


python必背源代码魔术方法__str__/__repr__代码
深入解析 Python 必背魔术方法 __str__ 与 __repr__ 的核心机制、实现差异、调用路径、容器遍历原理及避坑指南,提供可以直接使用的工业级标准示例代码。
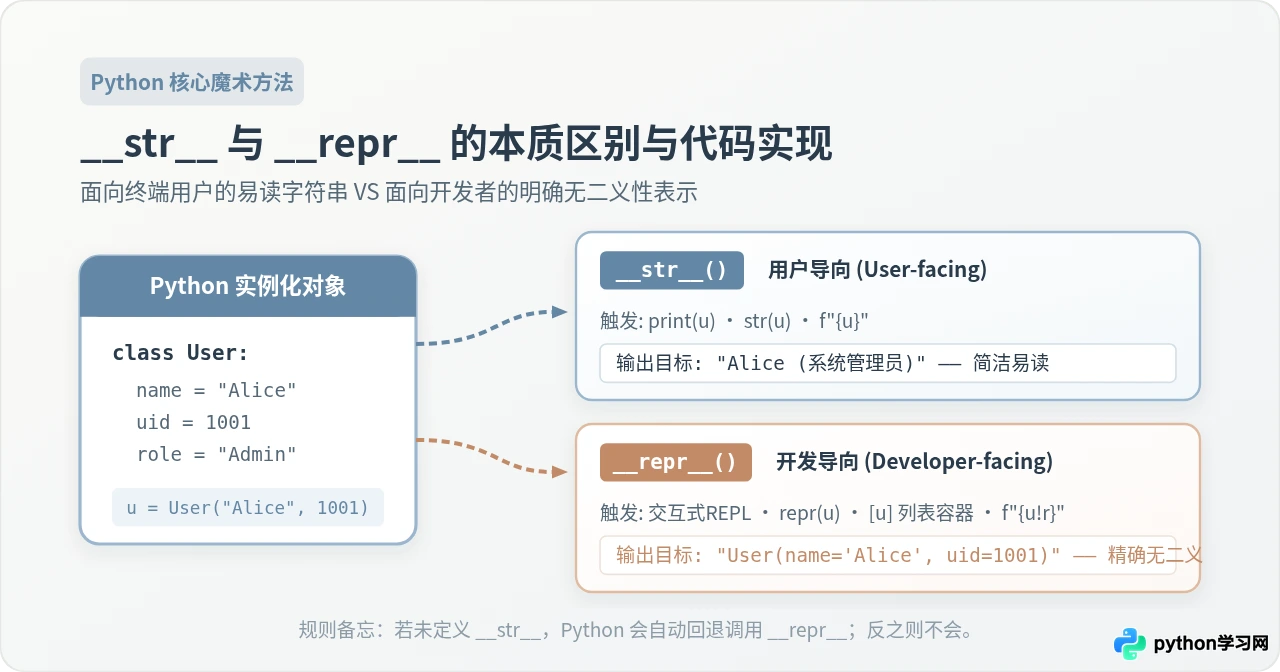
在 Python 面向对象编程中,默认情况下直接打印一个自定义类实例只会输出类似 <__main__.User object at 0x7fa2b0> 的内存地址,无论是在日常业务日志排查还是在终端交互调试中,都无法直接获知对象内部的有效属性。__str__ 与 __repr__ 就是 Python 专门用于控制对象“如何转换为字符串”的两个核心魔术方法:前者专注于为终端用户生成直观友好的描述文本,后者专注于为开发者提供明确、精准且无二义性的调试标识。本文提供这两个核心方法的标准源码模板,并逐层剖析调用逻辑、回退机制、容器陷阱与编写规范。
一、核心源码速查:生产级标准实现模板
在日常开发中,为类编写字符串表示的最短且最稳妥的方式是:首先定义格式规范的 __repr__,再根据是否需要面向非技术用户展示来决定是否编写 __str__。以下代码给出了符合现代 Python 规范的标准实现。
class UserAccount:
    """系统用户账户模型类"""
    def __init__(self, user_id: int, username: str, email: str):
        self.user_id = user_id
        self.username = username
        self.email = email

    def __repr__(self) -> str:
        """面向开发者:明确无二义,尽量可还原对象"""
        return f"{self.__class__.__name__}(user_id={self.user_id!r}, username={self.username!r}, email={self.email!r})"

    def __str__(self) -> str:
        """面向终端用户:简洁友好,适合文案与直观呈现"""
        return f"用户 {self.username} (ID: {self.user_id})"


# 测试用例
if __name__ == "__main__":
    user = UserAccount(1001, "Alice", "alice@example.com")

    # 1. 用户端场景触发 __str__
    print("--- 1. print() 与 str() 输出 ---")
    print(user)
    print(str(user))

    # 2. 调试场景触发 __repr__
    print("
--- 2. repr() 输出 ---")
    print(repr(user))

    # 3. 嵌套在列表容器中
    print("
--- 3. 容器内部遍历输出 ---")
    user_list = [user]
print(user_list)用户 Alice (ID: 1001)
用户 Alice (ID: 1001)
--- 2. repr() 输出 ---
UserAccount(user_id=1001, username='Alice', email='alice@example.com')
--- 3. 容器内部遍历输出 ---
[UserAccount(user_id=1001, username='Alice', email='alice@example.com')]
观察上述结果可以发现一个非常核心的现象:当执行 print(user) 时,Python 输出的是用户友好的 __str__;但当执行 print([user]) 打印列表时,列表内部包含的元素却调用了 __repr__。这种设计并非偶然,而是 Python 字符串解析机制中的明确分工。
二、底层调用路径与自动回退机制
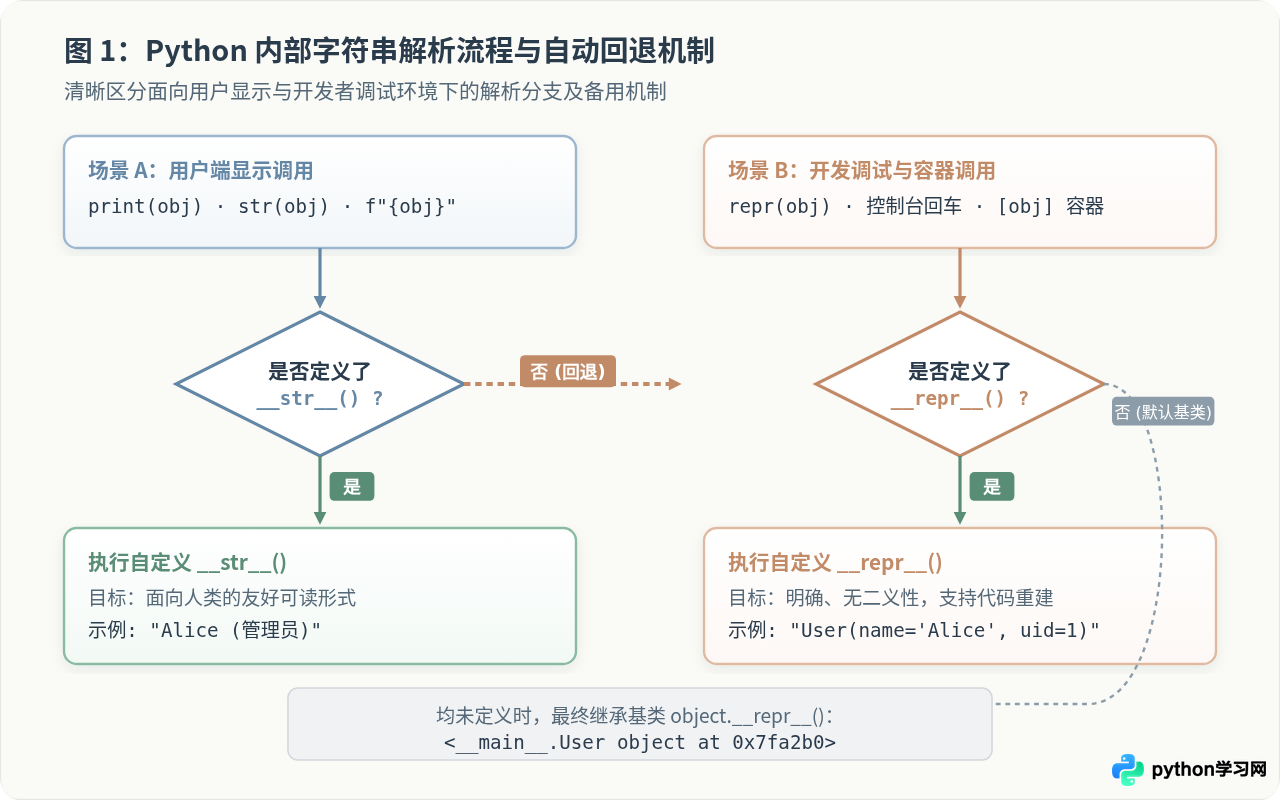
Python 解释器在不同语法场景下,决定调用 __str__ 还是 __repr__ 遵循着严格的路径判断,并且存在单向自动回退机制。
1. 用户端显示场景(优先找 __str__)
当执行以下操作时,解释器首先寻找目标对象的 __str__() 方法:
- 调用内置函数
str(obj); - 直接使用终端输出函数
print(obj); - 使用默认 f-string 插值:
f"{obj}"; - 使用格式化函数:
format(obj)或"{!s}".format(obj)。
关键回退规则:如果当前类没有实现 __str__,Python 不会直接报错,而是会自动回退调用该类实现的 __repr__()。这意味着只要写了 __repr__,即使不写 __str__,print(obj) 也能输出明确的内容。
2. 开发与调试场景(直达 __repr__)
在以下场景中,Python 会绕过 __str__,强制直接调用 __repr__():
- 调用内置函数
repr(obj); - 在 Python REPL 交互式命令行、IPython 或 Jupyter Notebook 中直接输入变量名回车;
- 被各种内置复合容器(列表
list、字典dict、集合set、元组tuple)包含并打印; - 在 f-string 中显式指定转换标识符
!r,如f"{obj!r}"; - 日志记录库(如
logging.debug)或 IDE 断点调试变量视窗。
不可逆原则:反方向的回退并不成立。如果一个类只定义了 __str__ 而没有定义 __repr__,在 REPL 命令行或列表打印时,解释器绝对不会调用 __str__,而是直接继承基类 object.__repr__,输出诸如 <User object at 0x...> 的内存地址。
三、深入解析:为什么 print([obj]) 不调用 __str__?
初学者最常感到困惑的问题是:“我已经对列表执行了 print(),为什么里面的元素没有展示成 __str__ 格式?”
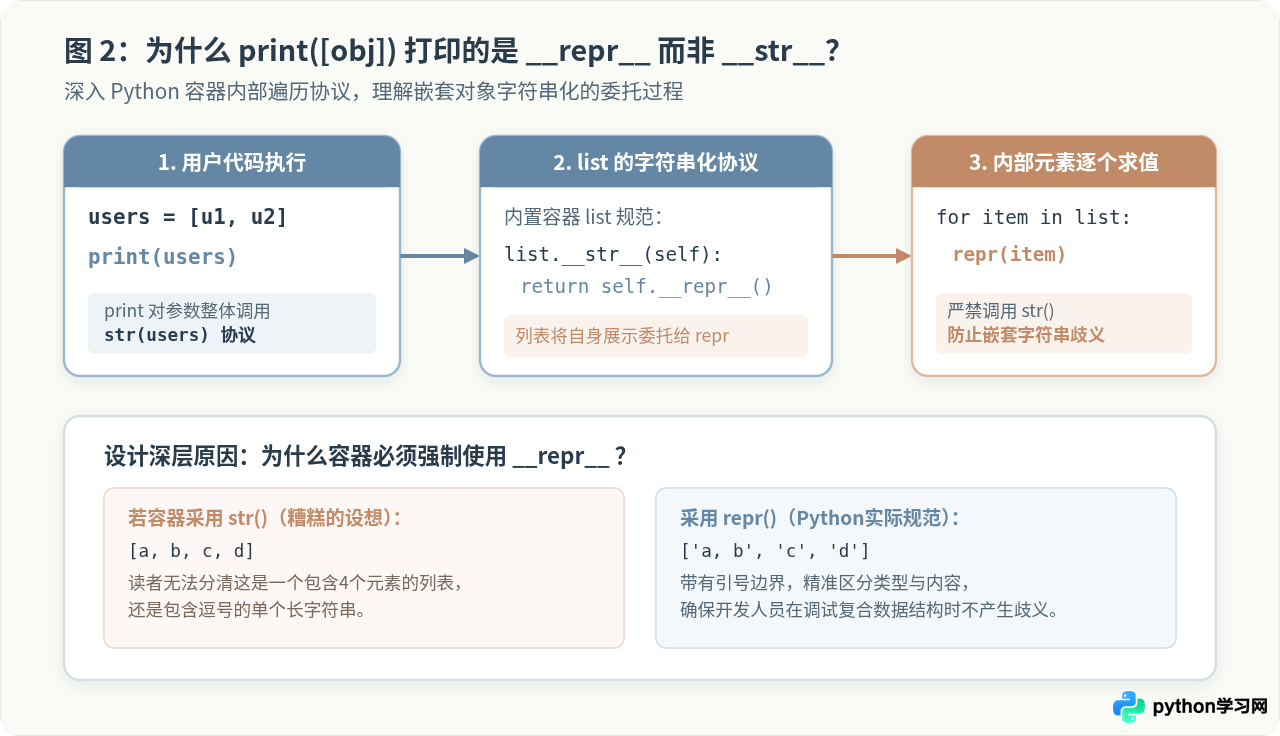
我们可以从 Python 容器的内部实现机制来理解这个流程:
- 当你执行
print([u1, u2])时,print确实对整个列表对象调用了str(list)。 - 在 Python 底层,内置类型
list的__str__实现实际上直接委托给了list.__repr__(即list.__str__ = list.__repr__)。 - 列表的
__repr__遍历内部的所有元素,并对每一个元素强制执行repr(item),最后用方括号和逗号连接起来。
假设列表中的元素采用了
__str__,若某个字符串本身就包含逗号(例如 "Beijing, China"),打印列表时将会变成 [Beijing, China, Tokyo]。此时开发者无法判断列表中到底是 3 个单项,还是 2 个含逗号的项。而使用 __repr__ 会带上单双引号如 ['Beijing, China', 'Tokyo'],类型与边界一目了然。
四、标准编写步骤与核心技巧
在实际工程代码编写中,推荐遵循以下标准化步骤,避免遗漏关键属性或违反内置约定。
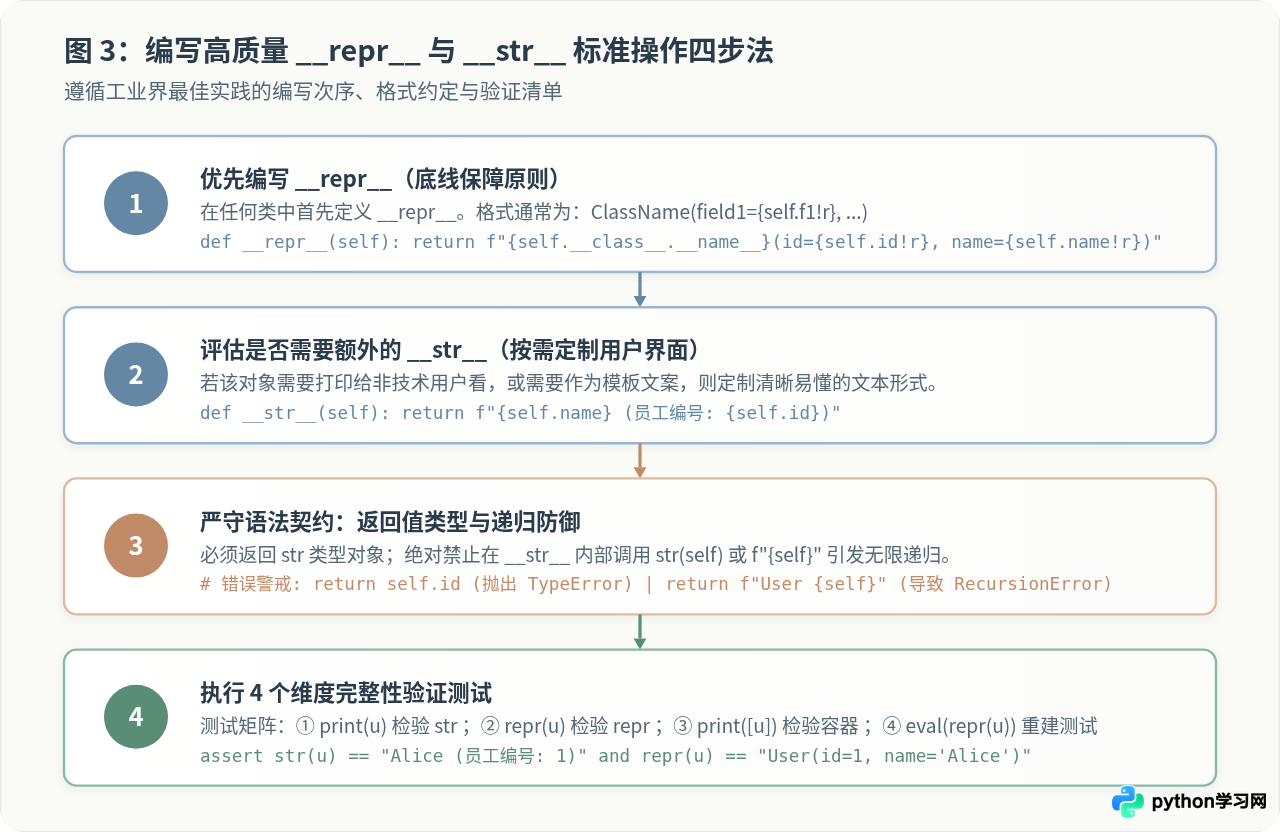
步骤一:优先编写 __repr__ 并使用 !r 格式化占位
编写 __repr__ 时,最优雅的实践是保持输出结果类似对象的构造函数调用(即满足“代码即表达式”原则)。在 f-string 中应当使用 !r,确保内部属性保留其自身类型的字面量特征(例如字符串带引号、数字不带引号):
def __repr__(self) -> str:
    # 使用 self.__class__.__name__ 兼容子类继承
    # 使用 !r 自动添加类型限定引号
    return f"{self.__class__.__name__}(id={self.id!r}, name={self.name!r}, active={self.active!r})"
步骤二:按需编写 __str__ 满足业务文案输出
当对象需要直接参与面向用户的提示信息、报表生成或控制台日志时,再编写 __str__。此时应剔除无关的技术细节(如内部状态标识、校验散列等),只呈现阅读者关心的核心信息。
步骤三:执行四维完整性测试验证
编写完成后,通过以下四行断言对代码进行自测:
obj = UserAccount(1001, "Alice", "alice@example.com")

# 1. 验证 str 行为
assert str(obj) == "用户 Alice (ID: 1001)"

# 2. 验证 repr 行为
assert repr(obj) == "UserAccount(user_id=1001, username='Alice', email='alice@example.com')"

# 3. 验证容器行为(必须调用 repr)
assert repr(obj) in repr([obj])

# 4. 验证 eval 重建能力(在安全上下文且参数完备时)
reconstructed = eval(repr(obj))
assert reconstructed.user_id == obj.user_id
五、核心差异横向对比与避坑指南
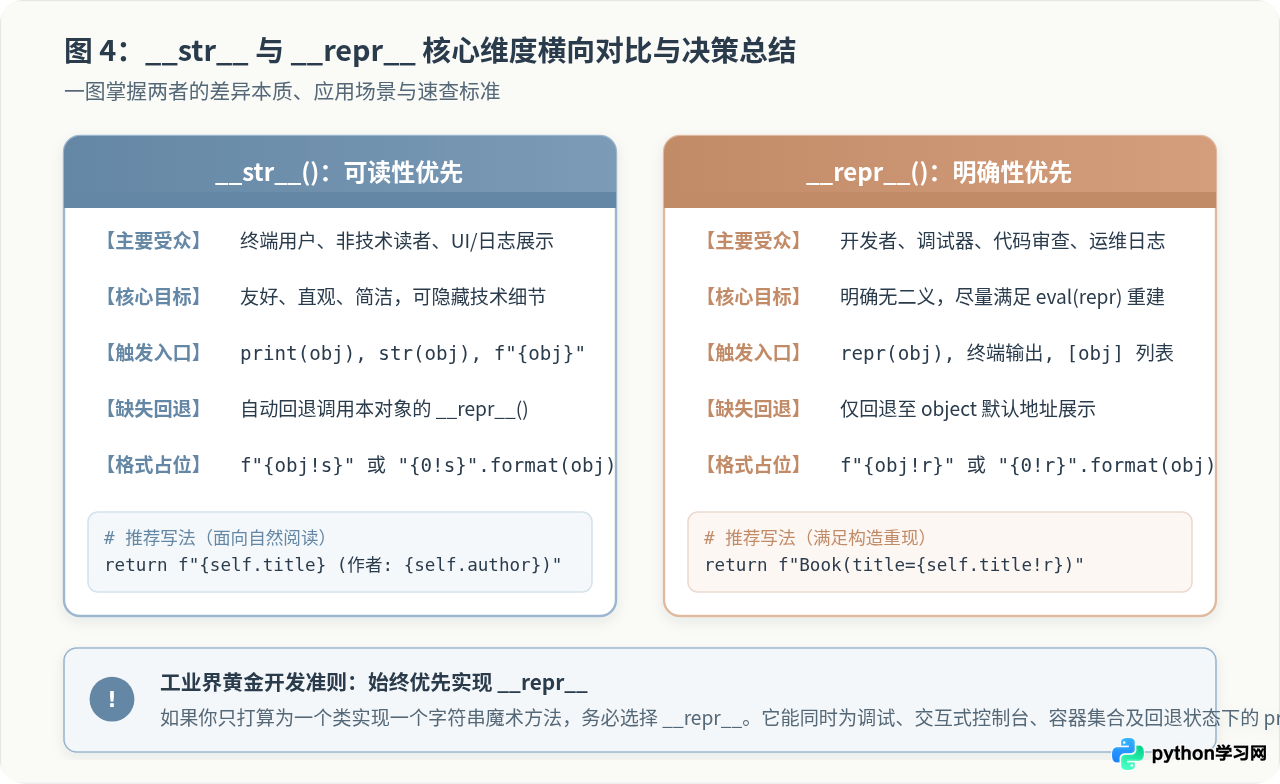
为了加深对两者差异的理解,以下表格横向总结了两个方法的关键区别:
| 对比维度 | __repr__(self) | __str__(self) |
|---|---|---|
| 设计核心目标 | 明确性(Unambiguous)、无歧义、支持调试 | 易读性(Readable)、直观、适合人类阅读 |
| 目标受众 | 开发者、调试器、日志分析系统 | 终端用户、业务运营人员、UI 文案 |
| 缺省回退表现 | 回退至 object.__repr__(输出内存地址) |
回退至本类的 __repr__ |
| 容器内展示表现 | 在 [obj]、{k: obj} 中被强制直接调用 |
容器打印时不生效 |
| 理想输出风格 | 尽量写成合法的 Python 表达式,如 Point(x=1, y=2) |
简练自然的描述,如 坐标点 (1, 2) |
| 优先级与建议 | 类中必写,首先实现 | 可选实现,视具体业务输出需求而定 |
常见三大开发陷阱与防范
__str__ 与 __repr__ 在 Python 语法规范中必须严格返回 str 类型。常见错误是直接返回整型 ID 或 None:
# 错误示例:
def __str__(self):
    return self.user_id  # 若 user_id 是 int,运行抛出 TypeError: __str__ returned non-string (type int)

# 正确修复:
def __str__(self):
return str(self.user_id)在实现
__str__ 时,如果在格式化字符串中又包含了 self 本身,会导致无限递归直到栈溢出:
# 错误示例:
def __str__(self):
    return f"User details: {self}"  # {self} 再次触发 self.__str__(),导致死循环 RecursionError

# 正确修复:
def __str__(self):
return f"User details: {self.username}"只写
__str__ 会导致在开发调试过程中(如列表中排查、终端控制台打印)仍然看到难看的内存地址。记住黄金法则是:宁可只写 __repr__,绝不只写 __str__。
六、生产环境综合实战代码
以下给出一个包含属性隐藏与格式化边界处理的完整示例文件,读者可以直接将其用于项目中的基础数据模型:
from typing import Optional

class ProductItem:
    """商品基础数据模型"""
    def __init__(self, sku: str, name: str, price: float, secret_token: Optional[str] = None):
        self.sku = str(sku)
        self.name = str(name)
        self.price = float(price)
        # 敏感信息通常不在 repr 中直接明文展示
        self._secret_token = secret_token

    def __repr__(self) -> str:
        """
        面向开发者:完整、准确,保护敏感字段
        """
        cls_name = self.__class__.__name__
        return (
            f"{cls_name}("
            f"sku={self.sku!r}, "
            f"name={self.name!r}, "
            f"price={self.price!r})"
        )

    def __str__(self) -> str:
        """
        面向终端用户:格式化金额与友好可读名称
        """
        return f"【商品】{self.name} (SKU: {self.sku}) - ¥{self.price:.2f}"


if __name__ == "__main__":
    item1 = ProductItem("SKU-9981", "无线机械键盘", 299.0, secret_token="tok_secret_abc")
    item2 = ProductItem("SKU-9982", "降噪无线耳机", 599.5)

    # 1. 终端用户显示
    print("=== 用户端展示 (str) ===")
    print(item1)
    print(f"推荐清单:{item2}")

    # 2. 调试与日志
    print("
=== 开发者调试 (repr) ===")
    print(repr(item1))

    # 3. 容器集合展示
    print("
=== 购物车列表展示 (container) ===")
    cart = [item1, item2]
    print(cart)

    # 4. f-string 占位符显式区分
    print("
=== 显式占位符验证 ===")
    print(f"使用 !s: {item1!s}")
print(f"使用 !r: {item1!r}")【商品】无线机械键盘 (SKU: SKU-9981) - ¥299.00
推荐清单:【商品】降噪无线耳机 (SKU: SKU-9982) - ¥599.50
=== 开发者调试 (repr) ===
ProductItem(sku='SKU-9981', name='无线机械键盘', price=299.0)
=== 购物车列表展示 (container) ===
[ProductItem(sku='SKU-9981', name='无线机械键盘', price=299.0), ProductItem(sku='SKU-9982', name='降噪无线耳机', price=599.5)]
=== 显式占位符验证 ===
使用 !s: 【商品】无线机械键盘 (SKU: SKU-9981) - ¥299.00
使用 !r: ProductItem(sku='SKU-9981', name='无线机械键盘', price=299.0)
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















