


Python微服务集群中怎么实现服务发现与负载均衡?
深入解析在Python微服务集群中实现服务发现与负载均衡的核心架构、工作原理与完整代码实践。对比客户端发现与服务端发现,详解Consul注册探活及平滑轮询调度。
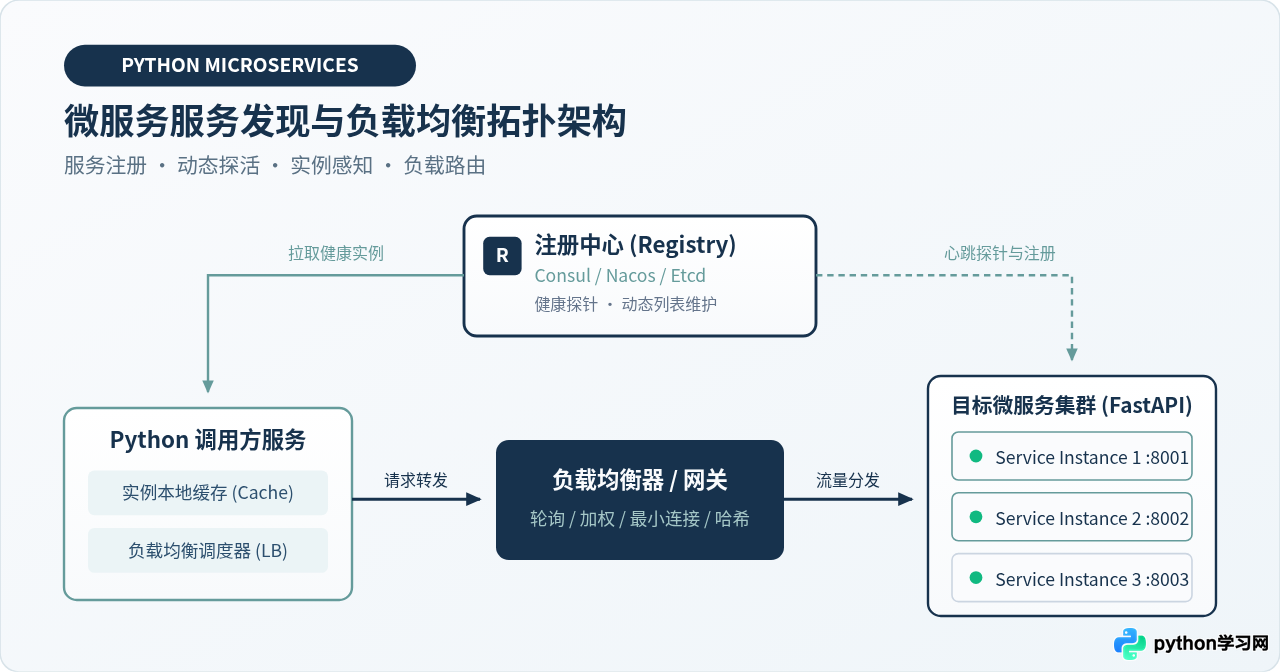
在 Python 微服务集群中,实现服务发现与负载均衡主要有两种成熟路径:一是服务端发现与负载均衡(借助 Consul / Nacos / Etcd 等注册中心配合 API 网关或 Kubernetes DNS / Envoy),将寻址和流量分发下沉到基础设施层;二是客户端发现与负载均衡(Python 客户端通过 SDK 订阅注册中心的健康实例列表,并在进程内部执行轮询、加权或一致性哈希等算法选择目标实例)。对于 Python 语言而言,生产环境最推荐以服务端网关或 K8s 原生 Service 为主,内部低延迟 RPC 辅助轻量客户端轮询的选型策略。
一、核心机制剖析:客户端发现 vs 服务端发现
单体架构演进到分布式微服务集群后,服务实例的 IP 与端口不再固定,随着动态扩缩容、故障漂移和滚动更新频繁变更。服务发现的核心职责是建立动态的“服务名到可用实例地址”的映射字典,而负载均衡则负责在这组健康实例中挑选最优节点投递流量。
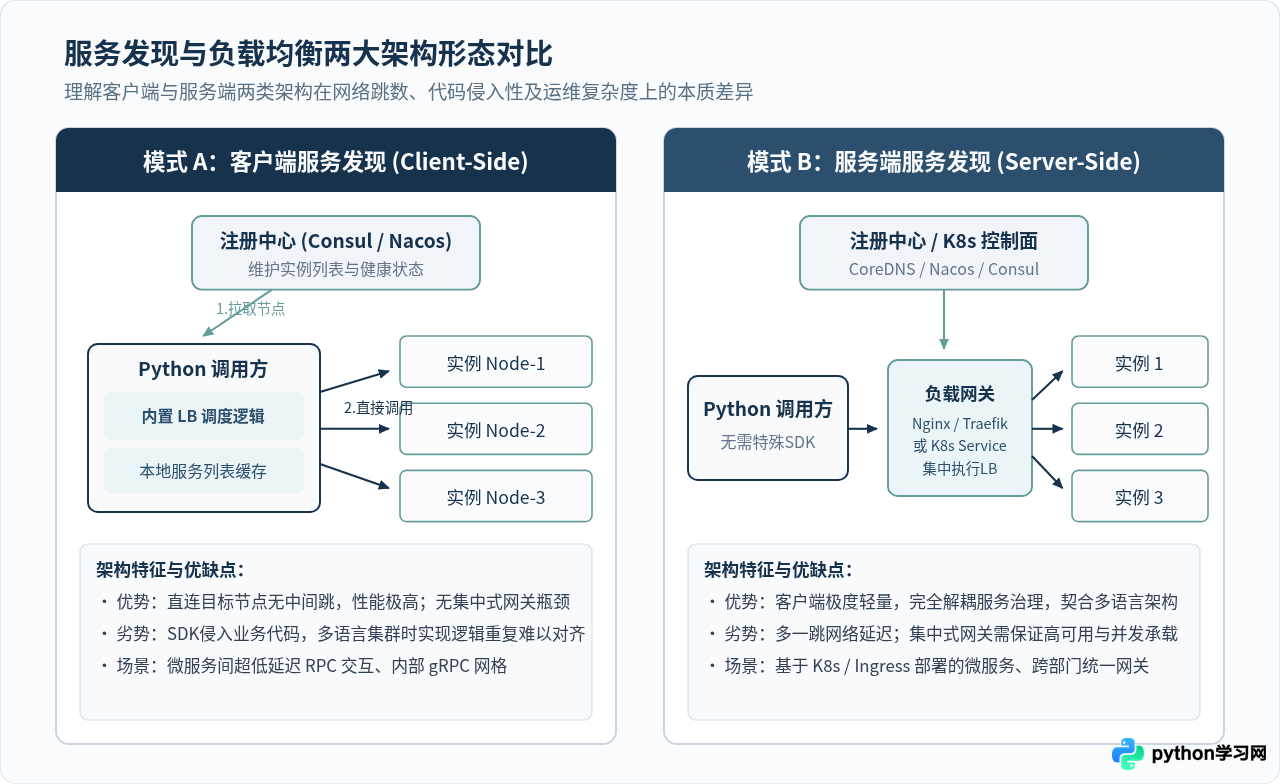
根据寻址与调度逻辑所在的位置,工程实践中分为两大经典架构模型:
1. 客户端服务发现与负载均衡 (Client-Side)
在客户端模式下,调用方 Python 程序集成了注册中心客户端。其基本流程为:
- 调用方定期向注册中心(如 Consul)查询被调用服务的健康节点,并将其缓存在本地内存中;
- 发起业务请求时,内置的负载均衡器(如 Round-Robin 算法)根据缓存列表选中一个目标实例;
- 调用方直接与目标实例建立 HTTP 或 gRPC 通信。
优势:去中心化,网络路径最短(直连少一跳),不存在中心化网关的单点吞吐瓶颈。
局限:每个微服务都需要集成发现与负载均衡代码逻辑。在 Python 多进程模型(如 Gunicorn / Uvicorn workers)下,各进程需独立维护缓存或共享缓存,增加了业务进程的复杂度。
2. 服务端服务发现与负载均衡 (Server-Side)
在服务端模式下,调用方完全不感知具体的后端实例,只请求固定的逻辑入口(如统一域名或内网反向代理):
- 由专门的中间件(如 Traefik、Nginx + consul-template、Kong 或 Kubernetes CoreDNS / kube-proxy)监听注册中心;
- 网关或代理层根据实时拓扑维护负载均衡池,完成路由分发。
优势:对 Python 业务代码完全零侵入,微服务只需专注于业务本身,运维与限流熔断策略可以集中治理。
局限:网络通信增加了额外的网络跳数(Hop),网关层需要保证高可用与足够的抗压吞吐能力。
二、基于 Consul 的服务注册与健康检查完整实践
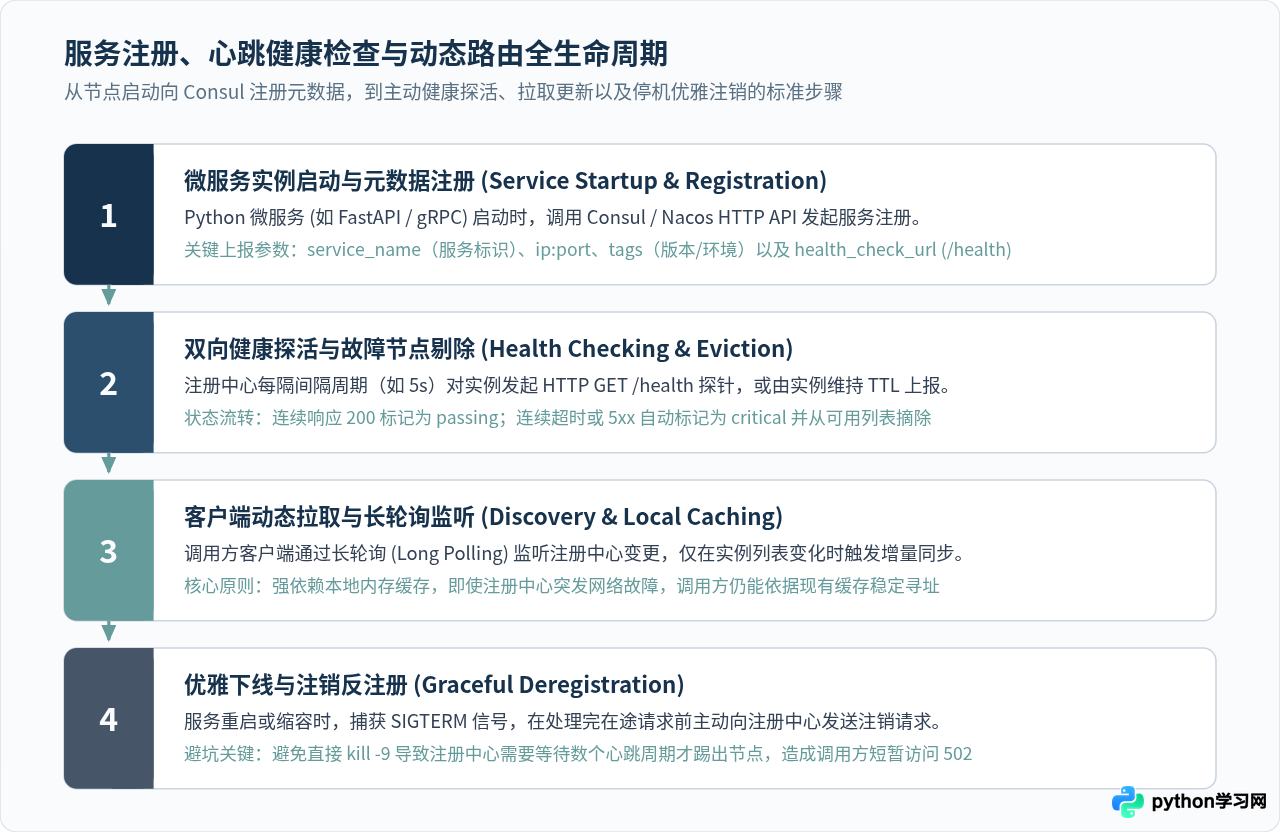
无论采用哪种发现方式,服务提供者启动时向注册中心宣告自身存在、并提供健康探活机制是整个闭环的第一步。在 Python 生态中,HashiCorp Consul 提供了成熟的 HTTP 接口与一致性保证,是常见的独立注册中心选型。
步骤 1:服务启动时上报元数据
以广泛使用的现代化异步框架 FastAPI 为例,利用其 Lifespan 生命周期机制,可以在应用启动时向 Consul 注册服务,并绑定 HTTP 健康检查端点:
# service_provider.py
import socket
import httpx
from contextlib import asynccontextmanager
from fastapi import FastAPI, status

CONSUL_HOST = "127.0.0.1"
CONSUL_PORT = 8500
SERVICE_NAME = "order-service"
SERVICE_PORT = 8001

# 获取本机真实内网 IP
def get_local_ip() -> str:
    s = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)
    try:
        s.connect(("8.8.8.8", 80))
        return s.getsockname()[0]
    finally:
        s.close()

SERVICE_IP = get_local_ip()
SERVICE_ID = f"{SERVICE_NAME}-{SERVICE_IP}-{SERVICE_PORT}"

@asynccontextmanager
async def lifespan(app: FastAPI):
    # 1. 应用启动:向 Consul 注册
    register_payload = {
        "ID": SERVICE_ID,
        "Name": SERVICE_NAME,
        "Tags": ["v1", "python", "production"],
        "Address": SERVICE_IP,
        "Port": SERVICE_PORT,
        "Check": {
            "HTTP": f"http://{SERVICE_IP}:{SERVICE_PORT}/health",
            "Interval": "5s",
            "Timeout": "2s",
            "DeregisterCriticalServiceAfter": "30s"  # 故障30秒后自动剔除
        }
    }
    async with httpx.AsyncClient() as client:
        resp = await client.put(
            f"http://{CONSUL_HOST}:{CONSUL_PORT}/v1/agent/service/register",
            json=register_payload
        )
        if resp.status_code == 200:
            print(f"[Register] 服务成功注册到 Consul: {SERVICE_ID}")
        else:
            print(f"[Register Failed] 状态码: {resp.status_code}, 内容: {resp.text}")

    yield  # 运行业务服务

    # 2. 应用停止:向 Consul 注销 (优雅下线)
    async with httpx.AsyncClient() as client:
        await client.put(
            f"http://{CONSUL_HOST}:{CONSUL_PORT}/v1/agent/service/deregister/{SERVICE_ID}"
        )
        print(f"[Deregister] 服务已从 Consul 注销: {SERVICE_ID}")

app = FastAPI(lifespan=lifespan)

@app.get("/health", status_code=status.HTTP_200_OK)
def health_check():
    # 此处可添加数据库连接池、Redis连通性等真实依赖检查
    return {"status": "UP", "service": SERVICE_NAME}

@app.get("/api/v1/orders")
def get_orders():
    return {"message": f"来自节点 {SERVICE_ID} 的响应数据"}
DeregisterCriticalServiceAfter 是防止“僵尸节点”的重要参数。当进程意外崩溃未来得及执行注销时,Consul 探活失败后将在设定的时间(如 30 秒)内强制清理该实例,避免无响应地址长期滞留在可用池中。
三、Python 客户端负载均衡算法与调度器实现
当调用方需要直接进行客户端路由时,必须在进程内实现高效、线程安全且具备本地缓存的负载均衡组件。常用的算法包括简单轮询、平滑加权轮询以及基于 Key 的一致性哈希。
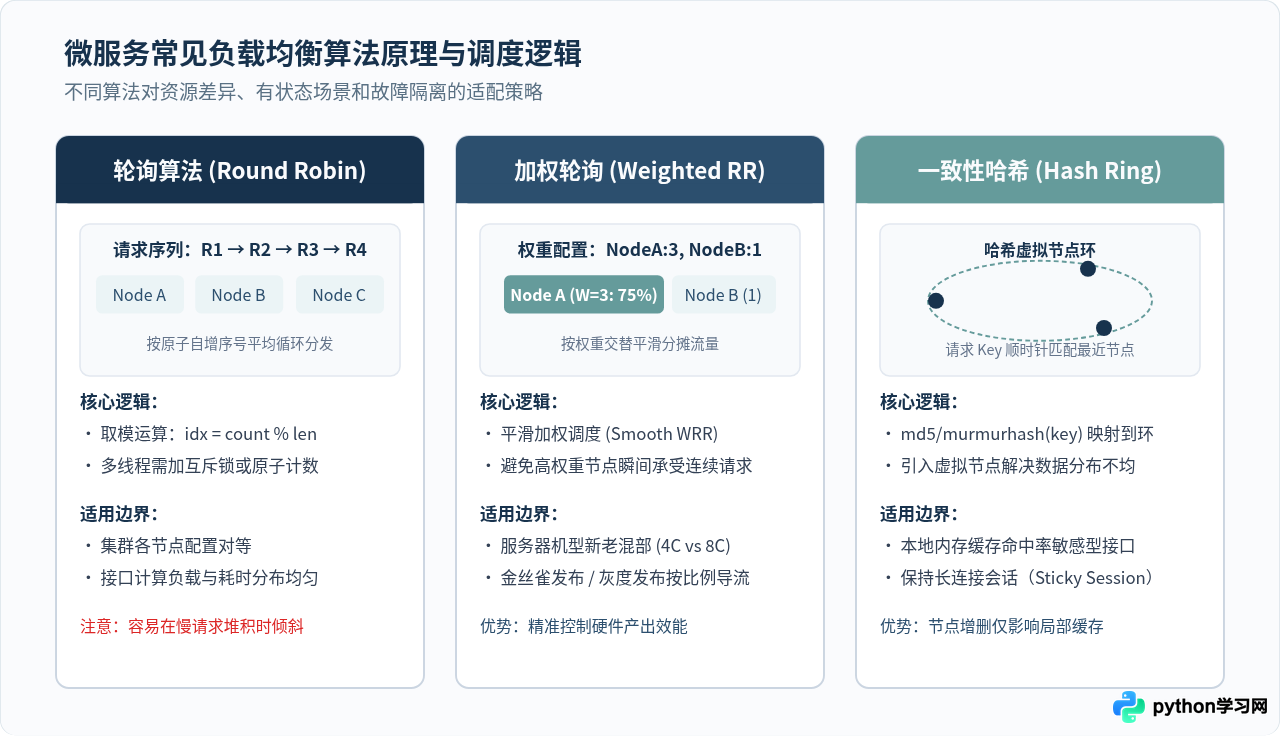
1. 编写带缓存与线程安全轮询的 Python 客户端
以下为一个可直接用于生产验证的客户端负载均衡器实现。它支持从 Consul 异步同步健康实例,并使用原子计数器执行轮询(Round-Robin):
# client_lb.py
import time
import threading
import itertools
import requests
from typing import List, Dict, Optional

class RoundRobinLoadBalancer:
    def __init__(self, consul_host: str, consul_port: int, service_name: str, sync_interval: float = 10.0):
        self.consul_url = f"http://{consul_host}:{consul_port}"
        self.service_name = service_name
        self.sync_interval = sync_interval

        self._instances: List[str] = []
        self._lock = threading.Lock()
        self._cycle = itertools.cycle([])
        self._last_sync_time = 0.0

        # 启动时同步一次
        self.refresh_instances()

    def refresh_instances(self) -> None:
        """从 Consul 查询 passing 状态的健康节点并更新本地缓存"""
        url = f"{self.consul_url}/v1/health/service/{self.service_name}?passing=true"
        try:
            resp = requests.get(url, timeout=3.0)
            if resp.status_code == 200:
                nodes = []
                for entry in resp.json():
                    service = entry.get("Service", {})
                    addr = service.get("Address")
                    port = service.get("Port")
                    if addr and port:
                        nodes.append(f"http://{addr}:{port}")

                with self._lock:
                    self._instances = nodes
                    self._cycle = itertools.cycle(nodes)
                    self._last_sync_time = time.time()
                print(f"[LB Cache Refreshed] 当前可用节点: {nodes}")
        except Exception as e:
            # 注册中心异常时静默降级,继续沿用上一次的本地缓存
            print(f"[LB Sync Error] 拉取实例失败,保留旧缓存: {e}")

    def get_instance(self) -> Optional[str]:
        """获取下一个路由节点"""
        # 惰性过期刷新
        if time.time() - self._last_sync_time > self.sync_interval:
            threading.Thread(target=self.refresh_instances, daemon=True).start()

        with self._lock:
            if not self._instances:
                return None
            return next(self._cycle)

# 使用示例
if __name__ == "__main__":
    lb = RoundRobinLoadBalancer(
        consul_host="127.0.0.1",
        consul_port=8500,
        service_name="order-service",
        sync_interval=5.0
    )

    # 模拟多次请求调度
    for i in range(6):
        node = lb.get_instance()
        if node:
            print(f"请求 #{i+1} 路由至目标节点 -> {node}")
        else:
            print(f"请求 #{i+1} 无可用健康节点!")
        time.sleep(0.5)
refresh_instances 的异常捕获块中,切勿清空 self._instances。注册中心网络闪断或发生领导选举时,保留最后一份本地健康缓存是保证微服务集群不发生“全链路雪崩”的最底线防线。
四、生产落地关键坑点与防护策略
在实际生产部署中,服务发现和负载均衡的故障往往不会出现在正常运行期,而是在节点发布、网络抖动或流量高峰时爆发。以下是针对 Python 集群必须落实的优化举措:
1. 避免每次请求都同步查询注册中心
部分初学者会把“调用前从 Consul 查一次 IP”当作服务发现。如果QPS为 10,000,就会向注册中心发起 10,000 次 HTTP 请求,注册中心会瞬间被打崩。必须采用内存缓存 + 后台长轮询 / 定时刷新的机制,业务请求直接在纳秒级读取本地内存。
2. 滚动发布时的 502 错误与优雅退出
在容器化或机器上执行部署时,如果直接向 Python 进程发送 SIGKILL (kill -9),进程瞬间退出,而 Consul 检测到端点不可用需要经历 Interval × 次数(通常为 5~15 秒)。在此期间,其他微服务仍会向该死亡节点分发请求,导致报错。
- 标准规范:监听
SIGTERM信号; - 先调用 Consul deregister 接口注销自己;
- 等待 2~5 秒(留出让网关与下游调用方拉取最新列表的缓冲时间);
- 停止接受新连接,待已有的在途请求处理完毕后退出主进程。
3. 连接池复用与 Keep-Alive
Python 在调用下游节点时,切勿在每次请求中新建 httpx.Client() 或 requests.get()。频繁的三次握手与四次挥手会耗尽系统本地端口(TIME_WAIT 堆积)。必须按目标 host:port 复用长连接池,并配置合理的空闲超时与重试上限。
五、工程选型决策与全景总结
对于不同规模和技术栈的团队,服务发现与负载均衡的建设深度应与团队基础设施现状相匹配:
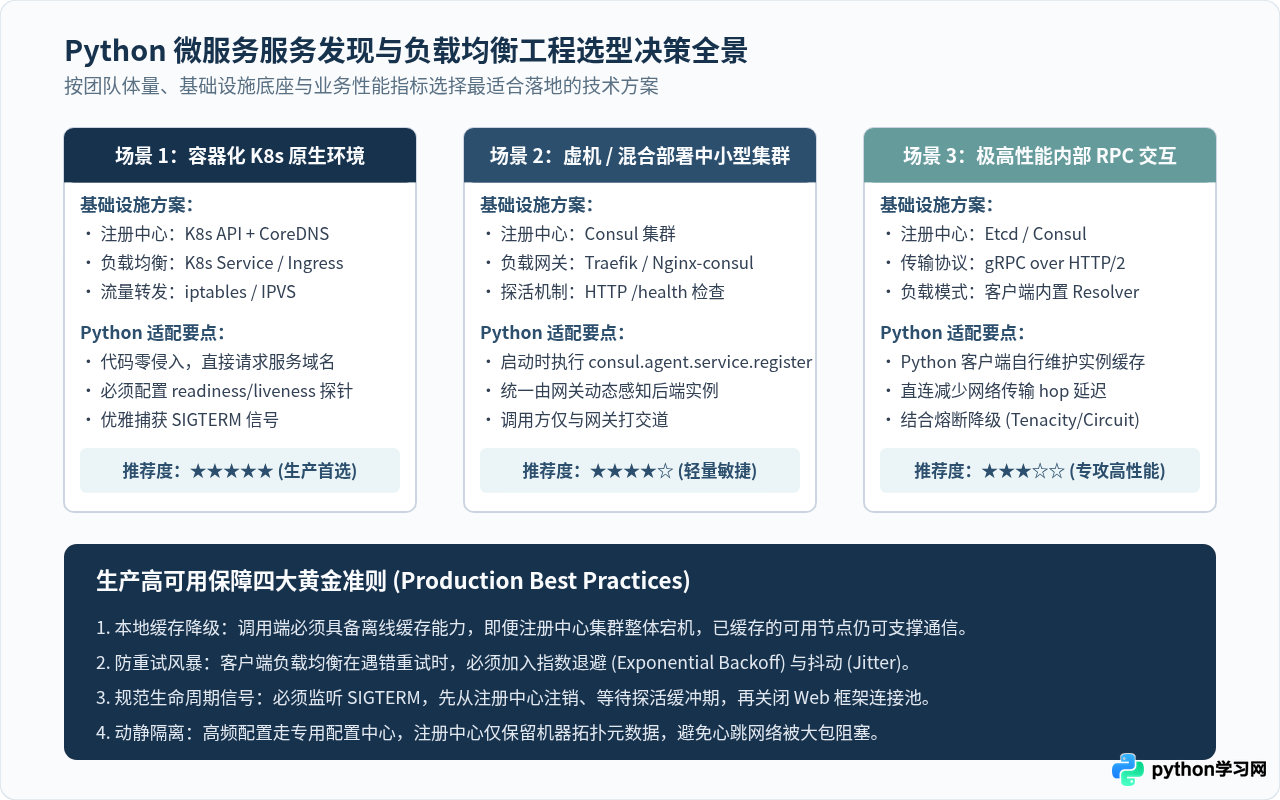
| 技术架构方案 | 服务发现机制 | 负载均衡执行点 | Python 侵入性 | 适用业务场景 |
|---|---|---|---|---|
| Kubernetes 原生模式 | CoreDNS / K8s Endpoints | kube-proxy (IPVS) / Ingress | 完全无侵入(标准域名解析) | 容器化部署、多语言中大型集群(生产首选) |
| Consul + 边缘网关 (Traefik/Nginx) | Consul Service Catalog | 网关反向代理层动态轮询 | 极低(仅启动时上报自身) | 混合云部署、中小型企业通用 Web 业务 |
| 客户端 SDK 直连模式 | Consul / Nacos API 轮询 | Python 进程内内存轮询/加权 | 较高(需维护 SDK 与缓存) | 局域网内部超高性能 RPC、极低延迟要求系统 |
综上所述,Python 微服务集群实现服务发现与负载均衡的本质,是在网络拓扑的动态感知与流量调度的高可用容错之间建立自愈机制。在云原生环境中,优先利用平台层能力(如 K8s Service / Envoy Sidecar)实现透明代理;在非容器化环境中,采用“Consul 负责健康注册与探活,动态网关负责负载转发,客户端保留本地缓存兜底”的组合,能够以最低的研发与维护成本构建出稳定坚固的微服务底座。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















