


Python模块文件名命名规则:为什么不能以数字开头或含连字符
深入解析Python模块文件名为什么不能以数字开头或包含连字符。从词法分析、语法树构建及执行机制剖析SyntaxError成因,并提供PEP 8命名规范与动态加载解决方案。
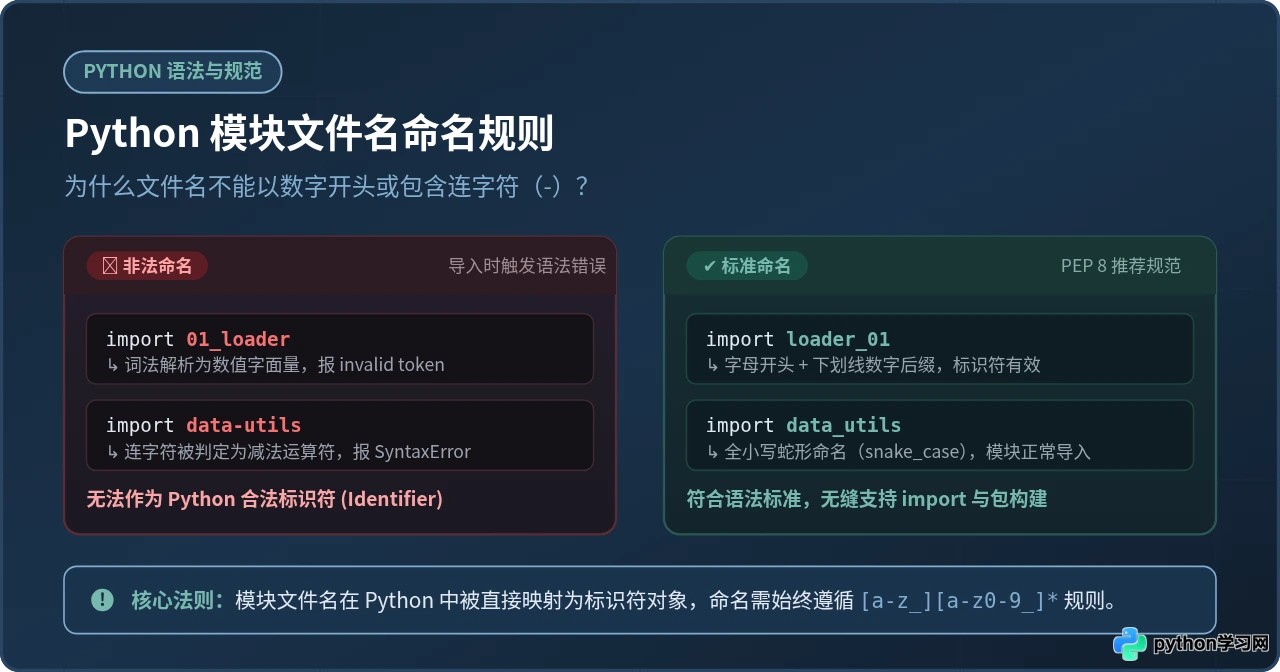
在日常 Python 项目开发中,很多人会习惯性地用数字序号或中划线来给脚本命名,例如用于步骤编排的 01_data_loader.py,或者按照业务语义命名的 data-utils.py。当在终端中直接通过命令行运行 python 01_data_loader.py 时,程序能够畅通无阻地运行;然而,一旦在其他脚本中写下 import 01_data_loader 或 import data-utils,Python 解释器就会瞬间抛出 SyntaxError: invalid syntax 错误并强制终止。这一现象的核心根源在于:Python 模块在被导入时,其文件名必须直接作为当前代码上下文中的“标识符(Identifier)”进行语法分析。以数字开头的名称会被词法分析器误认为数值常量,而连字符 - 则被严格保留为算术减法运算符,二者均违背了 Python 的标识符语法规则。本文将由浅入深解析底层的解析原理、对比直接运行与导入加载的机制差异,并给出工业级的命名重构与特殊场景解决方案。
一、现象重现:令人困惑的 SyntaxError
为了直观展示这一问题,我们可以构建一个极简的代码结构。假设在同一工程目录下存放着以下文件:
project/
├── 01_processor.py    # 负责数据清洗
├── data-utils.py      # 负责辅助工具函数
└── main.py            # 主执行脚本
在 main.py 中,开发者按照通常直觉编写导入逻辑:
# main.py 源码片段
import 01_processor
import data-utils

def run():
    print("Pipeline started...")
当执行 python main.py 时,控制台将输出如下报错信息:
  File "main.py", line 2
    import 01_processor
           ^
SyntaxError: invalid decimal literal
即使注释掉第一行,换成导入含连字符的模块 import data-utils,解释器同样毫不留情地报错:
  File "main.py", line 3
    import data-utils
               ^
SyntaxError: invalid syntax值得特别注意的是:该报错属于编译期语法错误(SyntaxError),而非运行期的模块未找到错误(ModuleNotFoundError)。这意味着 Python 解释器在读取 main.py 源码并将其翻译为抽象语法树(AST)时就直接崩溃了,甚至根本还没有来得及去磁盘文件系统中检索是否存在对应的 .py 文件。
二、深度原理:词法分析(Lexer)与语法树的底层冲突
要彻底理解为什么不能这样命名,必须回到 Python 语言的词法与语法分析流程。Python 源码在被解释器执行前,会经历词法分析(Tokenizing)和语法分析(Parsing)两个关键阶段。
1. 为什么不能以数字开头?
在 Python 语言规范中,标识符(Identifier)被形式化定义为必须以拉丁字母(a-z、A-Z)或下划线(_)开头,后续字符可以由字母、下划线及数字(0-9)组成。形式文法可以简化表示为:
identifier   ::=  (letter | "_") (letter | digit | "_")*
letter       ::=  lowercase | uppercase
词法分析器(Lexer)在自左向右扫描字符流时,一旦遇到以 0-9 开头的连续字符,其状态机就会立即进入数值字面量(Numeric Literal)的解析分支。例如扫描到 01 时,解析器判定这应该是一个整数(在旧版本中可能判定为八进制前缀,在 Python 3 中 01 为非法的十进制数字格式)。紧随其后的 _processor 是字母下划线字符,数值解析器无法处理这类拼接,于是直接报出 SyntaxError: invalid decimal literal。即使是合法的数字开头(如 import 1),也会因为 import 语法要求后接标识符而数字却匹配为字面量常量,触发类型不匹配的语法解析失败。
2. 为什么不能包含连字符(-)?
连字符在 ASCII 编码中是减号字符(-)。在 Python 的词法体系中,- 是一个高优先级的保留操作符(Operator: MINUS)。
当词法分析器遇到 import data-utils 时,它切分出来的 Token 序列并非一个整体名称,而是三个独立的 Token:NAME('data')、OP('-')、NAME('utils')。语法分析器在处理 import 语句时,其文法规则严格限制为:
import_stmt ::= 'import' dotted_as_names
dotted_name ::= identifier ('.' identifier)*也就是说,import 后面只允许接由点号连接的纯粹标识符列表,不允许承载任何二元算术表达式。语法分析器在期望逗号或换行符的位置遇到了减号操作符,语法断言失败,只得报出 SyntaxError: invalid syntax。
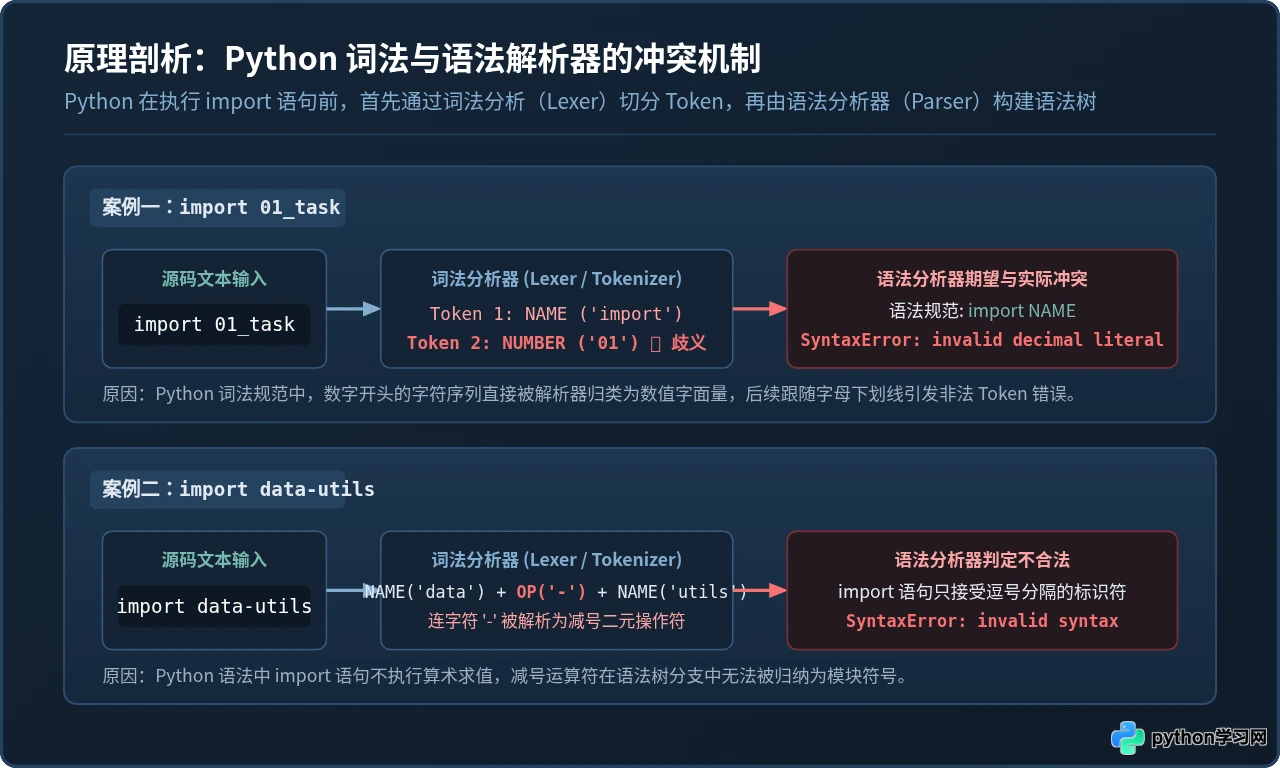
三、执行机制差异:为什么命令行直接运行却没报错?
许多初学者最容易产生疑惑的问题是:“如果 01_processor.py 和 data-utils.py 命名真的非法,为什么我在终端里执行 python 01_processor.py 或者 python data-utils.py 却可以完全正常跑完?”
这是因为两种场景下,解释器所走的加载链路与角色定位有着根本的区别:
- 命令行直接运行(Path-based 模式):操作系统终端将文件名作为纯粹的文件路径字符串(String Path)传递给 Python 可执行文件。Python 解释器通过底层操作系统 API(如 C 语言的
fopen)直接定位并打开该文件流,将文件内部的代码读取后直接编译并执行。在整个过程中,该脚本被赋予了一个内置常量名称__name__ = "__main__"。操作系统的文件名在这里仅起到了“磁盘寻址”的作用,完全没有进入 Python 语言的标识符词法校验器。 - 作为模块导入(Identifier-based 模式):当在代码中使用
import foo时,foo不仅是文件名,更是 Python 语言内部的一个变量符号。导入成功后,Python 会在当前作用域创建一个名为foo的模块对象引用。因此,foo必须首先满足 Python 标识符的所有语法规则,才能被编译进当前模块的抽象语法树中。
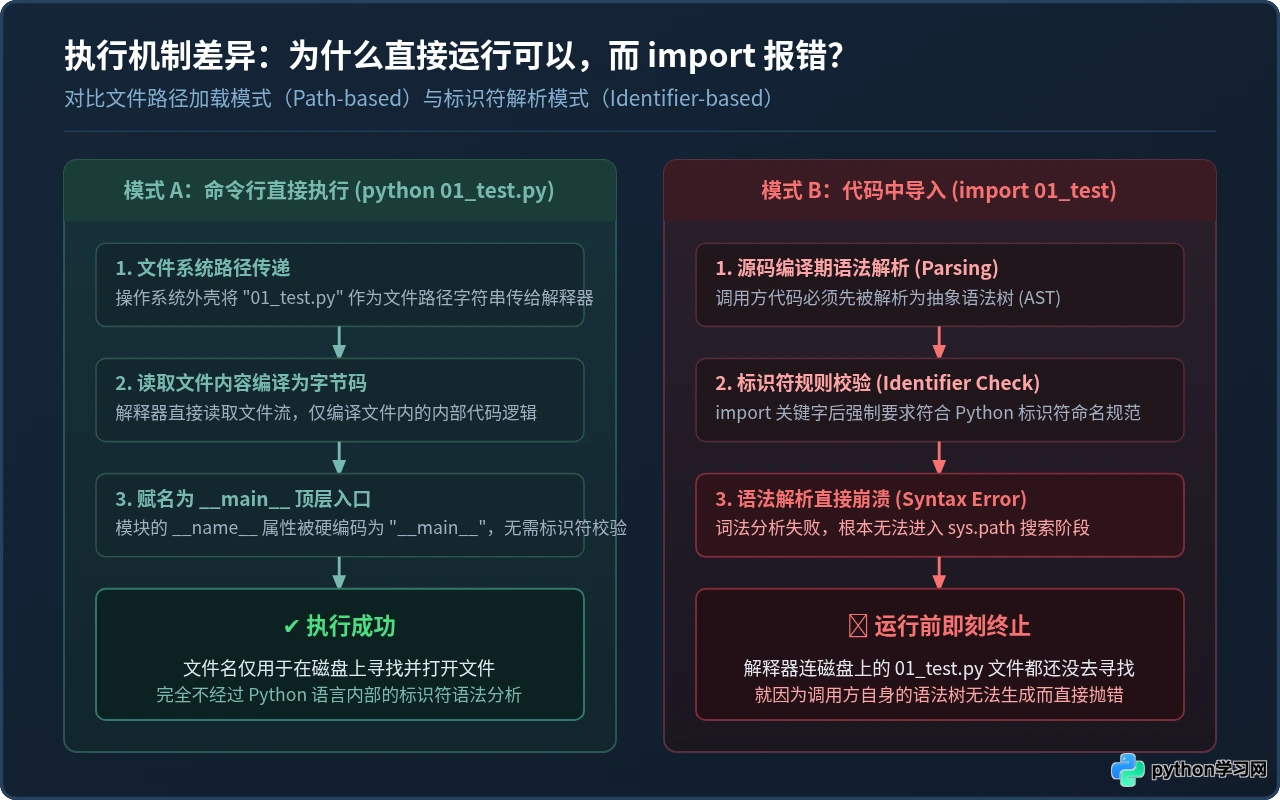
四、规范重构指南:遵循 PEP 8 与标准化命名
Python 官方设计指南 PEP 8 -- Style Guide for Python Code 对模块(Modules)和包(Packages)的命名有着非常明确的规范:
- 模块命名:应该采用短小的、全小写的命名方式。如果为了提高可读性,可以在模块名中使用下划线(
_)连接多个单词(即蛇形命名法snake_case)。 - 包命名:同样采用全小写,但强烈建议不要使用下划线(通常保持单个简短的纯字母单词)。
常见反模式与重构对照
| 反模式文件名 | 违规原因 | PEP 8 推荐重命名 | 工程改造建议 |
|---|---|---|---|
01_cleaner.py |
数字开头,报 invalid decimal literal | cleaner_01.py 或 step1_cleaner.py |
将顺序序号后置,或增加合法的字母语义前缀(如 step / stage) |
data-utils.py |
包含连字符,被词法识别为减法减号 | data_utils.py |
直接将所有连字符 - 批量替换为下划线 _ |
User Profile.py |
包含空格,破坏词法连续性 | user_profile.py |
去除空格,改为全小写蛇形命名 |
class.py / import.py |
占用 Python 核心保留关键字 | class_helper.py / importer.py |
补充具体业务语义词,严禁与关键字重名 |
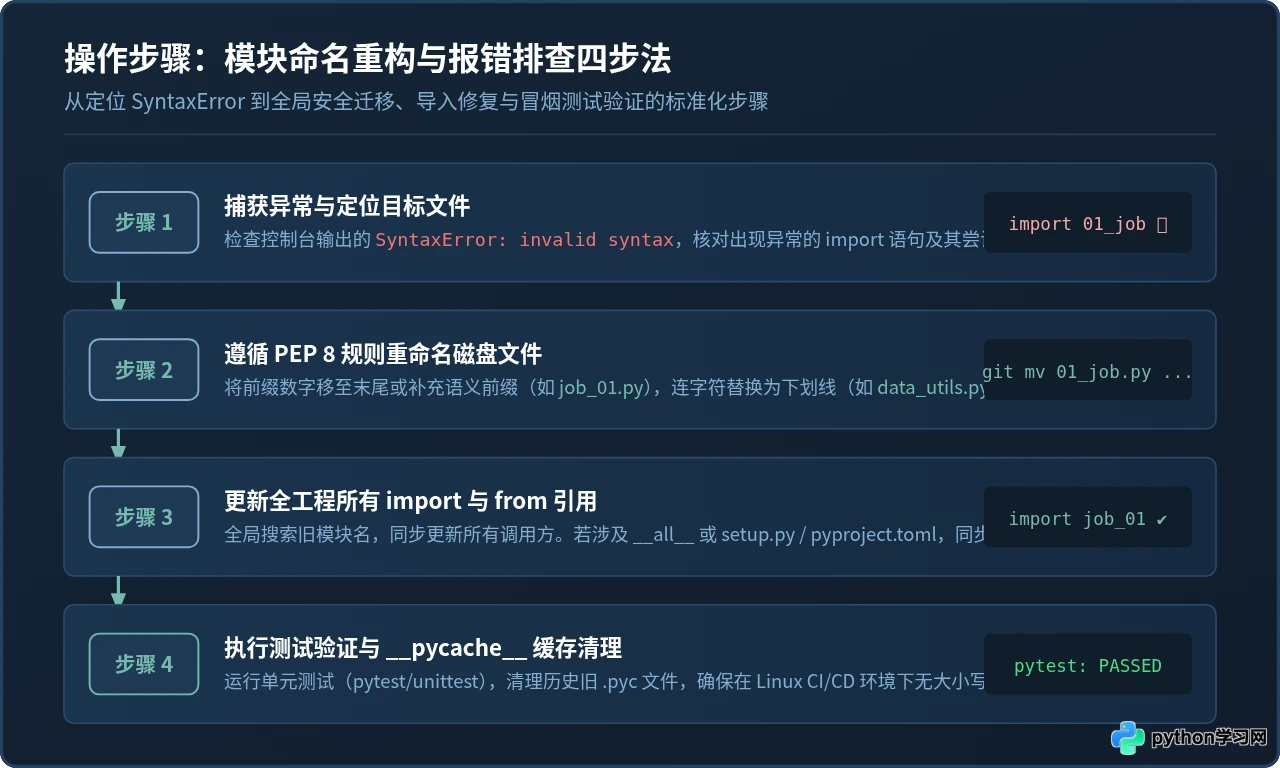
标准重构操作步骤
- 定位异常引用:通过控制台 Traceback 确认触发
SyntaxError的文件名及导入行。 - 使用版本控制工具重命名:如果使用 Git 管理代码,推荐使用
git mv命令重命名文件,保留版本变更历史:git mv 01_processor.py processor_01.py git mv data-utils.py data_utils.py - 全局更新导入声明:在 IDE 或通过全局替换工具,将所有的
import 01_processor替换为import processor_01,import data_utils。 - 验证与清理缓存:运行项目的单元测试或冒烟测试,并清理历史缓存目录(
__pycache__中的旧.pyc文件):find . -type d -name "__pycache__" -exec rm -rf {} + pytest
五、特殊场景应对:遗留脚本无法改名时的动态加载
在某些特定生产场景中,例如对接外部供应商交付的代码包、只读的遗留系统数据处理脚本,或者依赖自动化工具生成的固定数字序号文件,开发者可能暂时没有修改磁盘文件名的权限。此时,若必须在 Python 代码中导入这些非标文件,直接使用 import 语句是绝对行不通的。
许多人首先会尝试调用 importlib.import_module("01_processor"),然而由于 import_module 底层同样依赖标准模块查找规范,数字开头仍可能在某些解析环节受到限制。最稳健、通用的正规解法是使用标准库 importlib.util 基于确切物理路径构建模块规范(ModuleSpec):
# dynamic_loader.py:加载不规则文件名的通用解决方案
import pathlib
import importlib.util

def load_module_from_file(module_name: str, file_path: str):
    """
    从任意指定的物理文件路径动态加载模块对象
    :param module_name: 在 Python 运行时中注册的合法模块名称(建议自定义合法的别名)
    :param file_path: 磁盘上目标 .py 文件的实际物理路径(支持任何系统合法文件名)
    """
    resolved_path = pathlib.Path(file_path).resolve()
    if not resolved_path.is_file():
        raise FileNotFoundError(f"未找到目标文件: {resolved_path}")

    # 1. 根据文件物理路径创建加载规范
    spec = importlib.util.spec_from_file_location(module_name, str(resolved_path))
    if spec is None or spec.loader is None:
        raise ImportError(f"无法为 {resolved_path} 创建模块规范")

    # 2. 根据规范实例化模块对象
    module = importlib.util.module_from_spec(spec)

    # 3. 将模块执行并绑定命名空间
    spec.loader.exec_module(module)
    return module

# 示例调用:无视非标准文件名限制
processor_mod = load_module_from_file("processor_module", "./01_processor.py")
utils_mod = load_module_from_file("utils_module", "./data-utils.py")

# 正常调用其内部函数
processor_mod.run_clean()
utils_mod.format_output()importlib.util)应当仅作为兼容无法修改的遗留环境的兜底手段。在正常的自主工程研发中,依靠反射和动态加载来规避命名规范会极大地降低代码的可读性,并导致 IDE 自动补全、类型推断(Mypy/Pyright)和代码重构工具全部失效。
六、进阶避坑:大小写敏感性与标准库遮蔽
除了数字开头与连字符两大“硬伤”,在 Python 模块命名中还有两个极具隐蔽性、容易导致团队线上事故的常见陷阱:
1. 操作系统大小写敏感性冲突(Cross-Platform Case Sensitivity)
在 Windows 和 macOS 默认文件系统(NTFS / APFS 不区分大小写配置)下,文件名 DataLoader.py 与 dataloader.py 指向同一个文件。在本地开发时,写 import dataloader 可以正常运行;但当项目部署到严格区分大小写的 Linux 服务器(Docker 容器、CI/CD 构建节点、云端宿主机)时,由于文件实际名为 DataLoader.py,解释器在查找 dataloader.py 时会直接抛出 ModuleNotFoundError: No module named 'dataloader'。因此,PEP 8 强制要求模块名必须全部使用纯小写字母。
2. 标准库命名遮蔽(Shadowing Builtin Modules)
Python 查找模块时优先检索当前执行目录(sys.path[0])。如果在项目中随手创建了名为 test.py、json.py、random.py、email.py 或 string.py 的文件,当其他依赖库(如 requests 或标准模块)执行 import json 时,Python 会优先加载你自定义的脚本,导致标准库被遮蔽覆盖,抛出诸如 AttributeError: module 'json' has no attribute 'loads' 这一类令人摸不着头脑的严重连锁崩溃。
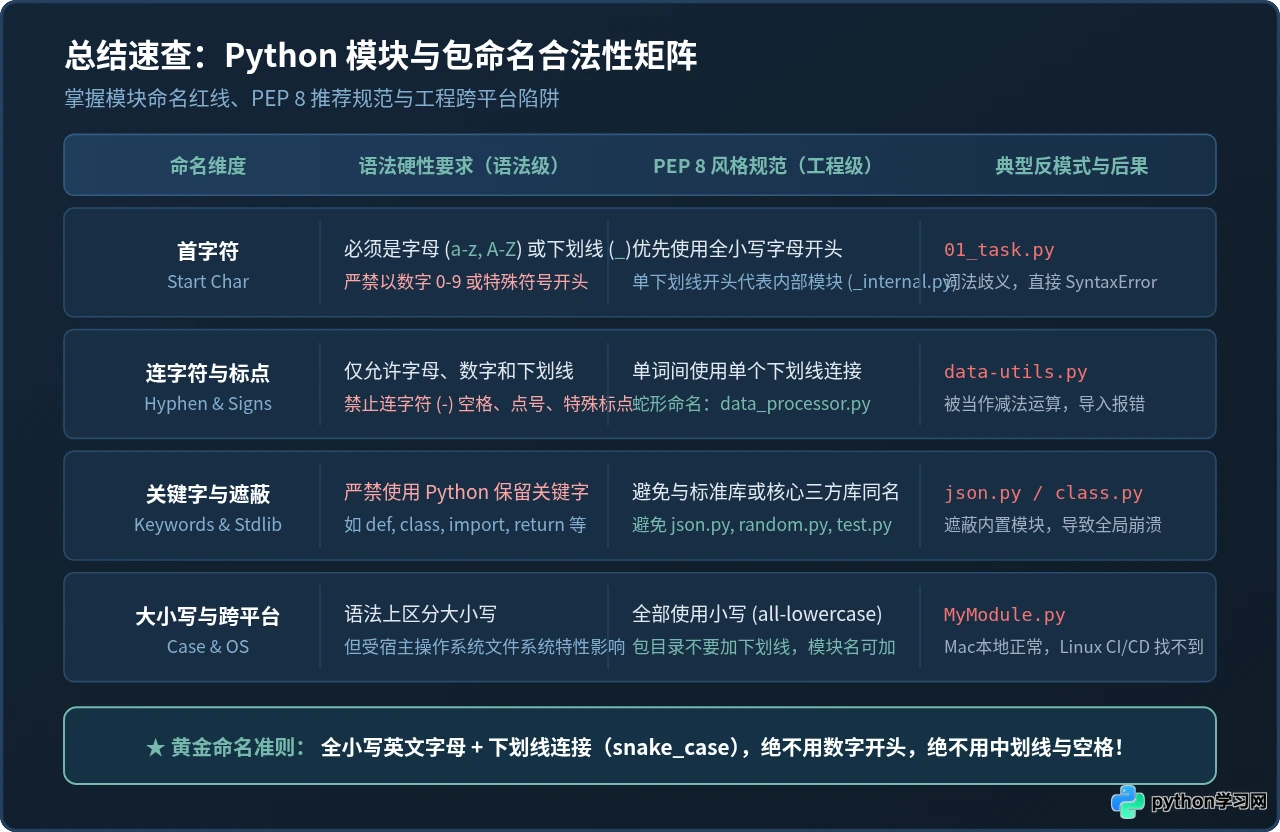
七、总结速查
理解 Python 模块文件名的命名约束,本质上是理解 Python 语言如何将“物理文件”抽象为“内存变量”的过程:
- 根本原因:
import语句后面的目标必须是合法的 Python 标识符。数字开头会导致数值字面量解析冲突,连字符-会导致减法算术运算符语法冲突。 - 现象解密:命令行直接运行
python script.py属于文件系统路径载入,绕过了代码层面的标识符语法解析;而import属于源码编译树的一部分,受到文法约束。 - 最佳实践:始终坚持 PEP 8 全小写蛇形命名(
snake_case),将数字序号作为后缀或添加语义前缀,用下划线代替连字符与空格。 - 工程红线:严禁使用 Python 关键字及标准库常用模块名命名脚本,防范跨平台大小写不兼容与依赖遮蔽风险。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















