


怎么使用Python三引号优雅地定义多行字符串
深入解析如何在Python中优雅使用三引号定义多行字符串,系统解决函数缩进污染、首尾多余换行问题,掌握textwrap.dedent与反斜杠转义的最佳实践。
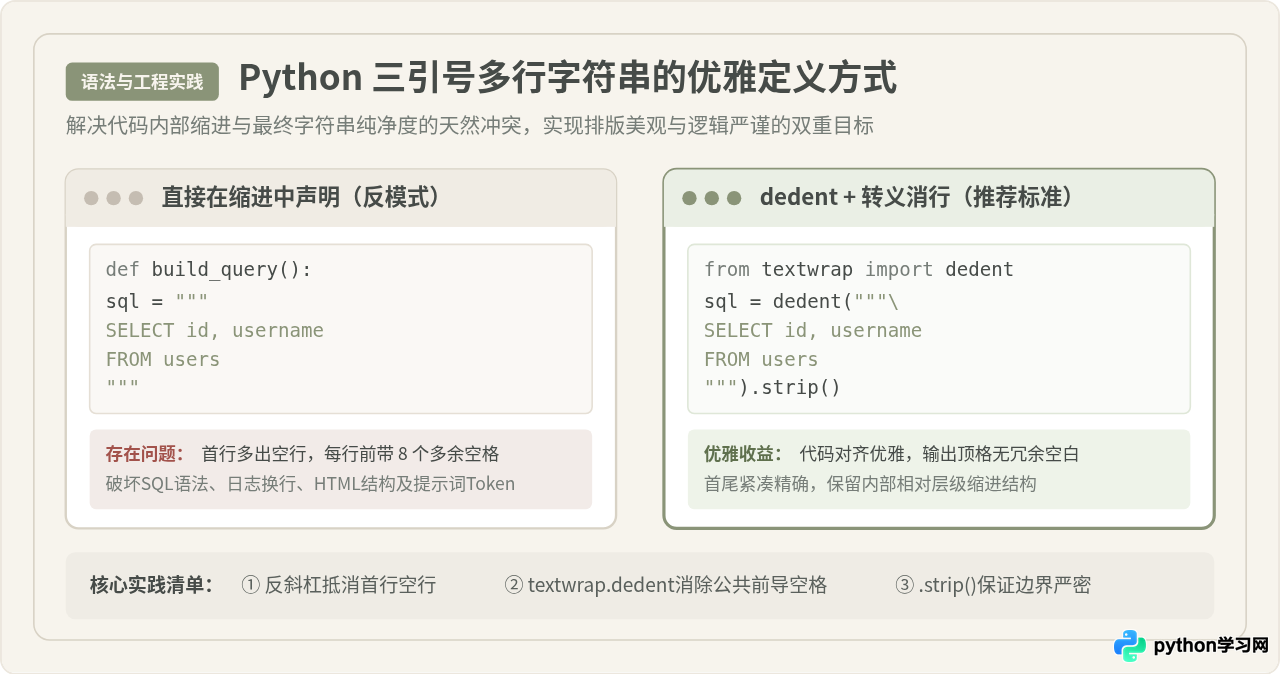
在 Python 中,使用三引号(''' 或 """)定义多行文本是最直观的语法特性。然而,当三引号出现在带缩进的代码块(如函数、类或条件分支)内部时,往往会引发“排版整齐”与“内容纯净”之间的冲突:直接排版会导致每一行都被塞入大量无意义的前导空格与首尾空行;若为了内容顶格而破坏代码缩进,又会导致代码结构紊乱。本文将通过剖析底层原理,介绍结合反斜杠转义、标准库 textwrap.dedent 以及边缘修剪的标准化解决方案,使代码既赏心悦目,又保证数据输出的绝对精确。
一、三引号的直白特性与“缩进污染”问题
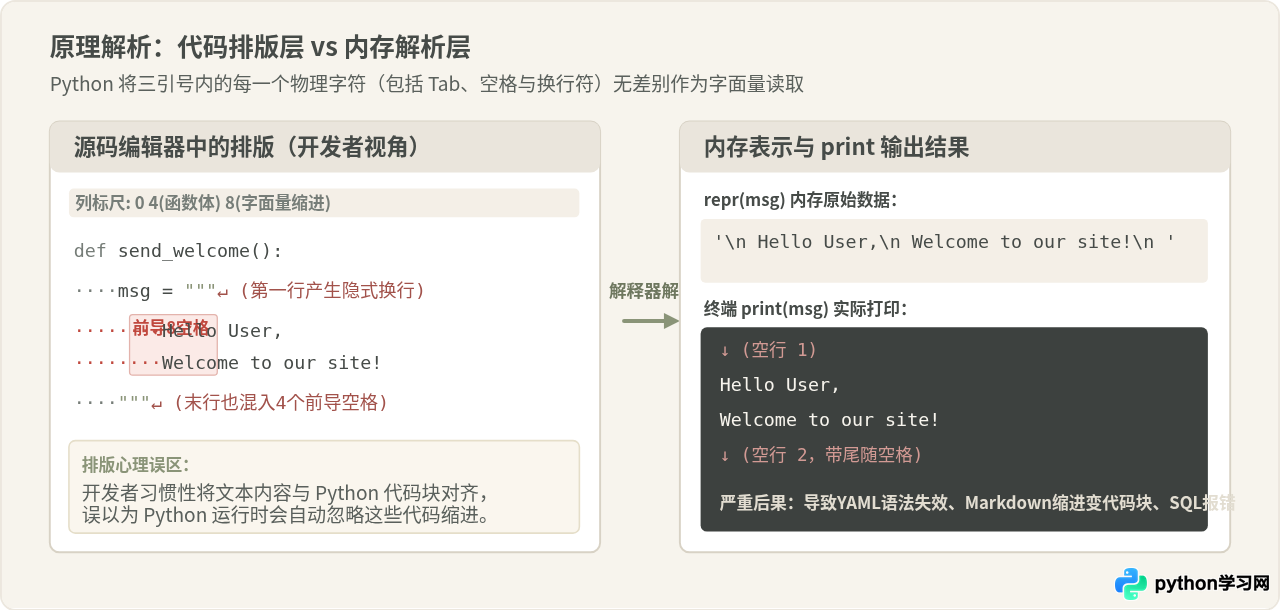
Python 解释器在词法分析阶段处理三引号字符串时,采取的是一种“所见即所得”的严格保留策略。凡是包裹在三引号之间的内容,不管是空格、制表符(Tab)还是物理换行符,都会被原封不动地转化为内存字符串中的具体字符。
这种设计在文件顶层声明全局变量时非常方便,但一旦将其写在函数或方法体内,问题便接踵而至。请观察下面这段常见的业务代码:
def generate_sql(user_id):
    query = """
        SELECT id, username, email
        FROM app_users
        WHERE status = 'active'
          AND user_id = :uid
    """
    return query
直观上看,这段代码遵循了 PEP 8 的缩进规范,整洁且层次分明。然而,当我们实际打印 repr(generate_sql(1001)) 时,真实的内容其实是:
'\n SELECT id, username, email\n FROM app_users\n WHERE status = \'active\'\n AND user_id = :uid\n '该字符串暴露了三个隐蔽却影响深远的问题:
- 首行多出空行:由于在开头的
"""之后直接按下了回车,字符串的第一个字符实际上是一个无意义的\n。 - 前导缩进污染:为了与外层函数对齐,正文每一行前都附带了 8 个物理空格。这在执行 SQL、生成 Markdown 文档(8 个空格会导致文本被错误解析为代码缩进块)、构建 YAML 配置或统计 LLM 提示词 Token 消耗时,会带来不可预测的隐患与体积膨胀。
- 末行残留空白:结尾的
"""单独占据一行,使得字符串末尾带有换行符及 4 个无用空格。
二、核心解法:反斜杠转义与 textwrap.dedent 组合拳
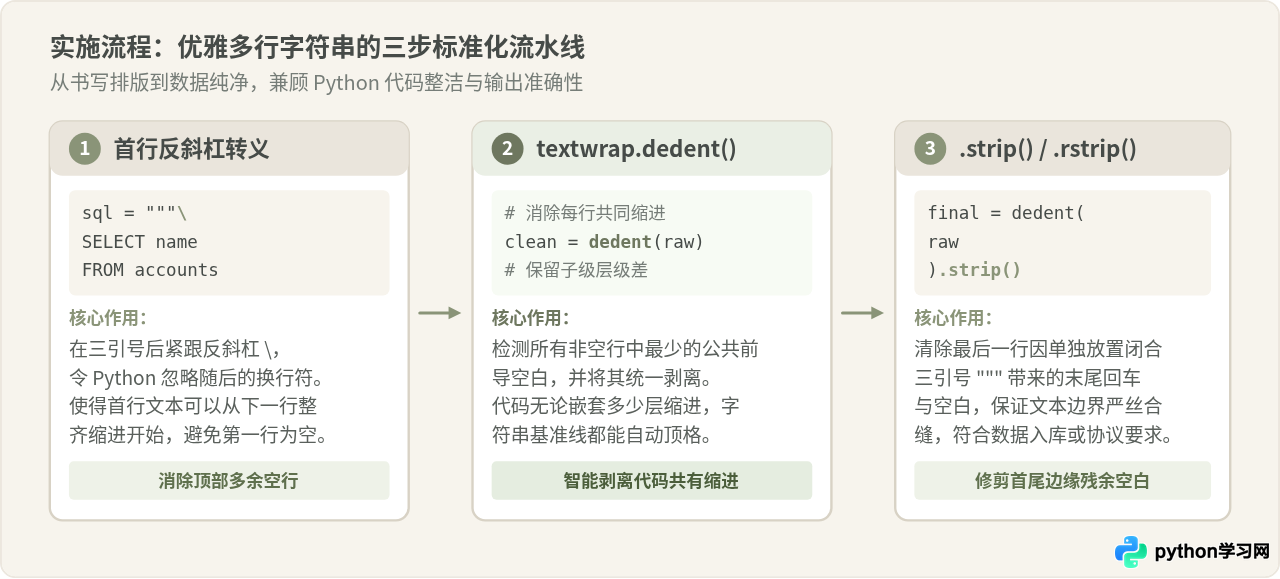
要优雅地解决这一难题,核心思想是:在源码中保持正常的代码缩进,而在程序解析时通过标准手段剥离这些属于代码层面的公共前导空白。
1. 使用首行反斜杠消除第一行多余空行
在 Python 中,行尾反斜杠 \ 是续行符。如果将它紧贴在开头的三个引号之后,Python 解释器在读取时就会忽略紧随其后的物理换行符。这允许我们在语法上直接跳到第二行开始书写正文,同时保证字符串开头不出现任何意外的回车符。
# 开头紧跟反斜杠,第二行正常对齐书写
text = """\
第一行内容
第二行内容"""
2. 引入标准库 textwrap.dedent 剥离公共缩进
Python 标准库内置了专门解决缩进问题的工具:textwrap.dedent()。它的工作逻辑非常智能:扫描传入字符串中所有非空行,计算出它们共有的最小前导空白数量,然后将每一行开头的这部分公共空白完全移除。
值得注意的是,它只去除公共的最少前置空白,并不会抹杀文本内部原有的相对缩进层级。例如,在编写带子层级的 JSON、YAML 或大纲结构时,内部的相对层级能够被完美保留。
3. 配合 .strip() 保证边缘严丝合缝
在代码审美上,大多数开发者习惯将闭合的 """ 单独起一行,以便与当前作用域的缩进对齐。这会在字符串末尾产生一个换行符和若干空格。调用 .strip() 能够一次性清理掉首尾多余的空白字符与空行。
将这三者结合起来,就构成了工业级代码中最推崇的优雅多行字符串范式:
from textwrap import dedent

def get_service_config():
    # 1. 开头使用反斜杠抵消换行
    # 2. 内部内容随代码正常缩进(8个空格)
    # 3. 闭合引号独立成行,并链式调用 strip()
    config_yaml = dedent("""\
        server:
          host: 0.0.0.0
          port: 8080
        database:
          pool_size: 20
          timeout: 5.0
    """).strip()

    return config_yaml
执行上述函数后,config_yaml 的第一行 server: 完美顶格,子项 host: 依然保持 2 个空格的相对缩进,整个字符串既没有顶部多余空行,也没有末尾残留空白。
三、与其他前缀特性的协同使用
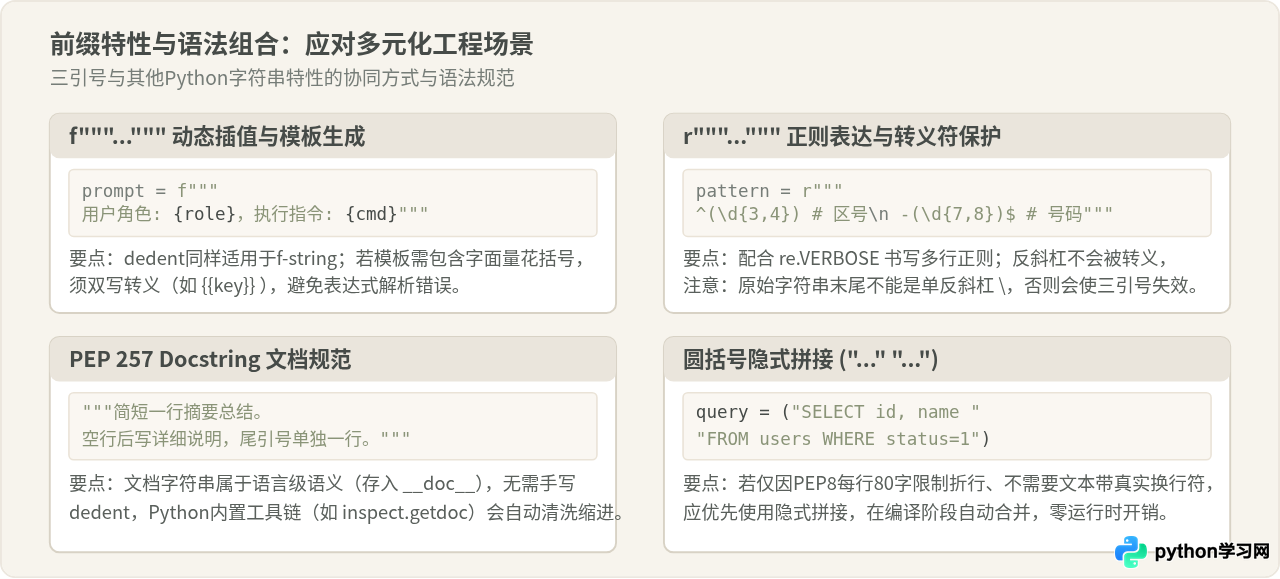
在现代 Python 开发中,三引号多行字符串往往需要配合动态变量插值或原始字符转义。以下是三种最典型的组合模式:
1. 格式化插值:f"""..."""
当需要在多行字符串中注入变量或表达式时,三引号与 f-string 的结合使用频率极高。例如构建大语言模型的 Prompt 或富文本通知模板:
from textwrap import dedent

def render_notification(user, role, tasks):
    return dedent(f"""\
        亲爱的 {user}:
          您当前的系统身份为【{role}】。
          今日待处理任务数:{len(tasks)} 项。
        请在工作日内登录平台查收。
""").strip()若你的多行模板内容本身包含花括号(如生成内联 CSS 样式表或 JSON 字符串结构),必须使用双花括号 {{ 和 }} 进行转义,否则 Python 会将其误判为插值变量表达式。
2. 原始字符串:r"""..."""
当字符串内含有大量反斜杠,且不希望被 Python 解释为转义字符(如 \n、\t)时,应添加 r 前缀。最常见的情形是编写带有注释的多行复杂正则表达式:
import re
from textwrap import dedent

PHONE_PATTERN = re.compile(
    dedent(r"""
        ^              # 匹配行首
        (\+?86)?\s*    # 可选国家码
        (1[3-9]\d{9})  # 中国大陆手机号主体
        $              # 匹配行尾
    """).strip(),
    re.VERBOSE
)
在 re.VERBOSE 标志下,正则表达式引擎会自动忽略未转义的空白符与 # 注释,与三引号多行书写结合,能够让原本晦涩难懂的正则变得极其清晰可读。
四、常见误区与深层概念辨析
在讨论多行字符串时,开发者群体中常有一些容易混淆的习惯做法。我们需要通过具体机理厘清何时适用、何时需要修正。
误区辨析一:“三引号是 Python 的多行注释语法”
为什么看似合理:在很多教程中,常常能看到用未赋值给任何变量的三引号块来“注释”一段无用代码,运行时 Python 也确实不会报错。
真实机理与风险:
- Python 官方语法中只有井号(
#)是真正的单行/多行注释语法。 - 写在函数、类或模块第一行的未赋值三引号字符串,会被编译器识别并绑定为
__doc__属性(即文档字符串 Docstring)。 - 如果写在普通代码逻辑中,未赋值的三引号虽然是一个无害的“独立表达式语句(Expression Statement)”,但解释器仍会将其编译为字节码常量加载并丢弃,既平白浪费解析开销,又容易引起静态检查工具(如 flake8、pylint)的警告。
正确做法:临时注释大段代码时,应使用 IDE 的批量注释快捷键(统一添加 # 前缀);三引号只用于表示真正的字符串数据或模块文档。
误区辨析二:“只要文字很长,就必须用三引号”
为什么看似合理:当单行代码超过 PEP 8 推荐的 79 或 120 字符长度限制时,直觉上就会想到换行,而换行自然会想到三引号。
何时不该用三引号:如果这串长文本在业务逻辑上是一条完整的单行文本(例如一条很长的错误日志提示、一条长 URL 或单行 SQL 查询),若使用三引号,文本内部就会被强制注入 \n。
此时最优雅的方案是利用 Python 编译期的圆括号隐式字符串拼接特性:
# 多个被括号包围的邻接字符串字面量在编译阶段自动合并
# 既满足了代码每行不过长的美观要求,又绝对不产生物理换行符
error_msg = (
    "User authentication failed because the provided credentials "
    "have expired. Please re-login to renew your session token."
)
该方式属于编译器级别的常量折叠(Constant Folding),在字节码中直接合并为一个单一字符串常量,没有任何运行期的函数调用开销。
PEP 257 文档字符串规范的特殊待遇
既然普通函数内的三引号会被缩进污染,那作为函数说明文档的 Docstring 是否也需要手动 dedent 呢?
答案是:不需要。根据 PEP 257 规范,Python 标准库中的文档提取工具(例如 pydoc、help()、inspect.getdoc() 以及 Sphinx 构建器)内部均已集成了类似 textwrap.dedent 的智能清洗算法。因此编写 Docstring 时,只需遵守标准格式:
def calculate_metrics(data_frame, window_size=5):
    """计算指定滑动窗口内的数据指标。

    参数:
        data_frame: 输入的 pandas DataFrame 对象。
        window_size: 移动平均的窗口大小,默认为 5。

    返回:
        包含计算后衍生特征的新 DataFrame。
    """
    pass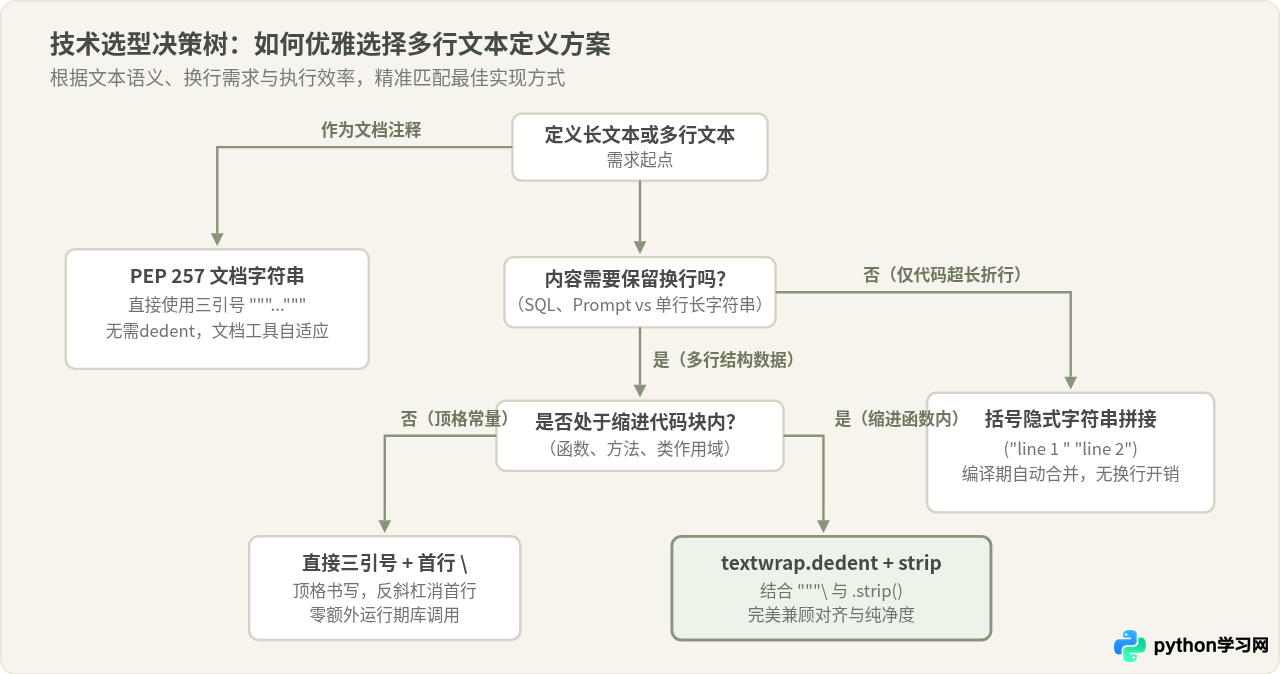
五、实用决策指南与编码清单
| 应用场景 | 推荐写法 | 关键技巧 | 核心优势 |
|---|---|---|---|
| 缩进函数内部的多行数据(SQL、HTML、YAML、Prompt) | dedent("""\...""").strip() |
首行加 \,末行加 .strip() |
源码对齐整洁,输出数据顶格无冗余空白 |
| 模块顶层定义的全局多行常量 | 直接 """\...""".strip() |
代码顶格书写,反斜杠消除首行换行 | 无需导入模块,零运行时函数调用开销 |
| 超长单行文本折行(日志、URL、单行文案) | ("part1 " "part2") 括号隐式拼接 |
每行结尾显式保留必要空格,无需逗号 | 编译期自动折叠,不产生任何换行符 |
| 多行正则表达式 | dedent(r"""...""").strip() |
结合 re.VERBOSE 编写注释 |
免除转义斜杠困扰,逻辑结构一目了然 |
| 模块、类、函数说明文档 | PEP 257 规范文档字符串 """...""" |
首行概括,空行隔开,末引号独占一行 | 被工具链自动解析并规范格式化 |
1. 绝不妥协缩进:不要因为担心空格而将三引号内部的文字贴在编辑器最左侧(第 0 列),这会严重破坏 Python 代码的视觉层次。
2. 明辨换行需求:需要物理换行才用三引号,单纯为了代码排版折行请使用括号隐式拼接。
3. 善用标准库工具:用 textwrap.dedent 代替手动 replace(" ", "") 等易产生副作用的脆弱逻辑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















