


初学者学Python爬虫需要先掌握哪些前置知识?
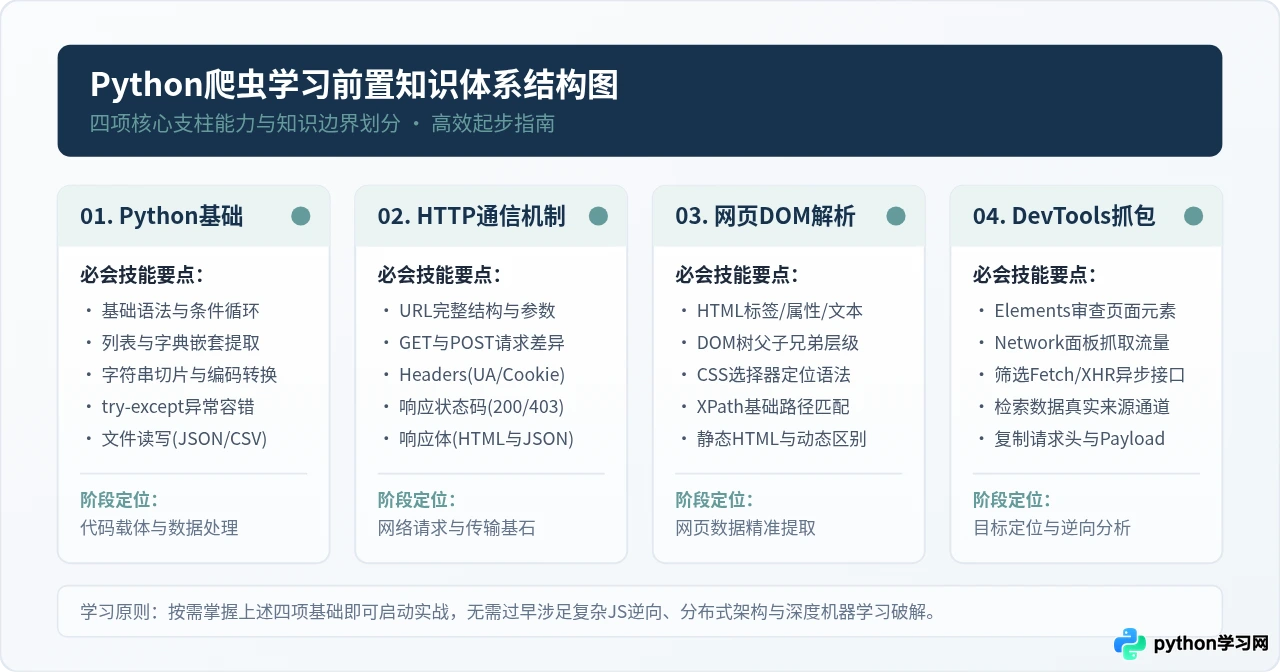
针对初学者学习Python网络爬虫的核心前置知识清单,涵盖Python基础语法与容器操作、HTTP通信机制与请求头、HTML文档树与选择器定位、浏览器开发者工具(DevTools)抓包四大支柱,帮助新手建立清晰扎实的学习路径。
一、Python语言基础:聚焦数据处理与程序容错
许多初学者往往产生误区,以为必须读完几百页的Python进阶书籍才能着手写爬虫。实际上,爬虫前期的重心在于网络请求与文本解析,涉及的高级面向对象设计、元类、复杂闭包等特性在入门期几乎用不上。初学者应当将精力聚焦于以下几项与数据清洗直接相关的核心语法:
1. 控制流与循环迭代
爬虫最常见的工作模式就是“抓取一页数据、解析内容、翻到下一页继续抓取”。这直接对应两类控制结构:
for循环:用于遍历解析出来的列表条目,例如从包含20个新闻卡片的列表里逐一提取标题与链接。while循环:常用于分页爬取控制,配合页码计数器,当返回数据为空或达到指定上限时通过break终止循环。- 条件判断 (
if-elif-else):用于过滤异常或不需要的数据。例如当某些商品没有促销价时跳过,或者剔除广告推广条目。
2. 核心数据结构:列表(list)与字典(dict)的深度取值
网络爬虫拿到的绝大多数结构化数据(尤其是现代Web应用的JSON接口)最终都会转换为Python中的字典与列表相互嵌套的形式。如果无法熟练地从层层嵌套的数据中取出具体字段,爬虫就无法完成任务。
# 示例:从API返回的嵌套字典结构中安全取值
data = {
    "code": 200,
    "result": {
        "total": 45,
        "items": [
            {"id": 101, "title": "Python爬虫快速入门", "price": "免费"},
            {"id": 102, "title": "HTTP协议基础剖析", "price": None}
        ]
    }
}

# 必须掌握:利用 .get() 避免因字段缺失抛出 KeyError
items = data.get("result", {}).get("items", [])
for item in items:
    title = item.get("title", "未知标题")
    price = item.get("price") or "暂无报价"
    print(f"[{item.get('id')}] {title} - {price}")
3. 异常处理机制(try...except)
在编写普通本地脚本时,语法无误通常就能顺序执行。但爬虫面对的是不可控的互联网环境:目标服务器偶尔超时、网络波动导致连接中断、部分页面字段结构突然缺失等。如果不掌握异常捕获,单次请求失败就会让已经抓取了几个小时的脚本直接闪退。
4. 本地文件持久化(File I/O、JSON与CSV)
数据抓取下来的最终目的是留存与分析。初学者无需一上来就安装MySQL或MongoDB,只需掌握Python内置的 open() 上下文管理器,配合 json 模块或 csv 模块,把数据规范写入本地文件即可。
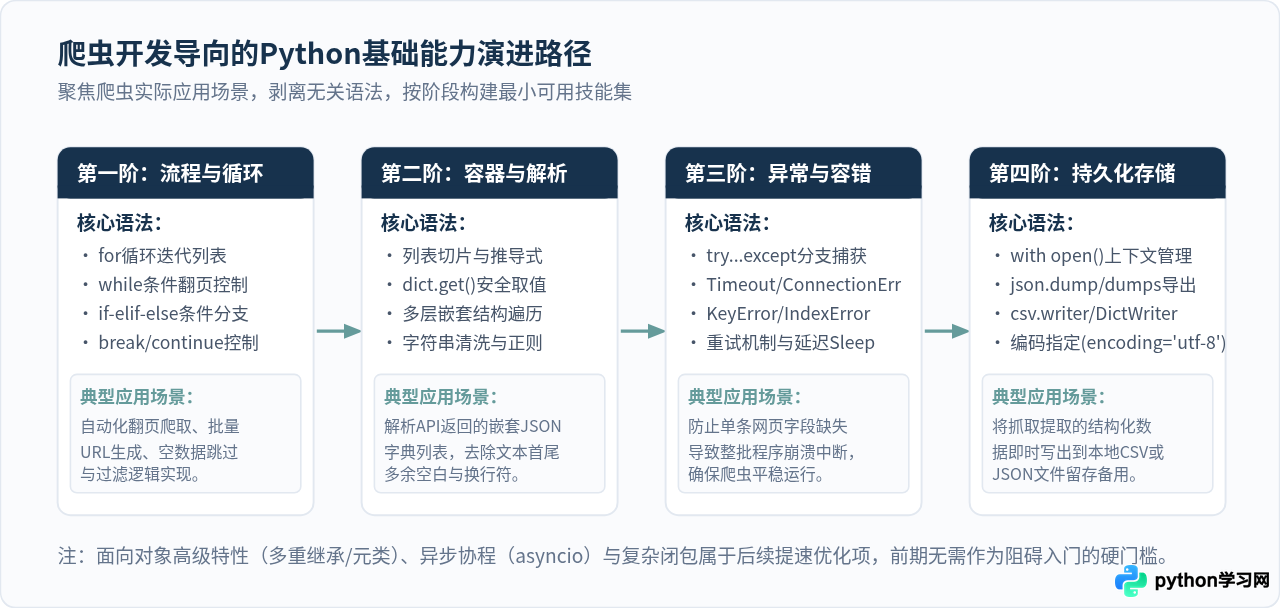
open() 写入文本或CSV文件时,Windows系统默认可能采用本地GBK编码,极易出现中文字符乱码。养成无论读写都显式指定 encoding='utf-8' 的编码习惯,可以规避绝大多数乱码报错。
二、HTTP网络通信协议:搞懂请求与响应的本质
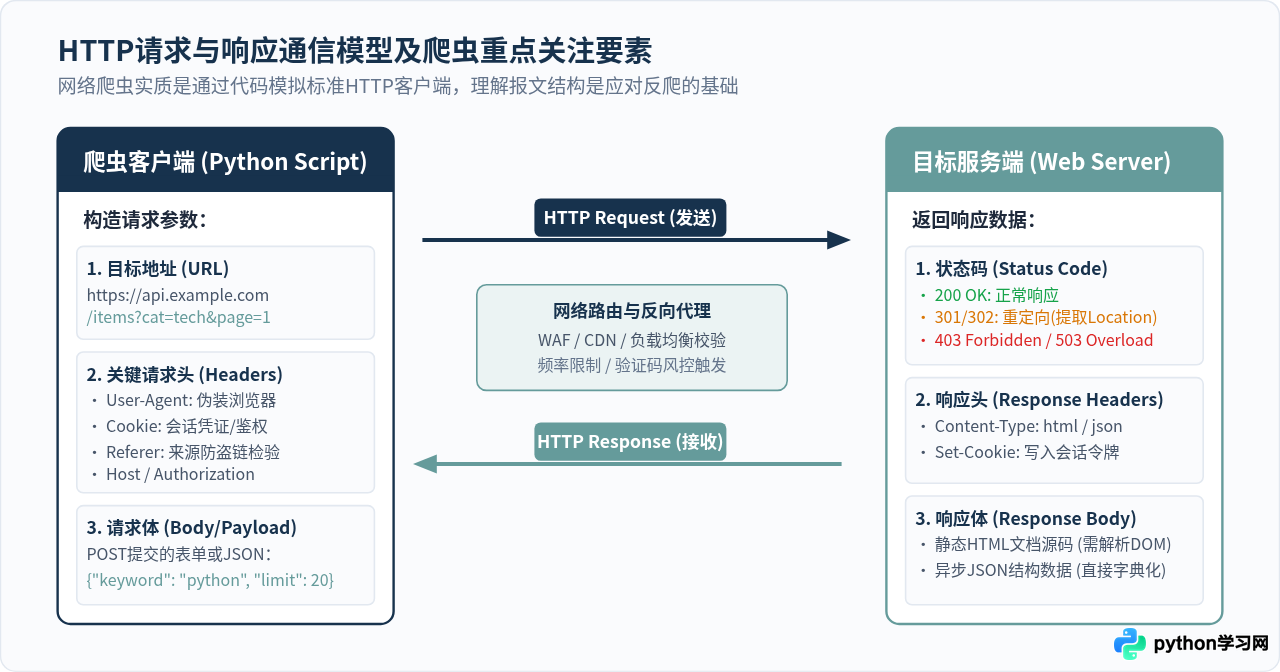
无论是使用简单的 urllib 还是主流的 requests,爬虫执行的代码本质上都是在构建HTTP请求包并解析服务端返回的HTTP响应包。如果不清楚HTTP协议的基本交互机制,就无法理解代码中各种参数的含义,遇到反爬机制时更会无从下手。
1. URL(统一资源定位符)的结构剖析
URL是爬虫的目标地址。一个标准的URL由协议(Protocol)、域名(Host)、端口(Port)、路径(Path)以及查询字符串(Query Parameters)组成:
https://www.example.com:443/search/list?category=book&page=2&sort=hot
└─┬─┘   └──────┬──────┘ └──┬┘ └───┬─────┘ └──────────────┬─────────────┘
协议 主机域名 端口 资源路径 查询参数初学者需要重点理解查询参数(Query String)的传递方式:问号 ? 后面的键值对以 & 连接,爬虫进行多页抓取时,通常就是通过在代码中修改这些参数(例如改变 page=2)来实现翻页请求的。
2. 请求方法:GET 与 POST 的根本区别
| 特性 | GET 请求 | POST 请求 |
|---|---|---|
| 数据传输位置 | 直接拼接在 URL 路径之后(Query Params) | 封装在 HTTP 请求体(Request Body/Payload)内 |
| 可见性与长度限制 | 在浏览器地址栏完全可见,受URL长度限制 | 地址栏不可见,可传输大量文本、表单或JSON |
| 常见爬虫场景 | 搜索列表展示、内容详情页读取、分类检索 | 模拟用户登录、表单提交、复杂筛选异步加载 |
3. 请求头(Request Headers):伪装与鉴权的核心
Web服务器通常会检查请求头,判断访问者是真实用户还是脚本工具。初学者必须掌握四个最常用的字段:
User-Agent:声明访问者的客户端类型、操作系统及浏览器内核版本。绝大多数初级反爬策略只要检测到User-Agent包含类似python-requests字样,就会直接阻断访问。Cookie:保存服务端分发的会话状态与登录身份凭证。抓取需要登录才能查看的页面时,必须在请求头中携带有效的Cookie。Referer:记录当前请求是从哪个网页跳转而来的。许多图片资源或内部API会校验该字段进行防盗链保护。Content-Type:说明客户端发送数据的编码格式(例如表单类型application/x-www-form-urlencoded或数据类型application/json)。
4. 响应状态码(Status Code)含义与应对逻辑
向服务端发送请求后,首先需要通过状态码判断请求是否正常完成:
- 200 OK:请求完全成功,可以安全提取响应内容。
- 301 / 302:页面发生永久或临时重定向。此时若需要获取最终数据,应跟踪跳转后的
Location地址。 - 403 Forbidden:客户端被服务器拒绝访问。这往往意味着触发了目标站点的反爬风控(如缺少请求头、IP访问频次超限或Cookie失效)。
- 404 Not Found:请求的资源路径不存在,应核查URL或参数拼接是否错误。
- 500 / 502 / 503:服务器内部故障、网关错误或服务过载。通常需要设置短暂休眠并执行重试机制。
三、前端基础:HTML骨架与DOM树形提取定位
爬虫成功获取到响应数据后,紧接着的工作就是从成百上千行的网页代码中精确抽取出目标字段。理解HTML的基本骨架与层级结构,是写出稳定解析表达式的前提。
1. HTML的基本语法单位
一个标准的HTML标签通常由标签名、属性(Attribute)和文本内容(Text)构成。例如:
<a class="article-link" href="https://example.com/item/1024" id="top-news">Python学习指南</a>
 ▲        ▲                             ▲                           ▲             ▲
标签名 属性名="属性值" 属性名="属性值" 属性名="值" 文本节点在编写解析规则时,我们的目标通常是提取两类内容:一类是标签所夹带的可见文本(如“Python学习指南”),另一类则是特定属性中的链接或媒体地址(如 href 或 src)。
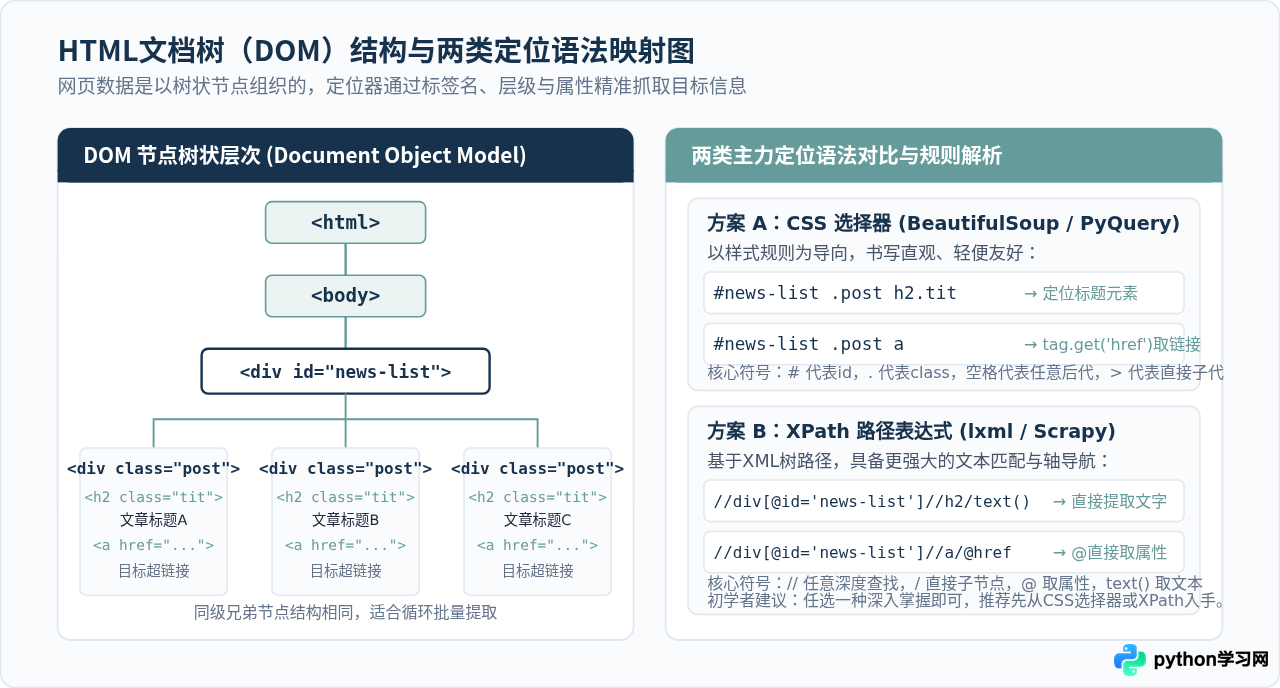
2. DOM(文档对象模型)的树形结构
浏览器在渲染HTML时,会将其解析为一棵树形结构。树上的每个节点都是一个HTML元素,节点之间存在明确的关系:
- 父节点(Parent):直接包含当前节点的上一层标签。
- 子节点(Child):当前标签内部直接包含的下一层标签。
- 兄弟节点(Sibling):同属于一个父节点的同级标签。
在提取类似列表、商品网格等重复元素时,正是利用兄弟节点具有相同 class 名的特征,实现批量循环提取。
3. 定位语法双雄:CSS选择器 与 XPath 的选择
在Python爬虫生态中,最常用的两套解析语法分别是CSS选择器(多配合 BeautifulSoup 或 parsel)和XPath(多配合 lxml)。初学者无需两套同时精通,建议任选一种作为主修工具:
- CSS选择器:语法直观贴近前端习惯。
#id匹配ID,.class匹配类名,空格表示后代查找,>表示子代查找。上手极快。 - XPath:功能更为强大,支持从子节点向上反查父节点(轴运算),并可直接通过
//div[contains(text(), '下一页')]依据文本内容反向定位元素。
四、浏览器开发者工具(DevTools):定位目标数据的排查利器
不少初学者在写第一个爬虫时,直接打开网页把浏览器地址栏的URL复制进代码,结果运行后发现抓回来的HTML里根本没有想要的数据。这是因为现代网页大量采用动态渲染,你眼睛看到的数据未必直接存在于最原始的HTML源码里。学会使用浏览器开发者工具(F12),是找到真实数据来源的关键。
1. Elements(元素面板)的正确用法
在网页任意感兴趣的文字上点击鼠标右键,选择“检查”(Inspect),DevTools会自动高亮显示该内容在当前DOM树中的精确位置。此时可以做两件事:
- 查看该元素周围具有辨识度的
id或class名称,用于辅助构思选择器。 - 在DOM节点上右键选择
Copy > Copy selector或Copy XPath,直接获取浏览器生成的参考定位路径。
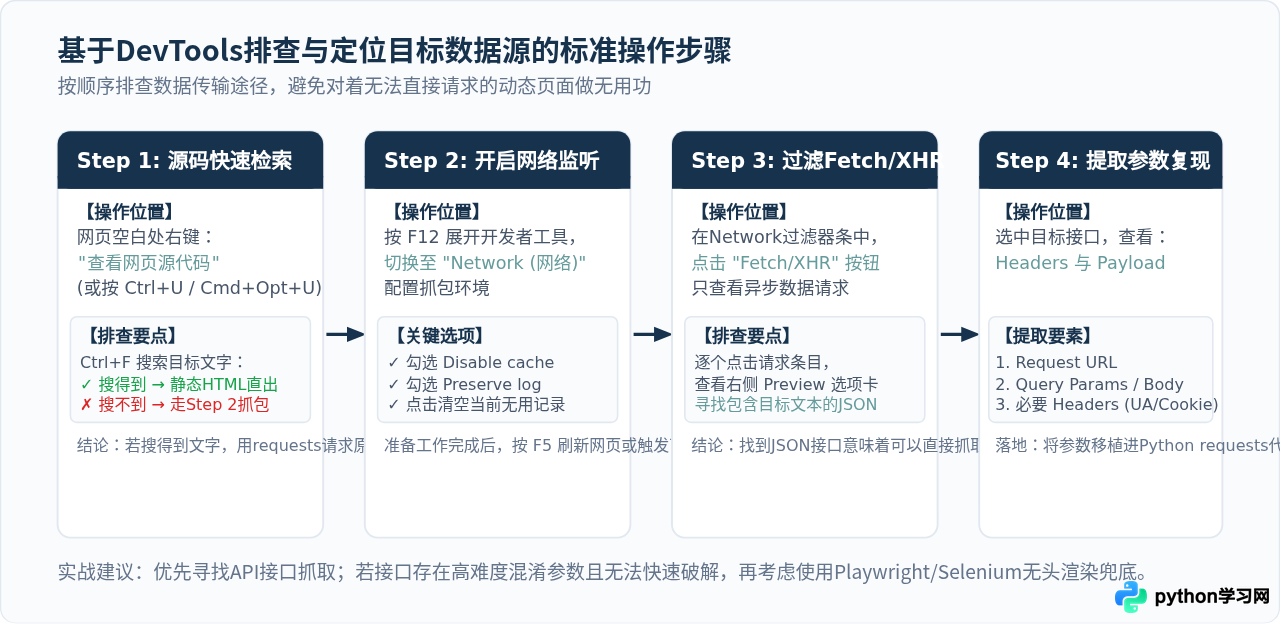
2. 目标数据源排查的标准四步法
面对一个崭新的目标网站,先不要急着写Python代码,先按照以下标准流程走一遍诊断:
- 查看网页原始代码:右键点击“查看网页源代码”(或按
Ctrl+U/Cmd+Opt+U),在打开的纯源码页面按Ctrl+F搜索页面上的某段具体文字。- 如果搜得到:说明是传统的服务端渲染(SSR)页面,直接使用
requests.get(当前URL),配合 BeautifulSoup/XPath 解析即可。 - 如果搜不到:说明数据是通过后续的异步请求动态加载的,进入下一步。
- 如果搜得到:说明是传统的服务端渲染(SSR)页面,直接使用
- 开启网络监听(Network):按
F12展开开发者工具,切换到Network(网络)标签页。勾选Disable cache(停用缓存)和Preserve log(保留日志),然后刷新网页。 - 筛选 Fetch/XHR 请求:在网络请求类型过滤器中,点击
Fetch/XHR按钮。此时面板上只会列出异步数据请求。逐个点击列表项,查看右侧的Preview(预览)窗口。如果发现某个请求返回了整齐的JSON数据,且正好包含了我们要找的目标内容,那么这个请求就是真实的数据接口。 - 提取接口要素复现请求:切换到该请求的
Headers选项卡,复制Request URL、Request Method以及Query String Parameters(或 Request Payload)。直接用Python请求这个接口,不仅解析更简单(直接response.json()转字典),而且抓取效率比解析庞大的HTML高数倍。
五、前置知识自查清单与学习避坑建议
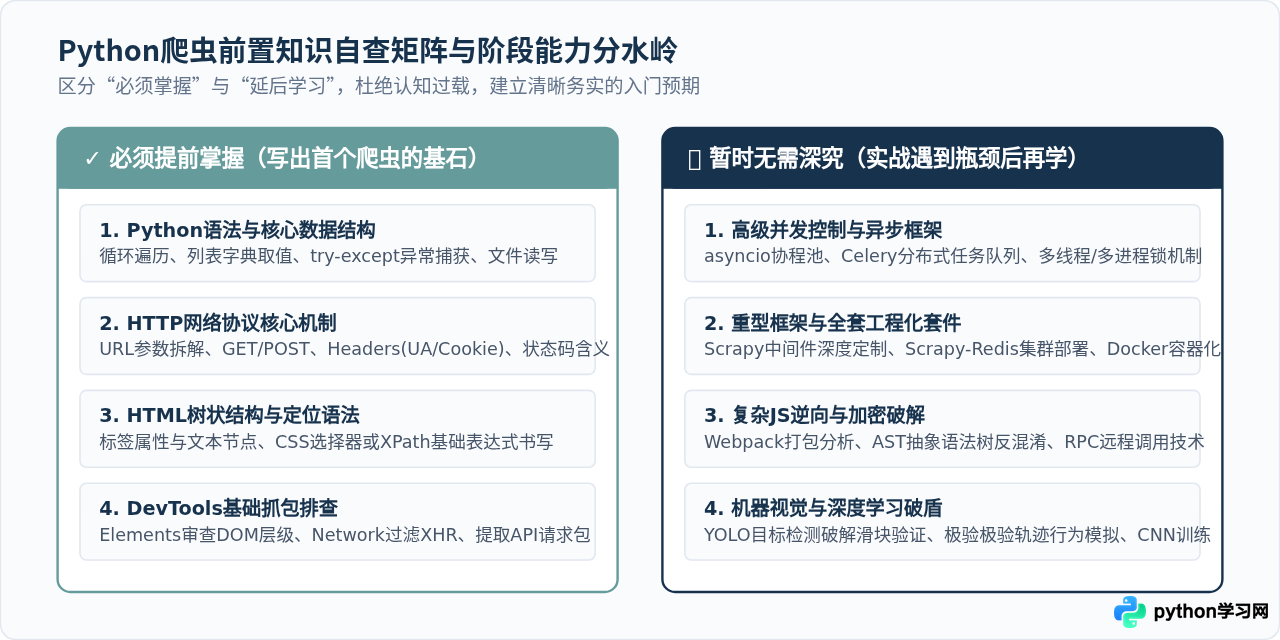
在正式动手写爬虫之前,对照下面的清单做一次简要自查。只要左侧的核心项能够理清,就可以立即开始写你的第一个爬虫项目了;而右侧的内容,强烈建议在后续遇到具体业务瓶颈时再行补充,切忌在起步阶段陷入盲目的“知识大包围”。
初学者起步的三大避坑建议
- 不要一上来就学Scrapy框架:框架虽然功能强大,但封装了大量网络调度与中间件逻辑。如果连基础的HTTP请求与DOM解析都没有亲手写过,一旦框架抛出异常或中间件拦截报错,新手很难定位问题根源。建议先用
requests + BeautifulSoup/lxml原生写出3到5个完整的小案例,建立端到端的直观认知。 - 不要把时间浪费在钻研深度JS逆向与加密解密上:互联网上约80%的基础数据公开网站并不存在极其复杂的JS混淆。新手阶段的目标是掌握标准流程与稳定提取,过早死磕AST解混淆或逆向工程很容易产生严重的挫败感。
- 重视频率控制与礼貌爬取:在循环爬取多个页面时,务必在每次请求之间加入适当的延迟(如
time.sleep(1)),避免给目标服务器造成过大的负载压力,同时也能降低自身IP被临时封禁的风险。
掌握了基础语法、理解了HTTP报文、看懂了HTML层级、学会了用DevTools抓包找接口,你便已经具备了迈入Python爬虫世界最坚实的一套核心装备。接下来,只需挑选一个简单的公开数据网站,开始你的第一次实战代码编写吧。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















