


哪里下载Python 100例源码?GitHub优质带注释资源推荐
本文梳理了GitHub上优质且带中文注释的Python 100例源码资源,详细解析经典基础练习、进阶算法与实战项目的仓库选择,并提供Git克隆与ZIP下载、本地环境验证及源码高效学习方法。
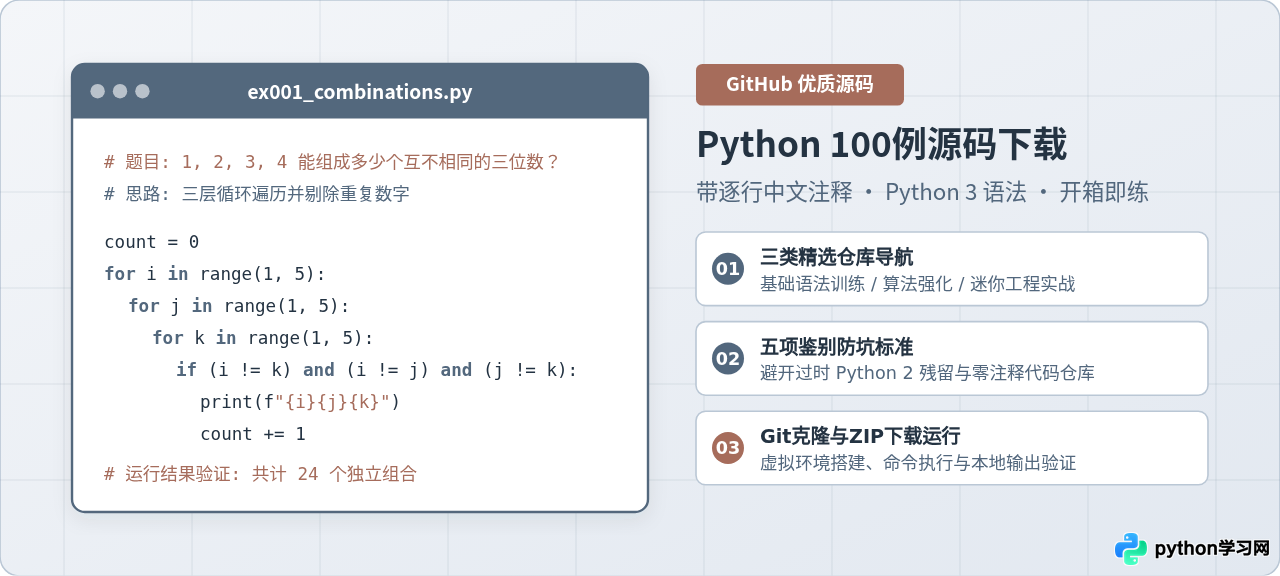
一、精选推荐:三类带详细中文注释的 GitHub 仓库
在 GitHub 检索“Python 100例”时,搜索结果往往成百上千,但质量参差不齐。有的仓库仅将题目简单罗列,缺乏解题思路;有的则是十年前遗留的 Python 2 语法未做更新。根据学习目标与代码深度,以下三类经过中文社区长期检验的开源项目最值得下载:
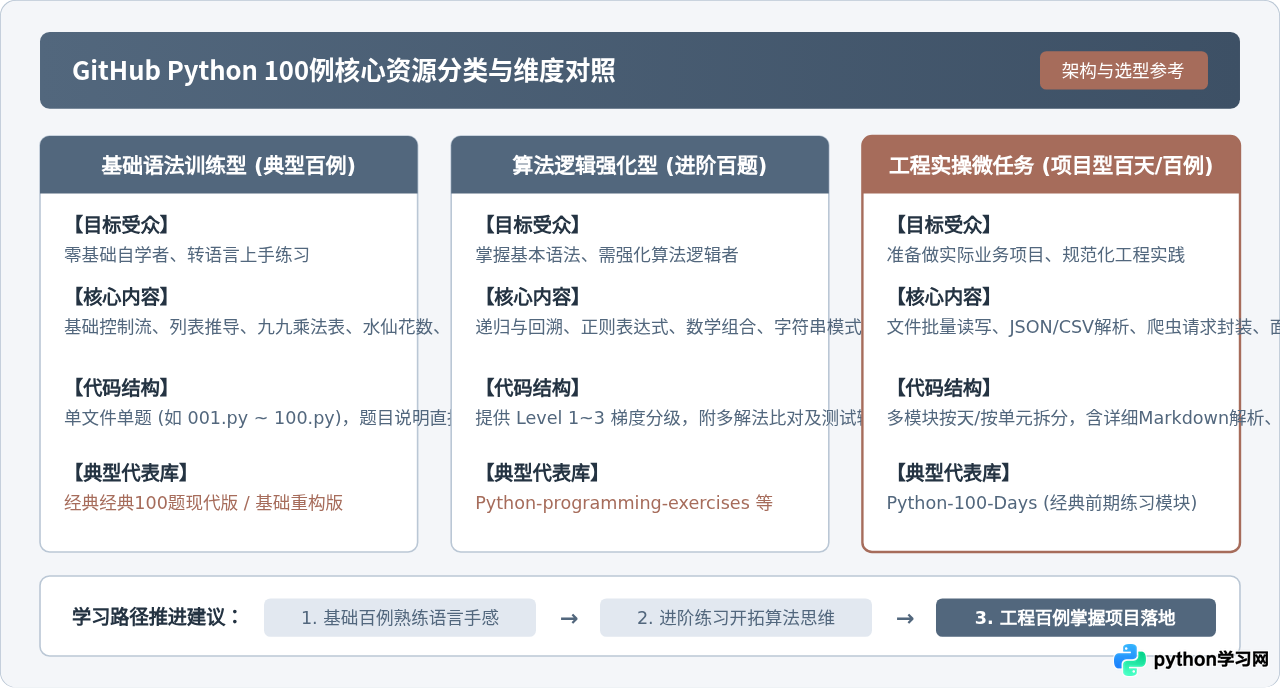
1. 经典基础语法训练型(单题独立 · 适合初学者)
这类仓库源于广泛流传的“经典编程 100 例”(包含水仙花数、九九乘法表、兔子繁殖、素数统计等题目)。优质仓库(如 crazyguitar/pysheeet 的经典题集分支,或按现代语法重构的 python-100-examples 集合)普遍遵循“一个问题一个独立 .py 脚本”的文件结构,如 001_combinations.py 至 100_matrix.py。
其核心价值在于逐题注释:脚本开头用多行文档字符串详细交代题目意图、数学规律推演,并在关键变量声明处给出类型说明。对于刚掌握变量、列表、循环与分支的初学者,这类代码零外部依赖,直接右键运行即可看到预期结果。
2. 算法思维与挑战强化型(分级练习 · 适合巩固强化)
以知名项目 zhiwehu/Python-programming-exercises(包含 100+ 道挑战性编程练习)及其广泛派生的中文带注释分支为代表。该类项目不仅给出一组答案,还针对同一道题目划分 Level 1(基础)、Level 2(进阶)与 Level 3(复杂),并列出“传统循环方式”与“内置高阶函数/推导式”的对比解法。
例如在处理字符频次统计、递归回溯与正则表达式校验题目时,作者在注释中写明了时间复杂度与空间复杂度的考量,非常适合有一定语法底子、希望提升逻辑思维与面试做题速度的自学者。
3. 工程微实战型百天例题(模块化设计 · 适合项目起步)
以 jackfrued/Python-100-Days 仓库前 15 天的经典习题模块最为典型。与单文件脚本不同,该项目将 100 例演化为进阶式的练习单元,涵盖文件批量读写、JSON/CSV 数据解析、面向对象封装及异常捕获。代码完全遵循 PEP 8 规范,带有完整的中文 Docstring 与类型注解(Type Hints),能够让读者提前建立工程化代码的编写习惯。
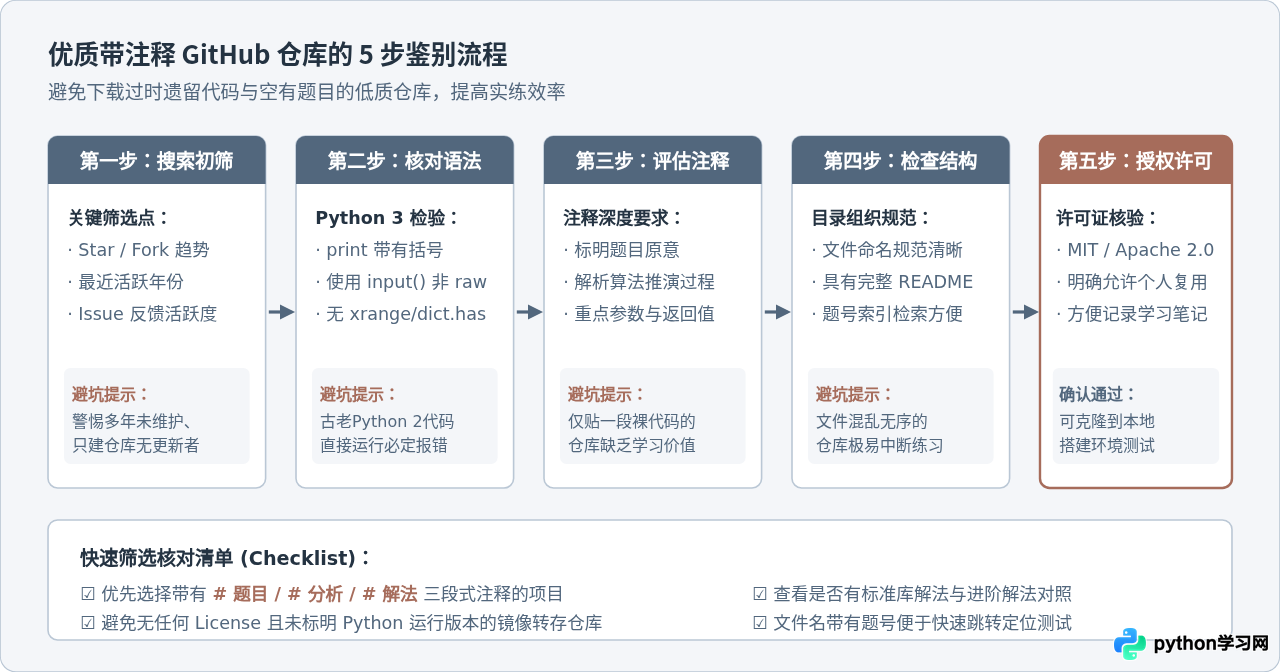
二、避坑指南:鉴别优质带注释仓库的 5 个关键指标
由于很多第三方仓库是早期镜像转存,直接下载可能遭遇环境报错或缺乏参考价值的代码。在点击下载或克隆前,建议读者通过以下 5 个特征快速筛选:
- 1. Python 3 语法核验:检查脚本中是否包含
print "xxx"(无括号)、raw_input()或xrange()。凡是带有此类 Python 2 遗留语法的项目,在现代 Python 3 环境下会直接抛出SyntaxError或NameError,必须排除。 - 2. 注释深度与推导说明:优秀的开源注释遵循“题目描述 + 算法思路 + 关键变量功能 + 复杂度”结构,而不是仅有一行函数名。有注释的解法不仅能告诉你“怎么写”,还能让你读懂“为什么这样组织条件”。
- 3. 目录与命名规范:优先选择单题以数字编号规范命名(例如
ex001_perm.py、day03_guess_number.py)的项目,仓库根目录下应附有完整的README.md目录索引,方便按知识点检索。 - 4. 依赖项透明度:练习题应以 Python 标准库(
math、random、itertools、collections等)为主。如果涉及第三方模块,仓库中必须提供清晰的requirements.txt,否则排查缺失模块将耗费大量时间。 - 5. 开源许可协议明确:优先选择采用 MIT 或 Apache 2.0 许可证的项目,保障读者在记录个人学习笔记、二次改写或在技术博客中引用时的合规性。
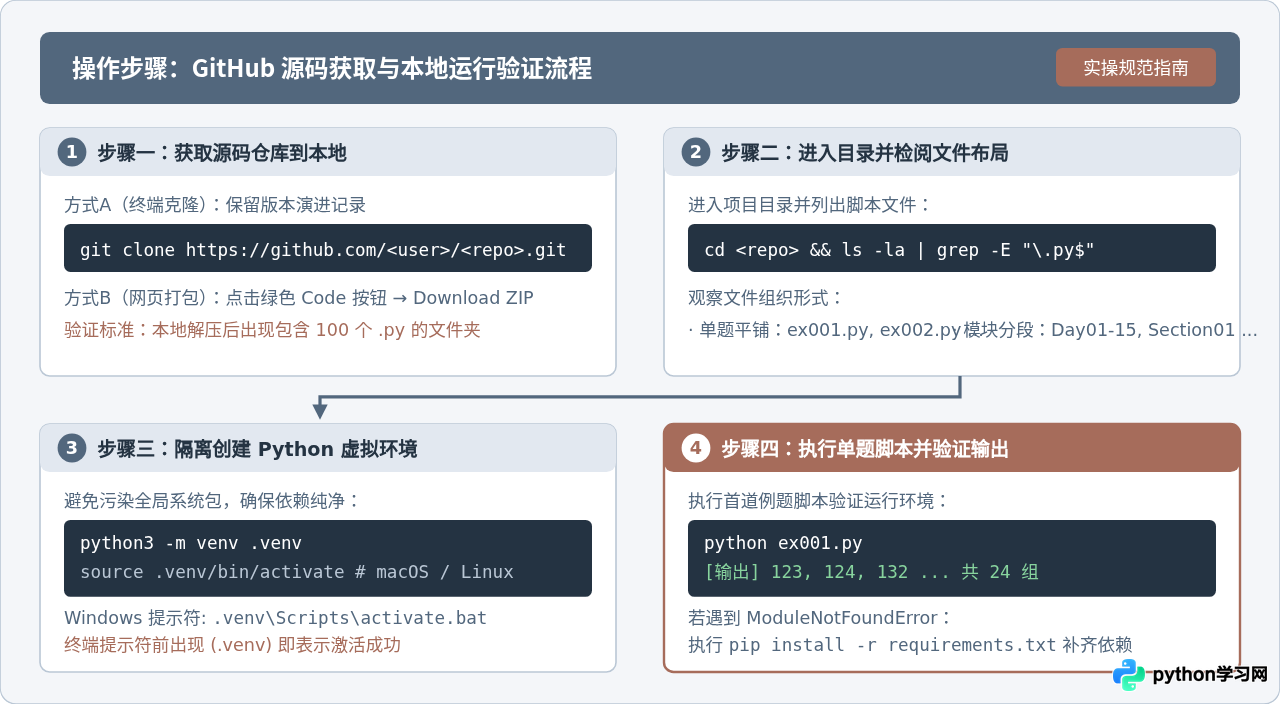
三、下载获取:Git 克隆与网页 ZIP 打包操作步骤
获取 GitHub 仓库有两种标准途径:使用 Git 命令克隆适合希望随时拉取更新或有版本管理需求的读者;网页直接下载 ZIP 压缩包则更适合无需配置 Git 环境、想立即上手练习的读者。
方法 1:使用 Git 命令行完整克隆(推荐)
打开终端(Terminal 或 PowerShell),进入你常用的学习代码目录,执行 git clone 命令。如果网络环境不稳定,可以附加 --depth 1 参数执行浅克隆,仅拉取最新一次提交的历史代码,大幅减少下载耗时:
# 完整克隆仓库(示例格式,实际替换为所选仓库地址)
git clone https://github.com/jackfrued/Python-100-Days.git

# 或者执行浅克隆,仅拉取最新版本以加速下载
git clone --depth 1 https://github.com/jackfrued/Python-100-Days.git

# 进入项目目录并检视源码文件
cd Python-100-Days
ls -la
方法 2:通过 GitHub 网页端直接下载 ZIP 压缩包
若本地未安装 Git,可按以下三个具体动作完成下载:
- 使用浏览器访问目标仓库的 GitHub 主页。
- 在代码列表右上方找到绿色的 Code 下拉按钮并点击。
- 在弹出的菜单中点击最下方的 Download ZIP。浏览器将自动下载一个名为
<repo-name>-main.zip的压缩包。
下载完成后,将压缩包解压到专门的编程练习目录(如 ~/Projects/python_100_cases),避免解压在带有复杂中文字符或空格的系统临时文件夹中,以免后续终端调试时路径解析异常。
四、本地环境搭建与首道例题运行验证
下载好源码后,不要直接用全局 Python 环境运行,建议使用 venv 创建一个独立的隔离环境。这样既能保证依赖纯净,也能防止第三方库版本冲突。
1. 搭建虚拟环境并激活
在终端中进入解压后的源码根目录,执行以下命令:
# 1. 创建名为 .venv 的虚拟环境
python3 -m venv .venv

# 2. 激活虚拟环境
# macOS / Linux 平台执行:
source .venv/bin/activate

# Windows 命令提示符 (CMD) 执行:
.venv\Scriptsctivate.bat

# Windows PowerShell 执行:
.venv\Scripts\Activate.ps1
激活成功后,终端命令行最前端会出现 (.venv) 标识。如果仓库包含 requirements.txt,可执行 pip install -r requirements.txt 补齐依赖;纯语法类练习则无需安装任何额外模块。
2. 运行并核对首道经典例题(Ex001:三位数组合问题)
作为验证,我们可以查看第一题 ex001.py 的典型实现。这道题要求利用 1、2、3、4 四个数字组成互不相同且无重复数字的三位数,并统计总数。以下为带标准中文注释的高质量示例源码:
# -*- coding: utf-8 -*-
"""
【题目 001】
有四个数字:1、2、3、4,能组成多少个互不相同且无重复数字的三位数?各是多少?

【解题思路】
1. 百位、十位、个位分别从 1、2、3、4 中选取,可通过三重嵌套循环遍历所有可能;
2. 剔除三个数位互相重合的情况(即满足 i != j and i != k and j != k);
3. 统计满足条件的组合总数并依次打印输出。
"""

def solve_ex001():
    # 计数器初始化
    count = 0
    results = []

    # 三重循环遍历数字集合
    for i in range(1, 5):
        for j in range(1, 5):
            for k in range(1, 5):
                # 过滤重复数字
                if (i != j) and (i != k) and (j != k):
                    num = i * 100 + j * 10 + k
                    results.append(num)
                    count += 1

    print(f"符合条件的三位数共计: {count} 个")
    print(f"具体列表如下: {results}")
    return count

if __name__ == "__main__":
    solve_ex001()
在终端中输入执行命令:
python ex001.py预期在终端控制台将看到如下清晰输出:
符合条件的三位数共计: 24 个
具体列表如下: [123, 124, 132, 134, 142, 143, 213, 214, 231, 234, 241, 242, 312, 314, 321, 324, 341, 342, 412, 413, 421, 423, 431, 432]SyntaxError: Non-UTF-8 code,请在文件首行补上 # -*- coding: utf-8 -*-,并将文本编辑器编码设为 UTF-8 无 BOM 格式。
五、吸收转化:从“下载代码”到“掌握精髓”的四阶学习法
将代码下载到硬盘只完成了第一步,许多学习者容易陷入“翻看两眼就觉得自己懂了”的误区。要真正将这 100 个案例转化为自己的编程功底,建议采用以下四阶闭环学习策略:
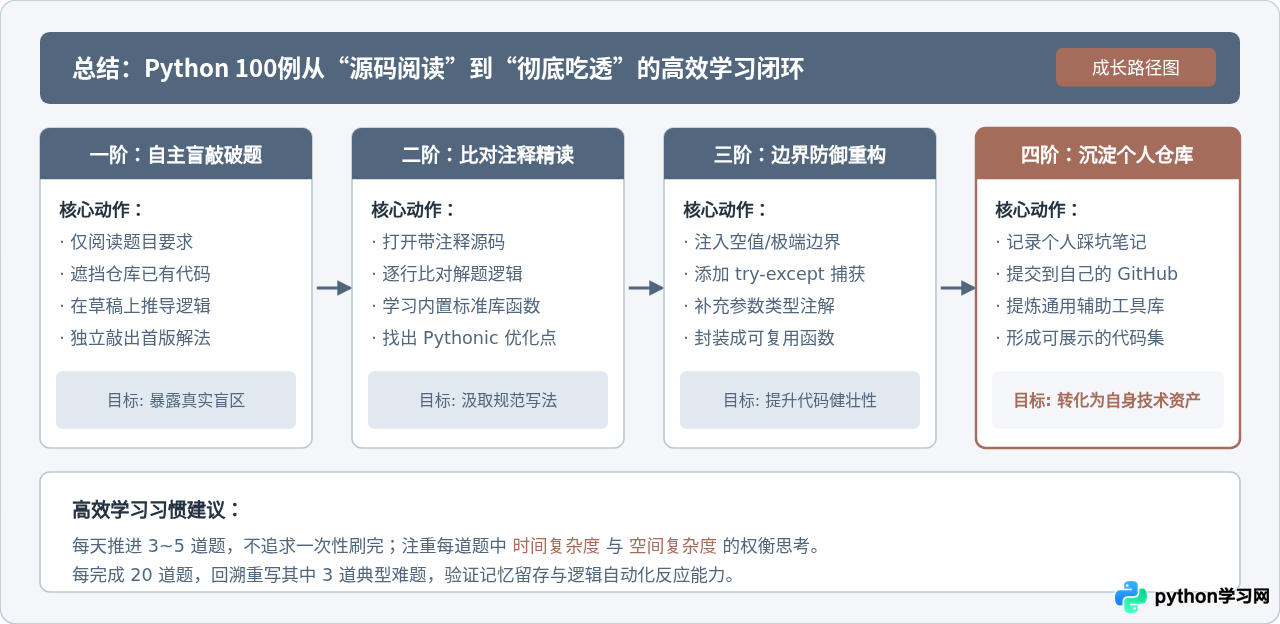
1. 阶段一:自主盲敲破题(暴露真实盲区)
面对一道题目时,先不打开已下载好的答案源码。在纸上或注释中写下解题逻辑,思考涉及哪些数据结构(例如是否需要集合去重、列表排序、字典统计),并尝试自己从零编写首版代码。即使遇到语法卡顿,也先借助官方文档解决,这样能清晰暴露出自己对语法的掌握薄弱点。
2. 阶段二:比对带注释源码(学习规范写法)
在自己完成或思考至少 15 分钟后,再打开 GitHub 仓库中的带注释代码。重点观察仓库作者在命名规范(是否采用小写蛇形命名 snake_case)、循环终止条件判断、以及内置函数使用(如利用 itertools.permutations 替代三重循环)上的技巧,找出自己的冗余代码并进行重构。
3. 阶段三:边界防御重构(提升工程健壮性)
练习题通常只针对理想输入,而实际开发必须应对异常数据。尝试为每个例题加入异常捕获(如 try-except 校验非整数输入)与参数类型注解。测试当传入空列表、负数、极大值时的运行表现,培养严谨的工程思维。
4. 阶段四:沉淀个人仓库(转化为技术资产)
建立自己的 GitHub 练习仓库,用自己的理解重写注释,记录在每道题中踩过的逻辑陷阱。这不仅能巩固记忆,也能在日后的求职与技术面试中,成为展示自己持续编程实践的清晰作品集。
| 学习阶段 | 核心目标 | 输出检验物 | 推荐频次 |
|---|---|---|---|
| 第 1~30 题 | 掌握基础控制流、字符串切片与基本算术推演 | 独立运行的单题脚本,无逻辑语法报错 | 每天 3~5 题 |
| 第 31~70 题 | 熟练运用列表/字典推导、函数封装与递归调用 | 增加多种解法对比注释与基础单元测试 | 每天 2~3 题 |
| 第 71~100 题 | 理解面向对象编程、正则匹配、文件 IO 与异常机制 | 具备防御性编程的模块化工具函数集 | 每天 1~2 题 |
掌握 Python 并不在于把 100 例代码原封不动地存进收藏夹,而在于理解每道题背后对数据结构与算法逻辑的拆解过程。按照上述方法筛选出适合自己的优质带注释项目,克隆到本地脚踏实地跑通每一道题,便能稳步建立起扎实的编程手感。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















