


Python类中私有变量怎么定义?_与__前缀的区别
深入讲解Python类中私有变量的定义方式,系统剖析单下划线(_)与双下划线(__)前缀在语法机制、名称改写(Name Mangling)、作用域、子类继承及实际工程应用中的核心区别与最佳实践。
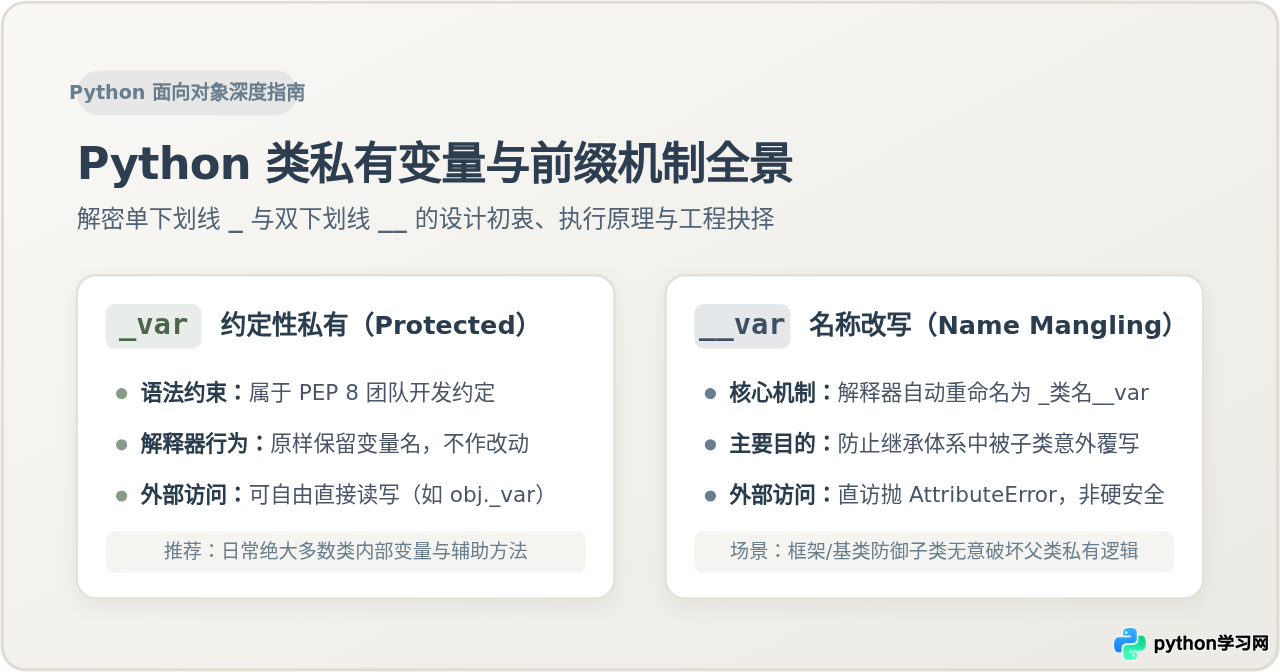
private 强隔离关键字。定义“私有属性”通常有两种方式:使用单下划线前缀(如 _var)表示团队约定上的受保护属性,解释器不会做任何强制拦截;使用双下划线前缀(如 __var)则会触发 Python 的名称改写(Name Mangling)机制,解释器自动将其重命名为 _类名__var。本文通过具体代码、底层原理剖析与继承场景对照,帮助你彻底理清两者的本质差异与正确用法。
1. 核心定义方式与快速代码对照
在 Python 的类设计中,变量的访问权限完全由命名约定和前缀规则决定。我们在一个简单的用户类中同时声明公开变量、单下划线变量和双下划线变量,来观察其直观语法:
class UserAccount:
    def __init__(self, username, email, password):
        self.username = username          # 公开变量(Public):随时随地可访问与修改
        self._email = email              # 单下划线(Protected):约定私有,提示外部请勿直连
        self.__password = password        # 双下划线(Private):触发改写,防止子类冲突

user = UserAccount("alex", "alex@example.com", "Secret@123")

# 1. 访问公开变量
print(user.username)     # 正常输出: alex

# 2. 访问单下划线变量
print(user._email)       # 正常输出: alex@example.com (语法允许,但违背了编码约定)

# 3. 访问双下划线变量
try:
    print(user.__password)
except AttributeError as e:
print("直接访问报错:", e)alex@example.com
直接访问报错: 'UserAccount' object has no attribute '__password'
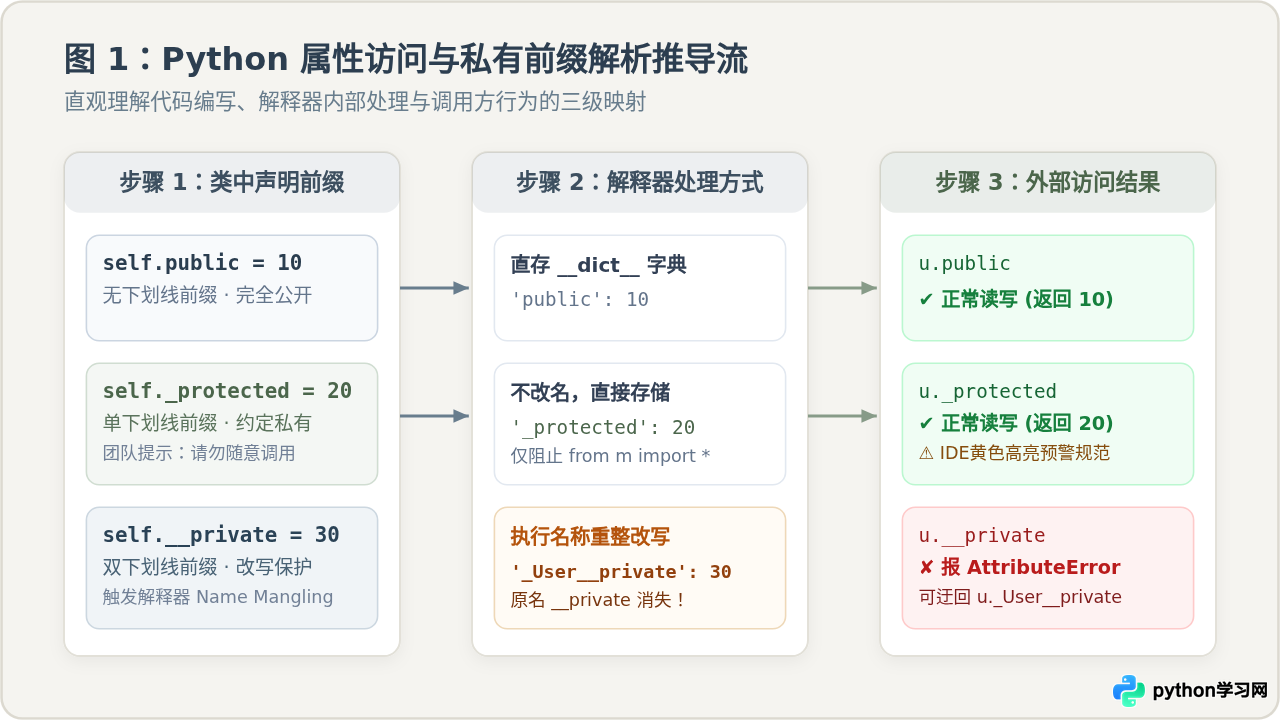
从上面的结果可以看到:公开变量和单下划线变量在运行时都可以毫无阻碍地访问,而双下划线变量直接访问却抛出了 AttributeError。这种现象背后的逻辑是什么?接下来我们一步步推导其执行过程。
2. 单下划线 _var:约定俗成的保护规范
单下划线前缀(如 _name、_service)在 Python 中被称为弱“内部使用”标示(Internal Indicator)。它是 Python 社区公认的《PEP 8 编码规范》中的一部分,遵循“大家都是成年人(We are all consenting adults here)”的语言哲学。
2.1 行为特征与语法表现
- 解释器不介入改名:解释器在加载该属性时,原原本本地将其存储在对象的命名空间中,属性名依旧是
_var。 - 外部可直接读写:虽然外部代码可以执行
obj._email = "new@mail.com",但现代 IDE(如 PyCharm、VS Code)会自动将该属性标记为浅色或给出警告,提醒开发者这是非公开 API。 - 模块级导入屏蔽:如果单下划线变量或函数定义在模块顶层(.py文件顶层),当其他模块使用
from module import *时,以_开头的名称不会被自动导入,从而避免污染导入者的全局命名空间(除非模块显式声明了__all__列表)。
3. 双下划线 __var:名称改写(Name Mangling)机制
与单下划线的纯道德约束不同,双下划线前缀(以至少两个下划线开头,且最多一个下划线结尾)会直接触发 Python 解释器的编译器级处理机制——名称改写(Name Mangling)。
3.1 名称改写是如何运作的?
当 Python 编译器解析到类定义中的 __var 时,会自动在其前面添加一个下划线和当前类的类名,将其静默转换成:
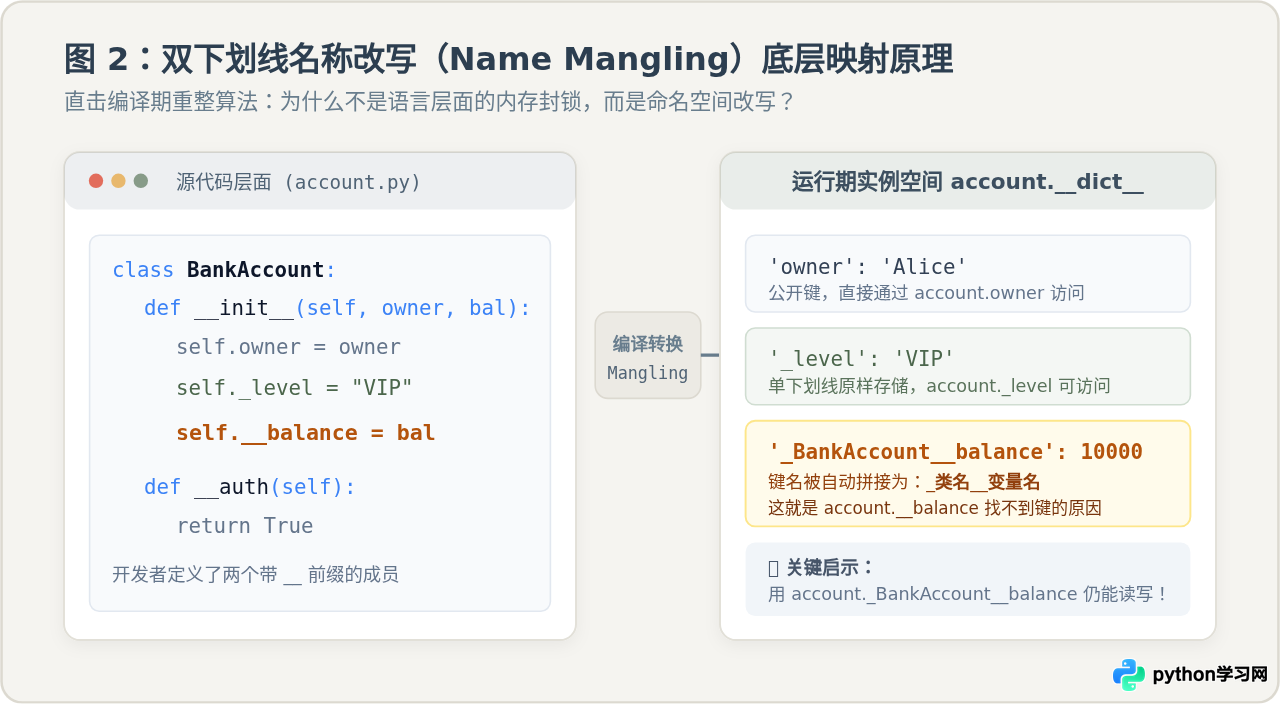
_<类名>__<变量名>例如在 UserAccount 类中,属性 self.__password 在编译后存入底层字典的名字被替换成了 _UserAccount__password。这就是为什么调用 user.__password 会报错——因为该实例的命名空间中根本不存在名为 __password 的键!
3.2 验证底层命名空间:__dict__ 的真相
我们可以打印实例的 __dict__ 属性,直接查看内存中存储的键值对:
# 查看实例的真实命名空间字典
print(user.__dict__)

# 使用改写后的真实名称依然可以读取和修改
print("通过改写名访问:", user._UserAccount__password)
user._UserAccount__password = "Modified@456"
print("修改后再次查看:", user._UserAccount__password)通过改写名访问: Secret@123
修改后再次查看: Modified@456
user._UserAccount__password 访问甚至篡改其值。Python 的名称改写机制初衷绝不是为了提供安全防护,而纯粹是为了解决面向对象继承体系中的名称冲突问题。
4. 核心维度对比:_ 与 __ 的关键差异
为了让差异更具可操作性,我们将单下划线与双下划线在各个维度的表现汇总如下:
| 对比维度 | 单下划线前缀 _var |
双下划线前缀 __var |
|---|---|---|
| 语法定位 | PEP 8 团队开发约定(Protected) | 解释器支持的名称改写(Name Mangling) |
| 解释器行为 | 不作任何重命名,保持原名 | 自动改写为 _类名__变量名 |
| 外部直接访问 | 可正常访问(IDE 提示警告) | 直接抛出 AttributeError |
| 迂回访问可能 | 无需迂回 | 可通过 obj._类名__var 强制访问 |
| 模块导入影响 | 阻止 from module import * 导入 |
无额外模块级特殊语法,仅用于类内 |
| 子类继承行为 | 子类若定义同名变量将直接覆盖父类 | 子类与父类分别拥有独立前缀,完全互不干扰 |
| 工程推荐度 | 绝大多数场景首选 | 仅在基类防覆写时谨慎使用 |
5. 实战场景:子类继承冲突与防御机制
双下划线最无可替代的价值,发生于具有多级继承关系的复杂代码库或公开库框架中。当多个子类由不同团队或第三方用户编写时,子类作者很可能不知道基类内部使用过某个私有变量。
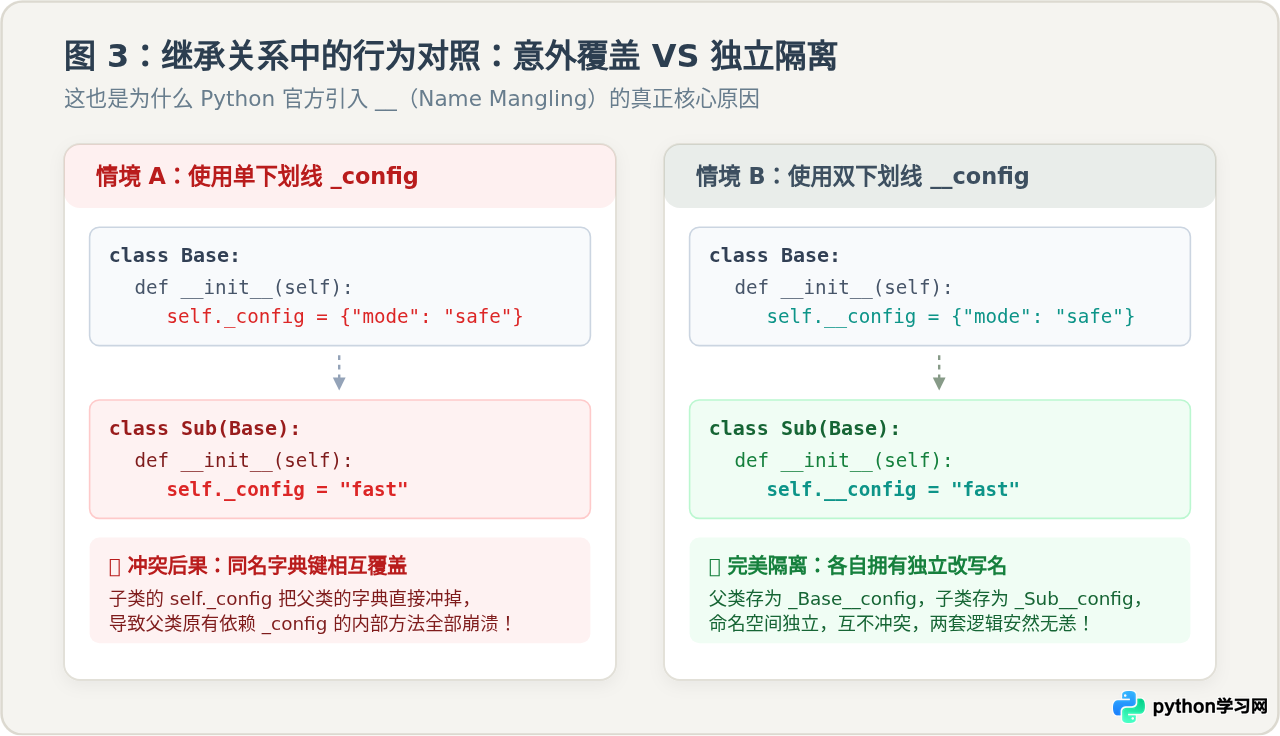
5.1 场景一:使用单下划线导致的意外灾难
假设我们编写一个任务调度基类,基类中维护内部配置 _options,并在执行时依赖该配置:
class TaskBase:
    def __init__(self):
        self._options = {"retry": 3, "timeout": 10}

    def run(self):
        # 父类方法假定 _options 始终是字典
        print("重试次数:", self._options["retry"])

class CustomTask(TaskBase):
    def __init__(self):
        super().__init__()
        # 子类无意中定义了同名属性,却赋了字符串类型
        self._options = "debug_mode"

task = CustomTask()
try:
    task.run()
except TypeError as e:
print("运行时崩溃:", e)在此案例中,子类的 self._options = "debug_mode" 直接洗掉了父类的字典,使得父类的 run() 方法在调用 self._options["retry"] 时当场抛出异常。
5.2 场景二:使用双下划线实现完美的命名隔离
如果我们把基类中的变量改为双下划线 __options:
class SafeTaskBase:
    def __init__(self):
        self.__options = {"retry": 3, "timeout": 10}

    def run(self):
        # 编译期被转为 self._SafeTaskBase__options
        print("父类安全读取重试配置:", self.__options["retry"])

class SafeCustomTask(SafeTaskBase):
    def __init__(self):
        super().__init__()
        # 子类同样定义 __options,被编译为 self._SafeCustomTask__options
        self.__options = "debug_mode"

    def show_custom(self):
        print("子类独立配置:", self.__options)

task = SafeCustomTask()
task.run()
task.show_custom()
print("对象内部并存两套独立状态:", task.__dict__)子类独立配置: debug_mode
对象内部并存两套独立状态: {'_SafeTaskBase__options': {'retry': 3, 'timeout': 10}, '_SafeCustomTask__options': 'debug_mode'}
父类和子类拥有各自改写后的命名空间,彼此变量相互隔离。这正是双下划线在设计上的真正使命所在!
6. 常见误区与最佳实践法则
6.1 常见误区排查
- 误区一:混淆
__var与__var__。
双下划线开头且双下划线结尾的名称(如__init__、__str__、__len__)是 Python 的魔术方法/属性(Magic / Dunder Method),拥有特定的系统协议语义。解释器绝不会对__var__进行名称改写。日常编写业务代码时,切忌自定义以双下划线开头并结尾的名称。 - 误区二:盲目滥用双下划线装作“高深”。
很多从 Java/C++ 转入 Python 的开发者,习惯性地把所有私有字段都冠以__。这会导致子类扩展变硬、单元测试做 Mock 极度别扭、序列化和动态调试异常繁琐。
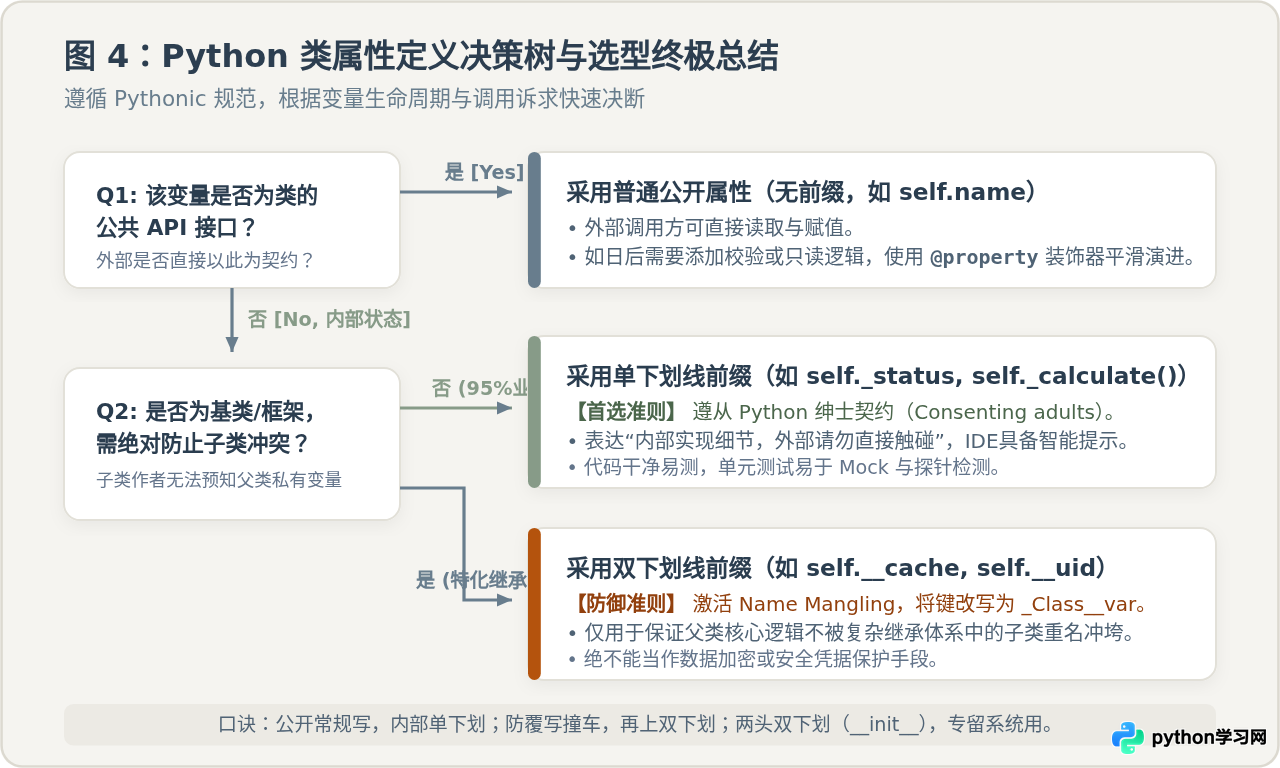
6.2 工程选型最佳实践指南
- 默认优先使用单下划线
_:告知团队“这是私有实现”,保持代码轻盈灵活。 - 需要外部读写保护时,配合
@property:通过属性装饰器将单下划线变量暴露为只读属性或加入校验逻辑,而非使用双下划线。 - 只有基类防止未来未知子类重名破坏时,才使用
__:在编写通用框架、可被无限扩展的基类库时,使用双下划线保护核心内部方法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















