


面试官问数据清洗用pandas还是Polars怎么答?
面对面试官提出的数据清洗工具选型问题,本文提供一套从底层机制、数据规模分水岭、代码范式到工程权衡的四步结构化应答策略与完整技术解析。
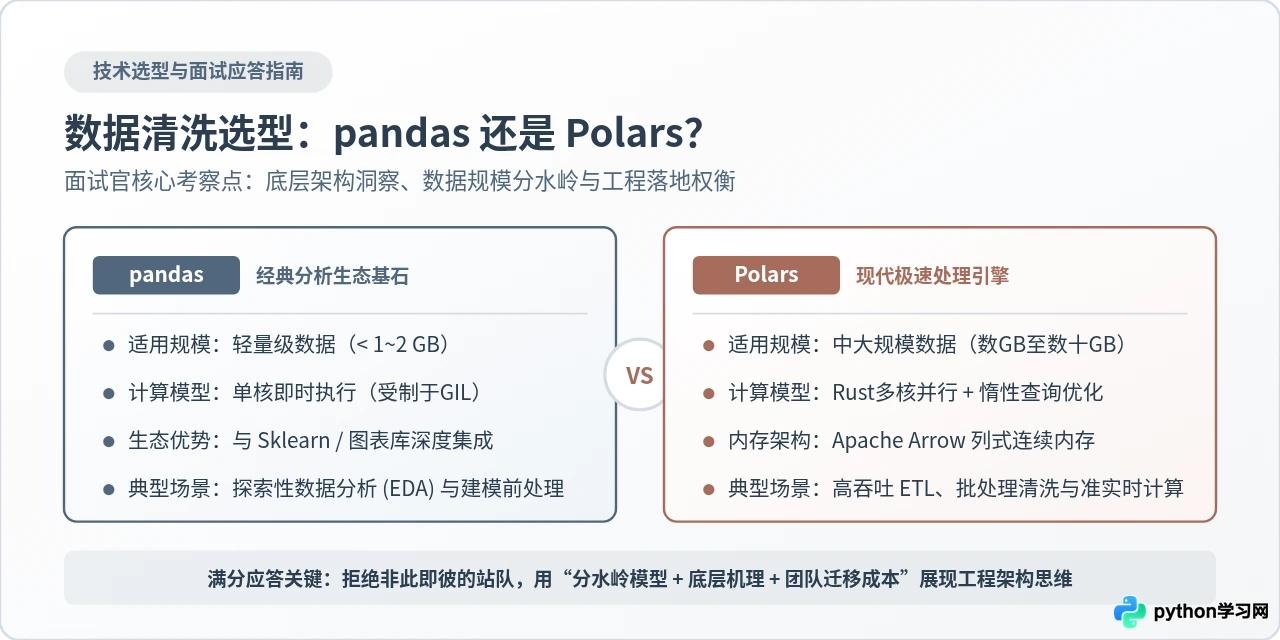
当面试官抛出“数据清洗用 pandas 还是 Polars”时,核心考察的不是死记硬背两者的 API 差异,更不是要求候选人盲目站队新技术,而是考察你对数据处理底层瓶颈(内存布局、GIL、并行计算)的认知深度,以及在真实业务中平衡性能开销、团队技能与上下游生态的工程选型素养。一个能拿到高分的回答,应当先给出客观分水岭,再从底层机制、语法范式与系统边界层层展开。
一、破题核心:拒绝单选,先立“分水岭”基准
面对这类带有“二选一”倾向的选型提问,最容易丢分的做法是立刻下断言:“现在必须全面用 Polars,因为它比 pandas 快几十倍”,或是保守地说“只用 pandas 就够了,Polars 还不普及”。这两种回答在面试官看来都缺乏工程理性。
成熟的破题原则是:明确以“数据规模”与“流水线场景”作为技术选型的分水岭。先直接亮出你的选型法则:
- 轻量级交互分析(数据量 < 1~2GB):当数据完全能够装入内存,且清洗目标紧密连接探索性数据分析(EDA)、统计检验或直接供给 Scikit-Learn、Statsmodels 建模时,pandas 依然是阻力最小、生态互通成本最低的成熟首选。
- 中大规模生产级清洗(数据量在数 GB 至数十 GB,或持续批处理 ETL):当单机面临内存膨胀、处理延迟敏感或多核资源长期空转时,Polars 在多线程并行吞吐、内存紧凑度与惰性查询优化上具备压倒性优势。
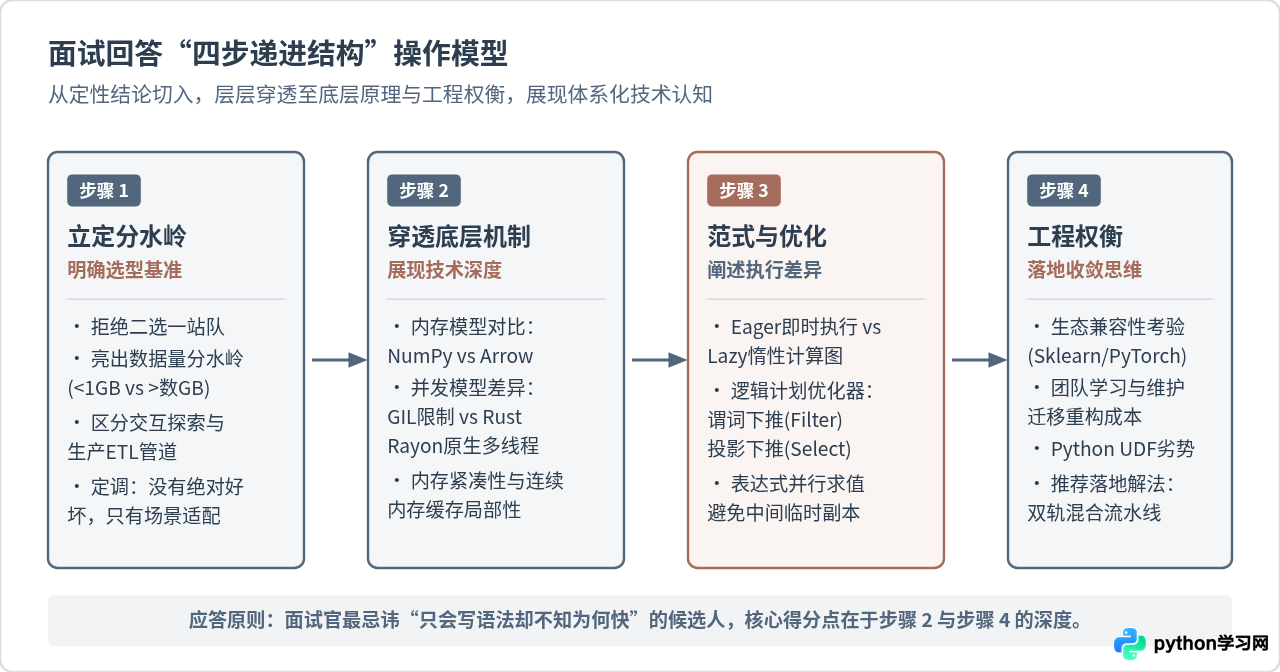
明确了分水岭后,便可以按照“立定分水岭 → 穿透底层机制 → 范式与优化 → 工程权衡落地”的四步结构组织回答,让面试官看到一个逻辑闭环、具备架构思维的答题路径。
二、底层机制对比:面试官最想听到的技术深度
亮出结论后,面试官通常会进一步深挖:“为什么 Polars 会比 pandas 快?快在哪?”此时不能泛泛而谈“因为底层是用 Rust 写的”,而必须从内存布局、并发模型与执行引擎三个技术细节切入。
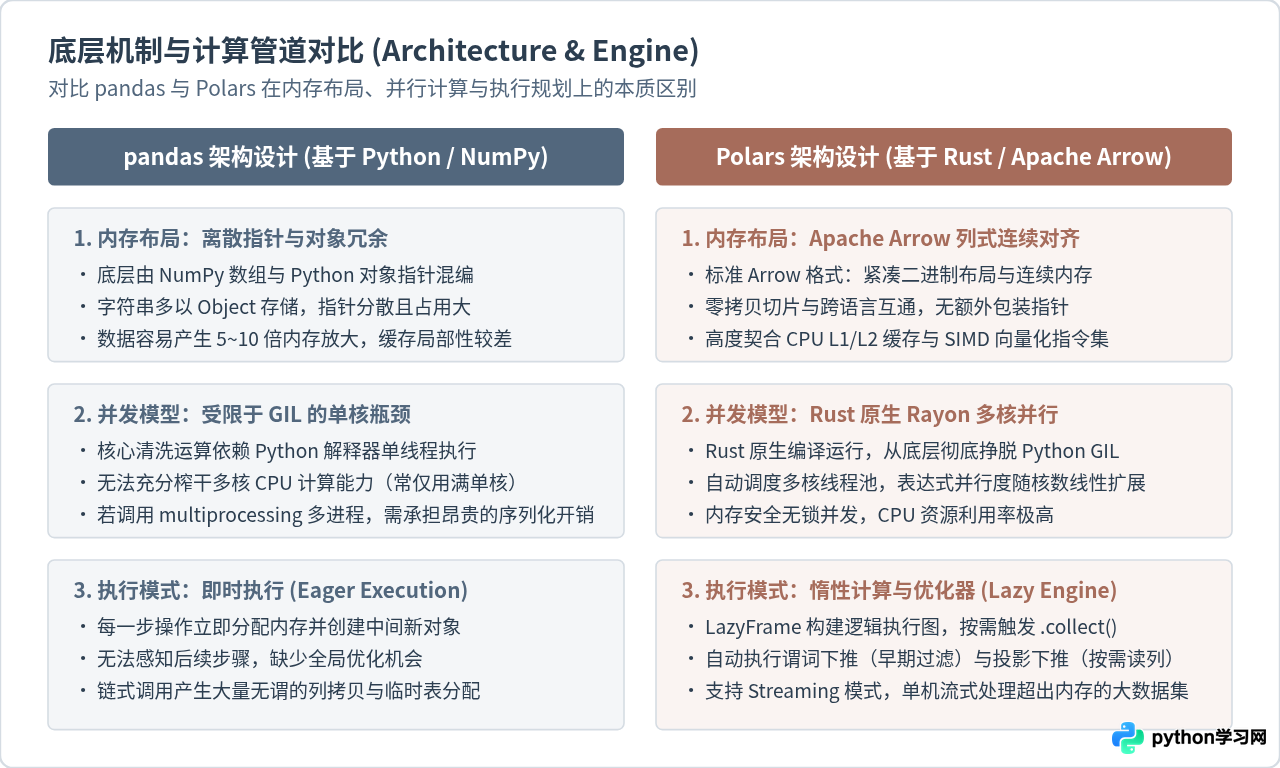
1. 内存模型:离散对象 vs. Apache Arrow 列式连续对齐
pandas 基于 NumPy 数组演进而来,早期在数值类型上表现良好,但在清洗常见的字符串、非对齐缺失值(NaN/None)时,底层往往回退到 Python Object 指针数组。每个元素都是堆上分散分配的独立对象,不仅指针开销巨大(常见 CSV 文件加载后内存放大 5 到 10 倍),更破坏了 CPU 的空间局部性,导致大量 CPU 缓存未命中(Cache Miss)。
Polars 底层完全构建在 Apache Arrow 标准之上。数据以扁平、紧凑的列式格式存放在连续内存块中,布尔位图(Bitmask)用于追踪缺失值,字符串采用连续字节缓冲区与偏移量索引。这种结构带来了双重红利:内存开销通常仅为 pandas 的三分之一到五分之一,且高度契合现代 CPU 的 L1/L2 缓存与 SIMD(单指令多数据流)向量化指令。
2. 并发模型:GIL 锁单核瓶颈 vs. Rust 原生 Rayon 多线程
Python 解释器的全局解释器锁(GIL)决定了纯 Python 代码同一时间只能在一个操作系统线程中执行。虽然 pandas 的部分底层 NumPy C 扩展能短暂释放 GIL,但在复杂的清洗逻辑(如自定义清洗、字符串切分、分组聚合)中,pandas 的运算基本局限在单个 CPU 核心上,服务器的其他 15 个或 31 个核心处于闲置状态。
Polars 的计算核心由 Rust 编译而成,其内部调度由成熟的 Rayon 数据并行库驱动。在执行过滤、排序或哈希聚合时,Polars 会自动将数据分片分配给所有可用的物理核心并行执行,整个运算脱离 Python GIL,将多核硬件算力榨干,且无锁并发保证了内存安全性。
3. 执行规划:即时执行(Eager)vs. 惰性计算图(LazyFrame)
pandas 是典型的即时执行模型。每一行代码执行时,都会立即在内存中生成新的 DataFrame 对象。例如连续调用 df.drop().rename().filter(),每一步都在开辟临时内存,无法得知后续操作,造成大量不必要的内存分配与中间表拷贝。
Polars 同时支持 Eager 与 Lazy 两种模式,但在数据清洗中,其核心威力体现在 LazyFrame:
- 谓词下推(Predicate Pushdown):优化器将过滤条件(如
filter(status == 'ACTIVE'))尽可能下推到数据读取阶段,如果是读取 Parquet 或 CSV,直接在 I/O 阶段跳过无关数据块。 - 投影下推(Projection Pushdown):分析整个查询链条最终用到了哪些列,仅读取所需字段,丢弃冗余字段。
- 表达式并行优化:在同一个
with_columns或agg作用域内,互相独立的计算表达式由多核线程并发求值。
三、清洗代码范式:用真实示例展现动手能力
在技术面试中,空谈架构容易显得脱离实践。主动展示一段典型的业务清洗操作对比,能够证明候选人不仅理解理论,更有扎实的代码功底。
假设我们有一张用户订单明细表,清洗需求包括:解析日期字段、处理缺失的分类、过滤异常与取消的订单,并按品类汇总订单总额与下单独立用户数。
pandas 典型清洗写法
import pandas as pd

# 1. 即时读取与解析
df = pd.read_csv("orders.csv")

# 2. 逐步赋值与原地修改
df["created_at"] = pd.to_datetime(df["created_at"])
df["category"] = df["category"].fillna("unknown")

# 3. 产生布尔索引切片
valid_df = df[(df["status"] != "cancelled") & (df["amount"] > 0)]

# 4. 分组聚合计算
summary = (
    valid_df.groupby("category", as_index=False)
    .agg(
        total_amount=("amount", "sum"),
        avg_amount=("amount", "mean"),
        active_users=("user_id", "nunique")
    )
)
print(summary.head())
Polars 惰性清洗表达式写法
import polars as pl

# 1. 扫描元数据构建逻辑图,暂不加载完整数据到内存
query = (
    pl.scan_csv("orders.csv")
    # 优化器自动将 filter 条件下推至读取阶段
    .filter((pl.col("status") != "cancelled") & (pl.col("amount") > 0))
    # with_columns 内部表达式并行处理
    .with_columns([
        pl.col("created_at").str.to_datetime("%Y-%m-%d %H:%M:%S"),
        pl.col("category").fill_null("unknown")
    ])
    # 高性能哈希多核并行分组
    .group_by("category")
    .agg([
        pl.col("amount").sum().alias("total_amount"),
        pl.col("amount").mean().alias("avg_amount"),
        pl.col("user_id").n_unique().alias("active_users")
    ])
)

# 2. 一次性触发全局优化并执行
summary = query.collect()
print(summary.head())在 Polars 中,
pl.col(...) 属于声明式表达式(Expression Context)。多个 pl.col 表达式在同一个作用域中天然并发执行,无需中间临时列;而 pandas 逐行赋值会导致反复检查索引对齐并开辟新内存块。
四、数据规模分界与极限场景表现
性能差异在不同数据量级下呈现出截然不同的走势,这正是面试官考察候选人是否有真实大数据集处理经验的关键试金石。
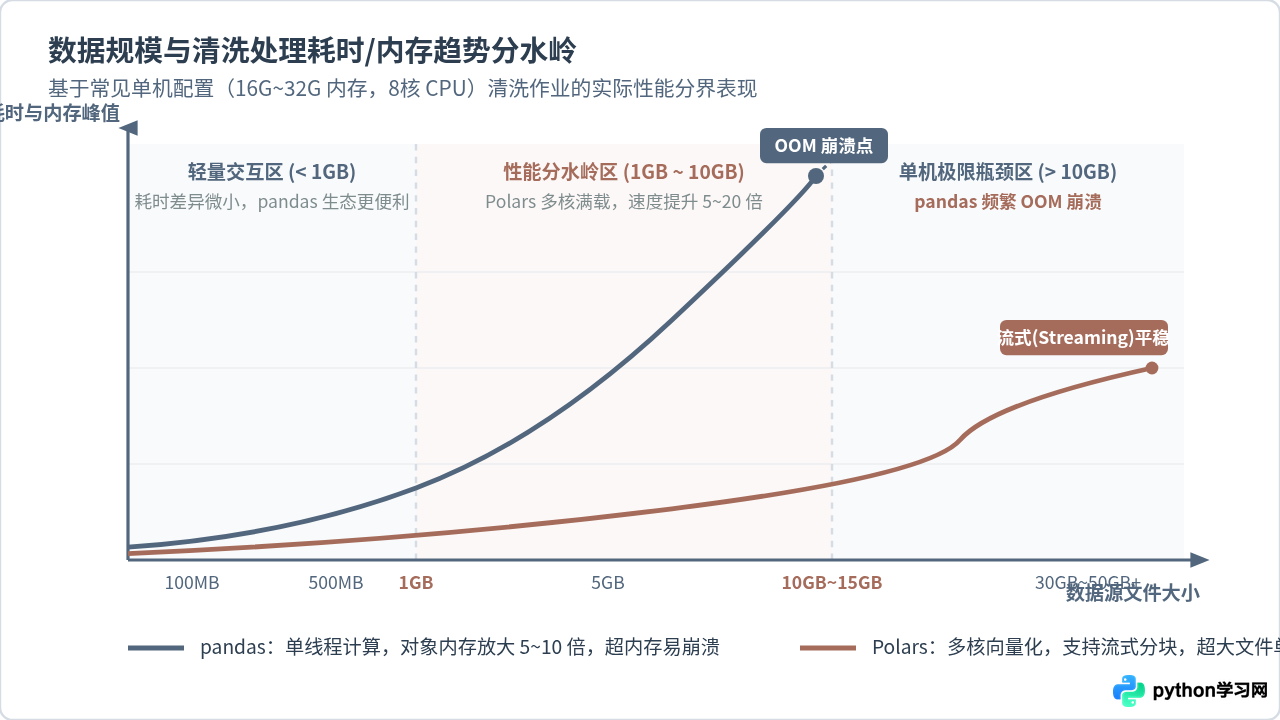
1. 轻量数据区(< 500MB ~ 1GB)
在这个量级内,pandas 读取与处理总耗时通常在 1 至 3 秒内,Polars 虽能压缩到数百毫秒以内,但在交互式探索(Jupyter Notebook)中,这种绝对时间的节省并不足以构成颠覆性体验。此时 pandas 的丰富语法糖与社区答疑资源的优势更为显著。
2. 性能爆发区分水岭(2GB ~ 15GB)
当单机文件达到数 GB 时,pandas 由于对象内存放大效应,内存占用可能飙升至 20GB~30GB,频繁触发操作系统的虚拟内存交换(Swap),处理耗时从数秒暴增至数分钟甚至陷入卡死。而 Polars 依靠紧凑连续的 Arrow 内存与全核并行,耗时依然保持在数秒至十几秒之间,性能差距扩大到 10 倍至 30 倍。
3. 极限单机超载区(> 20GB ~ 100GB+)
当数据规模逼近或超过物理内存时,pandas 会直接抛出 MemoryError (OOM 崩溃)。而 Polars 提供了 Streaming 流式计算引擎(在 collect(streaming=True) 中开启),能够按批次将数据切块送入管道,在单台普通的 16GB 笔记本上稳定清洗数十 GB 甚至数百 GB 的大型文件,无需搭建复杂的分布式 Spark 集群。
五、工程理性与落地避坑:展示资深架构思维
一个初级工程师容易神化某项新技术,而资深工程师更关注“使用新技术的代价”。在回答中主动谈及 Polars 的局限性与迁移成本,能瞬间提升回答的专业可信度。
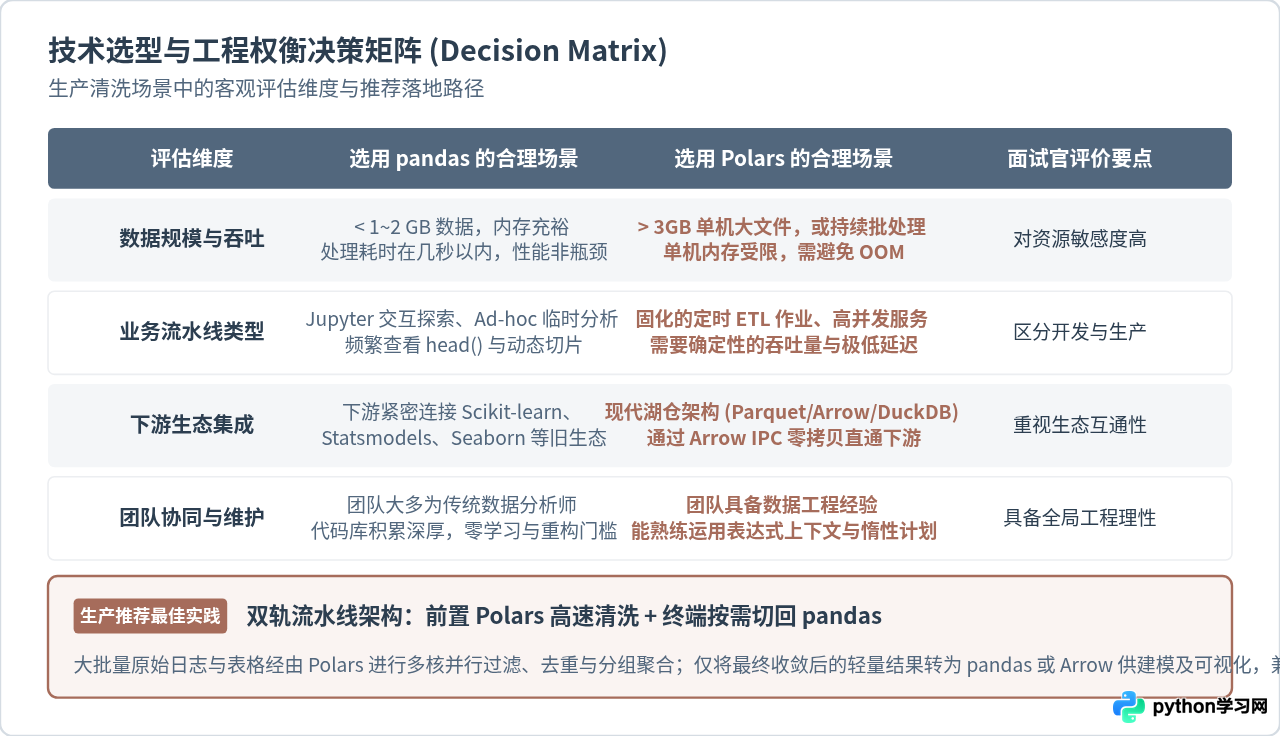
1. 为什么不能无脑将所有代码重构成 Polars?
- 下游生态兼容壁垒:传统的机器学习库如
scikit-learn、特征工程库category_encoders、统计模型库statsmodels均原生基于 pandas DataFrame 或 NumPy 数组。虽然 Polars 能通过.to_pandas()或 Arrow 零拷贝转换,但频繁在流水线末端类型互转仍会引入额外的维护成本。 - 团队学习曲线与既有资产沉淀:数据分析团队普遍拥有数年 pandas 编写经验,公司内部沉淀了大量共享清洗工具函数。全面重构面临语法范式转变(如放弃索引 Index 概念、改用声明式表达式)与回归测试的人力消耗。
- Python 自定义函数(UDF)的性能陷阱:如果在 Polars 中大量滥用
.map_elements()传入纯 Python 函数,执行引擎必须每行重新回退获取 Python GIL,这会导致 Polars 失去多核并行与 SIMD 优势,性能大幅缩水,甚至慢于经过优化的 pandas 向量化运算。
在实际生产架构中,最具性价比的方案是“Polars 负责前置粗洗,pandas 负责后置精细分析”。对于数 GB 的原始数据,利用 Polars 的多核与惰性优化快速完成加载、字段裁剪、多表关联、类型转换与分组聚合;随后通过 Arrow 零拷贝将缩减后的轻量级结果转给下游 pandas 或建模库。这种组合既拿下了极限吞吐量,又完全保全了旧有生态。
六、高分回答模版:面试实战应答范例
在面试现场,候选人可以用以下这段高度提炼、层次严密的表述作为回答蓝本:
推荐应答示范:
“我在做清洗选型时,主要以数据规模分水岭和工程流水线定位为核心依据:
如果数据量在 1GB 以内,且处于交互式探索(EDA)阶段,或者下游紧密依赖 Scikit-Learn、Statsmodels 等传统生态,我会优先使用 pandas。因为在这个体量下性能并非瓶颈,pandas 拥有成熟的社区支持和最低的协同摩擦。
但如果进入生产级批处理 ETL、清洗文件达到数 GB 甚至几十 GB,或者性能与资源成本成为核心考量,我会坚定选择 Polars。原因在于底层架构的三点本质飞跃:
- 内存架构:Polars 采用 Apache Arrow 列式连续存储,相比 pandas 离散的 Python Object,不仅节省数倍内存,而且对 CPU 缓存极其友好;
- 并发与算力:Polars 底层基于 Rust 和 Rayon,彻底摆脱了 Python GIL 限制,能无锁榨干服务器多核算力;
- 执行优化:其 LazyFrame 具备工业级查询优化器,能自动执行谓词下推与投影剪枝,并且原生支持 Streaming 流式计算,在单机内存受限时依然能平稳处理超大文件。
当然,在具体工程落地中我也会注意规避‘滥用 Python UDF 导致性能降级’的问题。我们目前的最佳实践通常是双轨模式:用 Polars 承担前置大吞吐的密集过滤与哈希聚合,再将收敛后的轻量数据按需提供给下游分析,兼顾高吞吐与生态兼容。”
七、总结
技术选型没有绝对的胜负,只有对资源、成本与效率的权衡。回答“用 pandas 还是 Polars”这道题,关键在于跳脱出单纯的“库函数对比”,将问题引申到内存管理、并发哲学、编译器优化与系统集成架构上。展现出这种多维度的工程理性,才能在面试中真正脱颖而出。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















