


Python异步调用大模型接口的性能优化配置
针对Python异步调用大模型接口常见的高延迟、429限频报错与连接泄露问题,系统讲解传输层连接池、分项超时、并发度与速率限制护栏、指数退避重试及流式消费的完整性能优化配置。
调用大模型接口本质上是高延迟的网络 I/O 密集型任务。单纯将同步代码替换为 async/await 并不能自动带来稳定的高吞吐量;若缺乏底层传输与流控配置,密集并发反而极易引发连接句柄泄露、429 速率限制(Rate Limit)报错与服务雪崩。实现高性能异步调用的核心路径,在于自底向上建立一套受控的资源管理体系:以连接池复用消除握手开销、以细粒度超时防止僵死连接、以信号量与令牌桶约束本地及远端配额、以指数退避吸收瞬时波动,并配合流式消费平抑单机内存占用。
一、大模型异步调用的性能瓶颈与分层拦截设计
大模型生成任务与传统轻量级 Web API 存在显著差异:单次生成的首字时间(TTFT)通常在数百毫秒以上,长文本生成可能持续数秒至数十秒。在未加调控的异步并发场景下,程序在毫秒内派发数百个协程,直接冲击服务商网关。
这种未调优的调用方式通常在三个层面暴露出性能隐患:首先,频繁新建与销毁底层 TCP/TLS 链路,大幅增加了首字延迟并可能耗尽操作系统的临时端口;其次,瞬时突发的请求速率直接击穿 API 服务商设定的 RPM(每分钟请求数)与 TPM(每分钟 Token 数)阈值,导致大面积 HTTP 429 异常;再次,缺乏针对大模型输出特性的超时解耦配置,导致连接要么在握手阶段无限挂起,要么在长文本生成途中被非预期切断。
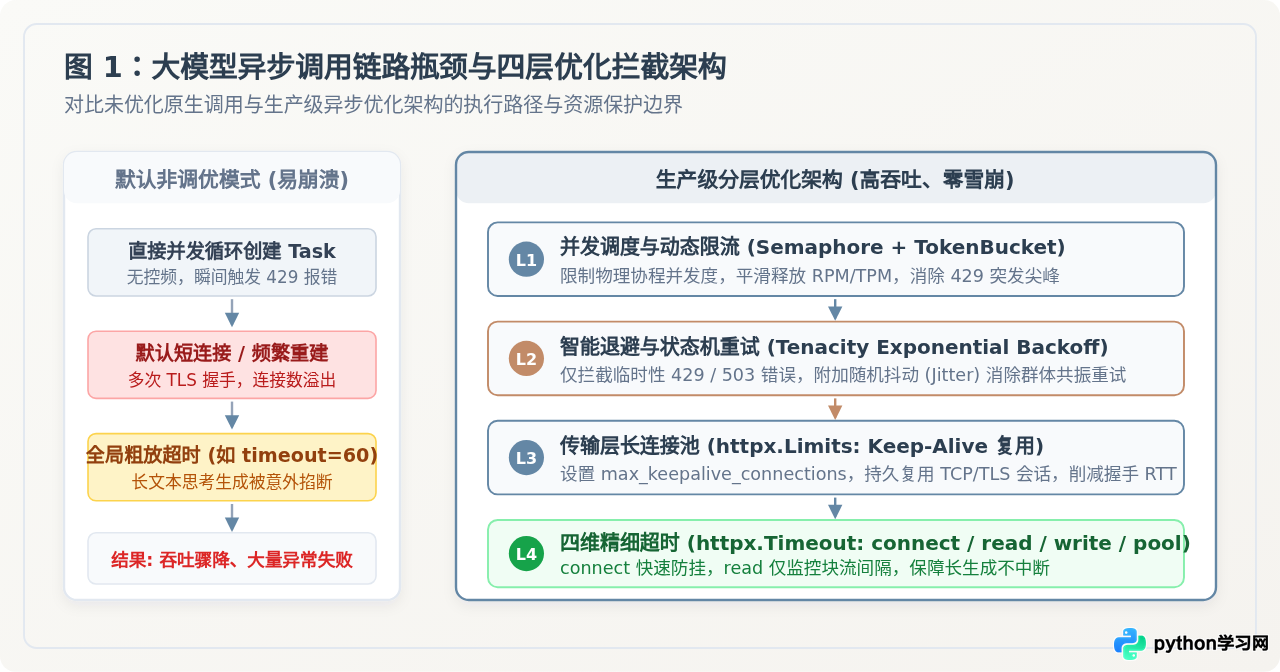
针对上述瓶颈,高性能架构需在应用层与网络层之间构筑四道防御护栏:在最上层通过并发调度器平滑请求峰值,在逻辑层利用自适应退避状态机拦截偶发性网络抖动,在传输层通过受控连接池保持持久会话,最后通过分项超时机制精细化管理连接生命周期。
二、优化配置实施标准与核心步骤
构建稳定的异步大模型调用管道需要遵循规范的配置顺序。跳过底层传输配置而直接做上层限流往往事倍功半,因此推荐按照底层通信参数、超时约束、配额防护、容错策略到数据消费的渐进流程完成装配。
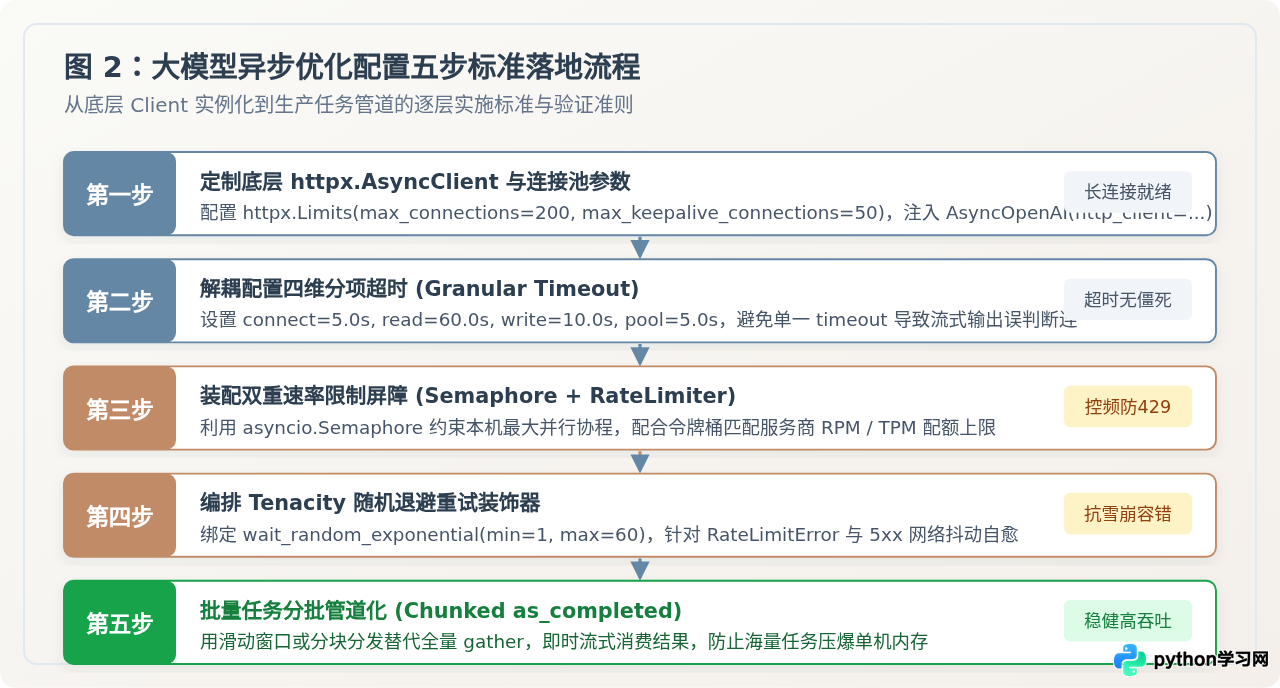
步骤一:定制底层持久连接池(httpx.AsyncClient 与 Limits)
主流 Python 大模型 SDK(如 AsyncOpenAI)默认基于 httpx 构建。默认配置下的连接池容量较小或采用即用即关模式,高并发下会导致大量时间损耗在握手阶段。配置自定义的 httpx.Limits 可以维持长连接复用,并限制全局连接数以防单机句柄溢出。
import httpx
from openai import AsyncOpenAI

# 1. 配置生产级 HTTP 传输与连接池
http_limits = httpx.Limits(
    max_connections=200,             # 全局最大允许打开的连接数
    max_keepalive_connections=50,    # 允许保持空闲就绪的长连接数
    keepalive_expiry=30.0            # 空闲长连接保活超时(秒)
)

# 2. 注入定制化的 AsyncClient
custom_http_client = httpx.AsyncClient(
    limits=http_limits,
    http2=True                       # 在服务商支持时启用 HTTP/2 多路复用
)

# 3. 初始化大模型客户端
client = AsyncOpenAI(
    api_key="your-api-key",
    base_url="https://api.openai.com/v1",
    http_client=custom_http_client
)
将 max_keepalive_connections 设为稳定长连接数,能保证突发请求直接复用已完成 TLS 协商的通道,使网络建立开销降低至接近 0 毫秒。
步骤二:精细化四维超时解耦(httpx.Timeout)
在网络配置中,简单设置单一浮点数(如 timeout=60.0)在大模型调用中极易引发两类极端问题:当建立 TCP 连接遇到网关路由故障时,程序会等待 60 秒才报错,严重拖慢整体吞吐;而在流式响应生成超长回答时,总耗时超过 60 秒又会导致传输被强行中断。
正确的做法是将超时解耦为四个独立维度:
- connect(连接建立超时):严格限制在 5.0 秒以内。若在此时间内无法完成 TCP/TLS 握手,说明链路异常,应快速失败并触发重试。
- read(数据读取超时):针对大模型流式输出,该数值代表“相邻两个数据块(chunk)之间的最大间隔时间”,而非整场对话的总时间。设置为 30.0 至 60.0 秒可有效监测远端网关是否心跳中断,同时不限制长文本输出总时长。
- write(数据写入超时):客户端向服务端发送 Prompt 数据的上限时间,一般设置为 10.0 秒即可满足包含较长上下文的请求。
- pool(获取连接超时):当并发请求数超出连接池空闲容量时,协程在连接池队列中等待可用连接的等待时间上限,通常设为 5.0 秒,避免队列无限阻塞。
# 精细化分项超时设定
granular_timeout = httpx.Timeout(
    connect=5.0,    # 连接握手阶段上限
    read=60.0,      # 单块读取心跳上限(支持长流式生成)
    write=10.0,     # 发送请求体上限
    pool=5.0        # 连接池排队等待上限
)

# 更新至 AsyncClient
custom_http_client.timeout = granular_timeout
三、并发度与动态速率限制协同机制
服务商的 API 访问配额通常以 RPM(Requests Per Minute)和 TPM(Tokens Per Minute)作为硬性指标。仅依赖协程池并发,往往会在开始调用的前几秒内瞬间超限。必须构建“本地物理协程并发度(Semaphore)+ 远端速率节流(Token Bucket)”的双重协同保护。
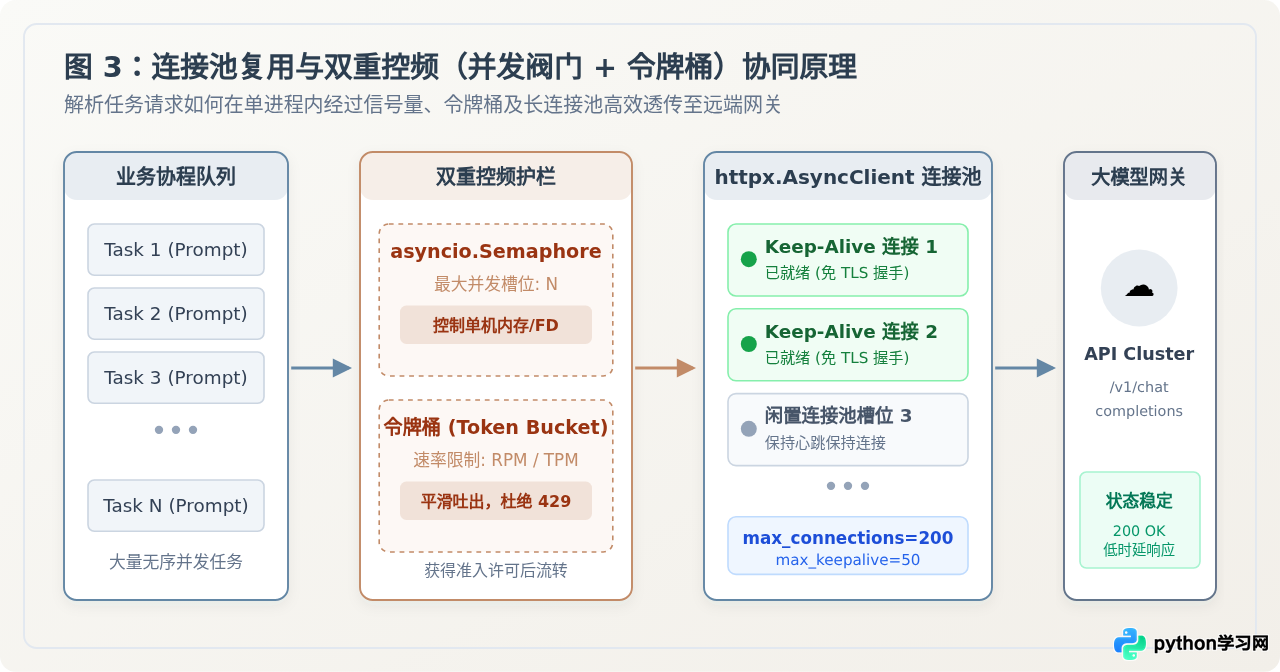
asyncio.Semaphore 负责控制本地操作系统层面的最大活跃协程数量,防止因过多挂起协程占用大量内存和文件描述符;而轻量级令牌桶或时间窗口限流器则根据服务商配额,平滑向服务商发送请求。
import asyncio
import time

class AsyncRateLimiter:
    """轻量级平滑速率限制器,限制每秒最大请求数 (RPS)"""
    def __init__(self, max_rate: float):
        self.interval = 1.0 / max_rate
        self.lock = asyncio.Lock()
        self.last_check = 0.0

    async def acquire(self):
        async with self.lock:
            now = time.monotonic()
            elapsed = now - self.last_check
            if elapsed < self.interval:
                await asyncio.sleep(self.interval - elapsed)
            self.last_check = time.monotonic()

# 示例:本地允许最大 20 个活跃协程,同时全局请求速率不超过 50 次/秒
concurrency_semaphore = asyncio.Semaphore(20)
rate_limiter = AsyncRateLimiter(max_rate=50.0)
四、基于 Tenacity 的智能退避与容错配置
在大规模异步调用中,遇到偶发性网络抖动(如 502 Bad Gateway、503 Service Unavailable)或突发 429 Too Many Requests 是不可避免的常态。若直接抛出异常或采用固定间隔粗暴重试,往往会引发更严重的“重试风暴”。
使用专业重试库 tenacity,结合指数退避(Exponential Backoff)与随机抖动(Jitter),能够平滑分散重试请求,让处于过载保护中的服务端节点平稳恢复。
from tenacity import (
    retry,
    stop_after_attempt,
    wait_random_exponential,
    retry_if_exception_type
)
from openai import RateLimitError, APIConnectionError, InternalServerError

# 针对特定可自愈异常进行带随机抖动的指数退避重试
@retry(
    retry=retry_if_exception_type((RateLimitError, APIConnectionError, InternalServerError)),
    wait=wait_random_exponential(min=1.0, max=60.0),  # 最小 1 秒,最大 60 秒的指数退避
    stop=stop_after_attempt(5),                      # 单次任务最大尝试 5 次
    reraise=True
)
async def robust_chat_completion(client: AsyncOpenAI, prompt: str) -> str:
    async with concurrency_semaphore:
        await rate_limiter.acquire()

        response = await client.chat.completions.create(
            model="gpt-3.5-turbo",
            messages=[{"role": "user", "content": prompt}],
            temperature=0.7
        )
return response.choices[0].message.contentretry_if_exception_type 的捕获范围。严禁捕获诸如 AuthenticationError(鉴权失败 401)、BadRequestError(请求参数格式错误 400)等不可恢复错误,避免无效重试空耗配额。
五、流式响应消费与大规模批处理管道
当需要批量处理数千甚至数万个 Prompt 时,切忌一次性使用 asyncio.gather(*[...]) 将所有任务全部压入事件循环。这种写法会在启动瞬间生成海量 Task 对象,耗尽单机内存,并导致一旦出现无法捕获的崩溃时全盘丢失进度。
推荐采用滑动窗口或分块管道(Chunked Pipeline)模式,结合 asyncio.as_completed 实现边生成、边消费、边落盘的低内存流式流水线:
async def process_batch_pipeline(client: AsyncOpenAI, prompts: list[str], chunk_size: int = 100):
    """分块批处理管道,防止单机内存积压并即时落盘"""
    results = []

    for i in range(0, len(prompts), chunk_size):
        chunk = prompts[i:i + chunk_size]
        # 创建当前窗口内的任务批次
        tasks = [asyncio.create_task(robust_chat_completion(client, p)) for p in chunk]

        # 按照完成先后顺序即时消费
        for completed_task in asyncio.as_completed(tasks):
            try:
                res = await completed_task
                results.append(res)
                # 可在此处即时写入 SQLite 或持久化存储,无需等待全部批次完成
            except Exception as e:
                # 记录失败详情及日志
                print(f"Task failed after retries: {e}")

    return results
六、配置参数对照与调优参考矩阵
为了方便在实际开发与运维部署时快速定位配置要点,下表总结了常规开发默认配置与高吞吐生产优化配置的差异及调优依据。
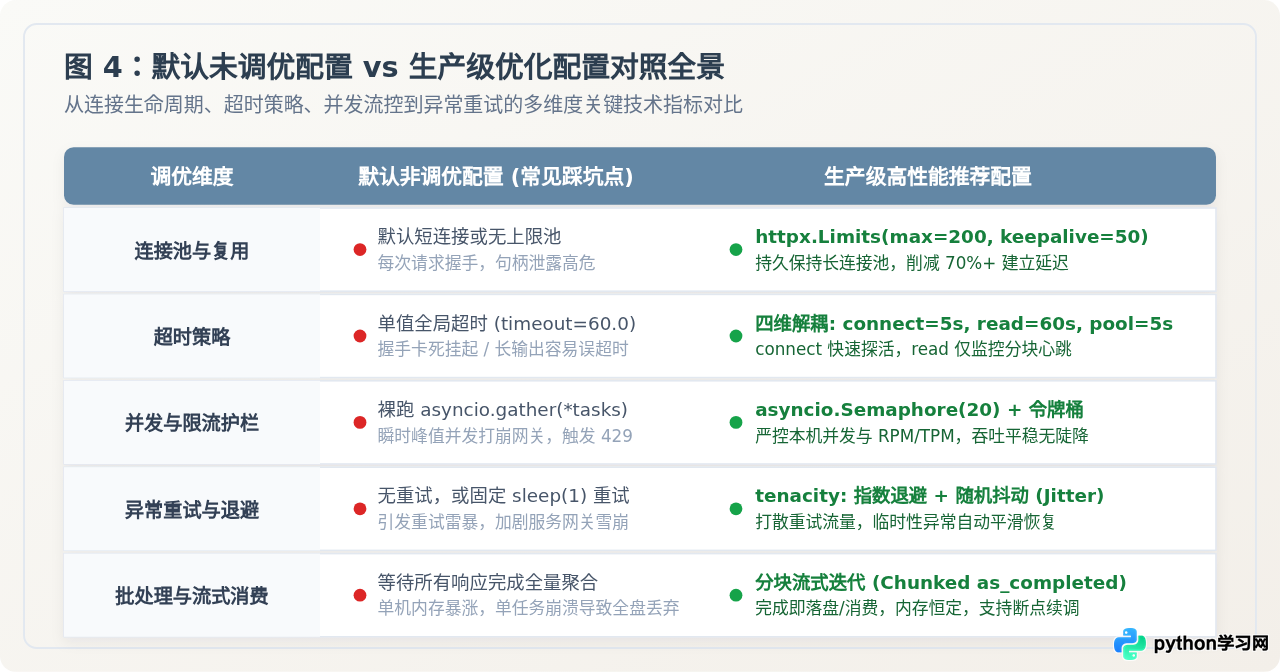
| 配置项 / 模块 | 默认非调优值 | 生产推荐优化值 | 调优生效原理与解决的问题 |
|---|---|---|---|
httpx.Limits.max_connections |
100 (或无限制) | 150 - 300 | 约束单进程打开的最大物理网络连接,防止文件句柄耗尽 (EMFILE)。 |
httpx.Limits.max_keepalive_connections |
20 | 50 - 100 | 维持空闲长连接通道,后续请求直接复用,省去 100ms-300ms 的 TLS 握手延时。 |
httpx.Timeout.connect |
5.0s / 60.0s | 3.0s - 5.0s | 快速探测网络可达性;遇到 DNS 污染或路由故障时迅速放弃并触发重试。 |
httpx.Timeout.read |
60.0s 全局 | 30.0s - 60.0s 块间隔 | 解耦为流式块间心跳监控,既能容忍超长文本逐步生成,又能阻断服务端挂起死连接。 |
asyncio.Semaphore |
未配置 | 10 - 50 (视核心数与网络) | 限制本机同时挂起的未完成协程总数,平抑内存占用,消除 CPU 上下文切换消耗。 |
tenacity 重试退避 |
无 / 固定 sleep | wait_random_exponential |
指数级拉长重试间隔并注入随机抖动,避免瞬时 429 演变为周期性网络并发共振。 |
七、常见排查问题与运行维护提示
1. 为什么配置了 Semaphore 依然偶发 429 报错?
并发数与速率并不是同一概念。当单次 Prompt 较长(包含数万 Token 的上下文)时,即使并发数仅为 5,瞬时消耗的 Token 总量也可能在 10 秒内打满服务商的 TPM 额度。此时需在 RateLimiter 中加入针对输入 Token 预估长度的权重统计,而非仅统计请求次数。
2. 服务端进程退出时出现 Unclosed client session 告警?
如果在程序退出前直接终止事件循环,未显式关闭 httpx.AsyncClient,会导致底层连接池未能正常发送 FIN/RST 报文。生产代码中应在 FastAPI、Tornado 等框架的生命周期事件(如 @app.on_event("shutdown") 或 lifespan)中显式调用 await client.close()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















