


Python namedtuple和NamedTuple怎么用?适合做轻量级结构体吗
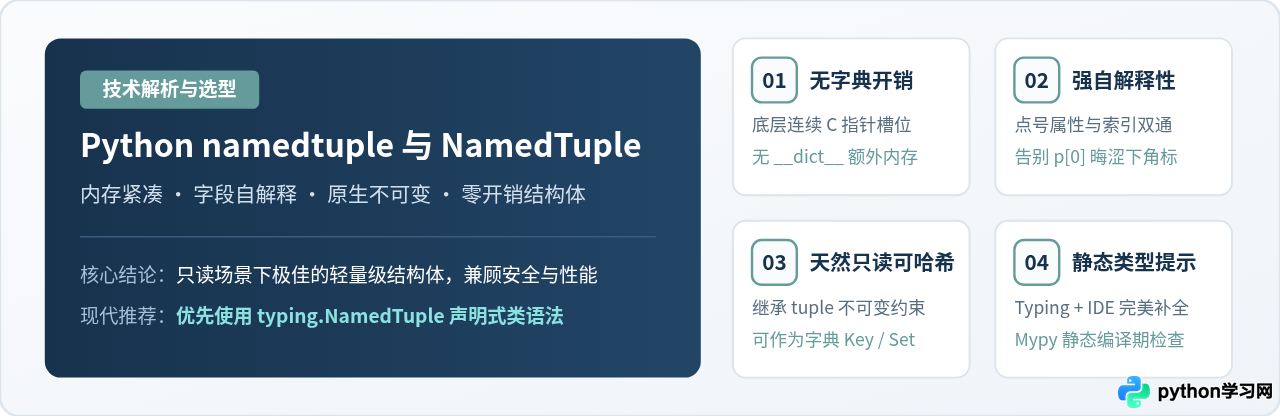
深入对比解析 Python 中 collections.namedtuple 与 typing.NamedTuple 的定义用法、底层内存机制、类型提示支持,并全面解答它们是否适合作为轻量级结构体,提供明确的技术选型决策依据。
dataclass 才是更恰当的选择。
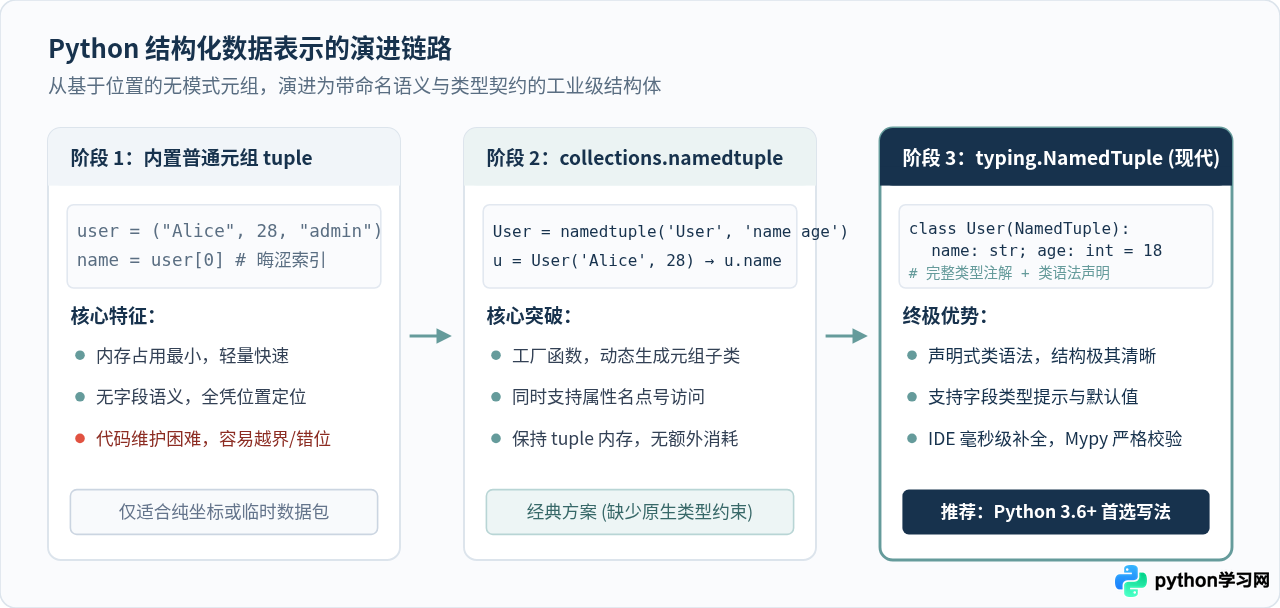
一、collections.namedtuple 与 typing.NamedTuple 的定义与基本用法
Python 内置的标准元组(tuple)虽然轻量且只读,但在表达多属性数据时非常晦涩——访问数据只能依靠数字索引(如 user[0]、user[1]),代码可读性很差,还容易因位置错位引发 bug。为了解决这个问题,Python 标准库先后提供了两套命名元组解决方案:
1. collections.namedtuple 的函数工厂用法
collections.namedtuple 自 Python 2.6 引入,是一个工厂函数。它通过接收类名和字段名列表,在运行时动态生成一个新的 tuple 子类:
from collections import namedtuple

# 定义命名元组类型:字段名可用空格隔开的字符串或列表声明
Point = namedtuple('Point', 'x y')

# 实例化
pt = Point(10, 20)

# 1. 支持像对象一样通过点号属性名访问
print(pt.x, pt.y)  # 示例输出: 10 20

# 2. 完全兼容原生元组的索引访问与解包
print(pt[0], pt[1])  # 示例输出: 10 20
x_val, y_val = pt
print(x_val, y_val)  # 示例输出: 10 20
从 Python 3.7 开始,collections.namedtuple 增加了 defaults 参数,允许为最右侧的字段设置默认值:
Person = namedtuple('Person', ['name', 'role', 'active'], defaults=['member', True])
p1 = Person('Alice')
print(p1)  # 示例输出: Person(name='Alice', role='member', active=True)
2. typing.NamedTuple 的声明式类语法(现代推荐)
Python 3.6+ 在 typing 模块中引入了 NamedTuple。它基于 Python 的类型注解机制(PEP 526),允许开发者直接使用类语法(class syntax)来定义命名元组。这种写法更加直观、优雅,并带来了原生的类型提示支持:
from typing import NamedTuple

class User(NamedTuple):
    id: int
    username: str
    is_active: bool = True  # 直接支持字段类型注解与默认值

# 实例化与调用
u = User(id=101, username="zhangsan")
print(u.username, u.is_active) # 示例输出: zhangsan Truetyping.NamedTuple。它不仅使代码结构清晰,还能让 VS Code、PyCharm 等主流 IDE 立即提供精确的字段自动补全,并能被 Mypy、Pyright 等静态检查器识别。
二、核心内置方法与数据更新技巧
因为命名元组本质上是 tuple,实例一旦创建,其内部字段就是只读的。试图执行 pt.x = 30 会直接抛出 AttributeError: can't set attribute。
为了避免与用户定义的字段名发生命名冲突,标准库为命名元组内置的所有辅助方法都以单下划线 _ 开头。掌握以下 3 个核心方法就能自如处理绝大多数场景:
1. _replace(**kwargs):非破坏性字段替换
这是“修改”命名元组的唯一标准方式。它不会改变原对象,而是以极其高效的方式生成一个包含新字段值的新元组实例:
class ServerConfig(NamedTuple):
    host: str
    port: int
    timeout: int = 30

cfg = ServerConfig(host="127.0.0.1", port=8080)

# 生成端口为 9000 的全新配置对象
new_cfg = cfg._replace(port=9000)
print(cfg.port)      # 示例输出: 8080 (原对象保持只读未变)
print(new_cfg.port)  # 示例输出: 9000 (新实例)
2. _asdict():序列化为有序字典
将命名元组转换为普通的 Python dict,在进行 JSON 序列化、Web API 响应或数据透传时非常便捷:
data_dict = new_cfg._asdict()
print(data_dict)  # 示例输出: {'host': '127.0.0.1', 'port': 9000, 'timeout': 30}
3. _make(iterable):通过可迭代对象快速构造实例
当从 CSV 文件、数据库 cursor fetchall、网络 Socket 读取到一整行列表或元组时,_make 可以直接免解包将其映射为强类型对象:
row_data = ["192.168.1.100", 443, 60]
node = ServerConfig._make(row_data)
print(node.host, node.port)  # 示例输出: 192.168.1.100 443
三、底层机制揭秘:为什么它是“极致轻量级”?
为什么业界通常称它为“轻量级结构体”?答案隐藏在 CPython 的底层对象分配模型中。
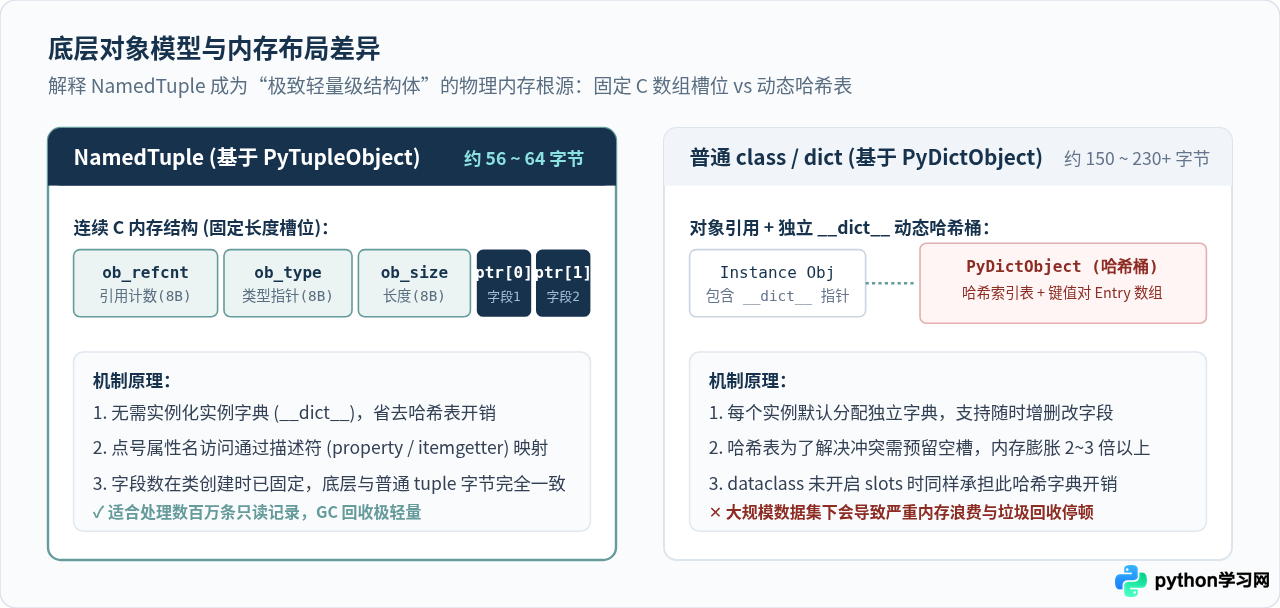
在 Python 中,普通类的实例之所以能够随时随地新增属性(例如 obj.new_attr = 1),是因为 CPython 默认为每一个类实例都分配了一个独立的哈希字典——即 __dict__。
- 普通类实例与 dict: 哈希表为了保证查找性能并减少冲突,必须预先分配稀疏连续数组。一个包含 3 个字段的普通类实例,其实例对象本身加上
__dict__的整体内存开销通常在 150 ~ 230 字节 以上。当系统需要加载上百万条记录时,字典会吃掉数百兆额外内存。 - NamedTuple / namedtuple: 它们在 C 语言层面是一个纯粹的
PyTupleObject变长结构体。其内存只由对象头信息(引用计数、类型指针、长度)和连续的 C 指针数组(指向各个字段对象)构成。没有任何__dict__开销。一个 3 字段的 NamedTuple 实例净占用仅约 64 字节,与原生元组完全相等。
我们在 Python 3 终端中可以通过 sys.getsizeof() 直接验证:
import sys
from collections import namedtuple

PointNT = namedtuple('PointNT', 'x y z')
nt = PointNT(1, 2, 3)

class PointClass:
    def __init__(self, x, y, z):
        self.x, self.y, self.z = x, y, z

pc = PointClass(1, 2, 3)

print("NamedTuple 尺寸:", sys.getsizeof(nt))                      # 示例输出: 64 字节
print("普通 Class 实例:", sys.getsizeof(pc) + sys.getsizeof(pc.__dict__))  # 示例输出: 152 字节左右
点号属性访问之所以能工作,是因为类创建时通过描述符(Descriptor)在类属性中注册了类似 property 的字段读取机制,直接将 pt.x 映射为底层的索引偏移量 tuple.__getitem__(pt, 0),因而速度极快,无需经历哈希表的散列查找。
四、深度讨论:它适合做轻量级结构体吗?
回到标题的核心设问:它适合做轻量级结构体吗?
结论是:非常适合,但仅限于“只读值对象(Value Object)”场景;若需要就地变更或复杂行为,它并不合适。
1. 为什么它非常适合?(核心优势)
- 零学习成本的只读安全性: 底层元组保证数据不会在函数传递过程中被外部意外篡改,构建出确定、可靠的数据管道。
- 原生支持哈希与集合操作: 只要包含的字段都是可哈希类型,NamedTuple 实例天然是可哈希的(hashable)。你可以直接将它用作
dict的键(Key)或存入set集合中去重,无需手写__hash__和__eq__。 - 极佳的序列兼容性与解包能力: 任何接收元组的第三方库或函数(如数据库接口、
*args解包、zip()等),都可以直接传入 NamedTuple,无需任何类型转换。 - 垃圾回收友好: 没有
__dict__的循环引用隐患,在数百万级的大数据处理流中,GC(垃圾回收器)的扫描与回收负担极轻。
2. 为什么有时不适合?(限制与边界)
- 字段不可变带来的更新成本: 如果业务逻辑需要频繁更新对象状态(例如爬虫状态机、游戏中怪物血量扣减),使用
_replace()会频繁在内存中分配新对象,反而不如可变类高效。 - 继承限制: 无法通过简单的子类继承来追加新字段。因为底层元组的内存槽位数在创建时就已经写死在 C 结构中,试图给已有的 NamedTuple 子类追加字段会直接报错。
- 元组相等性陷阱(Tuple Equality Pitfall): 因为它本质是元组,如果两个不同命名的 NamedTuple 具有相同数量和值的字段,或者直接拿它与原生元组比较,
==会返回True:
在弱类型或对类型隔离要求极高的大型系统中,这种跨类型的隐式相等可能掩盖潜在的逻辑错误。Point2D = namedtuple('Point2D', 'x y') Vector2D = namedtuple('Vector2D', 'x y') # 危险:即使类型名和语义完全不同,也会判定为相等 print(Point2D(1, 2) == Vector2D(1, 2)) # 示例输出: True print(Point2D(1, 2) == (1, 2)) # 示例输出: True
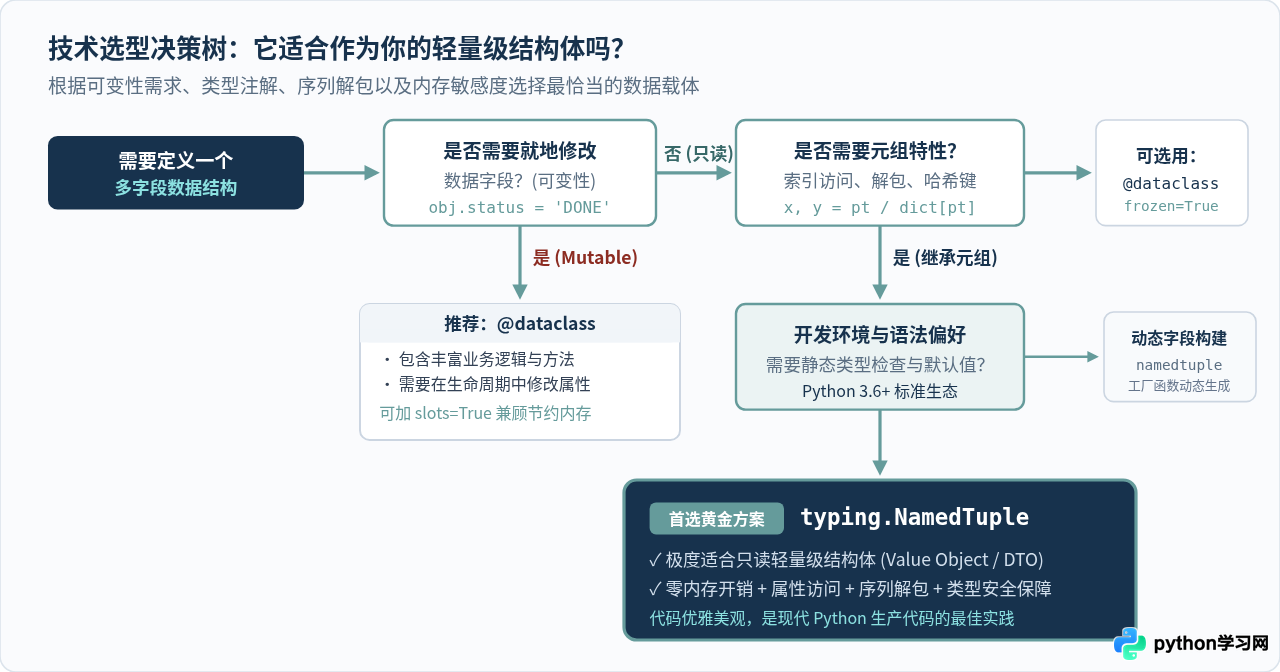
五、横向选型:NamedTuple、dataclass 与普通 dict 如何选?
在日常开发中,我们常常在 typing.NamedTuple、@dataclass 和原生字典 dict 之间纠结。以下是具体的选型建议:
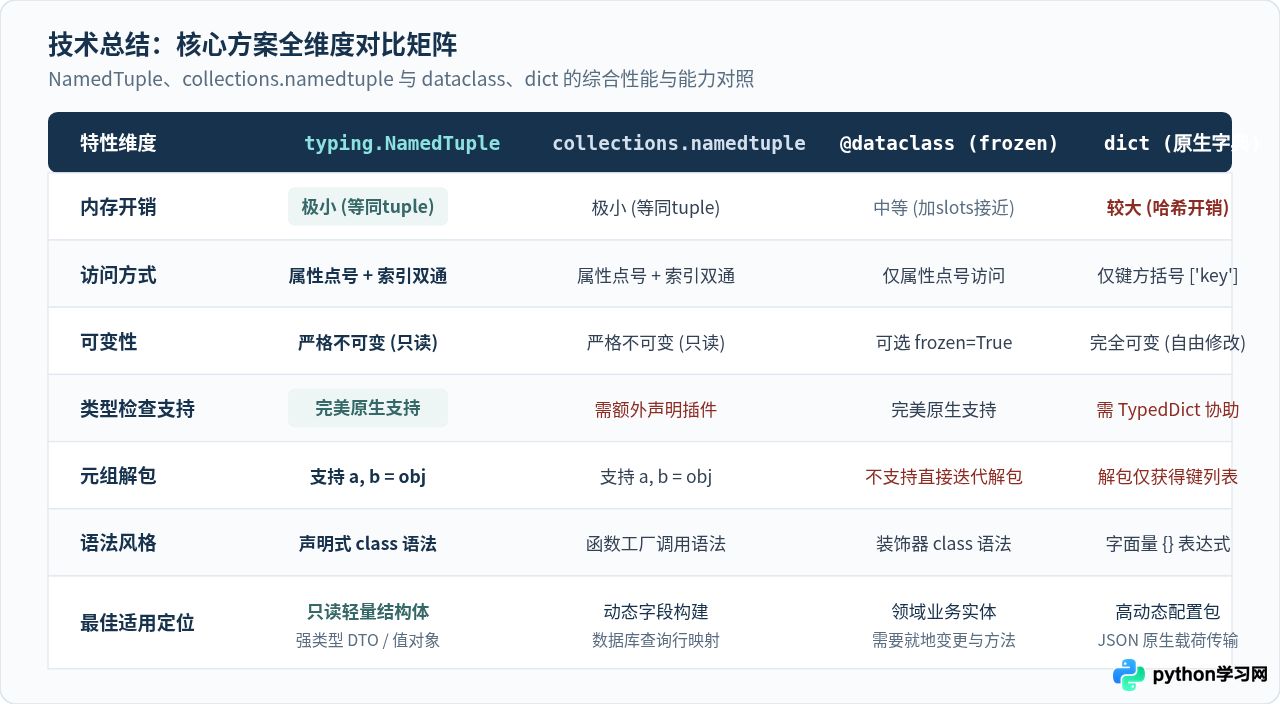
| 技术方案 | 典型声明方式 | 内存大小 | 不可变性 | 核心优势 | 适用场景 |
|---|---|---|---|---|---|
| typing.NamedTuple | class DTO(NamedTuple): ... |
极小 (~64B) | 严格只读 | 零字典开销、元组解包、类型安全 | 只读结构体、函数返回多值、坐标点、只读表格行 |
| @dataclass | @dataclass |
中/小 (支持 slots) | 默认可变 (可配 frozen) | 功能全面、支持方法、继承友好、代码灵活 | 领域模型实体、需要就地修改状态、复杂业务对象 |
| collections.namedtuple | namedtuple('Name', 'x y') |
极小 (~64B) | 严格只读 | 动态字段构建、跨版本兼容好 | 运行期动态生成结构、老旧 Python 脚本 |
| dict | {"name": "a", "val": 1} |
较大 (含散列表) | 完全可变 | 高度动态、随意增删键、原生对应 JSON | 高动态配置、RESTful API 原始输入输出载荷 |
- 浅层不可变性(Shallow Immutability): NamedTuple 自身的属性指针不可修改,但如果字段的值是一个可变容器(如
list或dict),列表或字典内部的内容依然能被修改(例如item.tags.append("new"))。如果追求真正的绝对深层不可变,请确保字段值均为int、str、float或嵌套的tuple/NamedTuple。 - 默认参数排布规则: 与 Python 函数签名一致,定义 NamedTuple 字段时,拥有默认值的字段必须严格排在所有无默认值字段的后面,否则会在类声明时直接触发
SyntaxError。
六、全文总结
回到文章的核心主题:
1. 怎么用:在 Python 3.6+ 项目中,请统一使用 typing.NamedTuple 的类语法进行声明。利用其类型注解提高代码规范度,通过点号访问提升可读性,通过 _replace() 产生修改后的新副本,通过 _asdict() 输出字典。
2. 是否适合做轻量级结构体:答案是非常适合。对于不需要在原对象上直接赋值修改的场景,它没有额外字典开销,内存紧凑,访问敏捷,比普通 class 快且省内存,比普通 tuple 具备自解释性,比 dict 拥有强 schema 约束与属性提示,是 Python 工程实践中极具性价比的轻量级结构体利器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















