


Python多线程类中共享变量导致数据竞争怎么办
深入解析Python多线程类中共享变量导致数据竞争的底层成因(GIL与字节码交错),并提供基于threading.Lock、RLock、Queue与threading.local的生产级解决方案与排查指南。
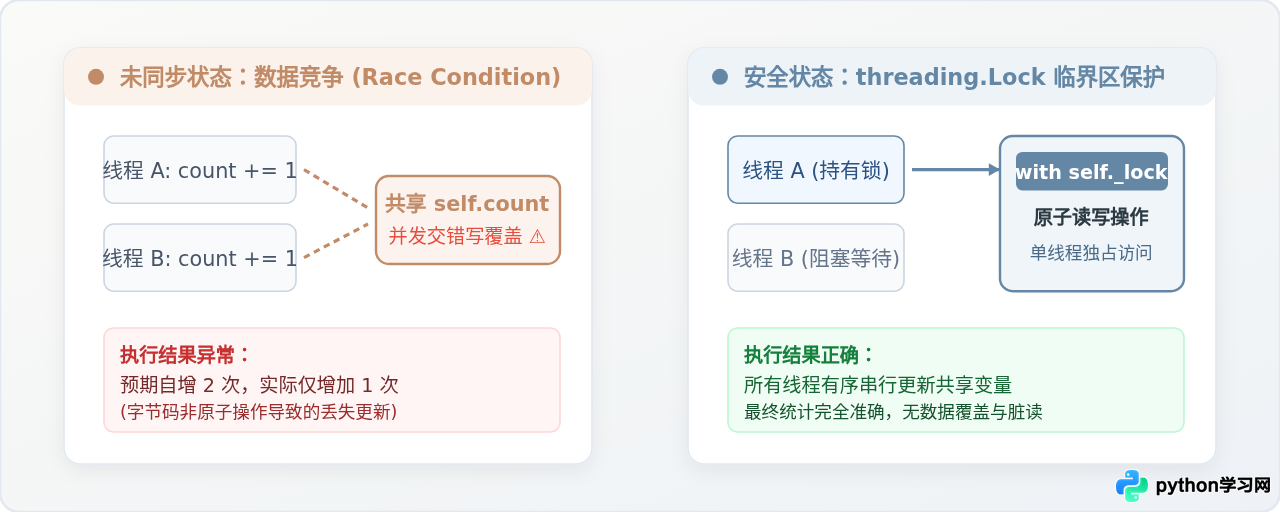
self.count += 1)依然会在字节码交错执行时引发数据竞争,导致丢失更新。解决该问题的标准做法是在类内部封装 threading.Lock 并结合上下文管理器 with self._lock: 圈定最小临界区;若存在类方法相互调用或递归,则应改用可重入锁 threading.RLock;若涉及跨线程数据协作,应优先采用线程安全的 queue.Queue 替代共享内存。
一、为什么 Python 多线程类中会出现数据竞争?
很多初学者接触 Python 时,常听到“Python 有全局解释器锁(GIL),同一时刻只有一个线程在运行”。由此容易产生一种误解:既然同一时刻只有一个线程在执行,类中的共享变量不就不会被破坏了吗?
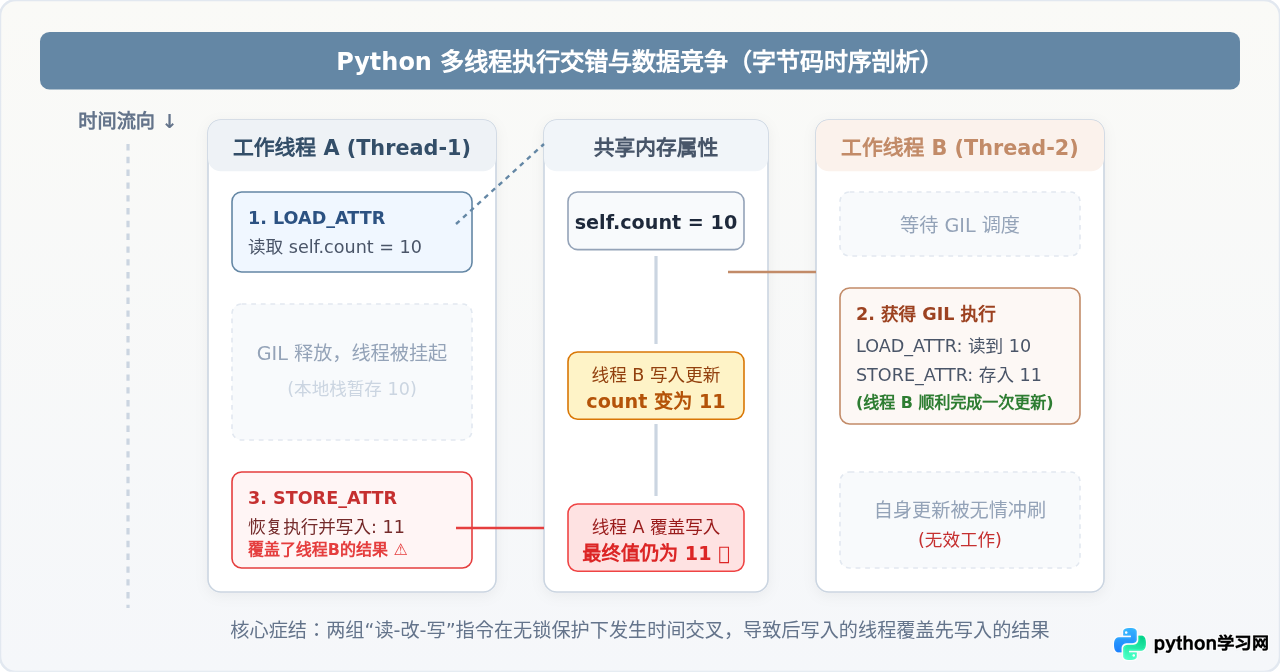
事实并非如此。GIL 的作用仅在于保护 CPython 解释器自身的内部状态与内存管理(如引用计数),确保解释器层面的安全;GIL 绝不保证 Python 语言层面的语句具有原子性(Atomicity)。当我们在类中编写类似 self.counter += 1 的代码时,在高级语言中看似只有一行,但在 Python 底层实际上被拆解成了多条字节码指令:
LOAD_FAST或LOAD_ATTR:从实例字典或类命名空间中加载当前变量的值到求值栈;LOAD_CONST:加载常量1;BINARY_OP/BINARY_ADD:执行加法计算;STORE_ATTR:将计算结果重新写入实例或类属性中。
CPython 会在线程执行一定数量的字节码或达到时间片间隔(sys.getswitchinterval(),默认 5 毫秒)时主动释放 GIL 并切换线程。如果线程 A 在读取了旧值(例如 10)完成加法但尚未存回属性之前,解释器切换到了线程 B,线程 B 同样读取到旧值 10 并完成自增存入 11;此时再切回线程 A,线程 A 会直接执行最后一步 STORE_ATTR,将自己算出的 11 再次写入。这样两次累加操作最终只增长了 1,发生了典型的“丢失更新”(Lost Update)。
二、典型故障复现:多线程共享计数器类
为了直观看到数据竞争的表现,我们编写一个典型的无防护计数器类 UnsafeCounter。该类包含一个实例属性 self.count,并在多个线程中对其并发执行累加:
import threading

class UnsafeCounter:
    def __init__(self):
        self.count = 0

    def increment(self):
        # 此处发生数据竞争:非原子操作包含读、加、写三步
        self.count += 1

def worker(counter, iterations):
    for _ in range(iterations):
        counter.increment()

if __name__ == "__main__":
    counter = UnsafeCounter()
    threads = []
    num_threads = 10
    iterations_per_thread = 100_000

    # 启动 10 个线程,预期总计数为 1,000,000
    for _ in range(num_threads):
        t = threading.Thread(target=worker, args=(counter, iterations_per_thread))
        threads.append(t)
        t.start()

    for t in threads:
        t.join()

    print(f"预期结果: {num_threads * iterations_per_thread}")
    print(f"实际结果: {counter.count}")
终端运行输出(示例):
预期结果: 1000000
实际结果: 624189
在每次循环执行 10 万次这种高频读写场景下,近 38 万次自增操作由于数据竞争被默默吞没。这种问题在小规模本地测试时可能极难察觉,但在高并发或生产流量冲击下,会导致统计遗漏、余额错误或状态不一致等隐蔽故障。
三、核心解决方案与改造步骤
方案一:引入 threading.Lock 圈定最小临界区(通用推荐)
互斥锁(Mutual Exclusion Lock)是解决数据竞争最经典、最有效的方法。通过在类初始化时创建一个互斥锁,并在读写共享变量的方法中使用 with self._lock:,可以确保同一时刻只有一个线程能够进入受保护的代码块(即临界区)。
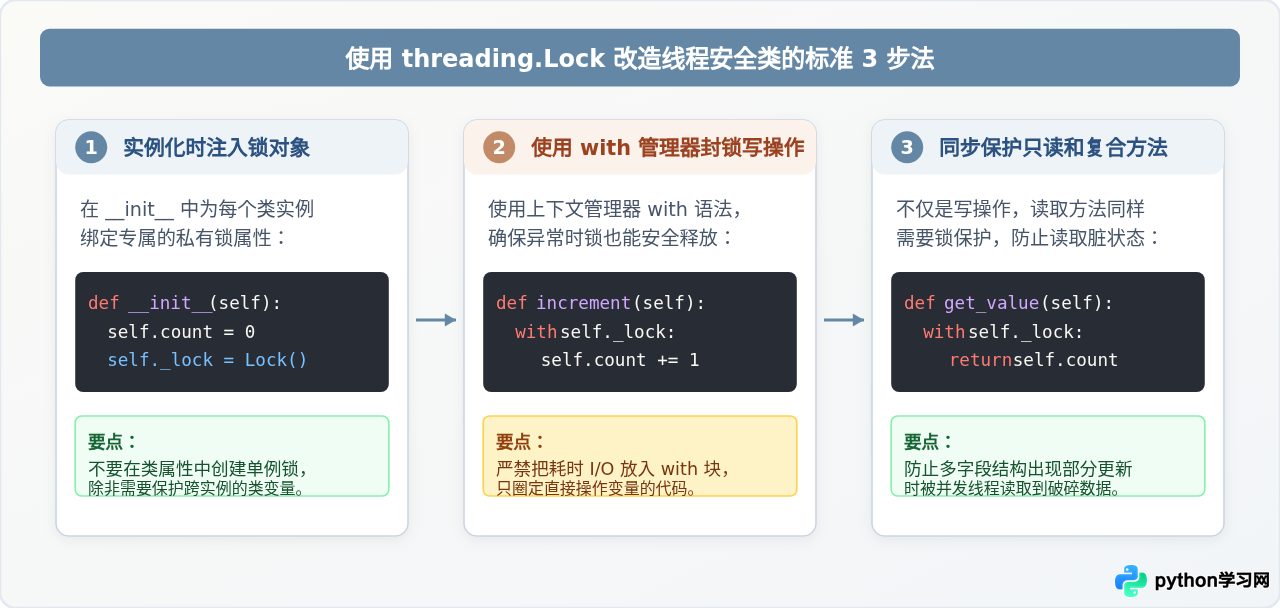
改造后的完整可运行代码如下:
import threading

class SafeCounter:
    def __init__(self):
        self._count = 0
        # 为该实例创建专用的互斥锁
        self._lock = threading.Lock()

    def increment(self, step=1):
        # 使用上下文管理器自动获取并在退出时释放锁
        with self._lock:
            self._count += step

    def get_value(self):
        # 读操作同样加锁,确保读取到完整更新后的稳定值
        with self._lock:
            return self._count
运行相同测试时,10 个线程累加的结果将准确保持在 1000000,不会产生任何数据遗漏。
方案二:方法互相调用与递归场景,改用 threading.RLock
标准的 threading.Lock 是不可重入的。如果某个方法在已经获得锁的情况下,内部又调用了本类中另一个同样需要加锁的方法,或者发生了递归调用,当前线程就会因等待自己释放锁而陷入永久自锁死锁。
此时只需要将 threading.Lock() 替换为 threading.RLock()(可重入锁,Reentrant Lock)。可重入锁允许同一个线程多次调用 acquire(),内部维护一个计数器,只有当相应次数的 release() 全部执行完毕后,锁才会被真正释放供其他线程使用。
import threading

class SafeAccount:
    def __init__(self, balance=0):
        self.balance = balance
        # 采用可重入锁避免内部方法嵌套调用导致死锁
        self._lock = threading.RLock()

    def deposit(self, amount):
        with self._lock:
            self.balance += amount

    def batch_deposit(self, amounts):
        with self._lock:
            for amt in amounts:
                # 内部直接调用同样带有 with self._lock 的 deposit 方法
                # 若使用普通的 Lock() 此处会立刻死锁,而 RLock 则能安全执行
                self.deposit(amt)
方案三:使用 queue.Queue 解耦线程间共享状态(架构级预防)
并发编程中一条广受认可的工程经验是:“不要通过共享内存来通信,而要通过通信来共享内存”。如果类中的共享变量主要用于线程之间分发任务、传递事件或聚合执行结果,与其让多个工作线程同时直接修改类属性,不如在类中使用 Python 标准库自带的线程安全队列 queue.Queue。
import queue
import threading

class TaskCollector:
    def __init__(self):
        # Queue 内部已实现完善的锁和条件变量机制,无需手动加锁
        self._tasks = queue.Queue()

    def submit_task(self, item):
        self._tasks.put(item)  # 原生线程安全入队

    def get_task(self, timeout=1.0):
        try:
            return self._tasks.get(timeout=timeout)  # 原生线程安全出队
        except queue.Empty:
            return None
方案四:不需要真正共享时,使用 threading.local() 隔离变量
很多时候,类属性被多线程访问并不是业务上真正需要跨线程合并数据,而是为了在同一个线程的多个方法之间传递会话信息(例如数据库连接、请求追踪 ID 或本地缓冲区)。如果强行使用普通类属性,线程之间就会互相串话、覆盖数据。
使用 threading.local() 可以为每个线程生成独立的属性存储槽,各线程读写互不干扰,完全避免锁带来的开销:
import threading

class ThreadContextManager:
    def __init__(self):
        # local 对象为每一个访问它的线程维护独立的属性空间
        self._thread_local = threading.local()

    def set_request_id(self, req_id):
        self._thread_local.request_id = req_id

    def get_request_id(self):
        return getattr(self._thread_local, "request_id", None)
四、如何选择最合适的数据竞争解决方案?
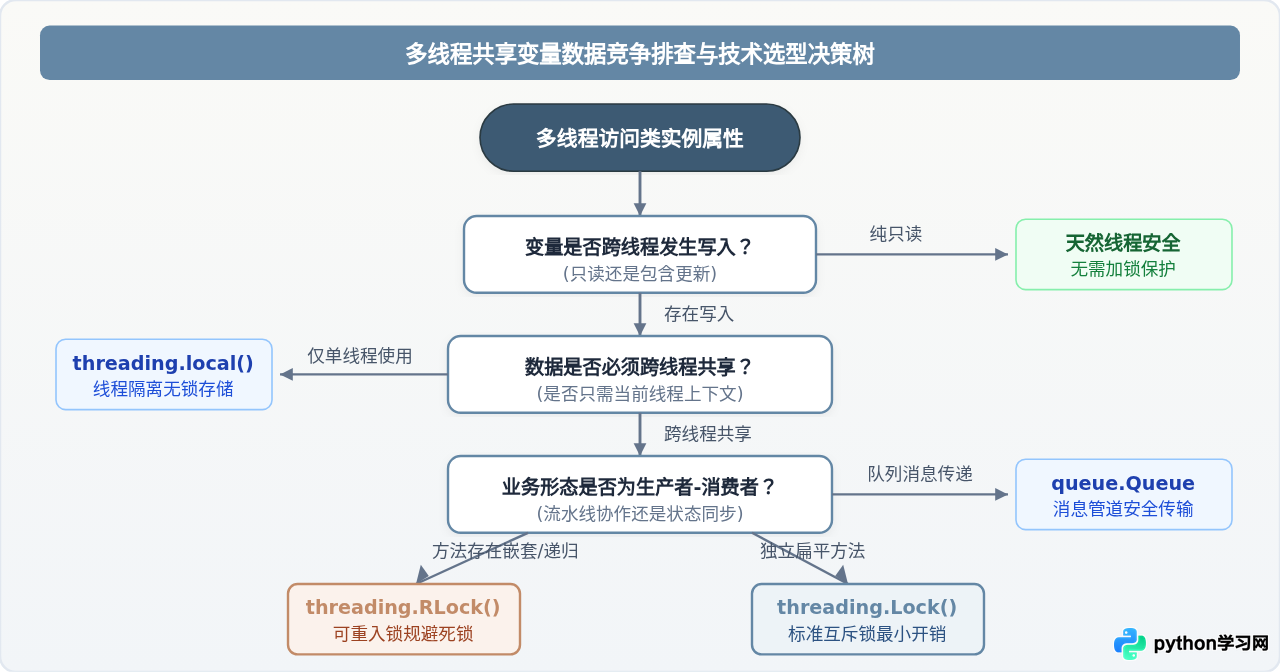
面对不同的业务形态与调用链路,盲目添加互斥锁可能会引发不必要的性能瓶颈或死锁隐患。可以按照下方的排查与决策流程树,判断最适配的防护方案:
五、生产实践中的关键陷阱与防范规范
class Service: counter = 0),此时如果在 __init__ 中定义 self._lock = Lock(),每个新创建的实例都有自己独立的锁对象!多个实例并发修改类属性 Service.counter 时,各自持有的锁无法互斥,数据竞争依然发生。规范做法:针对类变量的竞争,必须使用类级别锁(定义在类定义体中或通过类方法加锁),例如
_cls_lock = threading.Lock(),并在修改类属性时使用 with cls._cls_lock:。
with self._lock: 中,会导致所有其他并发线程全部阻塞排队,多线程并发直接退化为串行执行,并发吞吐量剧降。规范做法:遵循“最小临界区原则”:在进入锁之前完成所有前置耗时计算与数据准备,仅在真正读取或覆写共享状态的几行代码前后加锁,完成后立即释放。
self._lock.acquire() 后直接执行逻辑的代码。一旦临界区中途抛出任何异常,代码未能执行到 self._lock.release(),该锁将被永久占用,导致整个进程其他线程全部卡死。规范做法:无条件使用
with self._lock: 上下文管理器,或者在必须手动控制时严格配合 try ... finally: self._lock.release() 结构。
六、方案全景总结与特性对比
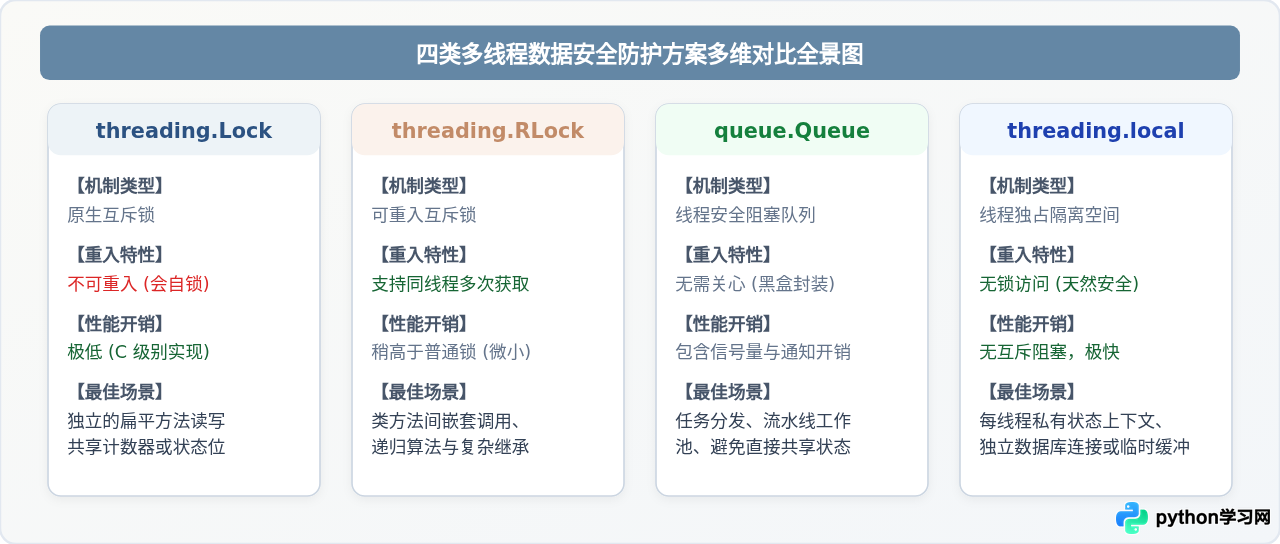
为了方便快速查阅与工程落地,下表及图示汇总了解决 Python 多线程数据竞争的四种核心机制:
| 技术方案 | 锁类型与机制 | 死锁风险 | 是否支持跨线程数据汇总 | 核心使用方式 |
|---|---|---|---|---|
| threading.Lock | 非重入互斥锁 | 嵌套调用自身时可能死锁 | 是 | with self._lock: 圈定最小范围 |
| threading.RLock | 可重入互斥锁 | 低(同线程可多次 acquire) | 是 | 适合复杂嵌套方法、递归保护 |
| queue.Queue | 线程安全 FIFO 管道 | 极低(内置超时机制) | 是(通过事件/结果队列回传) | queue.put() 与 queue.get() |
| threading.local | 各线程独立存储字典 | 无死锁(无互斥锁参与) | 否(各线程完全私有) | self._local.attr = val |
总而言之,在 Python 多线程类中,解决共享变量数据竞争的第一步是破除“GIL 等于线程安全”的迷思。只要存在多个线程交替执行非原子读写,就必须对临界区进行明确同步。绝大多数业务场景下,优先在类中植入 self._lock = threading.Lock() 并配合 with self._lock: 即可彻底解决问题;而在涉及架构设计时,通过 Queue 传递数据或利用 threading.local() 隔离上下文,往往能带来更为清爽健壮的系统设计。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















