


Python concurrent.futures实战:用标准库实现多线程与多进程
深入解析 Python 标准库 concurrent.futures 模块,全面掌握 ThreadPoolExecutor 与 ProcessPoolExecutor 的核心抽象、选型边界、API 规范与生产避坑实践。
Python 标准库内置的 concurrent.futures 模块提供了一套高度一致的高级并发抽象接口。开发者可以通过完全相同的 API 规范,在以网络或磁盘等待为主的 I/O 密集型任务中调用 ThreadPoolExecutor 释放 GIL 阻断,或在数值运算密集的 CPU 任务中调用 ProcessPoolExecutor 调度物理多核。本文将从核心抽象、基础与高级用法、线程与进程选型、典型实战模式及四大生产避坑细节展开,帮助你写出结构清晰、安全可靠的并发程序。
一、核心抽象:Executor 与 Future 生命周期
在引入 concurrent.futures 之前,Python 开发者通常需要直接操作底层的 threading.Thread 或 multiprocessing.Process,并且必须自行搭配 queue.Queue 实现生产者与消费者管道,手动管理线程/进程的启动、汇聚与异常处理。
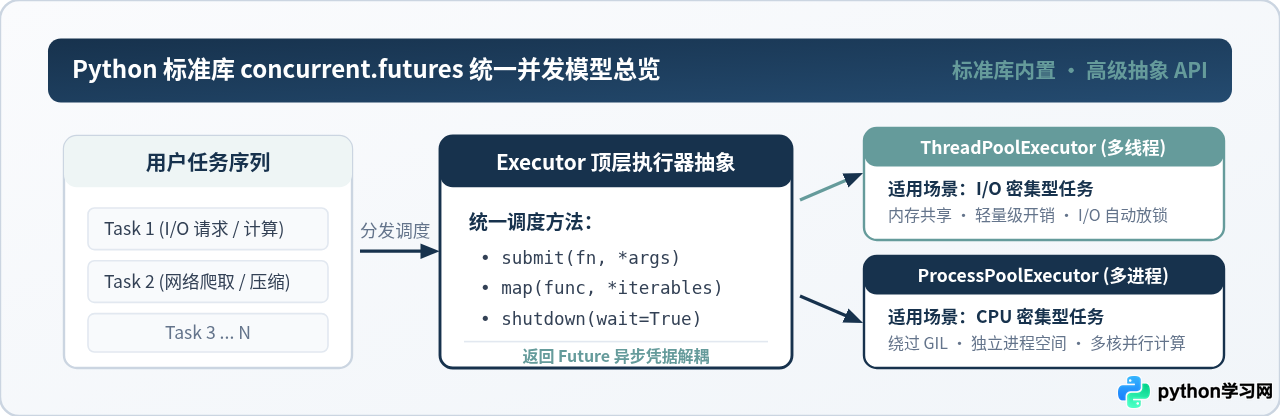
concurrent.futures 抽象出了两个核心概念:
- Executor(执行器):管理工作线程池或进程池的抽象基类,对外统一暴露任务提交接口(如
submit()与map())和生命周期管理(shutdown())。 - Future(延期凭据对象):代表一个异步执行操作的最终结果。任务投递后立即返回该凭据,调用方可以随时查询其执行状态、注册完成回调或阻塞获取返回值。
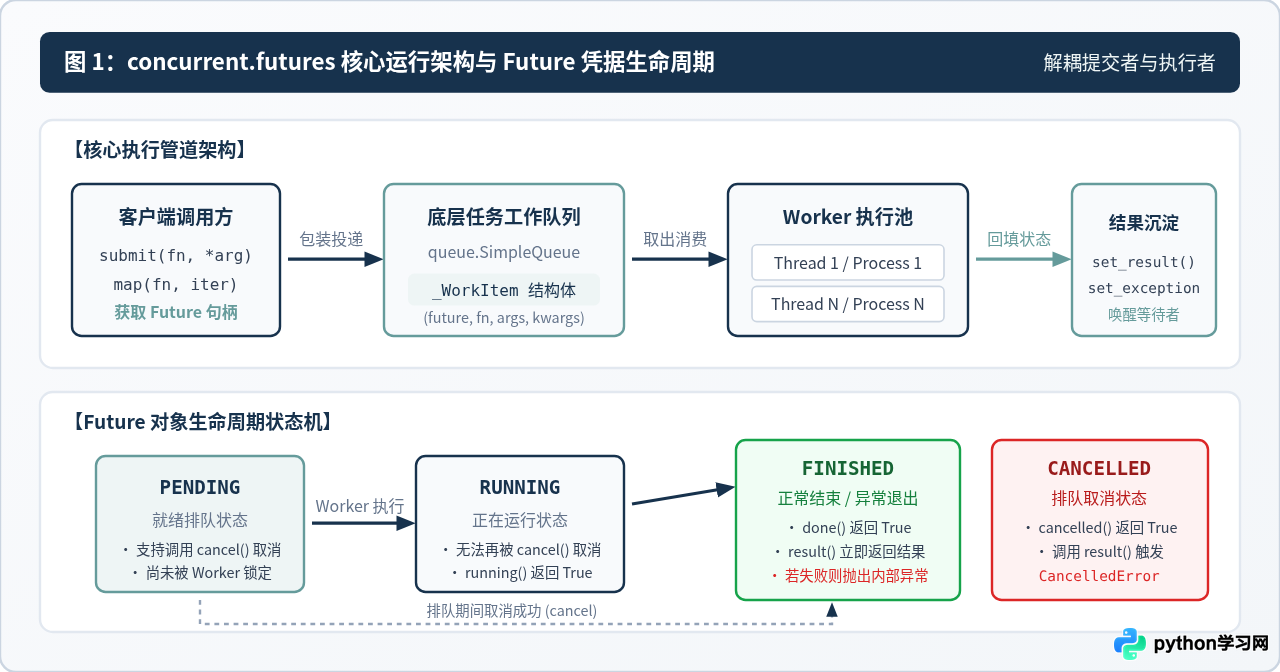
Future 对象内部封装了严格的状态机流转:
PENDING:任务已进入内部等待队列,尚未分配给 Worker 执行。此时允许调用future.cancel()尝试撤销任务。RUNNING:Worker 已经开始执行该任务。此时调用cancel()将返回False,不可中止已运行代码。FINISHED:任务顺利执行完毕或中途抛出异常,此时结果或异常对象已回填至 Future,等待调用端读取。CANCELLED:在排队阶段被成功取消的任务状态。
二、选型边界:ThreadPoolExecutor 与 ProcessPoolExecutor 对比
虽然两者的编程接口高度统一,但底层运行机制与适用场景有着本质区别。选择的核心判据在于:该任务的性能瓶颈究竟是网络/磁盘 I/O 等待,还是纯算力计算消耗。
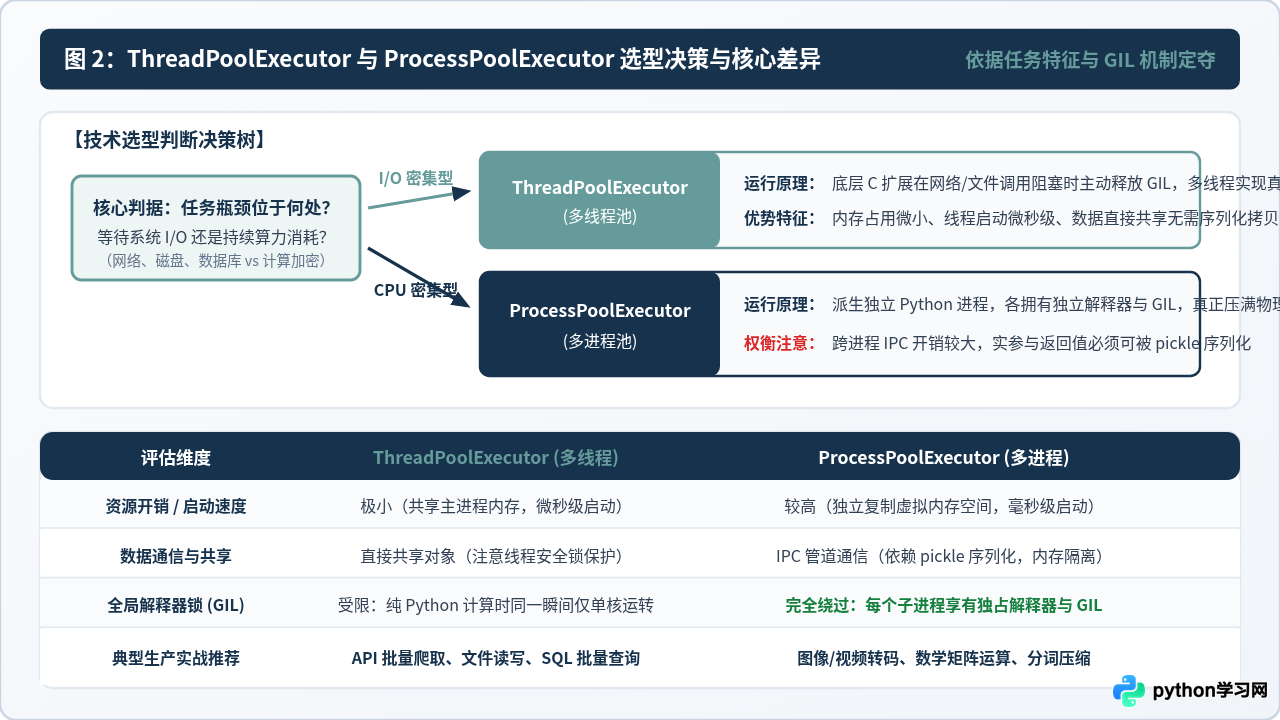
在 CPython 解释器中,全局解释器锁(GIL)确保了任何时刻只有一个原生线程在执行 Python 字节码。对于网络请求、数据库查询、磁盘读写等 I/O 密集型任务,底层的 C 系统调用会在等待期间主动释放 GIL,因此 ThreadPoolExecutor 能够以极低的内存开销实现高效并发。
但在图像滤镜处理、矩阵运算、大规模数据解压等 CPU 密集型任务中,多线程不仅无法利用多核,反而会因频繁的线程上下文切换加剧耗时。此时必须选用 ProcessPoolExecutor,它通过派生出独立的操作系统进程,每个子进程独享独立的 Python 解释器与 GIL,真正压满多核 CPU。但代价是必须承担跨进程通信(IPC)与参数的 pickle 序列化开销。
三、标准工程实战四步法
在实际工程项目中,规范使用 concurrent.futures 可以总结为四个步骤:安全实例化、灵活分发、结果监听与显式异常处理。
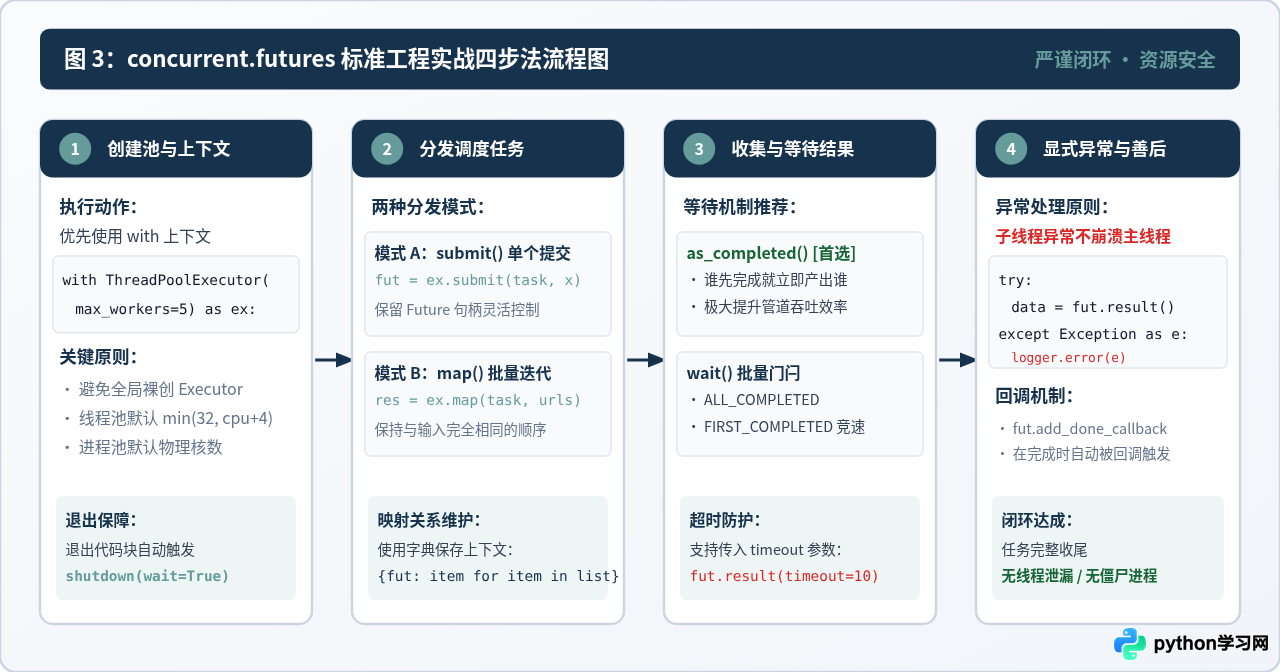
第 1 步:使用上下文管理器安全创建池
推荐始终使用 Python 的 with 语句管理执行器。这能确保在退出代码块时自动调用 executor.shutdown(wait=True),安全等待所有未完成的任务收尾,避免线程遗留或僵尸进程。
from concurrent.futures import ThreadPoolExecutor

# 显式指定最大工作线程数,避免无节制开辟导致系统负载失控
with ThreadPoolExecutor(max_workers=5) as executor:
    # 在此作用域内分发任务
    pass
# 离开 with 块时,自动隐式执行 shutdown(wait=True)
第 2 步:任务调度分发(submit 与 map 的抉择)
执行器提供了两种主要的调度方法:
submit(fn, *args, **kwargs):单个提交。立即返回独立的Future对象,适合异构参数、需要精细控制或即时监听每个任务状态的场景。map(fn, *iterables, timeout=None):批量映射。类似于内置map()函数,直接返回结果生成器,并且严格保持与输入参数一致的产出顺序。
第 3 步:异步结果收集(as_completed 模式)
当使用 submit() 提交了一批任务时,如果按提交顺序依次调用 future.result(),一旦排在前面的任务耗时很长,即使后面的短任务早已完成,主程序也会被死死阻塞。
使用 as_completed(futures_list) 可以彻底解决这一问题:无论提交先后,哪个任务先执行完毕,生成器就优先 yield 产出哪个 Future。
import time
import random
from concurrent.futures import ThreadPoolExecutor, as_completed

def fetch_data(task_id: int) -> dict:
    duration = random.uniform(0.5, 2.0)
    time.sleep(duration)
    return {"task_id": task_id, "cost": round(duration, 2)}

tasks = [1, 2, 3, 4, 5]

with ThreadPoolExecutor(max_workers=3) as executor:
    # 建立 Future 到原始入参的映射字典,便于排查与追踪
    future_to_task = {executor.submit(fetch_data, tid): tid for tid in tasks}

    # 哪个任务先完成就先处理哪个,极大提升下游处理吞吐率
    for future in as_completed(future_to_task):
        orig_id = future_to_task[future]
        try:
            data = future.result()
            print(f"[完成] 任务 {orig_id} 耗时 {data['cost']} 秒")
        except Exception as exc:
            print(f"[失败] 任务 {orig_id} 抛出异常: {exc}")
第 4 步:显式异常捕获与超时保护
Worker 内部抛出的异常不会直接导致主线程中断,而是被框架静默捕获并暂存在 Future 内部。只有当外部代码主动调用 future.result() 或 future.exception() 时,异常才会被重新抛出。因此,读取结果时务必嵌套在 try...except 块中。
此外,为了防止某个子任务因网络永久卡死或死锁,可在 result() 中设定 timeout 阈值:
try:
    # 设置 3 秒超时限制,超时则抛出 TimeoutError
    res = future.result(timeout=3.0)
except TimeoutError:
    print("任务执行超时,主流程跳过或执行降级逻辑")
except Exception as e:
    print(f"业务逻辑执行报错: {e}")
四、多进程 ProcessPoolExecutor 实战示例
对于耗费大量算力的数学运算或大文件处理,使用 ProcessPoolExecutor 能够充分释放现代多核处理器的性能。下面以高负荷质数检测计算为例:
import math
from concurrent.futures import ProcessPoolExecutor, as_completed

def is_prime(n: int) -> tuple[int, bool]:
    if n < 2:
        return n, False
    if n in (2, 3):
        return n, True
    if n % 2 == 0 or n % 3 == 0:
        return n, False
    for i in range(5, int(math.isqrt(n)) + 1, 6):
        if n % i == 0 or n % (i + 2) == 0:
            return n, False
    return n, True

# 严谨规范:ProcessPoolExecutor 的入口必须处于 __main__ 保护内
if __name__ == "__main__":
    test_numbers = [
        1000000007, 1000000009, 1000000021,
        1000000033, 1000000087, 1000000097
    ]

    print(f"开始调度多进程池计算 {len(test_numbers)} 个大质数...")
    with ProcessPoolExecutor() as executor:
        # map 适用于批量纯函数映射,保证结果顺序对应
        results = executor.map(is_prime, test_numbers)
        for num, prime_flag in results:
            status = "是质数" if prime_flag else "合数"
            print(f"数值 {num}: {status}")
五、生产环境四大避坑指南与总结
在将并发代码部署至生产环境时,许多看似正确的写法往往隐藏着死锁、内存溢出或进程崩溃的风险。请务必牢记以下四大底线规则:
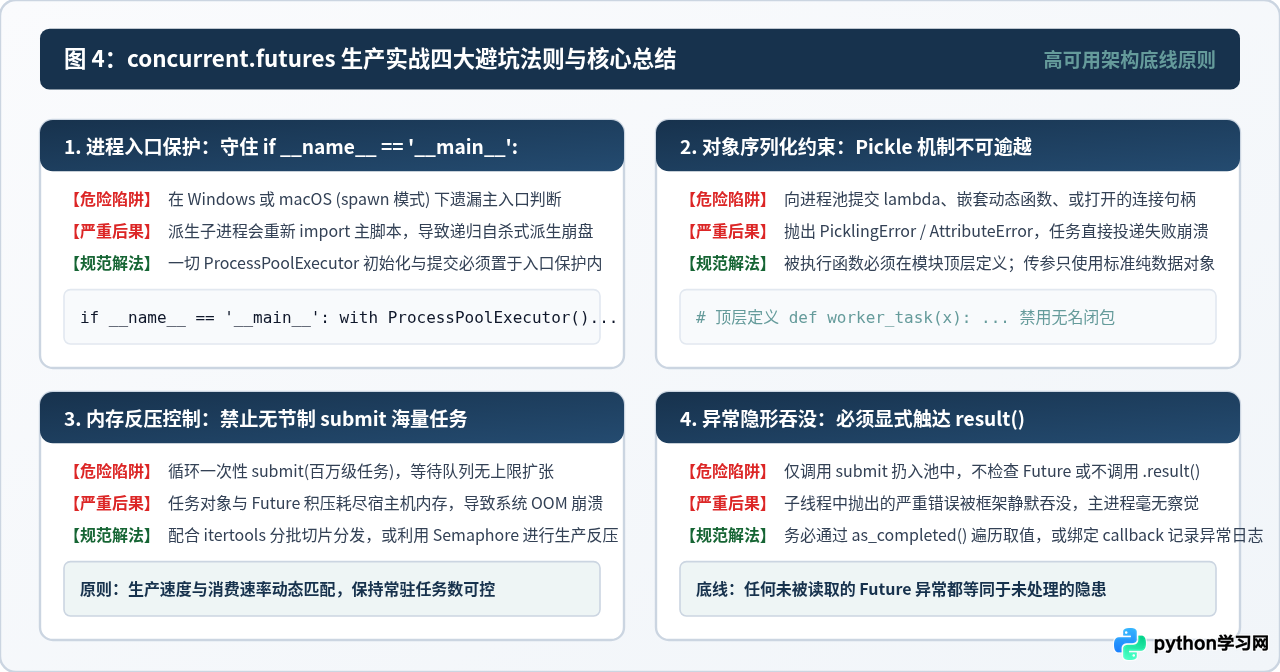
- 1. 必须使用
if __name__ == '__main__':保护:在 Windows 和 macOS 默认的spawn进程启动模式下,子进程启动时会重新完整执行入口模块代码。如果缺乏主入口保护,会导致子进程无限递归创建新的子进程,瞬时耗尽系统资源导致操作系统雪崩。 - 2. 进程池参数与返回值必须可 Pickle:跨进程调度必须通过 IPC 传输数据。因此传递给
ProcessPoolExecutor的目标函数不能是动态生成的匿名lambda函数,类方法或闭包也必须确保能够被pickle序列化,数据库连接、文件句柄等 OS 原生资源不可跨进程直接传递。 - 3. 警惕海量任务无界提交导致 OOM:执行器内部的任务队列是无界队列。如果一次性循环
submit数百万个任务,队列中积压的_WorkItem和Future对象会迅速吞噬数 GB 内存。面对大规模任务集,应使用itertools.islice分批提交,或利用threading.Semaphore构造背压控制。 - 4. 切勿遗漏 Future 异常检查:子任务发生崩溃时不会自动打印 traceback。如果不遍历获取结果,错误将永久隐蔽。生产系统建议结合
future.add_done_callback(log_exception)或集中化消费确保异常可感知、可监控。
掌握 concurrent.futures 的核心精髓在于:以 Executor 解耦任务投递与执行,以 Future 掌控异步生命周期,按 I/O 与 CPU 边界审慎抉择线程池与进程池。遵循标准工程范式,即可用简洁的 Python 标准库代码构建出高吞吐、强容错的并发服务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















