


Python怎么用多个不同字符分割字符串:split局限与re.split方案
深入解析Python中如何使用多个不同字符分割字符串。对比原生str.split的单子串局限与replace链的性能代价,详解标准库re.split的正则字符集语法、量词应用、捕获括号陷阱排查及大规模高频处理优化策略。
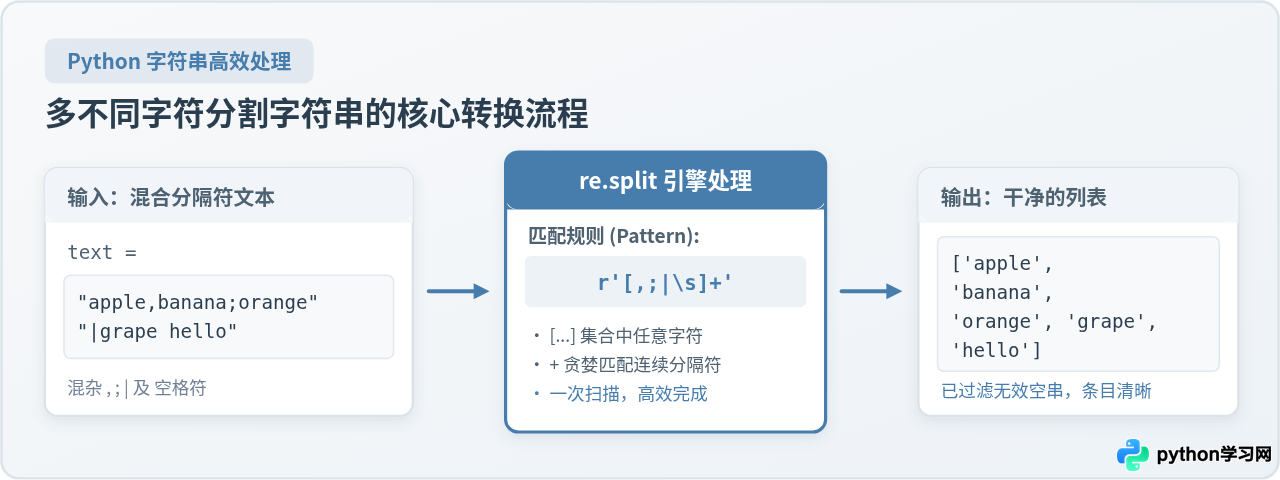
str.split() 传入多个分隔符,但该方法只接受单一固定子串。要同时根据逗号、分号、竖线或多种空白字符切分字符串,最规范且高效的方案是使用 Python 标准库中的 re.split() 函数。本文解析 str.split() 的底层匹配机制局限,说明如何通过正则表达式字符集构建多字符切分规则,并针对容易产生空字符串、意外捕获分隔符等核心细节提供具体代码和处理策略。
一、str.split 的机制局限与传统替代方案的代价
Python 字符串对象的内置方法 str.split(sep=None, maxsplit=-1) 是最常用的切分工具。当不传参数时,它会将连续的空白字符(空格、制表符 、换行符
)统一视作分隔符,并自动忽略首尾多余空白。然而,一旦明确指定了 sep 参数,它的匹配逻辑就完全变成了精确子串比对。
1. 为什么传入多个字符会失效
很多开发者在面对 "apple,banana;orange" 这样混杂逗号与分号的数据时,会下意识写出 text.split(",;")。但运行后会发现,字符串并未按逗号或分号分别拆分,而是整体作为一个未被切分的列表返回:
# 示例代码:错误地将多个分隔符整体传入 str.split()
text = "apple,banana;orange"
result = text.split(",;")

# 示例输出:
# result: ['apple,banana;orange']
这是因为在 Python 底层,str.split() 将 ",;" 视为一个长度为 2 的连续字节序列。它只会在文本中严格查找逗号紧跟分号的位置。当文本中的分隔符单独出现时,该条件无法触发。
2. 链式 replace 替换法的缺陷
在不引入正则表达式的情况下,一种常见的折中思路是先通过多次调用 str.replace() 将所有异构分隔符统一替换为同一种字符,最后再执行 str.split():
# 示例代码:采用链式 replace 规避多字符分割
text = "apple,banana;orange|grape hello"
standardized = text.replace(';', ',').replace('|', ',').replace(' ', ',')
result = standardized.split(',')

# 示例输出:
# result: ['apple', 'banana', 'orange', 'grape', 'hello']
这种写法在分隔符种类仅有两三种、数据规模极小时可以应急,但在正式项目中存在显著弊端:
- 多次内存分配开销:Python 的字符串是不可变对象(immutable)。每一次调用
.replace()都会在内存中完整复制并生成一个新的临时字符串对象。如果待处理文本较长或处于密集循环中,会产生大量瞬时垃圾对象。 - 无法有效应对不规则空白:如果文本中混合了不定长度的空格、Tab 制表符或回车换行,
replace()无法像正则表达式那样通过模式直接匹配任意空白序列,很容易在切分后遗留大量未清洗的空白片段。 - 维护成本随字符数量线性上升:当新增切分符号要求(如增加冒号、斜杠、顿号)时,必须持续拼接新的
replace()调用,代码冗长且脆弱。
二、使用 re.split 实现多字符分割:语法与规则构建
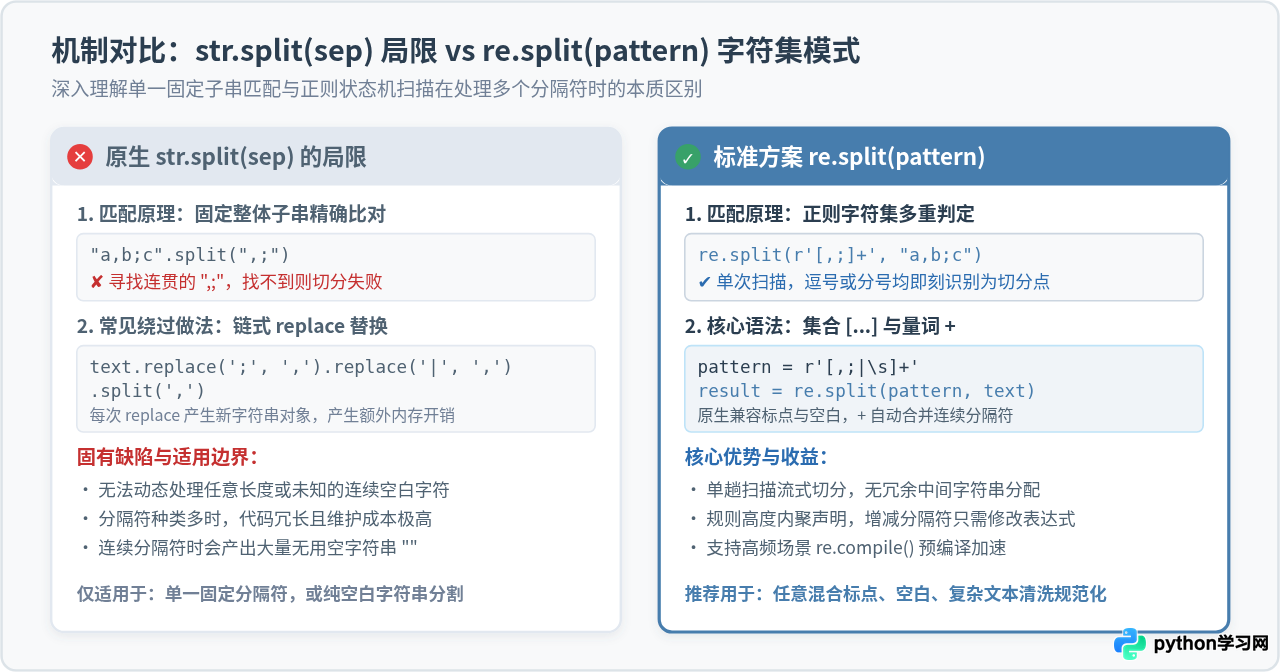
针对多字符分割需求,Python 标准库的 re(Regular Expression)模块提供了专门的 re.split() 函数。它允许将一个正则表达式作为分隔模式,在一次线性扫描中识别所有满足条件的分隔边界。
1. 核心语法:利用字符集 [...]
在正则表达式中,方括号 [...] 声明了一个“字符集”(Character Class),表示匹配括号中罗列的任意单个字符。例如,表达式 r'[,;|\s]' 能够同时匹配逗号、分号、竖线或任意空白符:
import re

text = "apple,banana;orange|grape peach"

# 使用字符集作为分割依据
result = re.split(r'[,;|\s]', text)

# 示例输出:
# result: ['apple', 'banana', 'orange', 'grape', 'peach']
2. 量词 + 的关键作用:抑制冗余空字符串
真实数据中经常出现多个分隔符连续排列的情况,比如逗号后跟随空格(", ")或多个连续分号(";;")。若仅使用 r'[,;|\s]',每个字符都会被单独视为一次分割,两两之间将产生多余的空字符串 "":
# 未添加量词时的现象
text = "apple,  banana;;orange"
print(re.split(r'[,;\s]', text))
# 示例输出:包含大量无意义的空字符串
# ['apple', '', '', 'banana', '', 'orange']
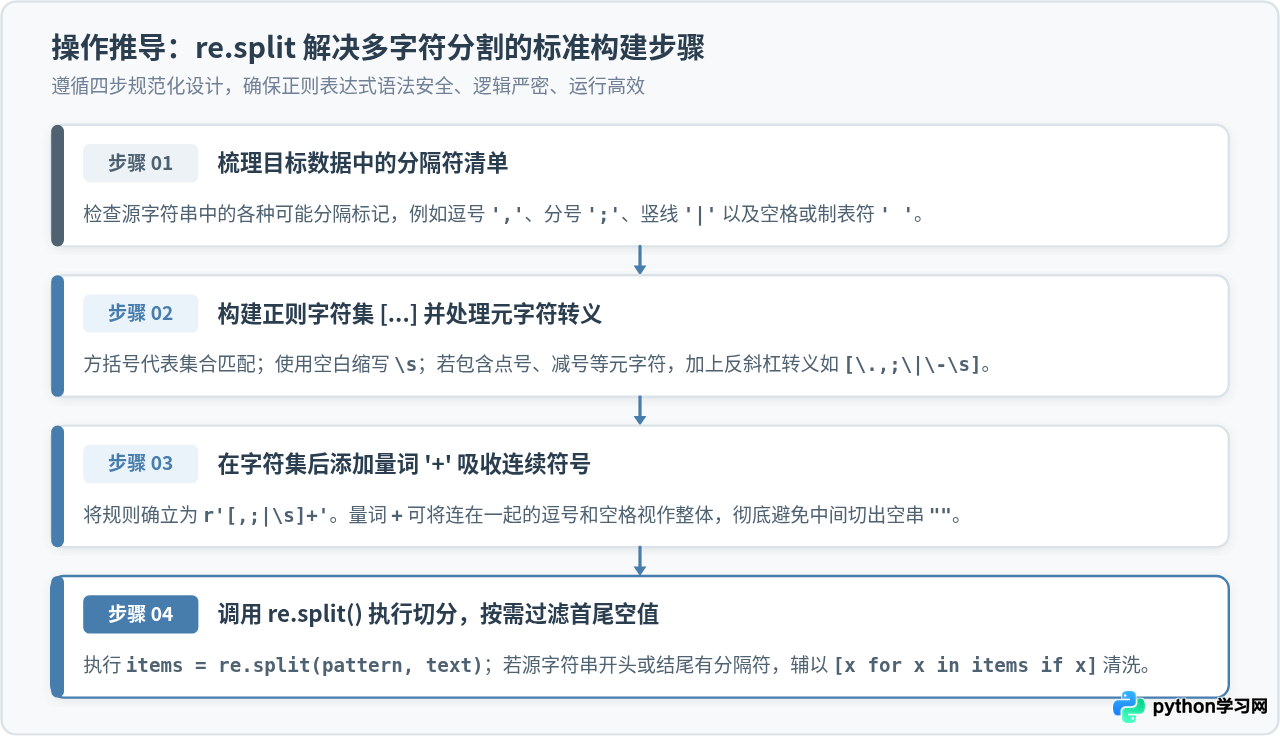
解决该问题的标准做法是在字符集后追加量词 +,即 r'[,;\s]+'。加号表示“匹配前面的字符集一次或多次”。此时,连续出现的逗号、分号或空格会被整体折叠为一个复合切分边界:
# 添加量词 + 后的表现
result = re.split(r'[,;\s]+', text)
print(result)
# 示例输出:连续分隔符被整体消耗
# ['apple', 'banana', 'orange']
3. 特殊字符与正则元字符的安全转义
在字符集内部,绝大部分普通标点(如逗号、分号、竖线、下划线)不需要转义。但有两类特殊字符需要格外注意:
- 短横线(减号
-):在方括号内,短横线若位于字符之间,会被解释为 ASCII 码区间(例如[a-z]或[0-9])。如果希望将减号本身作为分隔符,必须将其放置在字符集的开头、末尾,或者使用反斜杠转义,如r'[,\-;]+'。 - 点号(
.)、问号(?)、星号(*):尽管方括号内的点号通常被当作字面量点号,但为了避免与全局模式混淆并保证团队代码风格的确定性,建议带有特殊语义的字符统一进行前置转义,例如r'[\.,;\?!]+'。
三、必须规避的两个关键细节陷阱
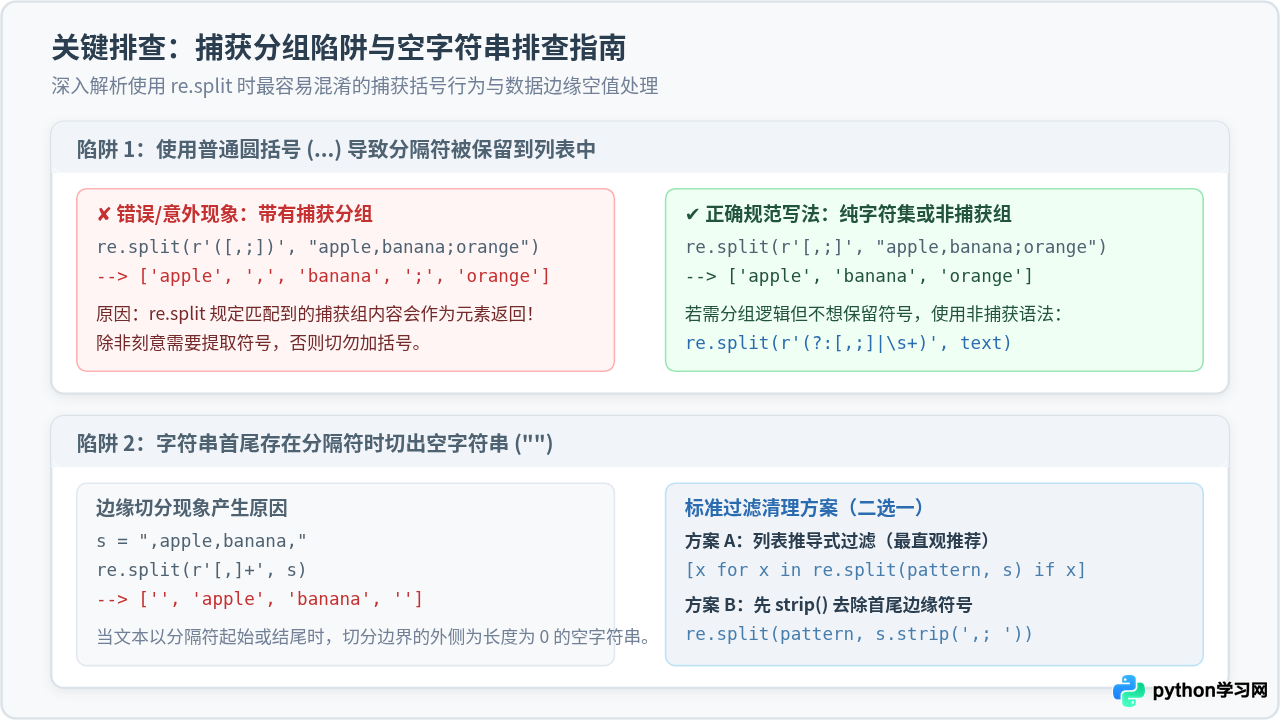
在使用 re.split() 时,初学者最容易在“捕获分组”与“首尾边界空值”两处细节上遇到非预期行为。
1. 捕获括号导致分隔符被保留到结果中
在正则表达式中,普通圆括号 (...) 代表“捕获分组”(Capturing Group)。在 re.split() 中,Python 规范定义:如果分隔表达式中包含捕获括号,那么匹配到的分隔符文本会被作为独立元素保留在返回列表中。
# 陷阱示例:模式中带有了普通圆括号
text = "apple,banana;orange"
res_with_group = re.split(r'([,;])', text)
print(res_with_group)

# 示例输出:分隔符被原样穿插在列表中
# ['apple', ',', 'banana', ';', 'orange']
除非业务上有明确需求要追踪每个元素具体由哪个符号隔开,否则在纯拆分任务中切勿使用普通圆括号。如果因为逻辑组合必须使用括号(例如结合 | 处理多字符单词分隔),应使用非捕获分组语法 (?:...):
# 正确做法:使用非捕获分组 (?:...)
res_non_capturing = re.split(r'(?:,|;|\s+)', text)
print(res_non_capturing)
# 示例输出:干净的结果列表
# ['apple', 'banana', 'orange']
2. 首尾分隔符引发的空字符串清理
如果原始字符串的开头或结尾恰好存在分隔符,即便在模式中使用了 +,返回列表的首尾也必然会出现空字符串 "":
# 边缘分隔符现象
raw_text = ",,apple,banana;orange; "
raw_items = re.split(r'[,;\s]+', raw_text)
print(raw_items)

# 示例输出:首尾出现空字符串
# ['', 'apple', 'banana', 'orange', '']
这是因为切分算法以开头匹配到的连续符号为界,符号左侧没有字符,因此生成一个长度为 0 的空字符串。针对该问题,工业界常用以下两种清洗手段:
- 手段 A:列表推导式后置过滤(推荐):直接通过
[item for item in items if item]过滤掉假值空串。此写法意图明确且具备通用性。 - 手段 B:输入前 strip() 预处理:如果已知所有可能的分隔符号,可在分割前先调用
raw_text.strip(',; ')剔除首尾外围符号。
四、高频与批量场景下的性能优化:re.compile
当需要对数十万行日志或海量文本字段进行循环切分时,直接使用 re.split(pattern, text) 会在底层经历正则表达式的解析与缓存查询开销。
虽然 Python 内部对最近使用过的正则表达式有局部 LRU 缓存,但在性能敏感的高频循环中,最佳实践是先通过 re.compile() 将模式编译为不可变的 Pattern 对象,之后反复调用其 split() 方法:
import re

# 1. 预先编译正则表达式对象
SPLIT_PATTERN = re.compile(r'[,;|\s]+')

def clean_and_tokenize(lines):
    tokenized_data = []
    for line in lines:
        # 2. 复用编译好的正则对象,结合推导式过滤空串
        tokens = [token for token in SPLIT_PATTERN.split(line) if token]
        tokenized_data.append(tokens)
    return tokenized_data

# 测试批量处理
sample_lines = [
    "user1,admin;active|dept_01",
    "user2 guest;disabled|dept_02",
    ";user3,operator;;dept_03 "
]
print(clean_and_tokenize(sample_lines))
# 示例输出:批量干净的切分结果
# [['user1', 'admin', 'active', 'dept_01'], ['user2', 'guest', 'disabled', 'dept_02'], ['user3', 'operator', 'dept_03']]
五、各分割方案技术特征与场景选型总结
在实际工程开发中,不必将所有文本切分任务都盲目交给正则表达式。选择最贴合当前数据结构与吞吐量要求的工具,是保持代码轻量与执行高效的关键。
| 方案类型 | 核心调用示例 | 执行效率 | 代码可读性 | 最佳适用场景 |
|---|---|---|---|---|
| 原生 str.split | s.split(',') |
极高(底阶 C 实现) | 极佳 | 标准 CSV 等单一已知字符分隔 |
| 原生无参 split | s.split() |
极高 | 极佳 | 英文句子、纯空白符(空格/Tab/换行)任意混杂 |
| 链式 replace + split | s.replace(';', ',').split(',') |
中偏低(多次内存复制) | 较差 | 严格受限环境下仅有 2 种固定字符且数据量微小 |
| 标准 re.split | re.split(r'[,;|\s]+', s) |
高(正则单趟扫描) | 优秀 | 混合多种标点符号、不可预测空白的多字符分割 |
| 预编译 re.compile | pattern.split(s) |
高且稳定 | 优秀 | 大规模数据集、ETL 清洗管道、Web 请求高频处理 |
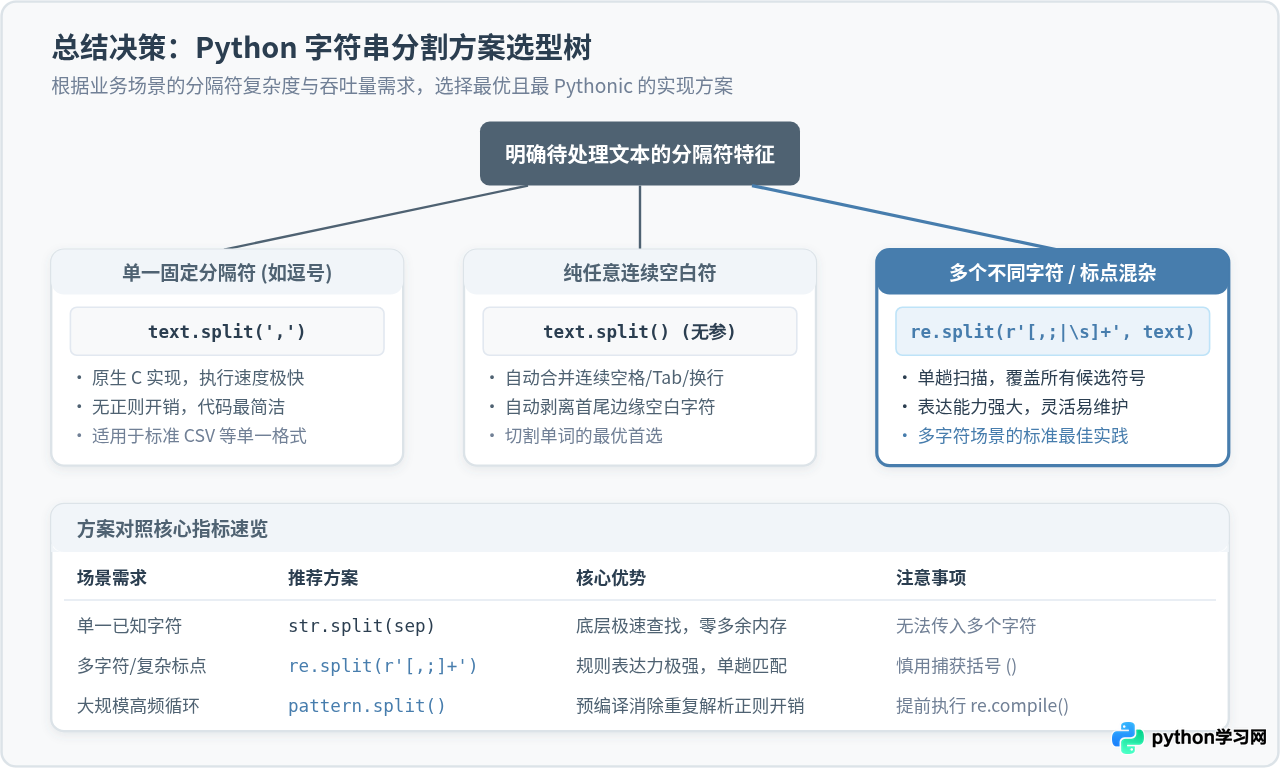
对于单一字符或纯空白文本,优先使用原生 str.split();对于任意包含两种及以上不同标点、空白符混杂的场景,坚决采用 re.split(r'[...]+', text) 方案,并在模式中使用字符集语法且避开捕获圆括号。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















