


Python嵌套列表怎么正确切片?多维序列操作误区
深入解析Python嵌套列表无法直接进行多维切片的原因,拆解matrix[0:2][0]与matrix[:, 0]等常见操作误区,并提供列表推导式、zip转置及NumPy三种标准切片实现与浅拷贝避坑方案。
[[1, 2, 3], [4, 5, 6]] 的嵌套列表本质上只是“包含子列表引用的一维指针序列”,语言层面并不存在真正的原生多维数组类型。初学者习惯写出的 matrix[:, 0] 会直接触发 TypeError,而链式切片 matrix[0:2][0] 也只会提取第一行整行,而非多行的某一列。在不引入外部库的前提下,正确提取列或子矩阵的标准方式是使用列表推导式(如 [row[0] for row in matrix]);若需全量行列互换可使用 zip(*matrix);而在海量数值计算场景中,则应直接迁移到支持多轴切片的 NumPy ndarray。
一、典型误区:为什么 matrix[0:2][0] 切不出列数据?
初学 Python 时,很多开发者在面对二维表格数据时,直觉上会联想到常规的数学坐标系或线性代数矩阵记号,认为方括号中的连续切片能分别控制行和列。最典型的写法就是试图使用链式切片提取前两行的第 0 列:
# 准备一个 3x3 的嵌套列表
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

# 很多开发者的心理预期:切出前两行的第 0 列,期望得到 [1, 4]
result = matrix[0:2][0]
print("运行结果:", result)输出结果并非预期的第 0 列元素 [1, 4],而是第 0 行整行数据 [1, 2, 3]。产生这一现象的根本原因在于 Python 对连续方括号表达式的从左至右串行求值机制。
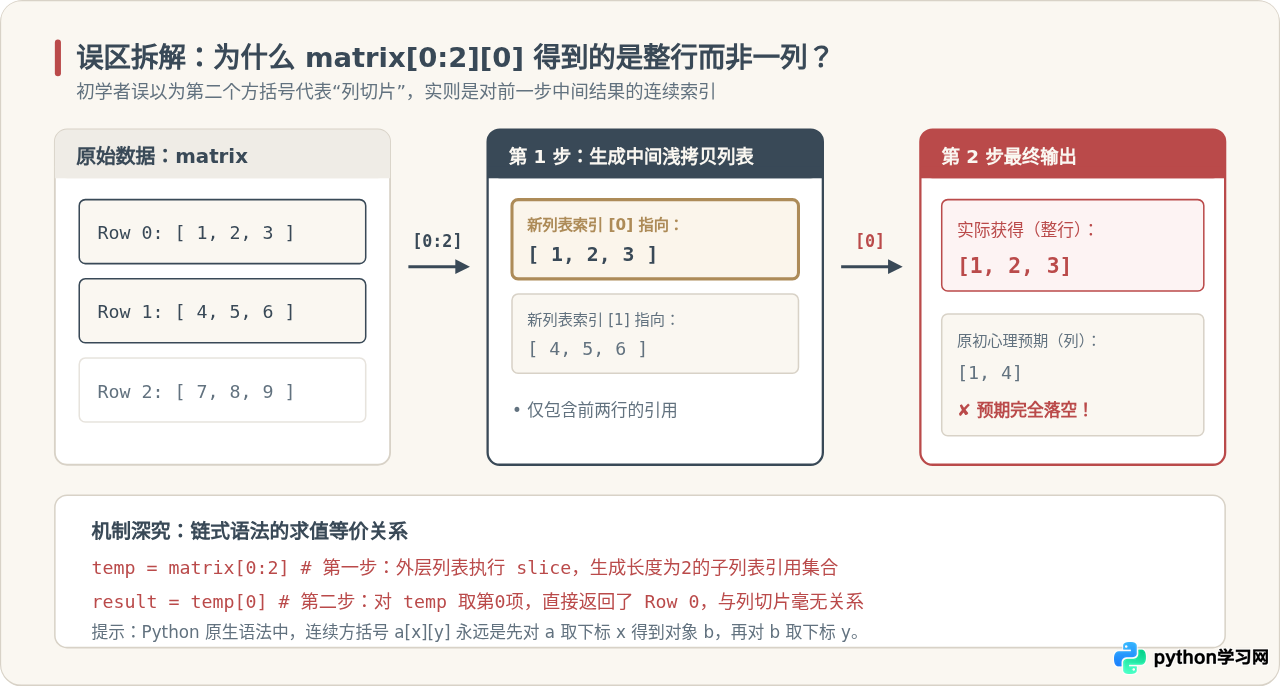
如图 1 所示,表达式 matrix[0:2][0] 在解释器内部被严格划分为两个完全独立的计算步骤:
- 第一步(行切片求值):解释器首先执行
matrix[0:2]。该操作对外部一维列表进行切片,生成了一个新的中间列表。这个中间列表包含原列表的前两项,即[[1, 2, 3], [4, 5, 6]]。 - 第二步(单项索引求值):紧接着的
[0]并不是作用在多维空间中,而是直接作用在刚刚生成的新列表上。取该新列表中下标为 0 的元素,自然就是它的第一项——即原列表的第 0 行[1, 2, 3]。
a[x][y],在语义上完全等价于 temp = a[x]; res = temp[y]。第二个方括号永远只认识第一个方括号返回的对象。如果第一步切片返回的是包含多个列表的序列,第二步单整数索引拿到的就只能是其中的某一个子列表,绝无可能跨越各个子列表纵向抽取元素。
二、底层机制:嵌套列表与多维数组的本质鸿沟
另一个高频报错是直接套用 NumPy 语法的逗号索引:matrix[0, 1] 或 matrix[:, 0]。在纯原生 Python 列表上运行此类代码,会立即抛出异常:
>>> matrix = [[1, 2], [3, 4]]
>>> matrix[:, 0]
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: list indices must be integers or slices, not tuple
这个报错揭示了 Python 原生数据结构与专业科学计算库之间的底层架构差异:
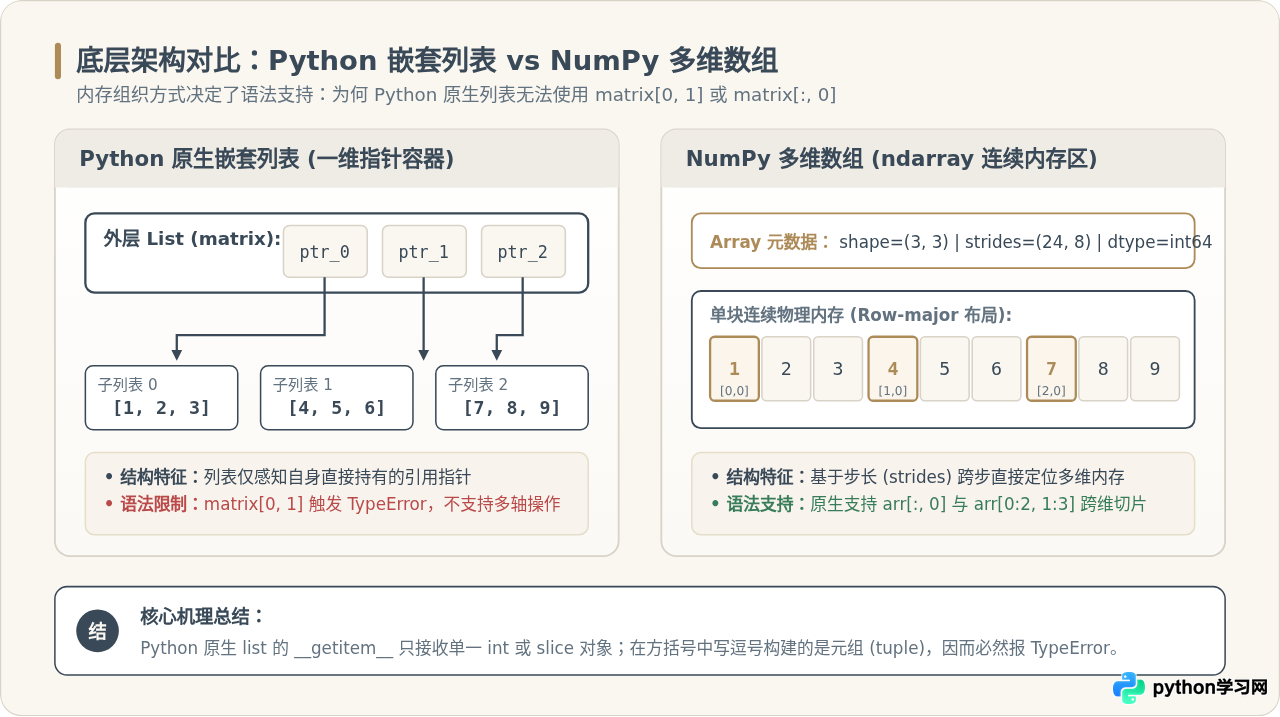
1. 为什么方括号里写逗号会变成 tuple?
在 Python 语法中,任何在方括号内由逗号分隔的表达式(如 [:, 0]),都会被解释器打包为一个元组 (slice(None, None, None), 0),然后传递给对象的 __getitem__(self, key) 方法。
Python 原生 list 的底层 C 实现(PyListObject)被设计为一维变长数组。其 __getitem__ 仅接受单个整数(用于索引)或 slice 对象(用于单维切片)。当它接收到一个元组对象时,由于没有处理多轴元组的逻辑,便会断然抛出 TypeError: list indices must be integers or slices, not tuple。
2. 内存引用的非连续性
如上方图 2 所示,NumPy 的 ndarray 在内存中是一块连续的数据缓冲区(Contiguous Buffer),它附带了步长(strides)和维度形状(shape)等元数据。当对 ndarray 执行多维切片时,NumPy 仅需通过简单的数学乘加运算改变起始指针与步长,就能以零内存复制的“视图(View)”形式高效返回跨列切片。
相比之下,原生 Python 嵌套列表的外层列表存储的仅仅是 3 个指针,这 3 个指针分别指向堆内存中离散分配的 3 个独立 list 实例。外层容器对其内部元素的内部结构一无所知,不可能凭空实现跨离散对象的步进内存寻址。
三、解决方案:正确切取多维序列的 3 种标准方式
既然原生语法不支持直接切片,在实际开发中如何准确提取嵌套列表的某一列、指定步长列或任意子矩阵?以下是三种经过工程检验的标准解决方案。
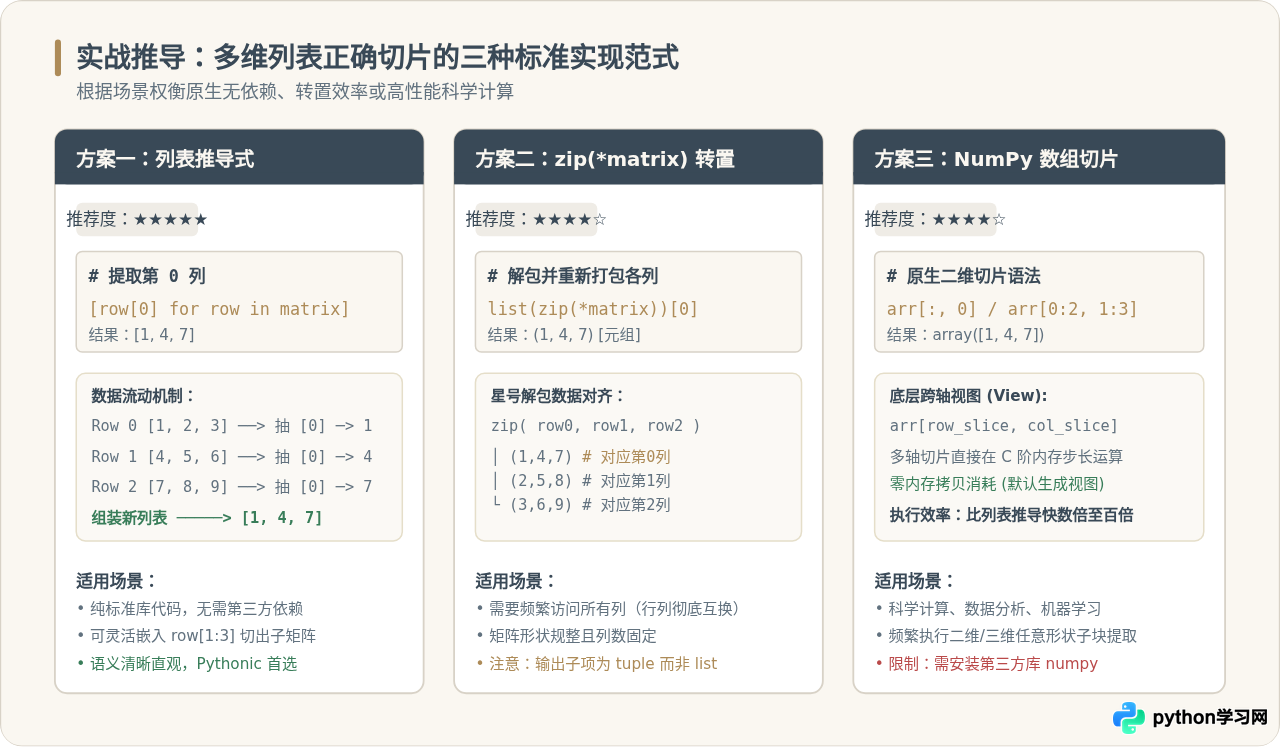
方法 1:列表推导式(轻量、通用、Pythonic)
列表推导式是处理原生嵌套列表切片最自然、最符合 Python 习惯的方法。其原理是:显式遍历外层列表中的每一行,针对每一行单独提取对应的列元素或执行行内切片。
matrix = [
    [10, 20, 30, 40],
    [50, 60, 70, 80],
    [90, 100, 110, 120]
]

# 场景 A:提取单列(如提取第 1 列:[20, 60, 100])
col_1 = [row[1] for row in matrix]
print("第 1 列数据:", col_1)

# 场景 B:切取多行多列的子矩阵(如提取第 0~2 行的前两列)
sub_matrix = [row[0:2] for row in matrix[0:2]]
print("2x2 子矩阵:", sub_matrix)

# 场景 C:带步长切片(隔行、隔列提取)
stride_matrix = [row[::2] for row in matrix[::2]]
print("步长切片结果:", stride_matrix)[row[1] for row in matrix[0:2]] 即可;若原矩阵每行长度不一致(不规则锯齿列表),推导式还能结合条件 if len(row) > 1 进行安全防御,容错率极高。
方法 2:zip(*matrix) 星号解包(矩阵转置技巧)
当需求涉及提取全部列,或者对二维表格进行全量行列互换时,利用 Python 内置的 zip() 函数搭配星号解包操作符(*)是代码量极少的优雅实现:
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

# 步骤解析:*matrix 将列表解包为 3 个独立实参传入 zip
# zip([1, 2, 3], [4, 5, 6], [7, 8, 9]) 按位置聚合元素
columns = list(zip(*matrix))
print("全量转置列集合:", columns)

# 获取第 0 列
col_0 = columns[0]
print("第 0 列元组:", col_0)zip() 打包返回的每一项默认是不可变的 tuple。如果后续流程严格要求可变列表类型,可配合推导式转换:[list(col) for col in zip(*matrix)]。另外,如果各子列表长度不同,标准 zip 会截断到最短子列表,此时若需保留全部数据应使用 itertools.zip_longest。
方法 3:借助 NumPy 数组进行多轴切片(复杂与海量数据)
若你的程序涉及大量矩阵乘除、高维几何计算、图像矩阵处理或数以百万计的元素截取,将数据转换为 NumPy 的 ndarray 是性能最优解:
import numpy as np

matrix = [
    [1,  2,  3,  4],
    [5,  6,  7,  8],
    [9, 10, 11, 12]
]

# 转换为 NumPy 连续数组
arr = np.array(matrix)

# 纯正的多维逗号切片语法:行切片在前,列切片在后
col_2 = arr[:, 2]              # 提取第 2 列
sub_block = arr[0:2, 1:4]      # 提取 0~1 行与 1~3 列交集

print("NumPy 第 2 列:", col_2)
print("NumPy 截取子块:
", sub_block)四、多维序列操作的另一大深坑:浅拷贝乘法陷阱
在讨论切片操作之前,必须提及导致多维切片与修改行为诡异的“罪魁祸首”——乘法浅拷贝初始化。许多开发者在创建多维矩阵时,习惯写出如下代码:
# 致命误区:试图创建一个 3x3 初始值为 0 的矩阵
bad_matrix = [[0] * 3] * 3
print("初始化矩阵:", bad_matrix)

# 修改第 0 行第 0 列的值
bad_matrix[0][0] = 99
print("修改 bad_matrix[0][0] 后的结果:", bad_matrix)仅仅修改了 [0][0],结果每一行的第一个数字全变成了 99!
原因剖析:内层 [0] * 3 创建了一个包含三个 0 的列表对象。而外层的 * 3 并没有把该列表复制三份新实例,而是把同一个子列表的内存引用地址复制了三次。外层列表里的 3 个指针其实指向同一块内存空间,任何一行的变动都会同步反映在所有行上。
避坑正确写法:必须使用列表推导式,确保每次迭代都触发一次新的内存对象分配:
# 正确方案:独立创建 3 个子列表对象
correct_matrix = [[0] * 3 for _ in range(3)]
correct_matrix[0][0] = 99
print("正确矩阵修改后:", correct_matrix)五、总结:选型决策与速查对照
理解了 Python 嵌套列表切片的机理与限制之后,我们在日常编程中可以依照以下决策路径进行技术选型:
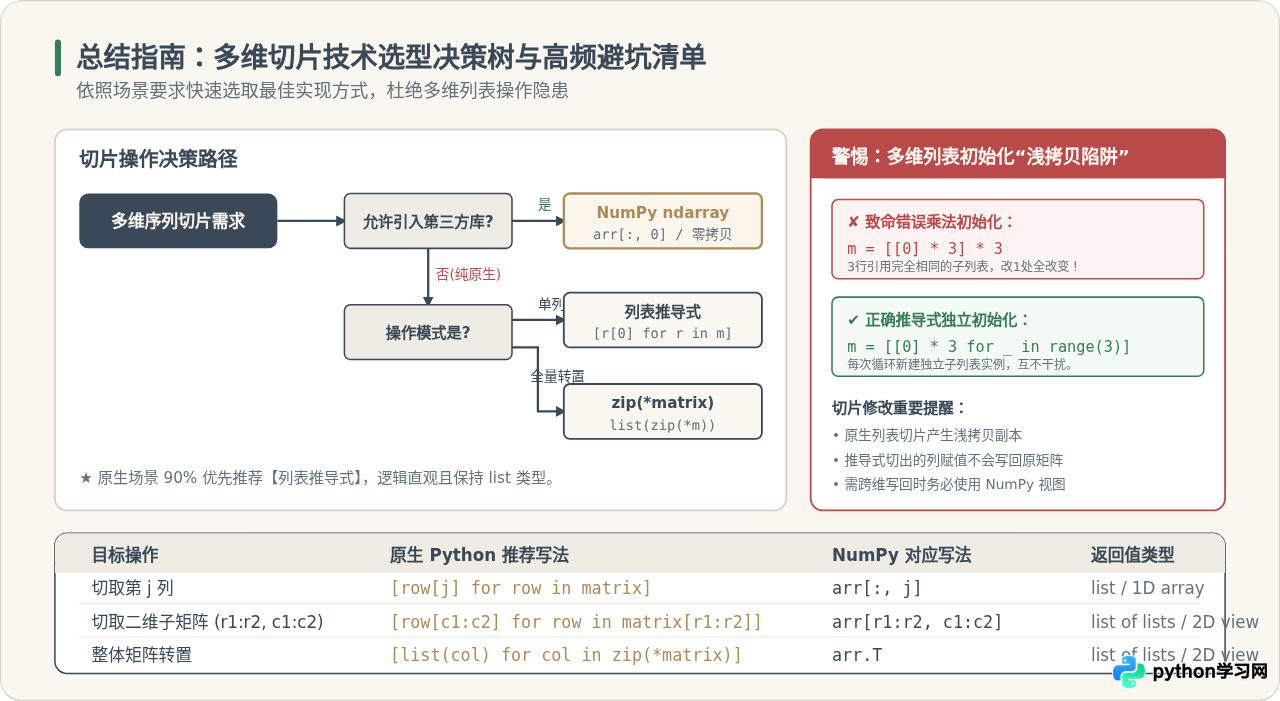
| 操作目标 | 原生推荐写法 | NumPy 对应语法 | 核心特性说明 |
|---|---|---|---|
| 切取整行(第 i 行) | matrix[i] |
arr[i, :] |
两者原生均原生支持,直接返回单行 |
| 切取单列(第 j 列) | [row[j] for row in matrix] |
arr[:, j] |
原生需推导式遍历;NumPy 原生支持多轴切片 |
| 切取子矩阵 (r1:r2, c1:c2) | [r[c1:c2] for r in matrix[r1:r2]] |
arr[r1:r2, c1:c2] |
原生推导式双重切片;NumPy 步长切片生成视图 |
| 全矩阵转置互换 | list(zip(*matrix)) |
arr.T |
zip 产物为 tuple 序列;NumPy .T 为零拷贝视图 |
| 多维序列安全初始化 | [[0]*cols for _ in range(rows)] |
np.zeros((rows, cols)) |
坚决杜绝使用 [[0]*c]*r 浅拷贝乘法 |
归纳而言,Python 嵌套列表的灵活性来自于其动态指针模型,但这一模型也决定了多维操作必须通过显式遍历或内置函数协作完成。牢记“方括号连续写是链式索引,方括号写逗号是传入元组”这一语法铁律,并在适当的场景选用列表推导式或专业的 NumPy 工具,就能彻底远离多维序列切片的各类诡异报错与陷阱。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















