


怎么用pandas3.0的新字符串类型避免编码报错?
深入讲解pandas 3.0基于PyArrow的新字符串类型(string[pyarrow]),剖析传统object类型引发编码报错的底层机制,提供三步实战迁移方法、源编码匹配技巧及自查清单,彻底杜绝UnicodeDecodeError。
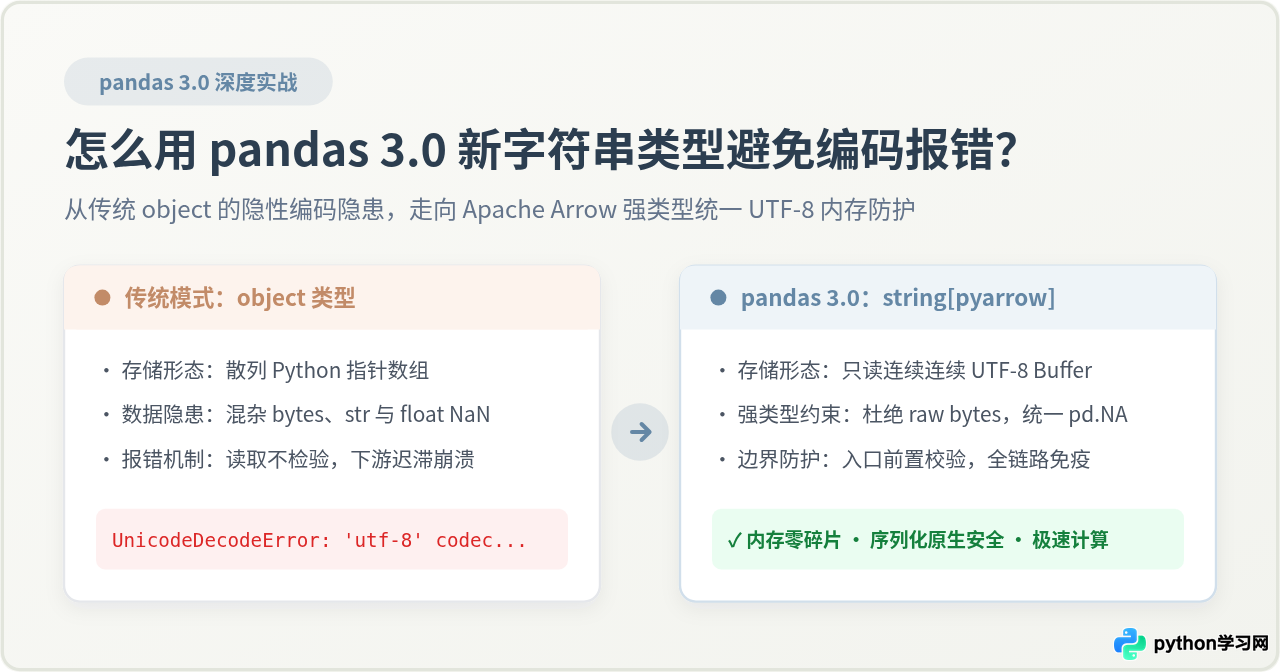
UnicodeDecodeError 和 UnicodeEncodeError)的核心方法,是将过去默认的 Python object 类型全面切换为基于 Apache PyArrow 的新型 string 类型(string[pyarrow])。PyArrow 在底层采用标准 UTF-8 连续内存缓冲区存储字符,并建立了严格的入口类型约束,从源头上阻止了多类型混杂以及原始未解码字节串(bytes)混入列中,从而使整个分析与导出链路具备完全确定的编码安全保障。
为什么过去用 object 类型容易引发编码报错?
在 pandas 2.0 之前以及未启用新字符串特性的环境中,当用户读取包含中文的 CSV、Excel 或数据库时,文本列会被自动赋予 object 数据类型。理解这一设计的本质,是理解所有编码报错的第一步。
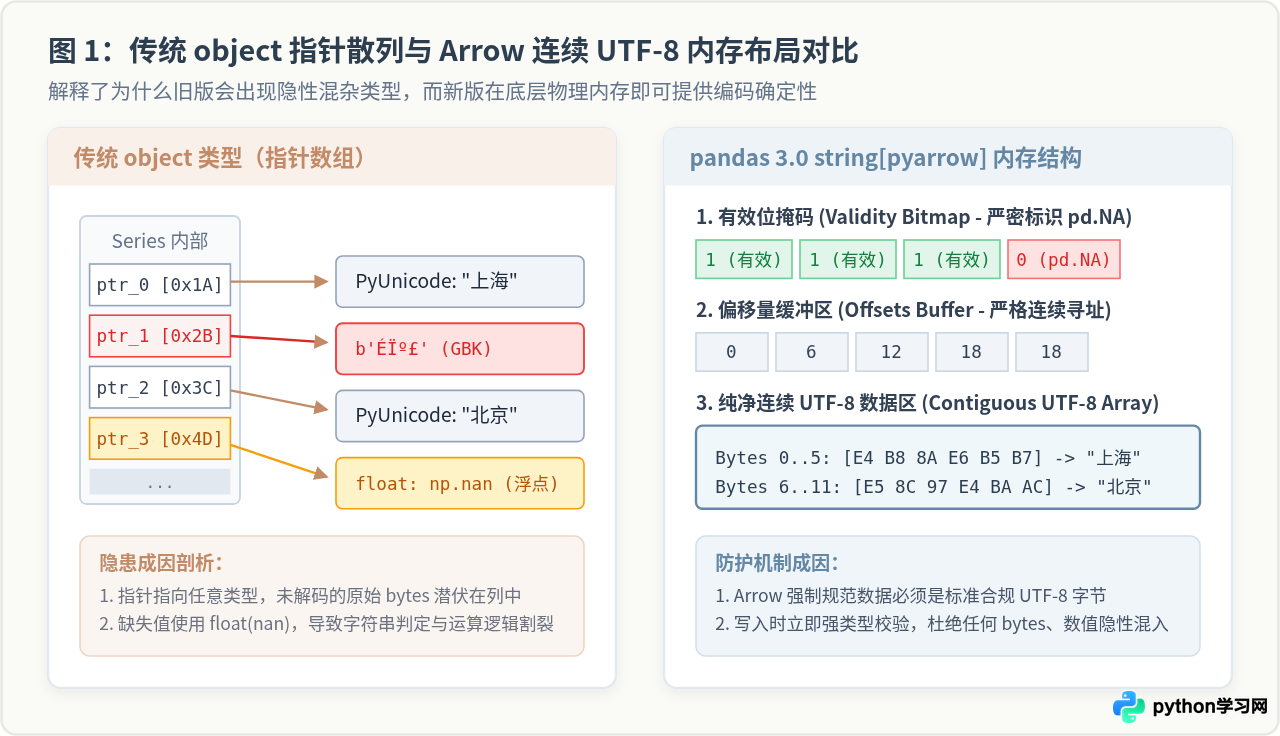
从底层物理结构来看,object 类型的 Series 并不是真正的字符串数组,而是一个由 64 位指针(PyObject*)组成的普通数组。数组中的每一个元素,都独立指向 Python 堆内存中的某个对象。这意味着:
- 允许任何对象混杂并存:在同一列中,部分单元格可能解析为正常的 Python
str(Unicode 文本),某些未能成功解码的生僻字段可能被读取逻辑降级为原始的bytes(字节串),甚至夹杂着浮点型的float('nan')或纯整型。 - 编码校验的“迟滞性”:当使用
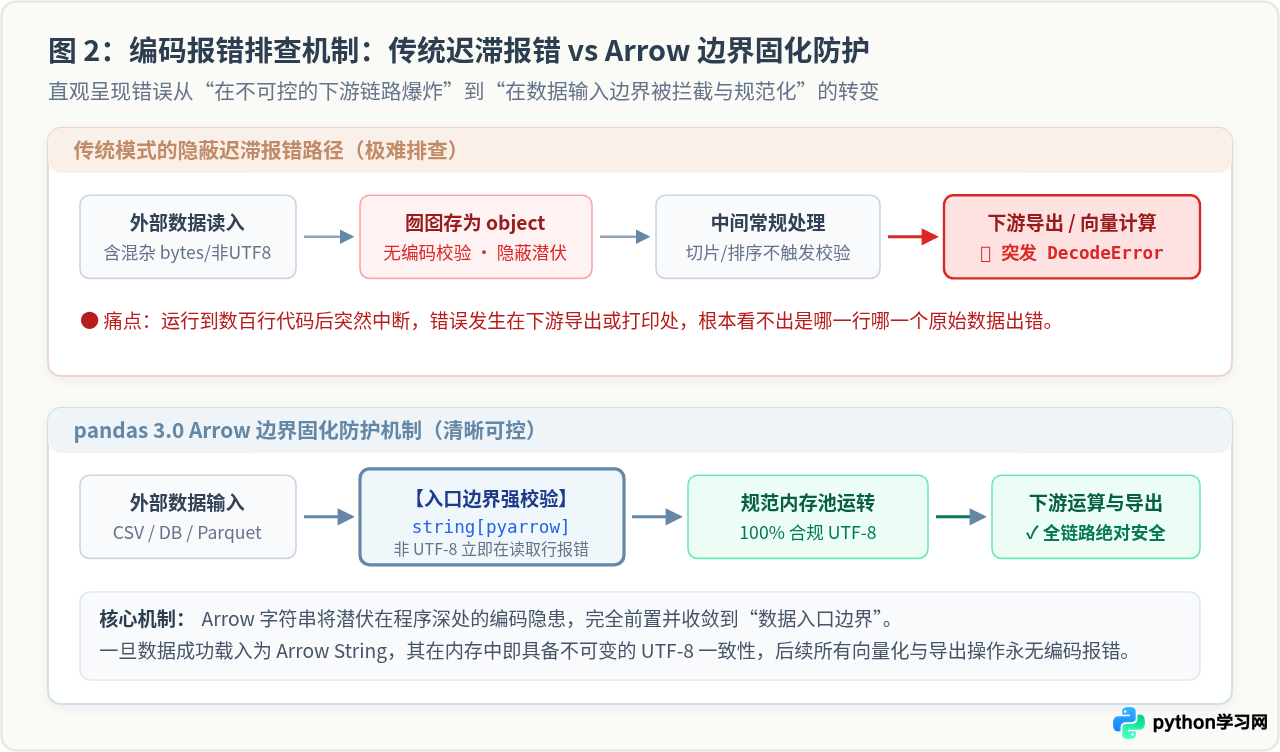
pd.read_csv()读取源数据时,object类型并不对指针指向的内容做统一的编码校验。数据即使夹带了非标准编码的字节串,也能顺利完成读入。这给开发者造成了“数据已经成功加载”的错觉。 - 下游操作的不可预知崩溃:真正的灾难往往发生在数十步操作之后。当对该列调用向量化文本切片
df['col'].str[:5]、将数据写入 Parquet 文件,或者调用第三方 C 扩展导出为 JSON 时,底层引擎尝试按统一规则解析字符,一旦遍历到藏匿其中的bytes对象或非 UTF-8 序列,程序就会瞬间抛出UnicodeDecodeError: 'utf-8' codec can't decode byte...并彻底中断。此时排查源头通常极其痛苦。
pandas 3.0 的新字符串类型如何化解编码隐患?
针对 object 类型带来的内存膨胀与类型不安全问题,pandas 团队在 2.x 版本开始引入并在 3.0 中将其确立为核心基础设施:全面由 Apache PyArrow 提供字符串后端支持。
与 Python 原始堆对象不同,PyArrow 的字符串数组(string[pyarrow])由三个严格规范的物理内存缓冲区组成:
- 有效位掩码(Validity Bitmap):使用严密的二进制位标记每个位置是否有效,彻底把缺失值统一收敛为
pd.NA,告别以往浮点型np.nan混入字符串列造成的类型异化。 - 偏移量数组(Offsets Buffer):按顺序记录每个字符串在连续内存区中的起始与终止字节位置,提供高效率的连续寻址。
- 连续 UTF-8 数据区(Values Buffer):这是杜绝编码报错的关键所在。PyArrow 规范强制要求该区域内所有字符必须是百分之百合法且合规的 UTF-8 字节流。
这套架构从根本上颠覆了编码错误的排查逻辑:它将原本可能潜伏在程序任意角落的隐性编码异常,完全前置并收敛到“数据输入与类型转换”的第一道边界。任何非标准的字节串或混合类型,在进入该列的第一时间就会被拦截或规范化,绝不可能浑水摸鱼混入 DataFrame。一旦数据进入内存,下游的所有向量化清洗、过滤、聚合以及写出到 Parquet/Feather 文件的操作,都将在零拷贝与零编码隐患的前提下极速运行。
实际操作步骤:三步迁移到新字符串类型
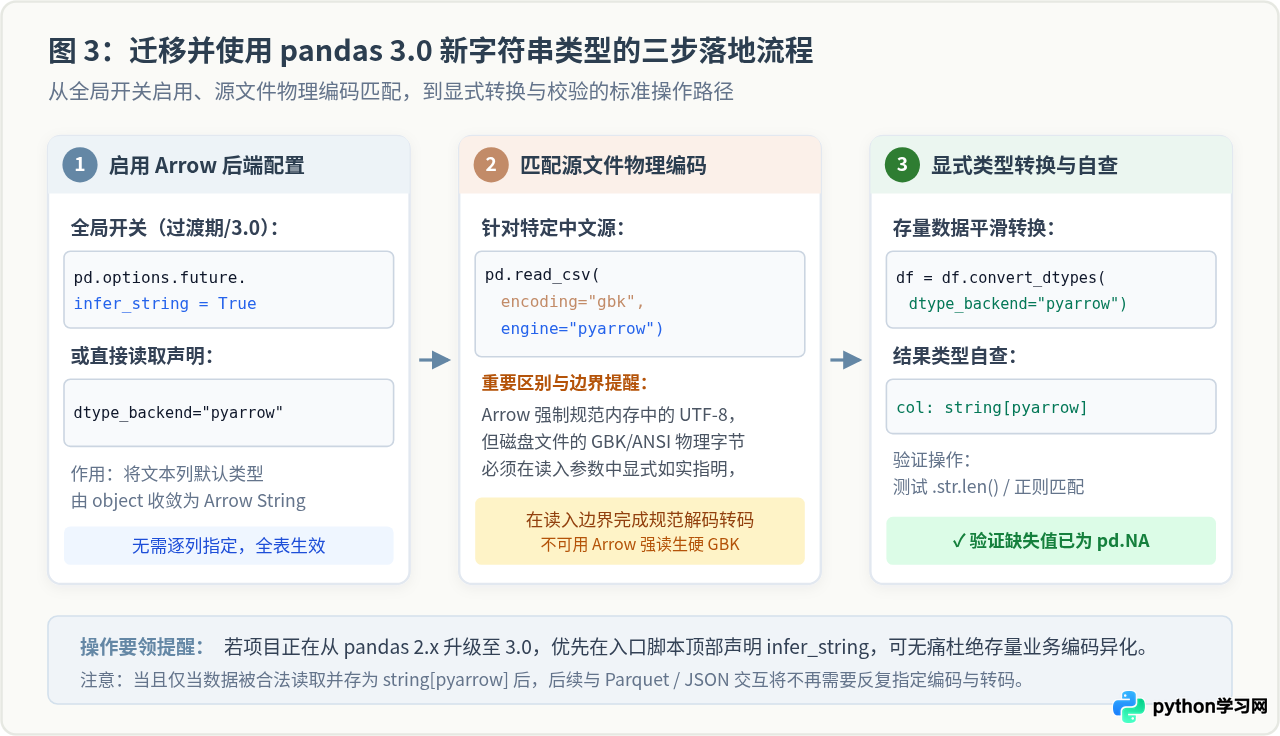
在实际数据处理项目中,要通过 pandas 3.0 的新字符串类型彻底避免编码报错,只需遵循以下三个标准化步骤。
步骤一:全局配置开启 Arrow 字符串推断
在编写数据处理脚本或数据管道的最开头,可以通过设置全局选项,命令 pandas 在读取或创建数据时,自动将所有文本推断为 Arrow 字符串,而不再创建老旧的 object 列:
import pandas as pd

# 全局开启新字符串推断(pandas 2.x 可过渡使用,pandas 3.0 默认策略)
pd.options.future.infer_string = True
若希望在单个文件读取任务中显式声明,可在 read_csv 等函数中直接传入 dtype_backend="pyarrow":
# 显式使用 PyArrow 作为数据类型后端
df = pd.read_csv("user_feedback.csv", dtype_backend="pyarrow")
print(df.dtypes)user_name string[pyarrow]
comment_content string[pyarrow]
dtype: object
使用 string[pyarrow] 需要运行环境中安装了 pyarrow(建议版本 ≥ 14.0.0)。若未安装,执行 pip install pyarrow 即可就绪。
步骤二:正确处理源文件的物理编码
这是一个最容易让初学者产生误解的关键环节:“内部统一为 UTF-8”不等于“可以胡乱读取非 UTF-8 文件”。
如果原始数据文件是由国内旧版 Windows 软件生成的 GBK、GB2312 或 GB18030 编码文件,磁盘上的字节本身就是 GBK 编码。如果直接使用默认的 UTF-8 去强行解读,第一步就会在边界抛错。
正确的做法是:在读取的入口处,显式告诉 pandas 源文件的实际物理编码。pandas 与 PyArrow 会在读取的第一道关卡中,精确将 GBK 字节流解析并转码为符合 Arrow 规范的标准 UTF-8 内存数据:
# 面对历史 GBK 文件,指定 encoding 让引擎完成合规转码与封装
df = pd.read_csv(
    "legacy_sales_gbk.csv",
    encoding="gb18030",
    dtype_backend="pyarrow"
)

# 此时内存中的字符串列已是百分之百纯净的 string[pyarrow]
print(df['product_name'].str.slice(0, 4))步骤三:现有 DataFrame 的显式类型转换与校验
对于已经存在于内存中、或者由混合源拼接而成的 DataFrame,可以利用 convert_dtypes() 或显式 astype() 完成平滑升级:
# 将现有 DataFrame 中所有兼容列转换为 PyArrow 后端
df = df.convert_dtypes(dtype_backend="pyarrow")

# 或者单独对某一列进行显式强类型升级
df['city'] = df['city'].astype("string[pyarrow]")

# 验证当前列的状态与健康度
assert pd.api.types.is_string_dtype(df['city'])
print("当前字符串缺失值形态:", type(df.loc[df['city'].isna(), 'city'].iloc[0]))
可以看到,缺失值已被统一封装为 <NA>,再也不会发生以往因为某一行是 float('nan') 而导致 .str.startswith() 抛出类型异常的尴尬情况。
常见边界情况与避坑指南
在实际工程实践中,为了确保新字符串类型真正发挥防错威力,需要特别留意以下三个关键细节:
1. 遇到损坏或夹杂非法字节的文件时的容错处理
网络抓取或多源采集的数据中,有时混入了无法被任何编码正常解析的损坏乱码。默认情况下,严格的编码校验会直接抛出错误。若业务场景需要“尽可能保留有效文字,对损坏字节做替换”,可配合 encoding_errors 参数:
# 对损坏字节做占位替换,防止解析阶段中断,后续依然享受 Arrow 内存安全
df = pd.read_csv(
    "untrusted_web_data.csv",
    encoding="utf-8",
    encoding_errors="replace",
    dtype_backend="pyarrow"
)
2. 与传统纯 Python 接口的交互与兼容
如果需要将 pandas 处理完毕的字符串列传递给某些历史遗留的第三方库(例如某些仅支持原生 Python list[str] 的传统分词工具包),直接传递 Arrow Series 可能会引发类型不兼容提醒。此时只需在传递前显式调用转换为原生列表即可:
# 导出为原生 Python str 列表供老旧第三方库使用
native_str_list = df['comment_content'].tolist()
3. 下游持久化与数据导出策略
当数据清洗完毕后,如果需要输出文件,推荐优先导出为 Parquet 格式。因为 string[pyarrow] 与 Parquet 属于同一个数据生态,写入时执行真正的零拷贝序列化,且文件元数据中完整保留字符串类型声明:
# 首选:导出为 Parquet,天然具备编码与类型免疫能力
df.to_parquet("clean_data.parquet", index=False)

# 若必须导出为供 Excel 查阅的 CSV,建议使用 utf-8-sig 防止 Excel 识别乱码
df.to_csv("report_for_excel.csv", encoding="utf-8-sig", index=False)
总结与快速自查表
解决 pandas 编码报错的根本思路,在于“拒绝用散乱的 object 指针管理文本,让合规的 Arrow 连续内存守住数据入口”。以下是日常开发中的快速参考矩阵:
| 考量维度 | 传统模式(object) | pandas 3.0 推荐(string[pyarrow]) |
|---|---|---|
| 内存存储机制 | 散列 Python 堆指针,高内存开销 | 连续 UTF-8 字节缓冲区,内存占用缩减 50%~70% |
| 编码检查时机 | 读取时不校验,在下游处理/导出时突然报错 | 读取入口强制校验,进入内存即 100% 合规 UTF-8 |
| 缺失值处理 | 混杂 np.nan (float) 与 None |
统一为强类型 pd.NA,不改变列类型 |
| 向量化文本算力 | Python 虚拟机逐行解包执行,速度慢 | C++ / SIMD 缓冲区向量运算,性能提升 2~10 倍 |
| 落地建议配置 | 不推荐继续在新项目中使用 | 脚本开头指定 pd.options.future.infer_string = True |
按照上述三步操作流程与自查矩阵配置,你的数据管道即可在面对海量复杂中文文本时,彻底告别随机崩溃的编码报错,获得稳定可靠的生产级表现。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















