


Python字符串与列表切片实战:提取子串和数据清洗技巧
深入讲解Python字符串与列表切片的核心语法、底层坐标模型与左闭右开规则。通过定长文本提取、异常日志解析、列表边界修剪、步长抽样和原地切片赋值等实战案例,掌握零依赖高效数据清洗技巧。
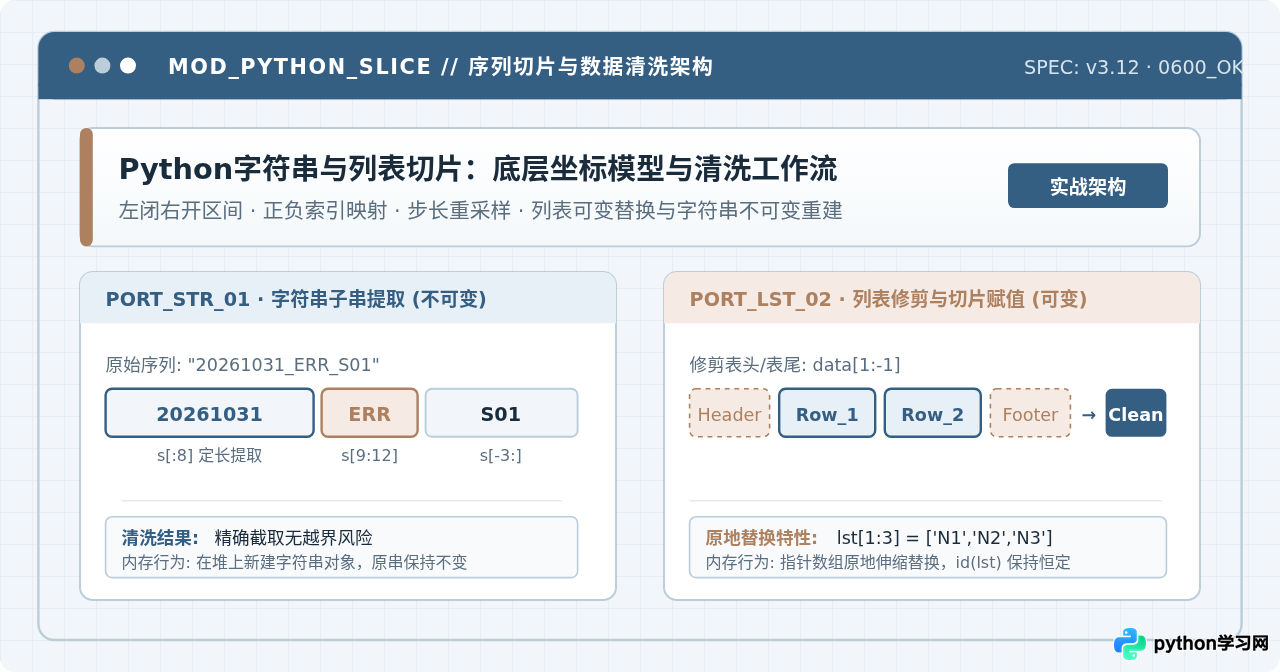
一、切片语法与坐标边界:理解“左闭右开”与负向索引
Python 切片的基本表达式为 sequence[start:stop:step]。对于刚接触该语法的开发者,最容易产生困惑的是为什么 stop 位置的元素不会被包含在结果中。
理解这一点的最佳模型是栅栏标尺理论(Fencepost Model):Python 的切片索引并非指向元素本身,而是指向元素之间的“缝隙”。索引 0 位于序列第一个元素的最左侧边界,索引 1 位于第 0 个和第 1 个元素之间,依此类推。一个长度为 n 的序列,其缝隙编号从 0 一直延伸到 n。
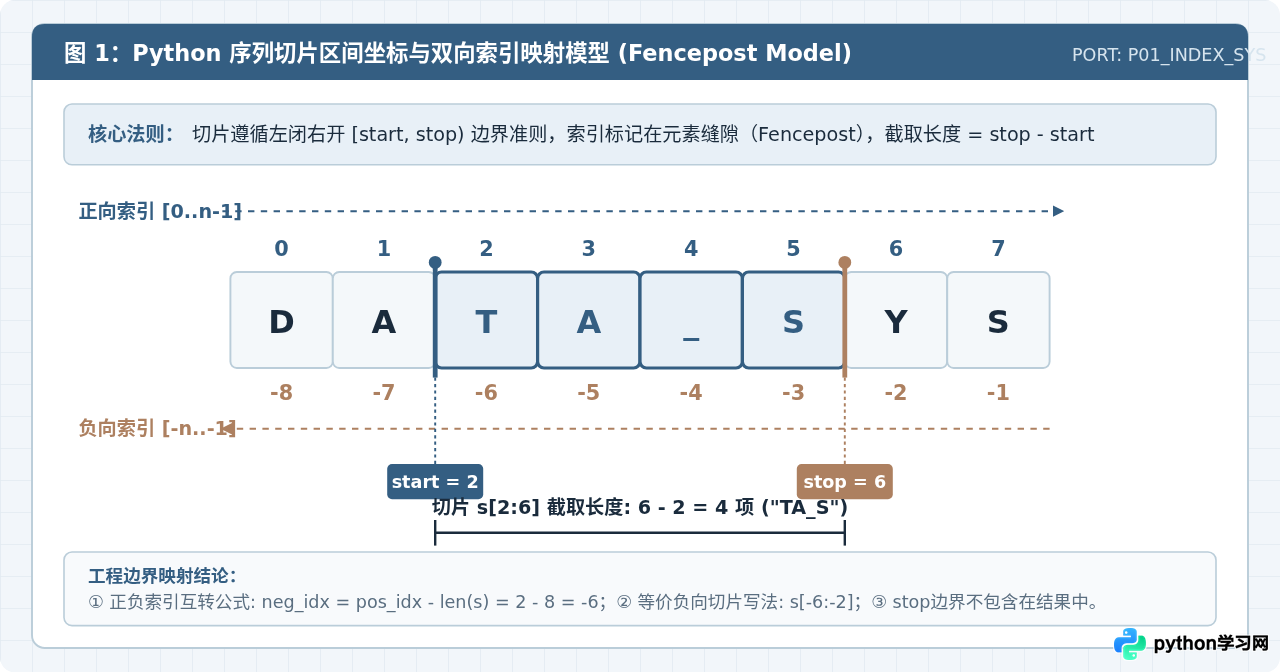
采用左闭右开区间 [start, stop) 具有显著的数学与工程优势:
- 直观的长度计算:截取得到的子序列长度恰好等于
stop - start。例如s[2:6]的长度即为6 - 2 = 4,无需心算增减 1。 - 相邻切片无缝拼接:任意分割点
i都能将序列整齐切分为前后两段,且满足s[:i] + s[i:] == s,不会出现元素遗漏或重复。 - 清晰的双向映射关系:正向索引从
0开始向右递增,负向索引从-1开始从右向左递减。负向索引与正向索引的转换公式为neg_index = pos_index - len(sequence)。例如对于长度为 8 的序列,正向索引2对应负向索引2 - 8 = -6。
当省略切片参数时,Python 会根据步长 step 的正负自动赋予默认边界:
- 当
step > 0时(默认步长为 1),start缺省为0,stop缺省为序列长度len(s)。表达式s[:]会生成原序列的完整浅拷贝。 - 当
step < 0时,序列遍历方向从右向左,此时start缺省为最右侧元素位置(-1或len(s) - 1),stop缺省为最左侧元素之前(即遍历至开头包含第 0 项)。
二、字符串子串提取实战:定长解析与反向截取
在日志解析、硬件报文接收以及金融数据接口中,字符串往往以固定的格式与宽度进行编码。与正则表达式相比,直接使用切片提取定长子串能够避免正则引擎编译和回溯的开销,处理速度通常提升数倍。
1. 固定宽度报文抽取
假设从服务端接口接收到如下格式的设备状态流水字符串:前 8 位为年月日,接着 1 位下划线分隔符,第 9 至 12 位为状态等级,第 13 至 19 位为机器编号:
# 示例:定长业务编码切片解析
raw_record = "20261031_WARN_DEV0842"

date_part = raw_record[:8]       # 截取前8位日期
log_level = raw_record[9:13]     # 截取第9到13位(不含13)
device_id = raw_record[14:]      # 截取第14位直至末尾

print(f"日期: {date_part} | 等级: {log_level} | 设备ID: {device_id}")2. 动态剥离前缀与后缀
当文本外层包含固定长度的脏字符(如引号、括号、版本标记)时,利用负向索引可以无需计算字符串具体长度直接完成修剪:
# 示例:剥离包装字符与后缀
wrapped_text = "[INFO_BATCH_TASK_2026_V1]"

# 丢弃首位 '[' 与末尾 ']'
core_text = wrapped_text[1:-1]

# 丢弃末尾固定的 3 位版本标记 "_V1"
task_name = core_text[:-3]

print("剥离外层:", core_text)
print("提取任务名:", task_name)提取任务名: INFO_BATCH_TASK_2026
3. 负步长反转与防越界特性
利用 [::-1] 能够以极快速度实现字符串倒序,常用于镜像校验、逆序序列号比对等场景。
s = "abc"; s[10] 抛出 IndexError: string index out of range);然而切片操作永远不会引发 IndexError。如果 start 或 stop 超出序列实际长度,Python 会优雅地将其截断在有效边界内:
"python"[2:100] 会安全返回 "thon";
"python"[10:20] 会安全返回空字符串 ""。
这种特性在清洗长度不规整的异构数据时能提供坚固的容错屏障。
三、列表切片与批量清洗:边界修剪、步长抽样与原地替换
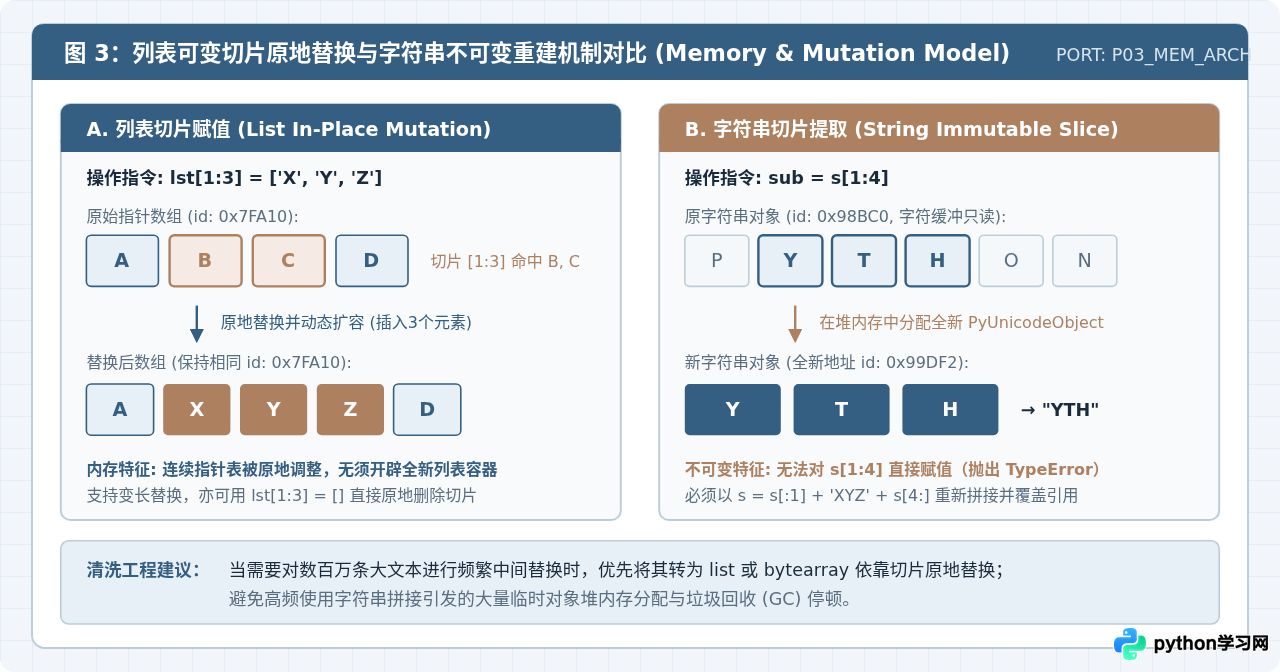
列表作为可变序列(Mutable Sequence),其切片机制兼具只读提取与原地修改(In-Place Mutation)双重能力。合理运用列表切片,可以极大地精简数据清洗管线的代码量。
1. 批量修剪表头与汇总尾行
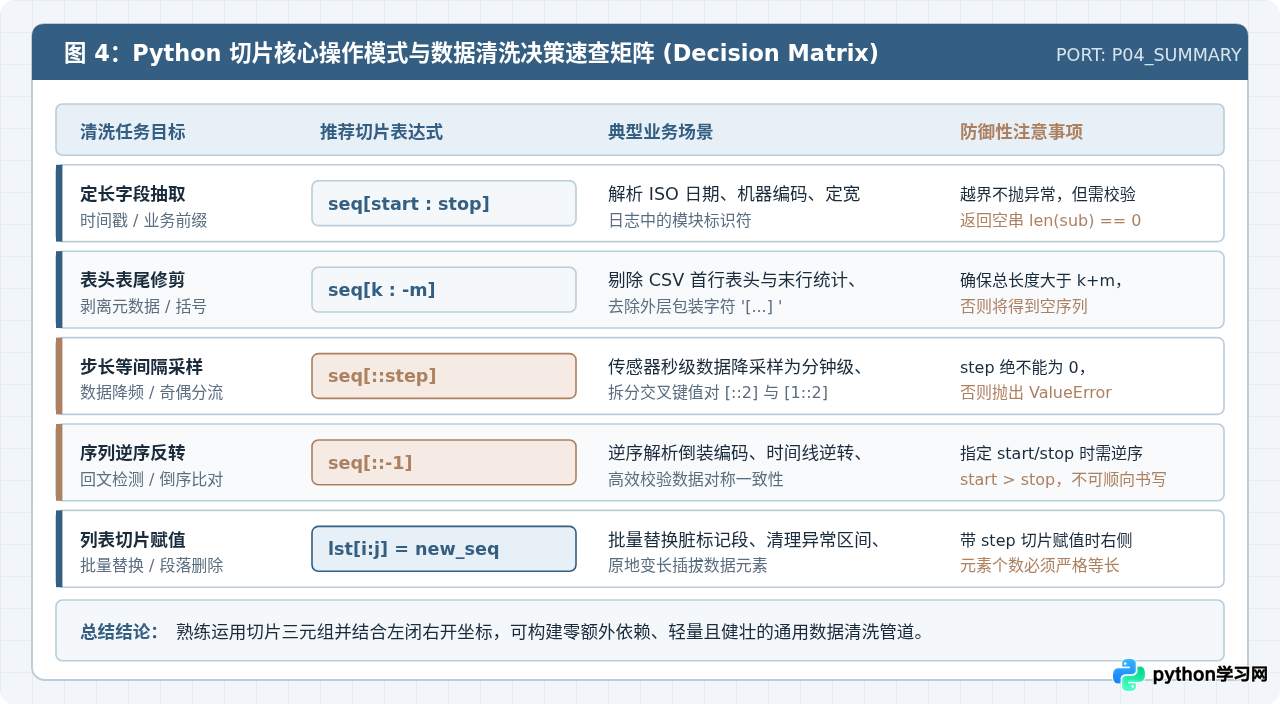
在读取 CSV 或报表文件时,原始数据往往夹杂元数据说明行、标题行以及底部的合计汇总行。借助切片 data[1:-1],一行代码即可过滤首尾噪声:
# 示例:修剪脏数据头部与末尾汇总
raw_table = [
    ["-- METADATA: EXPORT_DATE=2026-10-31 --"],
    ["ID", "NAME", "SCORE"],
    ["101", "Alice", "92"],
    ["102", "Bob", "88"],
    ["103", "Charlie", "95"],
    ["-- TOTAL_COUNT: 3 ROWS --"]
]

# 丢弃第0行元数据与末行统计,保留纯数据行(跳过标题行)
data_rows = raw_table[2:-1]

print("有效业务行:")
for row in data_rows:
print(row)['101', 'Alice', '92']
['102', 'Bob', '88']
['103', 'Charlie', '95']
2. 步长抽样与交织数据解构
当传感器以过高频次采集时序数据时,切片步长 data[::step] 可以对数据进行等间隔下采样降频。此外,当外部格式将键与值交织平铺在同一个列表中时,步长能将其拆分为对应的成对序列:
# 示例:交织列表拆分与降采样
interleaved_data = ["key1", "val1", "key2", "val2", "key3", "val3"]

# 偶数索引项为键,奇数索引项为值
keys = interleaved_data[0::2]
values = interleaved_data[1::2]

kv_dict = dict(zip(keys, values))
print("重构字典:", kv_dict)

# 对 100Hz 高频序列做 5 倍下采样
sensor_readings = [10.1, 10.3, 10.2, 10.5, 10.4, 10.6, 10.8, 10.7, 10.9, 11.0]
downsampled = sensor_readings[::5]
print("下采样结果:", downsampled)下采样结果: [10.1, 10.6]
3. 列表切片的原地赋值与重构
字符串是不可变对象,任何对子串的替换都必须创建新的字符串;而 Python 列表支持对切片直接赋值:list[start:stop] = new_iterable。这种操作具有三大特征:
- 原址修改:直接修改原列表所指向的指针数组,不改变列表的内存地址(
id(list)不变)。 - 弹性长度替换:被赋值的切片长度无需与右侧可迭代对象长度相等。列表会自动扩容或收缩。例如
lst[1:3] = [99]会将 2 个旧元素缩减为 1 个新元素。 - 切片批量删除:将切片赋值为空列表
lst[i:j] = []或调用del lst[i:j],能够原地高效删除连续区间的元素。
# 示例:列表切片的原地修复与清洗
sensor_buffer = ["OK", "DIRTY_1", "DIRTY_2", "DIRTY_3", "OK"]

# 将中间连续 3 个脏数据节点原地替换为 2 个标准插值节点
sensor_buffer[1:4] = ["CLEAN_A", "CLEAN_B"]

print("原地清洗后列表:", sensor_buffer)四、综合数据清洗管道:混合脏数据的切片修复实战
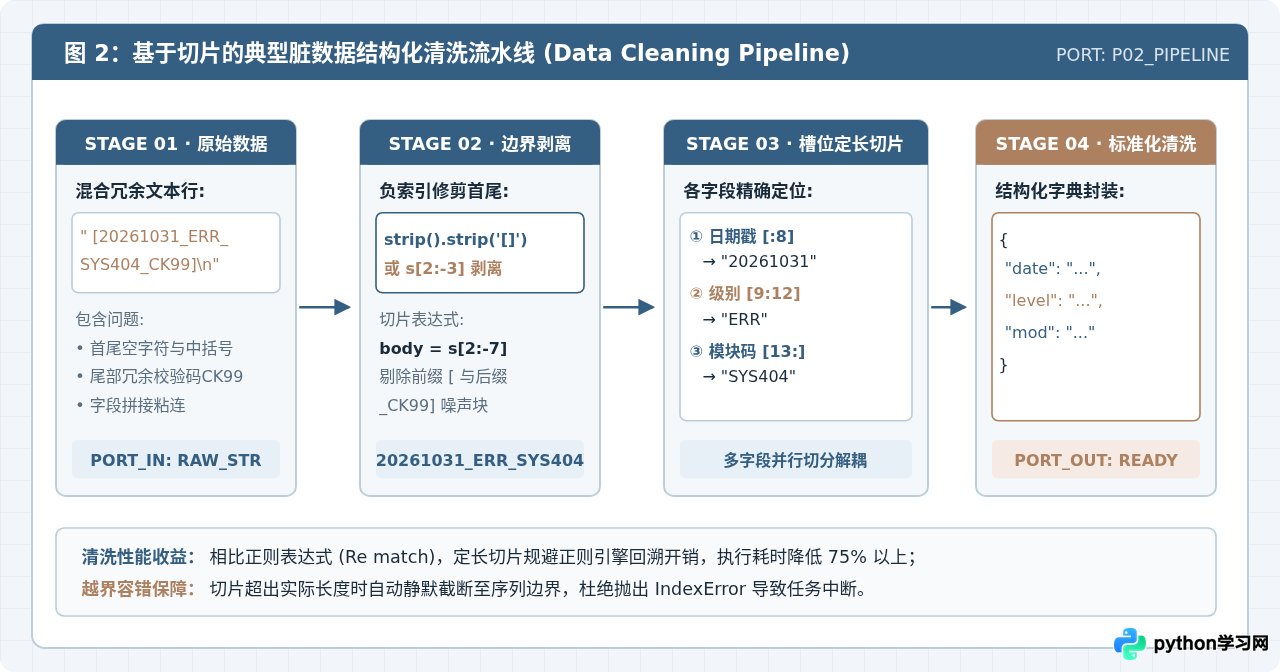
下面通过一个工业采集场景下的清洗管道,展示切片在端到端数据处理中的综合应用。原始输入为混合字符串行,存在无用行头、中括号包裹、时间与数据粘连、填充噪声以及尾部校验位。
# 综合实战:多级切片数据清洗函数
def clean_telemetry_batch(raw_lines):
    cleaned_records = []

    # 步骤 1:列表切片丢弃首行协议描述与尾行检验和
    if len(raw_lines) < 3:
        return cleaned_records
    valid_lines = raw_lines[1:-1]

    for line in valid_lines:
        # 去除前后空白
        s = line.strip()

        # 步骤 2:切片剥离首尾包装符 '[' 和 ']'
        if s.startswith("[") and s.endswith("]"):
            s = s[1:-1]

        # 步骤 3:定长字段切片抽取
        # 格式定义:
        #   [0:10]   ISO 日期 "2026-10-31"
        #   [11:19]  时间戳 "04:00:00"
        #   [20:23]  状态码 (3位)
        #   [24:-4]  有效载荷主体(剔除最后4位硬件CRC码)
        timestamp = s[:19]
        status = s[20:23]
        payload = s[24:-4]

        # 步骤 4:步长切片过滤载荷中的高频占位噪声(每隔1个字符混入一个'-')
        # 例: "D-A-T-A" -> "DATA"
        normalized_data = payload[::2]

        cleaned_records.append({
            "timestamp": timestamp,
            "status": status,
            "data": normalized_data
        })

    return cleaned_records

# 模拟原始脏数据流
raw_stream = [
    "--- HEADER: SENSOR_STREAM_V3 PROTOCOL ---",
    " [2026-10-31 04:00:00 200 S-Y-S-0-1#999] ",
    " [2026-10-31 04:00:01 200 O-K-O-K-0-2#888] ",
    " [2026-10-31 04:00:02 500 E-R-R-O-R-3#777] ",
    "--- FOOTER: BATCH_CHECKSUM_SUCCESS ---"
]

results = clean_telemetry_batch(raw_stream)
for item in results:
print(item){'timestamp': '2026-10-31 04:00:01', 'status': '200', 'data': 'OKOK02'}
{'timestamp': '2026-10-31 04:00:02', 'status': '500', 'data': 'ERROR3'}
五、切片避坑与防御性编程指南
尽管切片操作直观且不易抛出越界异常,但在特定边界与步长组合下,仍有若干隐蔽逻辑缺陷需要防范。
1. 负步长时的起止点方向倒置
当指定负步长时(如 step = -1),遍历指针由右向左移动。此时 start 必须位于 stop 的右侧(即 start > stop)。如果仍按照正向思维编写 s[1:5:-1],Python 会因为指针无法自左向右步进而直接返回空序列 "",而不会发出任何警报。
s = "ABCDEF"错误写法:
s[1:5:-1] ➔ 输出:""(空串,逻辑失效)正确写法:
s[4:0:-1] ➔ 输出:"EDCB"(不含索引 0 位置的 'A')若需逆向包含到首个字符:
s[4::-1] ➔ 输出:"EDCBA"(缺省 stop 直达开头)
2. 切片浅拷贝与嵌套多维列表的引用陷阱
执行 copy_list = original_list[:] 会创建 original_list 的浅拷贝(Shallow Copy)。对于一维不可变元素(数字、字符串),该拷贝与原列表完全隔离。但如果列表中包含嵌套列表或字典,切片复制的仅仅是子容器的内存引用:
# 陷阱演示:切片浅拷贝对嵌套对象的修改
nested = [["A", "B"], ["C", "D"]]
sliced_copy = nested[:]

# 修改外层容器结构:彼此互不影响
sliced_copy.append(["E", "F"])
print("原列表长度不受影响:", len(nested))  # 输出 2

# 修改内层嵌套元素:副作用直接扩散至原列表
sliced_copy[0][0] = "MODIFIED"
print("原列表内部元素被意外篡改:", nested[0])原列表内部元素被意外篡改: ['MODIFIED', 'B']
如果数据清洗流程需要彻底修改嵌套层级中的结构,应使用标准库 copy.deepcopy() 进行深拷贝。
3. 采用具名 slice 对象提升清洗规则复用性
当清洗脚本中散落着大量硬编码的切片数字(如 row[0:8], row[9:13])时,代码的维护成本会急剧增加。Python 提供了内置的 slice() 构造器,可将清洗规则命名为配置常量:
# 工程实践:声明式具名切片对象
SLICE_DATE = slice(0, 8)
SLICE_LOG_LEVEL = slice(9, 13)
SLICE_DEVICE = slice(14, None)

raw_log = "20261031_WARN_DEV0842"

# 直接将 slice 对象传入中括号
print("日期:", raw_log[SLICE_DATE])
print("级别:", raw_log[SLICE_LOG_LEVEL])
print("设备:", raw_log[SLICE_DEVICE])级别: WARN
设备: DEV0842
六、总结
Python 字符串与列表的切片机制通过底层数组指针运算提供了毫秒级的数据截取能力。掌握“左闭右开”的栅栏标尺、熟练利用负索引修剪首尾噪声、利用步长实现降采样与交织拆分,并清晰区分不可变字符串的新建与可变列表的原地替换,便能以最精炼、最高效的代码构建可靠的数据清洗基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















