


Python for循环遍历列表、字符串和元组的基础示例
详细讲解在Python中使用for循环遍历列表、字符串和元组的基础方法与实用技巧,包含代码示例、执行步骤、常见陷阱与四幅清晰的结构图示。
假设你正在处理一份包含学员名字的名单、一条接收到的验证码短信,或者一组只读的经纬度坐标,你需要逐一获取其中的每一个元素并进行处理。在Python中,for 循环正是完成这项任务的核心语法结构。本文将直接从底层遍历原理切入,通过清晰的代码示例,说明如何高效遍历列表、字符串和元组三种基础序列结构,并指出常见的编写误区。
一、for 循环与序列迭代的工作机制
与其他编程语言中依赖数字递增计数器(如 for (int i = 0; i < n; i++))不同,Python 的 for 循环本质上是一个迭代器遍历机制。它直接面向容器本身,每次从目标序列中依次取出一个元素,将其赋值给目标变量,直到所有元素耗尽自动停止。
这种设计避免了手动管理下标可能带来的越界错误,其通用语法表达如下:
for 变量名 in 可迭代对象:
    # 针对当前变量的执行逻辑
    pass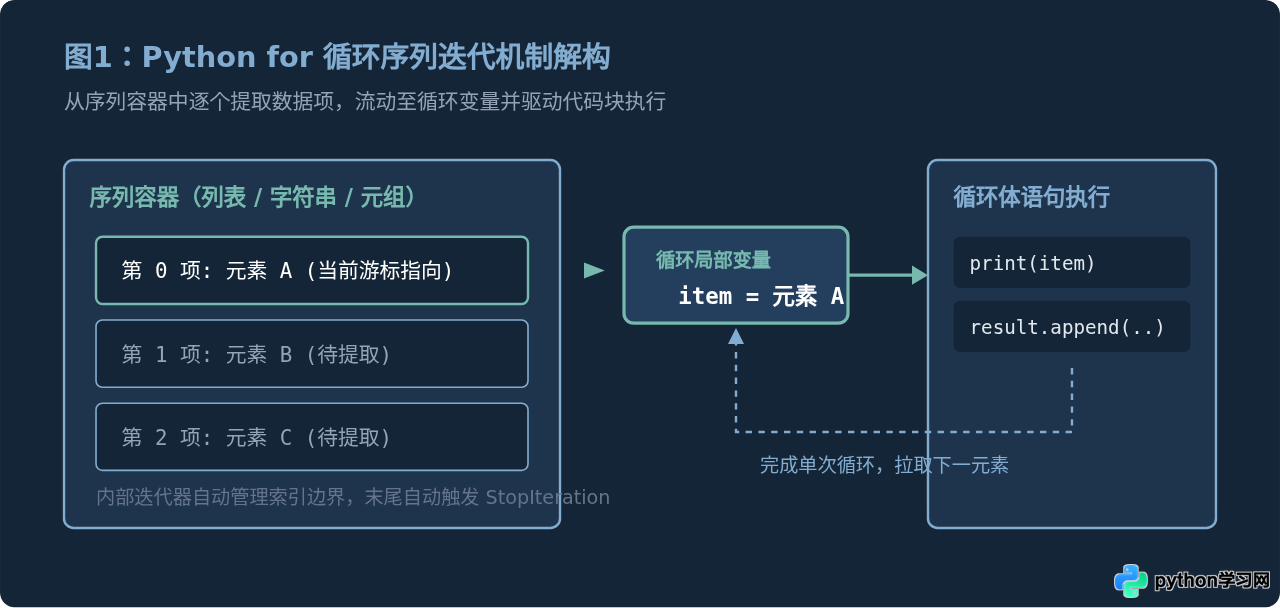
二、遍历列表(List)的基础示例
列表(List)是Python中使用最频繁的可变序列。遍历列表可以采用直接提取元素的方式,也可以在需要跟踪位置序号时结合内置函数进行增强。
1. 直接按值遍历列表
如果你只需要读取列表中的数据,直接使用 for 变量 in 列表 是最简练且符合 Python 惯用风格(Pythonic)的写法:
# 定义水果列表
fruits = ["苹果", "香蕉", "橙子", "西瓜"]

# 逐一读取并输出
for fruit in fruits:
print("今日推荐水果:", fruit)今日推荐水果: 香蕉
今日推荐水果: 橙子
今日推荐水果: 西瓜
2. 使用 enumerate() 同步获取索引与值
有时我们需要知道当前元素处于第几个位置(例如生成带序号的排行榜)。初学者常使用 range(len(fruits)),但更优雅、安全且高效的做法是使用 enumerate() 函数:
# 同时获取索引(从1开始计数)与元素内容
for index, fruit in enumerate(fruits, start=1):
print(f"序号 {index}: {fruit}")序号 2: 香蕉
序号 3: 橙子
序号 4: 西瓜
三、遍历字符串(String)的基础示例
在 Python 中,字符串本身就是一种有序且不可变的字符序列。当把字符串传递给 for 循环时,解释器会自动将其拆解为一个一个独立的字符(包括汉字、字母、标点与空格)。
1. 逐字符拆解与统计
下面示例演示如何逐字检查一段字符,并统计特定字符出现的次数:
# 待分析的字符串
message = "Python 3.12 is fast & stable!"

# 统计空格数量
space_count = 0

for char in message:
    if char == " ":
        space_count += 1
    else:
        # 直接输出每个字符及其Unicode编码
        pass

print("文本总长度:", len(message))
print("包含空格数:", space_count)包含空格数: 4
2. 字符清洗与过滤输出
遍历字符串通常用于过滤非目标字符。例如,从一段夹杂英文字符与数字的文本中提取纯数字:
raw_id = "USER-8904-AUTH"
digits = []

for char in raw_id:
    if char.isdigit():
        digits.append(char)

clean_id = "".join(digits)
print("提取出的纯数字代码:", clean_id)四、遍历元组(Tuple)的基础示例
元组(Tuple)与列表类似,但具有不可变性(只读性)。在多任务场景中,元组常用于承载结构固定的一组属性(如坐标、用户基础信息、数据库记录行)。
1. 基础单值遍历
对常规单层元组的遍历与列表完全一致:
# 系统的固定端口配置
server_ports = (80, 443, 8080, 8443)

for port in server_ports:
print(f"检测安全通道端口: {port}")检测安全通道端口: 443
检测安全通道端口: 8080
检测安全通道端口: 8443
2. 嵌套元组的就地解包(Unpacking)遍历
这是元组遍历最具威力的用法。当容器内的每个元素本身都是包含若干项的元组时,for 后面可以直接声明多个变量就地接收拆解数据:
# 经纬度航点列表(名称, 纬度, 经度)
waypoints = [
    ("北京站", 39.9042, 116.4272),
    ("上海虹桥", 31.1940, 121.3200),
    ("广州南站", 22.9880, 113.2730)
]

# 在循环定义中直接解包三个字段
for name, lat, lon in waypoints:
print(f"站点: {name:<6} | 纬度: {lat:.4f} | 经度: {lon:.4f}")站点: 上海虹桥 | 纬度: 31.1940 | 经度: 121.3200
站点: 广州南站 | 纬度: 22.9880 | 经度: 113.2730
五、列表、字符串与元组在遍历中的特性对比
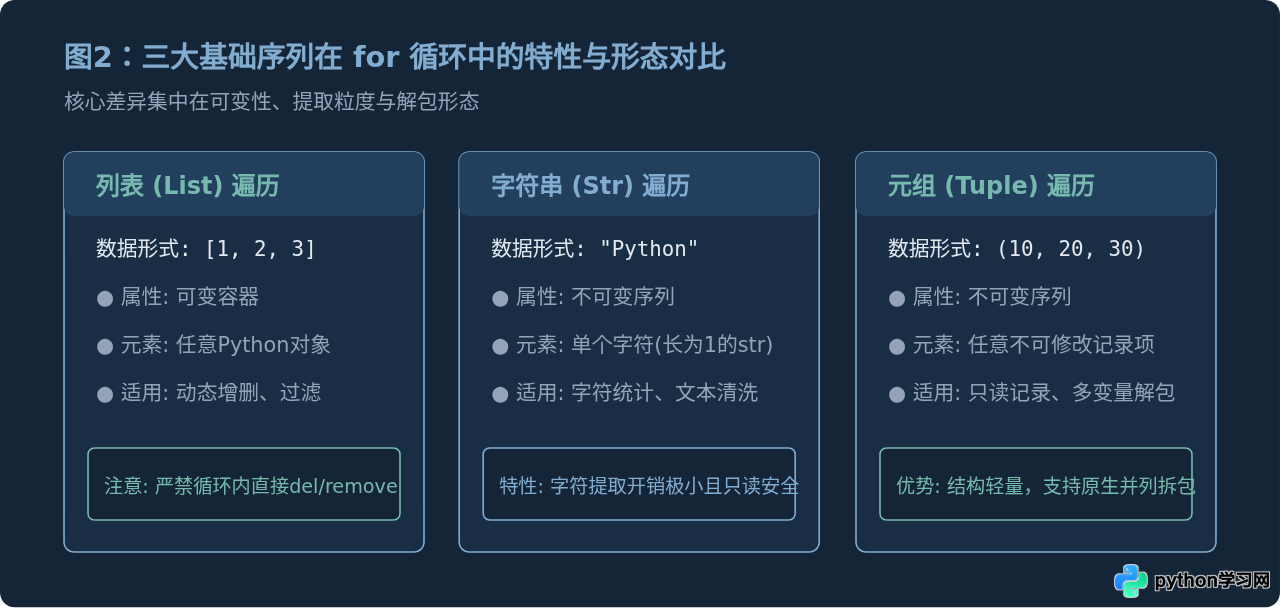
为了让选择更加清晰,我们需要对比这三者在遍历时的关键行为与差异:
| 序列类型 | 容器可变性 | 单次循环提取的内容 | 典型遍历应用场景 |
|---|---|---|---|
| 列表 (List) | 可变 (Mutable) | 原列表中的单个元素对象 | 需要遍历后收集产物、或者结合 enumerate() 定位序号 |
| 字符串 (str) | 不可变 (Immutable) | 单个字符(包含标点和空格) | 字符串合法性校验、特定符号统计、字符拼接过滤 |
| 元组 (Tuple) | 不可变 (Immutable) | 固定数据字段或多维组合键 | 保护配置项不被污染、在循环头中直接多变量解包 (Unpacking) |
六、编写遍历代码的推导与实现流程
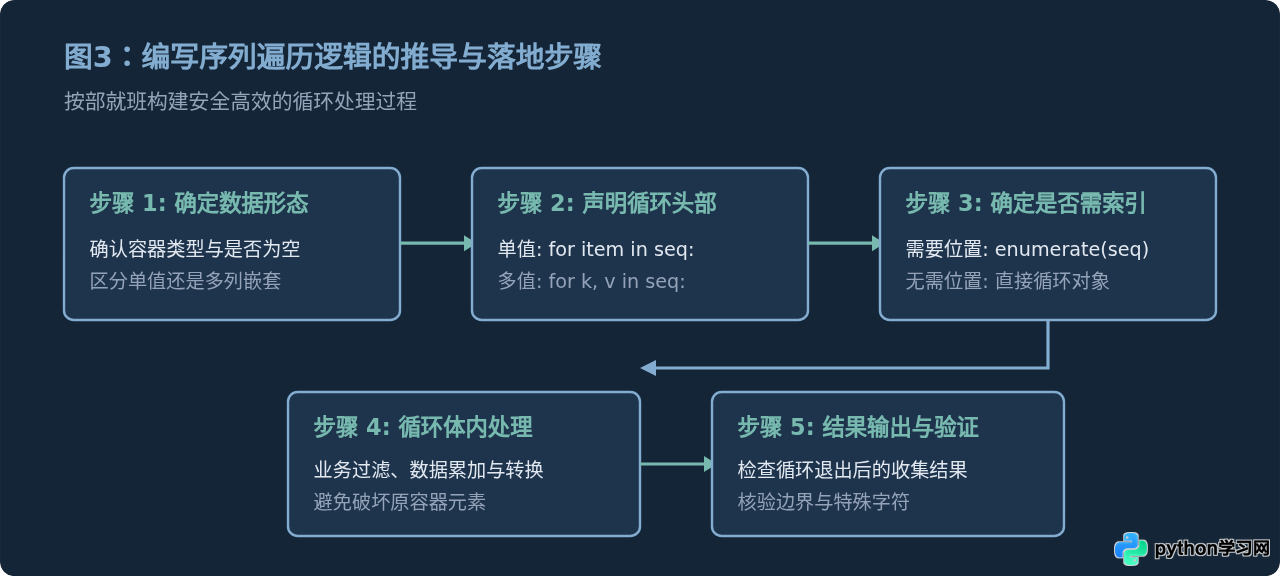
在实际编码中,实现一个稳健的 for 循环建议遵循标准化的推导步骤,确保边界条件得到充分处理:
七、遍历中的常见陷阱与避坑指南
掌握了基本语法后,初学者在编写过程中最容易遭遇以下两个逻辑陷阱:
陷阱 1:一边遍历列表,一边调用 remove() 或 pop()
高危错误操作:在 for item in my_list: 内部直接使用 my_list.remove(item)。因为底层指针按索引自增,删除元素后列表后面的项会自动向前补位,导致紧邻的下一个元素被直接跳过,产生静默漏网数据。
错误示范与修复方案:
# 错误方式:会导致奇数漏删
nums = [1, 3, 4, 5, 6]
# for n in nums:
#     if n % 2 != 0:
#         nums.remove(n)  # 致命陷阱!元素前移导致部分元素跳过

# 正确方式 1:使用列表推导式构建新列表
nums = [1, 3, 4, 5, 6]
even_nums = [n for n in nums if n % 2 == 0]
print("过滤后的偶数列表:", even_nums)

# 正确方式 2:如果必须就地修改原列表,可遍历切片副本 nums[:]
nums_copy = [1, 3, 4, 5, 6]
for n in nums_copy[:]:
    if n % 2 != 0:
        nums_copy.remove(n)
print("通过副本遍历就地删除后的列表:", nums_copy)通过副本遍历就地删除后的列表: [4, 6]
陷阱 2:非必要的下标遍历
在很多来自 C/Java 背景的初学代码中,经常出现 for i in range(len(seq)): print(seq[i]) 的写法。在 Python 中,除非你确实需要根据索引同时修改原列表指定槽位的内容,否则直接遍历元素或使用 enumerate() 的运行效率与可读性都明显更优。
八、全篇核心知识总结
通过本文的学习,我们可以将列表、字符串和元组遍历的核心模式总结为一张决策与要点图:
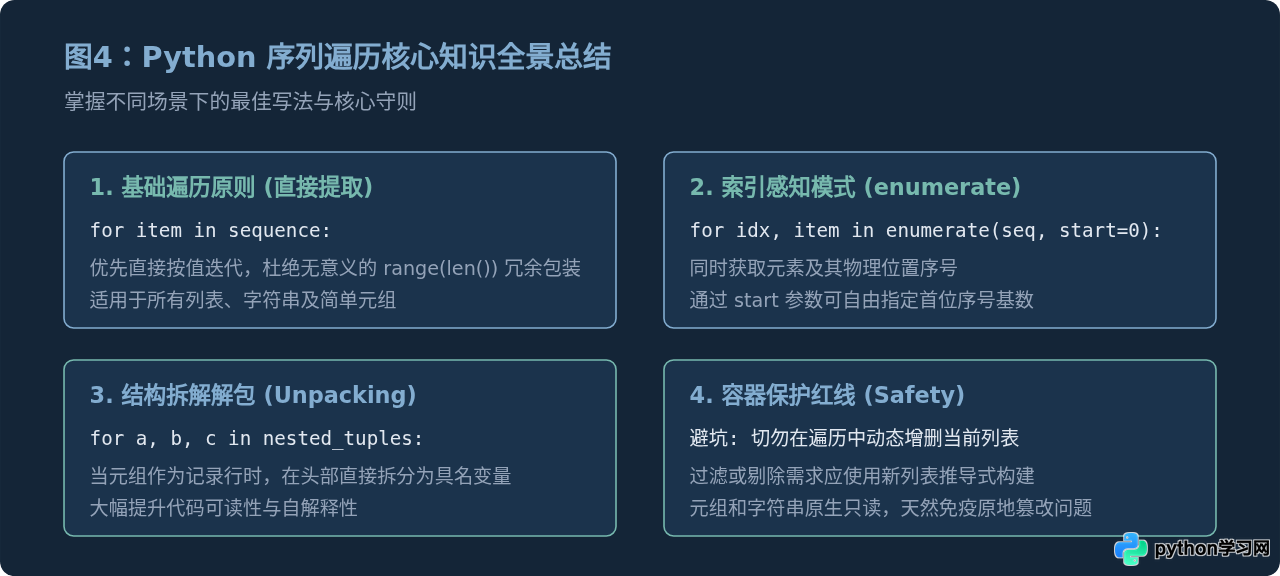
综上所述,Python 的 for 循环为列表、字符串和元组提供了统一且一致的遍历接口。在日常开发中,牢记“优先按值直接提取、需位置用 enumerate、多值嵌套用解包、避免就地改列表”这四大准则,就能编写出既地道高效又稳健无误的代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















