


Python调用Claude API如何记录request-id并控制重试
成功读取_request_id,HTTP异常读取状态、request_id与retry-after。本文用完整SDK示例说明单次调用、默认重试与流式和工具任务的完成边界。
Python调用Claude API时,怎样记录request-id并避免重复重试?成功响应可读message._request_id,HTTP错误可从APIStatusError读取request_id、status_code和响应头;连接错误可能没有可用请求ID。官方SDK默认对暂时失败退避重试两次,应用已有统一重试层时,可用max_retries明确配置,避免两层循环叠加。请求失败与外部任务未执行也不是同一个结论。
先把一次调用记录与业务任务记录分开
API的request-id是定位一次请求的标识。错误JSON也通常含request_id及error对象,type与message说明类别和细节。模型、请求时间及其时区、请求ID、是否获得完整结果,共同帮助定位调用;它们不能代替文件写入或外部工具任务的完成回执。
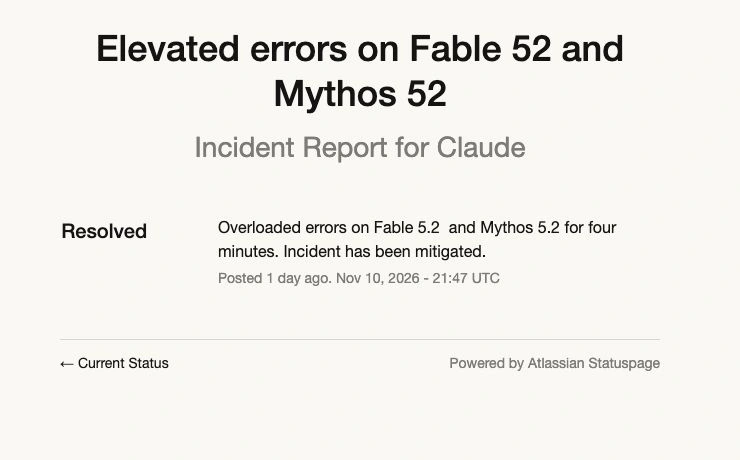
例如Fable 5.2与Mythos 5.2的事件pgz8r13pk4sm曾有约四分钟overloaded errors,已缓解并标Resolved。恢复说明发表于2026年11月10日21:47 UTC、北京时间11月11日05:47;公告没有精确故障窗口、请求比例、地区或根因,也未说明全部模型和网页都不可用。日志时间相近,不足以把所有失败归为同一事件。
用完整SDK代码记录成功与失败标识
以下示例要求Python已安装官方anthropic SDK,环境变量ANTHROPIC_API_KEY提供自己的密钥,CLAUDE_MODEL提供账户有权访问的真实模型ID。示例不硬编码模型别名或凭据,将SDK重试明确设为0,便于展示单次调用的异常边界:
import logging
import os
import anthropic

logging.basicConfig(level=logging.INFO)
client = anthropic.Anthropic(max_retries=0)
try:
    message = client.messages.create(
        model=os.environ["CLAUDE_MODEL"],
        max_tokens=128,
        messages=[{"role": "user", "content": "用一句话解释Python异常处理"}],
    )
    logging.info("请求完成 request_id=%s", message._request_id)
except anthropic.APIConnectionError:
    logging.exception("连接失败,结果可能尚不确定")
    raise
except anthropic.APIStatusError as error:
    logging.error(
        "HTTP=%s request_id=%s retry_after=%s",
        error.status_code,
        error.request_id,
        error.response.headers.get("retry-after"),
    )
    raise
成功分支记录请求ID,HTTP异常分支保留状态和重试提示,随后重新抛出异常供调用方处理;连接失败不会伪造请求ID。示例没有外层循环,也没有把异常转换成成功返回。日志不输出密钥、Authorization头或完整提示内容,具体模型回答不作为固定预期结果。
重试应由哪一层负责
官方SDK默认对连接错误、限流与5xx等暂时失败进行指数退避,默认两次,并在存在retry-after时遵循该响应头。max_retries可改变或关闭这一行为;上例的0只是显式关闭,不代表所有应用都必须禁用SDK重试。
若SDK已经重试,应用层每次失败又重新调用SDK,总尝试次数可能被放大。选择SDK或业务层作为主要重试入口时,需要同时考虑总次数、退避和任务完成状态,而不是在每一层都写相同循环。使用量突然增大还可能触发429,加速恢复积压不等于同时释放所有请求。
哪些错误不能靠等待统一解决
529 overloaded_error表示API暂时过载,429 rate_limit_error则可能来自组织速率、使用档位月度支出上限或Claude Code工作区额度。档位支出上限的429可能没有retry-after,并持续到访问条件恢复,不能将每个429都理解为等几秒即可恢复。
400一般与请求格式、内容及特定支出条件有关,401指向认证条件,403指向资源权限。临时过载不意味着密钥已失效;认证和权限错误也不因无限重试解决。实际error.type和message仍是重要判断依据,这些通用分类并非上述历史故障的逐请求统计。
流式响应为什么需要另一种完成判断
SSE可以在HTTP 200之后发生错误,因此初始状态不保证完整生成。只有应用拿到预期的最终结果,才适合把任务标为完成;已收到部分文本的流失败,不应直接当成完整答案继续传给下游。
长时间非流式连接可能因网络空闲而断开。流式Messages或Message Batches提供不同交付方式,选择取决于实时输出需求、处理时长和结果获取方式,不能据此反推四分钟过载的根因。网络中断也不证明关联工具动作没有发生;目标系统已有完成记录时,补做应依据实际状态决定。
恢复后仍要保留新的请求证据
历史事件Resolved只说明该事件已结束,不承诺每个后续请求都成功。新错误可能有独立的额度、网络或权限原因,新的请求ID也不应被混进旧故障统计。应用恢复涉及完整模型结果、重试层级和外部业务状态三层,而不是仅看状态页是否已变绿。
更换密钥或模型还受账户权限、业务能力和输出要求影响;上述公告没有保证替代模型相同表现,也没有确认重复执行或数据损坏。可靠记录应保留未知边界,避免把未收到完整响应误写成服务一定没有执行任何工作。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















