


Python正则表达式在数据清洗与格式验证中的应用
深入解析Python正则表达式在数据清洗与格式验证中的核心应用,涵盖re模块常用函数机制、结构化验证实战、半结构化清洗技巧及避免回溯陷阱的工程实践。
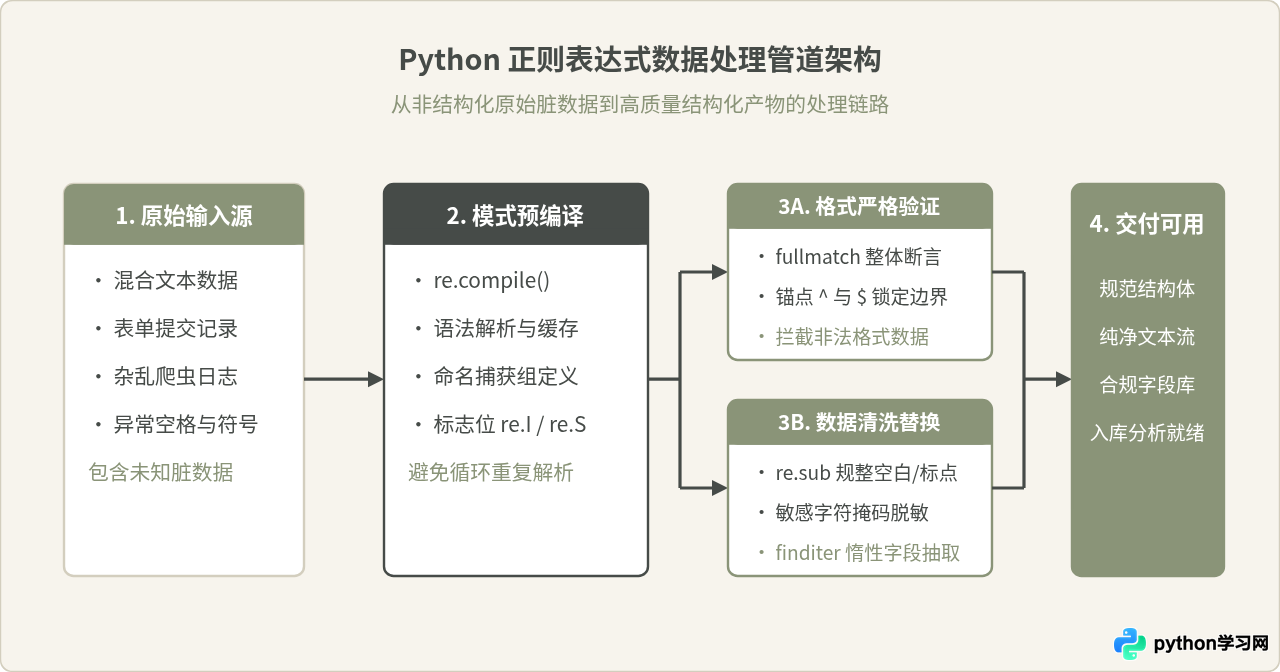
在数据处理工作流中,原始文本往往混杂着格式残缺、脏符号、多余空格以及不合规的输入。Python 标准库自带的 re 模块提供了原生的正则表达式解析引擎,其核心价值在于以轻量、声明式的模式匹配语法,快速完成格式合法性断言、脏字符过滤与关键字段捕获。本文围绕数据清洗与格式验证两大高频场景,拆解 re 模块核心函数的底层区别,给出生产级代码模版,并剖析常见认知误区与性能边界。
一、核心匹配函数的机制差异与选型依据
很多初学者在调用 re 模块时,经常遇到“明明写了正则表达式却匹配出预期外结果”的情况,其根源往往不是正则语法本身写错,而是选错了匹配函数。Python 的 re 模块提供了语义截然不同的匹配入口:
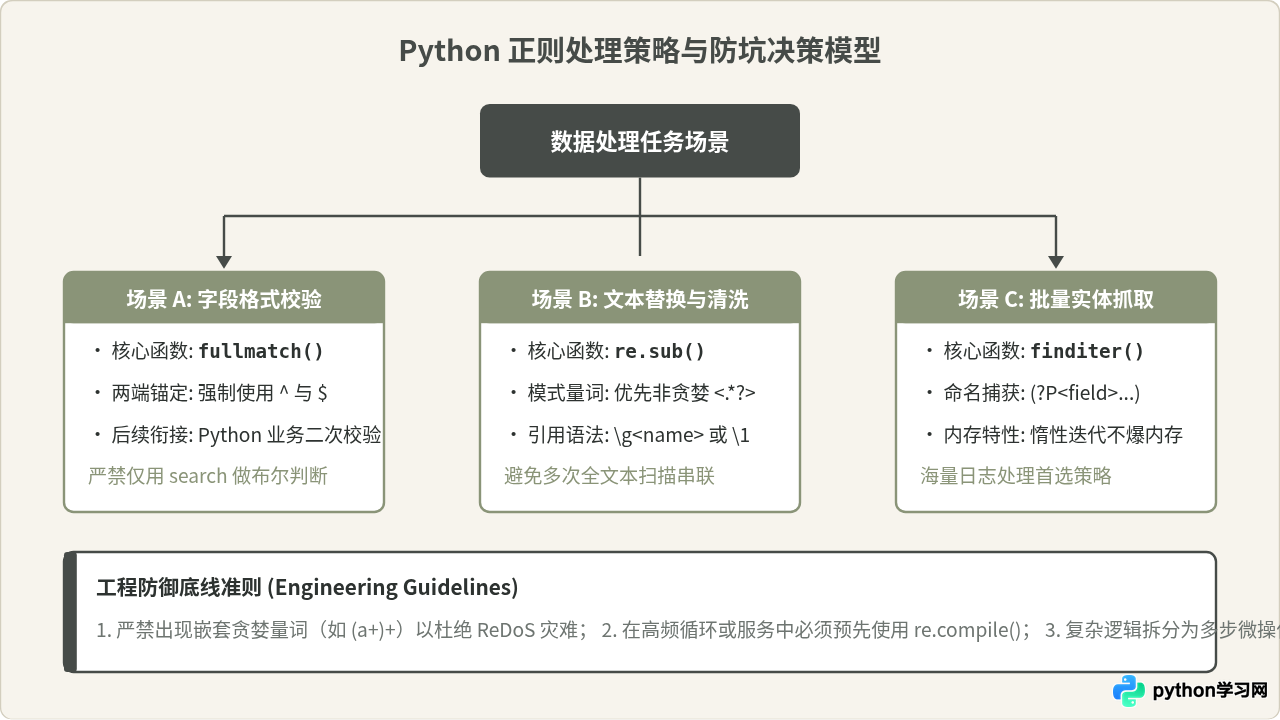
re.match(pattern, string):仅从字符串开头匹配。如果字符串第一个字符不满足模式,即使后续内容完全符合,也会立即返回None;反之,若开头匹配成功但尾部包含脏字符,它仍然判定成功。re.search(pattern, string):在全文中搜索首个匹配项。它会扫描整个字符串直到找到第一个符合模式的子串。适合定位关键词,但不适合直接做严格格式验证。re.fullmatch(pattern, string):严格全文匹配。要求整个字符串从头到尾必须完全符合模式定义,等价于两端显式包裹^与$。这是做格式校验的首选函数。re.findall(pattern, string)与re.finditer(pattern, string):全文检索所有非重叠匹配项。前者直接返回匹配字符串列表,后者返回惰性迭代器,适合大文本流式抽取。
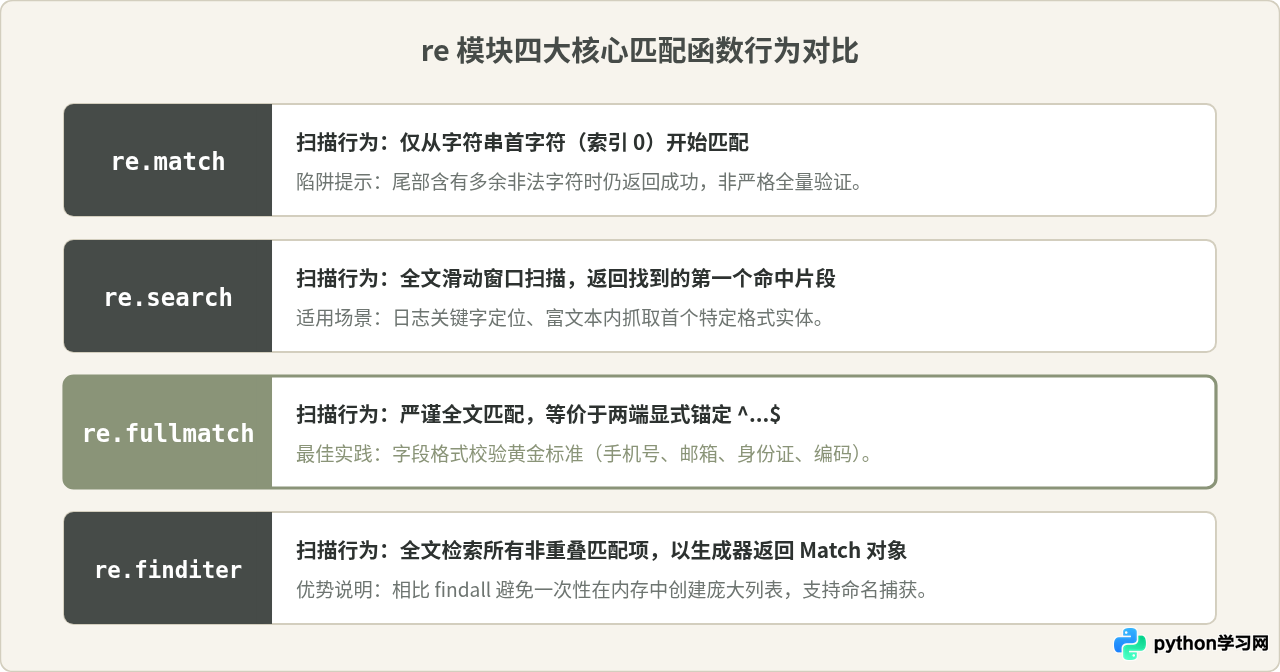
常见误区辨析:有开发者认为“校验手机号用 re.match(r'1[3-9]\d{9}', text) 足够了”。实际上,若传入 "13800138000abcdef",re.match 依然判定为合法,因为它的前11位确实吻合模式。若不加结束锚点 $,必须严格改用 re.fullmatch 才能避免此类穿透缺陷。
二、结构化字段格式验证实战
格式验证的本质是断言输入的文本是否完全满足特定的排他性规则。在进行模式设计时,应当遵循三个原则:前缀约束、长度明确、字符集排他。以下提供常见字段的工业级验证方案。
1. 常用验证模式设计
| 业务字段 | 验证正则表达式 | 设计要点说明 |
|---|---|---|
| 大陆手机号码 | ^1[3-9]\d{9}$ |
首位必须为1,第二位3-9,后续严格跟随9位连续数字。 |
| 标准电子邮箱 | ^[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+$ |
覆盖常见字母、数字及规范点号,要求域名段具备合法分割。 |
| ISO 8601 日期 | ^\d{4}-(?:0[1-9]|1[0-2])-(?:0[1-9]|[12]\d|3[01])$ |
月份限定 01-12,日期限定 01-31,采用非捕获组 (?:...)。 |
| 18位居民身份证 | ^[1-9]\d{5}(?:18|19|20)\d{2}(?:0[1-9]|1[0-2])(?:0[1-9]|[12]\d|3[01])\d{3}[\dXx]$ |
前6位行政区划不以0开头,年份限定1800-2099,末位校验位支持X。 |
2. 验证与预编译实现示例
import re

class DataValidator:
    def __init__(self):
        # 预编译正则对象,提升多次调用的匹配效率
        self._phone_pattern = re.compile(r"^1[3-9]\d{9}$")
        self._date_pattern = re.compile(
            r"^(?P<year>\d{4})-(?P<month>0[1-9]|1[0-2])-(?P<day>0[1-9]|[12]\d|3[01])$"
        )

    def validate_phone(self, phone_str: str) -> bool:
        """校验手机号是否合法"""
        if not isinstance(phone_str, str):
            return False
        return bool(self._phone_pattern.fullmatch(phone_str.strip()))

    def validate_and_parse_date(self, date_str: str) -> dict:
        """校验日期格式并提取年月日字典"""
        if not isinstance(date_str, str):
            return {}
        match = self._date_pattern.fullmatch(date_str.strip())
        if not match:
            return {}
        # 通过命名捕获组直接输出字典
        return {k: int(v) for k, v in match.groupdict().items()}

# 示例验证执行
validator = DataValidator()
print("手机号验证 [13800138000]:", validator.validate_phone("13800138000"))       # 输出: True
print("手机号验证 [13800138000abc]:", validator.validate_phone("13800138000abc")) # 输出: False
print("日期解析 [2026-10-24]:", validator.validate_and_parse_date("2026-10-24"))    # 输出: {'year': 2026, 'month': 10, 'day': 24}
三、非结构化文本数据清洗实操
与格式验证不同,数据清洗关注于从脏乱、半结构化或富文本中剔除干扰噪音,将混乱的数据流收敛为规范的纯文本。典型的清洗动作包括:多余空白折叠、非法不可见字符剔除、敏感信息打码与特定实体结构化抽取。
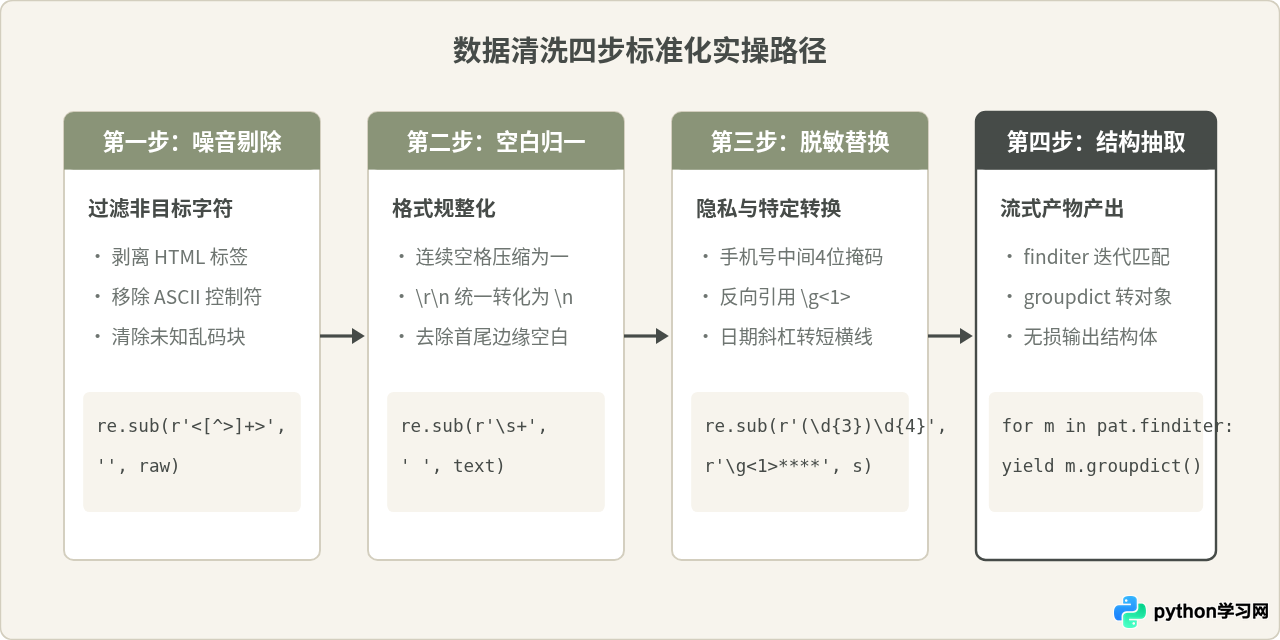
数据清洗流水线代码实现
import re

def clean_raw_document(raw_text: str) -> str:
    """综合清洗函数:剔除标签、折叠空白、统一标点"""
    if not raw_text:
        return ""

    # 1. 剔除 HTML 标签与 XML 标记
    text = re.sub(r"<[^>]+>", "", raw_text)

    # 2. 移除不可见控制字符(保留常规换行与制表符)
    text = re.sub(r"[\x00-\x08\x0b\x0c\x0e-\x1f\x7f]", "", text)

    # 3. 统一多变换行符并折叠超长空行(3个及以上换行压缩为双换行)
    text = re.sub(r"\r\n|\r", "\n", text)
    text = re.sub(r"\n{3,}", "\n\n", text)

    # 4. 行内连续多空格(含制表符)压缩为单个半角空格
    text = re.sub(r"[^\S\n]+", " ", text)

    # 5. 常见日期分隔符归一化:将 2026/10/24 或 2026.10.24 统一为 2026-10-24
    text = re.sub(r"(?<=\d{4})[./](?=\d{2}[./]\d{2})", "-", text)

    return text.strip()

def mask_sensitive_info(text: str) -> str:
    """对清洗后文本中的手机号与身份证进行合规脱敏"""
    # 手机号脱敏:保留前3后4,中间4位转为 *
    masked = re.sub(r"(?<!\d)(1[3-9]\d)\d{4}(\d{4})(?!\d)", r"\g<1>****\g<2>", text)
    # 18位身份证脱敏:保留前6后4,中间8位转为 *
    masked = re.sub(r"(?<!\d)([1-9]\d{5})\d{8}(\d{3}[\dXx])(?!\d)", r"\g<1>********\g<2>", masked)
    return masked

# 示例执行测试
raw_sample = """
<div class="content">
   用户李明于  2026/10/24 提交了订单。\r\n\r\n\r\n
   联系电话: 13912345678 ,证件编号: 110101199003072345。\x00
</div>
"""

cleaned = clean_raw_document(raw_sample)
protected = mask_sensitive_info(cleaned)

print("--- 清洗并脱敏后的产物 ---")
print(protected)
# 输出:
# 用户李明于 2026-10-24 提交了订单。
#
# 联系电话: 139****5678 ,证件编号: 110101********2345。
四、认知误区与性能陷阱
正则表达式虽然强大,但在生产系统中极易因误用而引发系统级故障。以下三项是工程开发中最容易忽视的风险边界:
1. 误区:试图用正则完成所有业务逻辑验证
辨析:正则的核心职能是“形态与语法层面的合法性断言”,而非“业务逻辑校验”。例如,正则 ^\d{4}-\d{2}-\d{2}$ 能够确保日期是四位数字加两个两位数字的形式,但无法判断 2026-02-31 是否存在,更无法自动计算闰年二月。正确的架构设计是:先用正则做粗筛拦截格式畸变输入,再用 Python 原生模块(如 datetime)进行精确语义解析。
2. 贪婪匹配与非贪婪匹配的语义灾难
默认情况下,量词 *、+、{m,n} 是贪婪的,会尽可能多地消耗字符。当清洗包含多对标签的文本时,使用 <.*> 会直接吞掉从第一个 < 到最后一个 > 之间的所有有效内容。必须加上 ? 声明为非贪婪模式 <.*?>,或使用更严格的排他型字符集 <[^>]*>。
3. 回溯灾难(ReDoS 拒绝服务)
Python 默认的 re 模块基于 NFA(非确定性有限状态自动机)实现。当正则表达式中存在重复嵌套结构(如 (a+)+$ 或 ([a-zA-Z]+)*$)且待匹配字符串在尾部发生不匹配时,自动机会展开所有可能的分支组合进行试探,引发指数级的时间复杂度回溯,直接导致 CPU 占用 100%、进程挂起。
五、工程化落地建议与总结
在实际工程项目中,正则表达式往往具有“易写难读”的特征。为了兼顾执行性能与长期维护性,建议在代码仓库中推行以下四项落地规范:
- 必须使用原始字符串(Raw String):书写所有正则表达式时,强制使用
r"..."前缀。避免 Python 解释器本身的字符串转义与正则引擎转义发生冲突,消除无意义的双重反斜杠\\\\。 - 使用详细模式(
re.VERBOSE)组织复杂模式:当正则表达式长度超过 30 个字符时,启用re.X或re.VERBOSE标志位。该标志允许在正则内部自由添加换行和注释,使复杂的验证规则具备自我解释能力。 - 循环外强制预编译:尽管 Python 内部保留了小容量的最近正则缓存(LRU Cache),但当系统中存在大量动态模式交替运行时,频繁调用裸函数会导致缓存击穿与反复重新编译。在类初始化或模块级别统一执行
re.compile()是零成本的性能保障。 - 测试用例全量覆盖边缘情况:为正则模块编写单元测试时,测试集除了包含合法样例,必须重点构造反例,例如“首尾包含特殊不可见字符”、“超长恶意重复字符串”、“仅前缀匹配但后缀非法”等样本,防止在真实网络环境中被绕过。
合理运用 Python 正则表达式,能够大幅精简数据清洗流水线的代码行数并提升执行吞吐量。关键在于根据数据特性,在格式验证中坚持使用 re.fullmatch 严控边界,在清洗替换中依靠 re.sub 和非贪婪模式保障准确性,并在工程层面保持预编译与防回溯意识,从而构建出鲁棒、安全的数据预处理服务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















