


Python for循环中break和continue的区别及使用场景
深入解析Python for循环中break与continue的核心区别、底层执行机制、真实业务场景代码与多层嵌套注意事项,帮助开发者准确掌控循环控制流。
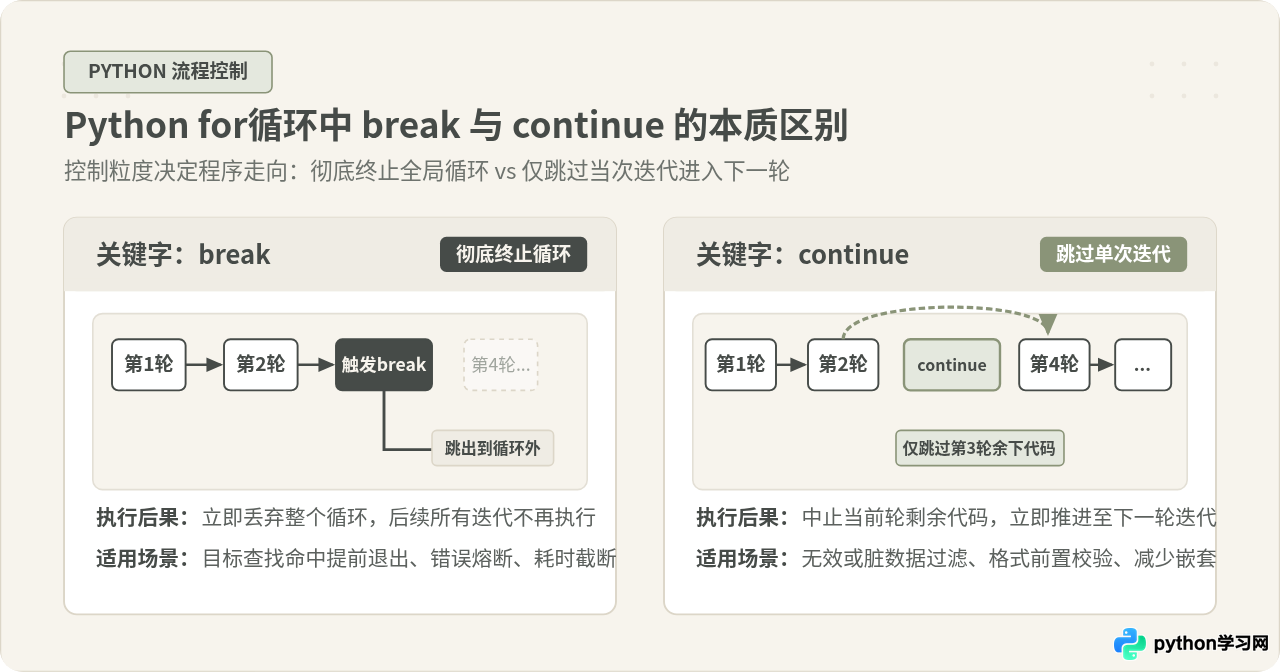
for 循环中,break 与 continue 都用于打破代码从上到下的默认执行流,但它们的控制粒度完全不同:break 属于“全局熔断”,一旦触发便立即终结整个 for 循环,彻底跳出并丢弃后续所有尚未遍历的元素;而 continue 属于“单次跳过”,一旦触发仅放弃当前这一轮迭代中剩余的代码,控制权会立即交还给循环头部,拉取序列中的下一个元素继续下一轮执行。
许多初学者在刚接触循环跳转语句时,容易混淆两者的边界,或者在多层嵌套和 for...else 结构中写出意料之外的逻辑漏洞。本文将从执行机制、数据流轨迹、典型工程场景、嵌套作用域及避坑指南五个维度,系统讲透两者的核心差异与规范用法。
一、执行机制与控制流程对比
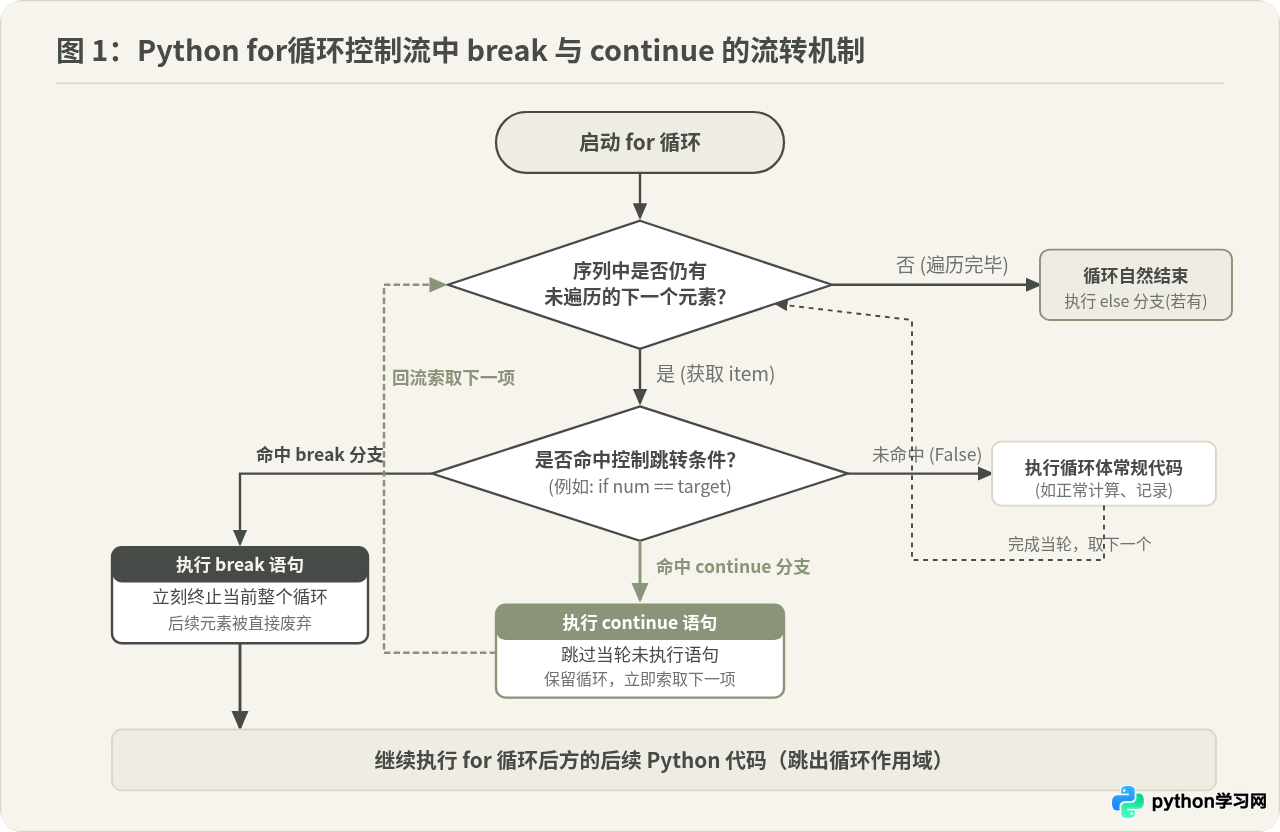
要透彻理解 break 与 continue,必须从 Python 解释器在遍历序列时的步进机制谈起。在标准的 for item in iterable: 结构中,Python 内部通过迭代器协议依次调用 next() 来提取元素,直到触发 StopIteration 异常正常结束。
当我们在循环体中加入分支判断时:
- break 的运作:当程序执行到
break时,解释器直接向外层抛出控制跳转,当前的循环迭代器不再索取下一个元素,直接终止该循环块,进入循环体紧随其后的代码。若该for循环附带了else子句,break会一并将该else子句直接跳过。 - continue 的运作:当程序执行到
continue时,解释器立即停止执行当前轮次位于continue下方的任何语句,但循环本身并没有结束。迭代器会紧接着尝试获取序列中的下一个元素,如果存在则直接开启下一轮迭代。
二、序列遍历轨迹对照:以具体数值列表验证
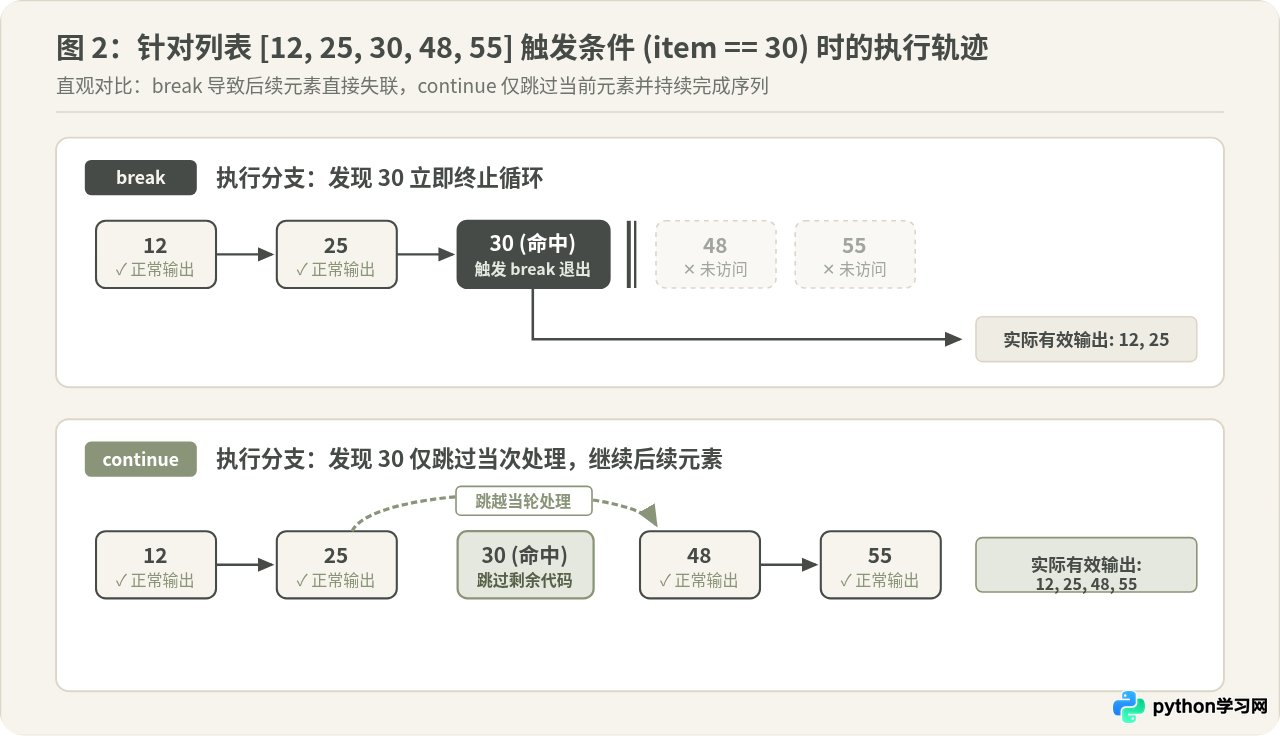
为了直观展现两者在数据处理上的真实差异,我们使用完全相同的数据源和触发条件,分别观察 break 与 continue 的运行轨迹。
测试场景设定为:遍历整数列表 [12, 25, 30, 48, 55],检测条件设定为 num == 30。
1. 使用 break 的执行行为
在遍历到数值 30 时执行 break,观察循环的截断效果:
numbers = [12, 25, 30, 48, 55]

print("--- 开始 break 测试 ---")
for num in numbers:
    if num == 30:
        print(f"命中目标值 {num},执行 break 退出循环")
        break
    print(f"处理数值: {num}")

print("--- 循环外部后续代码 ---")
--- 开始 break 测试 ---
处理数值: 12
处理数值: 25
命中目标值 30,执行 break 退出循环
--- 循环外部后续代码 ---
从输出中可以清晰看到,当 num 为 30 时,循环被直接终止。列表后续的 48 和 55 完全没有被遍历,相关的打印与后续计算全部被舍弃。
2. 使用 continue 的执行行为
保持列表和判断条件完全一致,将 break 替换为 continue:
numbers = [12, 25, 30, 48, 55]

print("--- 开始 continue 测试 ---")
for num in numbers:
    if num == 30:
        print(f"命中跳过值 {num},执行 continue 跳过本轮剩余语句")
        continue
    print(f"处理数值: {num}")

print("--- 循环外部后续代码 ---")
--- 开始 continue 测试 ---
处理数值: 12
处理数值: 25
命中跳过值 30,执行 continue 跳过本轮剩余语句
处理数值: 48
处理数值: 55
--- 循环外部后续代码 ---
在 continue 的输出中,仅有 30 后方的 print(f"处理数值: {num}") 被跳过了,但循环并未停顿,而是紧接着处理了 48 与 55,直至整个列表所有元素遍历完毕。
三、break 的典型使用场景与规范实践
break 的核心哲学是“目标一旦达成,即刻止步”或“遇到致命错误,立即止损”。在实际项目开发中,以下两类场景是 break 的主战场:
场景 1:目标搜索与提前返回(避免无效开销)
当我们在一个大型列表或数据集查找满足特定条件的单个记录(如通过用户 ID 查找配置或特定订单)时,一旦匹配成功,后续成千上万条记录的遍历就变成了纯粹的算力浪费。此时应立即使用 break 截断。
users = [
    {"id": 1001, "name": "Alice", "role": "editor"},
    {"id": 1002, "name": "Bob", "role": "admin"},
    {"id": 1003, "name": "Charlie", "role": "viewer"},
    {"id": 1004, "name": "Diana", "role": "viewer"}
]

target_id = 1002
matched_user = None

for user in users:
    if user["id"] == target_id:
        matched_user = user
        print(f"已定位目标用户: {user['name']},终止后续遍历")
        break

# 示例输出表明:匹配到 1002 后,1003 与 1004 不再被比对
场景 2:安全边界保护与错误熔断(Circuit Breaker)
在批量处理外部网络请求、读取流数据或解析未知格式文件时,如果累积错误达到了安全阈值,必须使用 break 强制终止,避免程序在雪崩状态下持续消耗系统资源。
tasks = ["task_1", "task_2", "task_fail_1", "task_fail_2", "task_fail_3", "task_6"]
consecutive_errors = 0
MAX_ERRORS = 3

for task_name in tasks:
    # 模拟任务执行
    is_success = not task_name.startswith("task_fail")
    if not is_success:
        consecutive_errors += 1
        print(f"任务 {task_name} 失败,连续失败次数: {consecutive_errors}")
        if consecutive_errors >= MAX_ERRORS:
            print("达到连续错误安全阈值,触发熔断并终止循环!")
            break
    else:
        consecutive_errors = 0
        print(f"任务 {task_name} 执行成功")
进阶特性:break 与 for...else 语法的协同
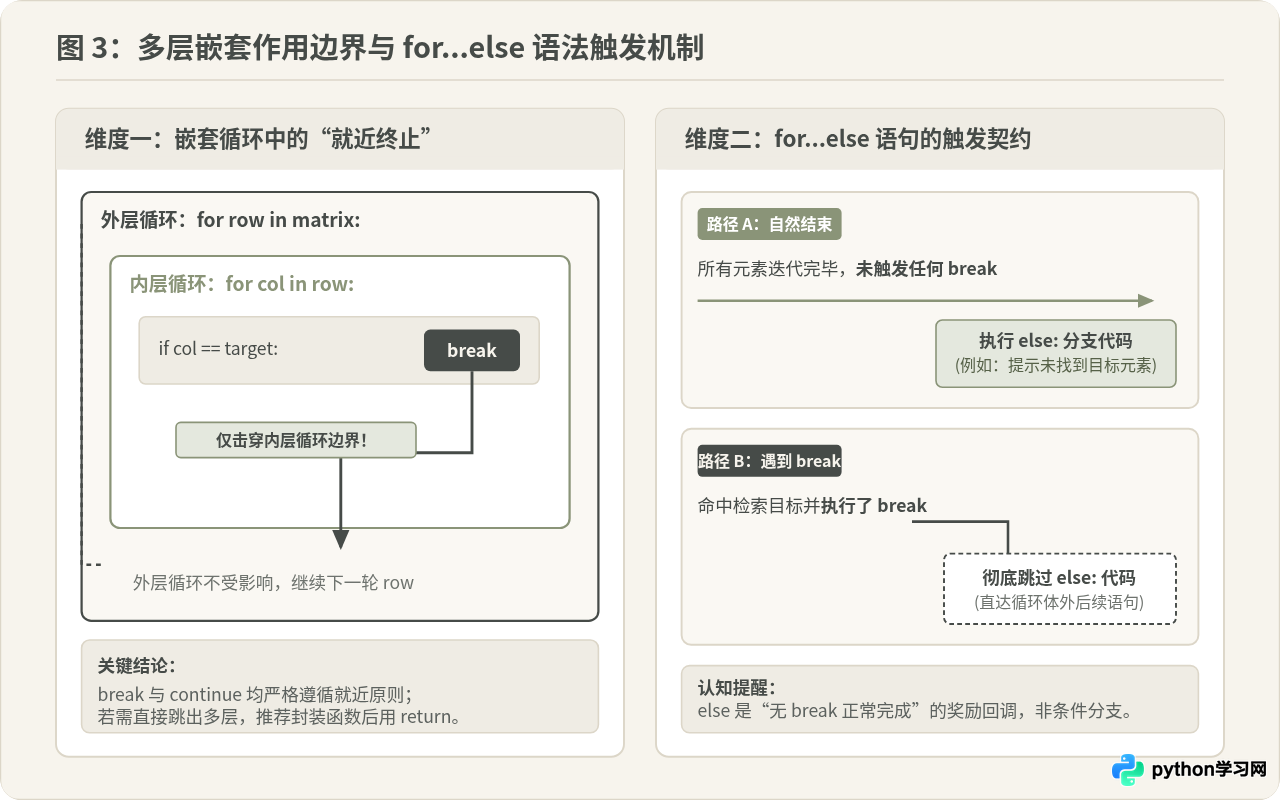
很多 Python 开发者容易忽视 for...else 结构。这里的 else 语义与 if...else 完全不同:循环体只有在“自然耗尽(即没有遭遇任何 break)”时才会执行 else 分支。如果循环被 break 中途打断,else 代码块会被完全跳过。
def check_account_status(accounts, target_account):
    for acc in accounts:
        if acc == target_account:
            print(f"账户 {target_account} 校验通过,允许访问")
            break
    else:
        # 仅当整个循环全部跑完且没有触发 break 时执行
        print(f"未找到账户 {target_account},请核对输入!")

# 示例调用
check_account_status(["acc_01", "acc_02", "acc_03"], "acc_02") # 触发 break,不走 else
check_account_status(["acc_01", "acc_02", "acc_03"], "acc_99") # 未触发 break,执行 else
四、continue 的典型使用场景与规范实践
continue 的核心哲学是“排除当前干扰,持续处理后续”。它能显著提升数据流处理的清晰度,主要应用在以下两类场景:
场景 1:数据清洗与无效数据过滤
在处理日志分析、CSV 文件解析或爬虫清洗流程时,输入数据往往伴随大量空字符串、注释行或不合法类型。使用 continue 可以在循环体最前部将这些脏数据直接剔除。
raw_config_lines = [
    "# 系统数据库配置项",
    "host=127.0.0.1",
    "",
    "   ",
    "# 端口配置",
    "port=3306",
    "invalid_entry_without_equal",
    "timeout=30"
]

parsed_config = {}
for line in raw_config_lines:
    stripped = line.strip()
    # 过滤空行与注释行
    if not stripped or stripped.startswith("#"):
        continue
    # 过滤格式不合规行
    if "=" not in stripped:
        continue

    key, val = stripped.split("=", 1)
    parsed_config[key.strip()] = val.strip()

print("最终解析结果:", parsed_config)
# 示例输出: 最终解析结果: {'host': '127.0.0.1', 'port': '3306', 'timeout': '30'}
场景 2:使用卫语句(Guard Clauses)扁平化嵌套结构
很多初学者喜欢把所有业务处理逻辑嵌套在层层 if 语句内部,导致代码缩进过深(形成所谓的“箭头型代码”)。利用 continue 充当卫语句,可以把异常或不符合条件的逻辑反转并在开头跳出,从而让核心处理逻辑保持在最浅的缩进层级。
深层嵌套(易读性差):
for user in users:
    if user.is_active:
        if user.has_permission:
            send_notification(user)
使用 continue 扁平化(结构清爽):
for user in users:
    if not user.is_active or not user.has_permission:
        continue
    send_notification(user)
五、多层嵌套循环中的作用范围与避坑指南
在面对二维矩阵计算、表格嵌套解析等多层循环场景时,最容易出现的认知盲区就是误以为 break 能直接跳出所有嵌套。请牢记一条铁律:无论是 break 还是 continue,在 Python 中都严格只对包围它们的最内层循环生效!
痛点解答:如何在内层循环中彻底跳出外层循环?
既然 break 只能击穿最内层循环,如果业务确实需要在内层找到答案后一并终止外层循环,有以下三种工业级处理方案:
-
方案一:封装为独立函数并使用 return(最推荐、最 Pythonic)
将嵌套遍历逻辑抽离成一个独立函数,当内层条件满足时,直接使用return返回结果。return会直接结束函数执行上下文,无论嵌套了多少层循环都会瞬间彻底退出。 -
方案二:标志变量配合外层 break(Flag Variable)
设置布尔标志(如found = True),内层break后,外层循环立刻检验该标志并再次执行break。 -
方案三:利用 for...else 链式跳出
内层循环利用for...else:如果内层因为break退出,则不会执行内层的else;在外层配合判断,也可以达到链式跳出的目的。
def find_in_matrix(matrix, target):
    for r_idx, row in enumerate(matrix):
        for c_idx, val in enumerate(row):
            if val == target:
                # return 瞬间跳出内层与外层所有循环,干净利落
                return (r_idx, c_idx)
    return None

matrix_sample = [
    [10, 20, 30],
    [40, 50, 60],
    [70, 80, 90]
]

pos = find_in_matrix(matrix_sample, 50)
print("目标值坐标:", pos)  # 示例输出: 目标值坐标: (1, 1)
六、常见误区与易混淆说法辨析
1. “continue 会导致循环死循环?”
辨析:这个说法在 while 循环中确实可能发生(例如在 continue 之前忘记对自增计数器 i += 1 进行累加,导致下一轮条件依旧满足并无限循环)。但是在 for 循环中,这个担心是多余的。因为 Python 的 for 循环基于底层的迭代器协议,每一轮迭代由解释器自动调用 next() 推进索引,continue 只会放弃当前轮次代码,绝对不会导致 for 循环计数停滞或回退。
2. “break 和 return 可以互相替代?”
辨析:它们在“提前结束执行”的表象上很接近,但作用范围有本质差别。break 仅在循环体语法结构内有效,它终止的是循环本身,函数仍在继续向下执行;而 return 是函数的返回指令,它会结束整个函数的调用。在函数体内的简单单层循环中,如果循环结束后没有其他逻辑,用 return 往往比 break 更加直接,但在脚本全局环境或循环后仍有收尾代码的场景下,两者不可混用。
七、选型决策指南与全景对比矩阵
在日常编写 for 循环时,究竟该选用 break 还是 continue?可以通过下面的决策导图快速定位:
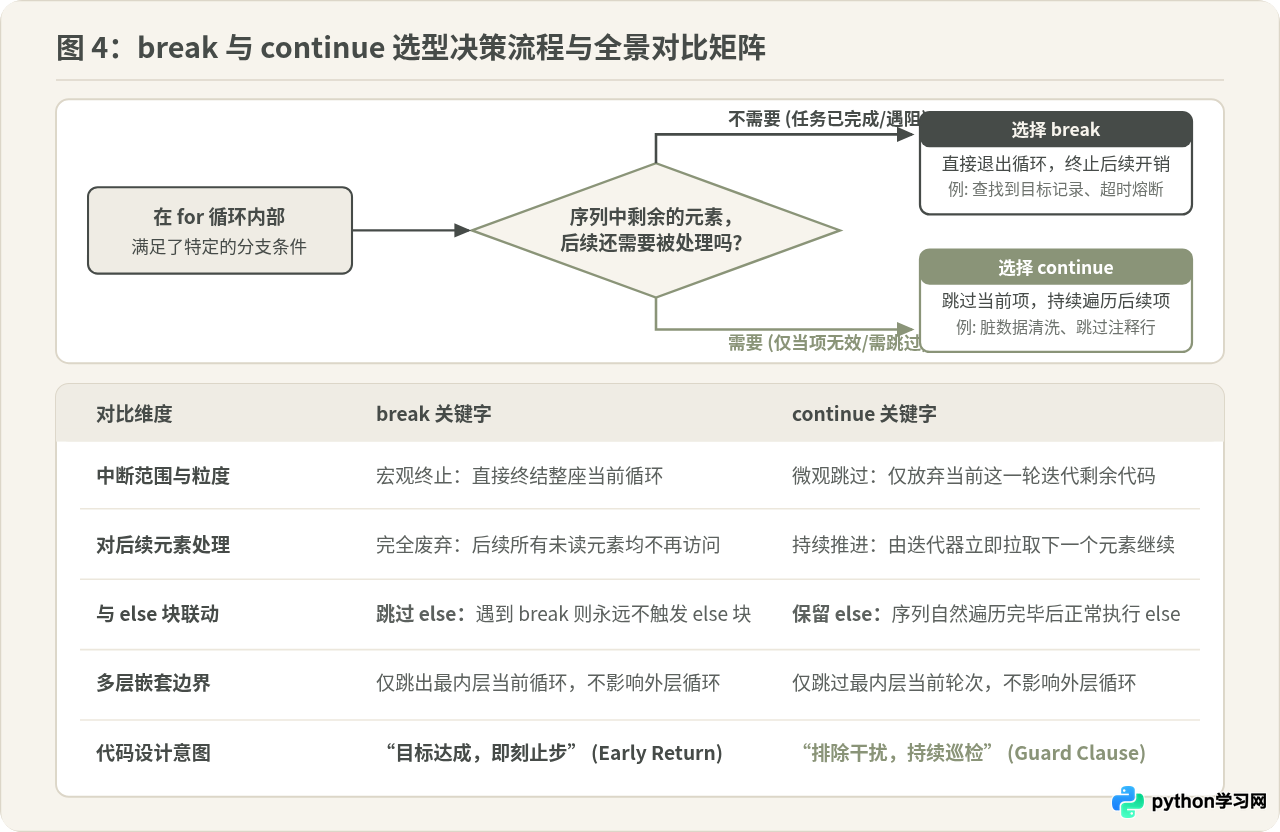
| 对比维度 | break 关键字 | continue 关键字 |
|---|---|---|
| 核心动作 | 终结并跳出整个循环体 | 跳过当次迭代,进入下一轮 |
| 后续元素处理 | 全部丢弃,不再读取 | 正常保持读取,遍历直至终点 |
| 对 for...else 影响 | 遇到 break 则彻底跳过 else 块 | 全部遍历完后正常执行 else 块 |
| 多层嵌套作用域 | 仅打破当前最直接内层循环 | 仅跳过当前最直接内层当前轮 |
| 典型工程场景 | 精准查找命中、安全熔断、超时拦截 | 数据清洗、跳过无效格式、消除多层嵌套 |
| 代码阅读心理期望 | “后续无需再看,此循环任务已收工” | “这一项略过不理,后面继续照常处理” |
八、小结
掌握 break 与 continue 的本质区别,关键在于理解控制粒度:break 关停的是整台循环机器,而 continue 只是把当前传送带上的单个残次品扔掉并继续运转。在编写代码时,优先根据“后续元素是否还有处理必要”做出选择;遇到多层嵌套需要全局跳出时,优先采用“封装函数 + return”的优雅写法,保持代码的简洁与高可维护性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















