


Python123网页版代码运行报错或超时怎么办
针对Python123网页端平台在执行作业或实验时出现的代码报错、执行超时及无响应问题,系统梳理典型错误类型、产生根源与具体排查修复方案。
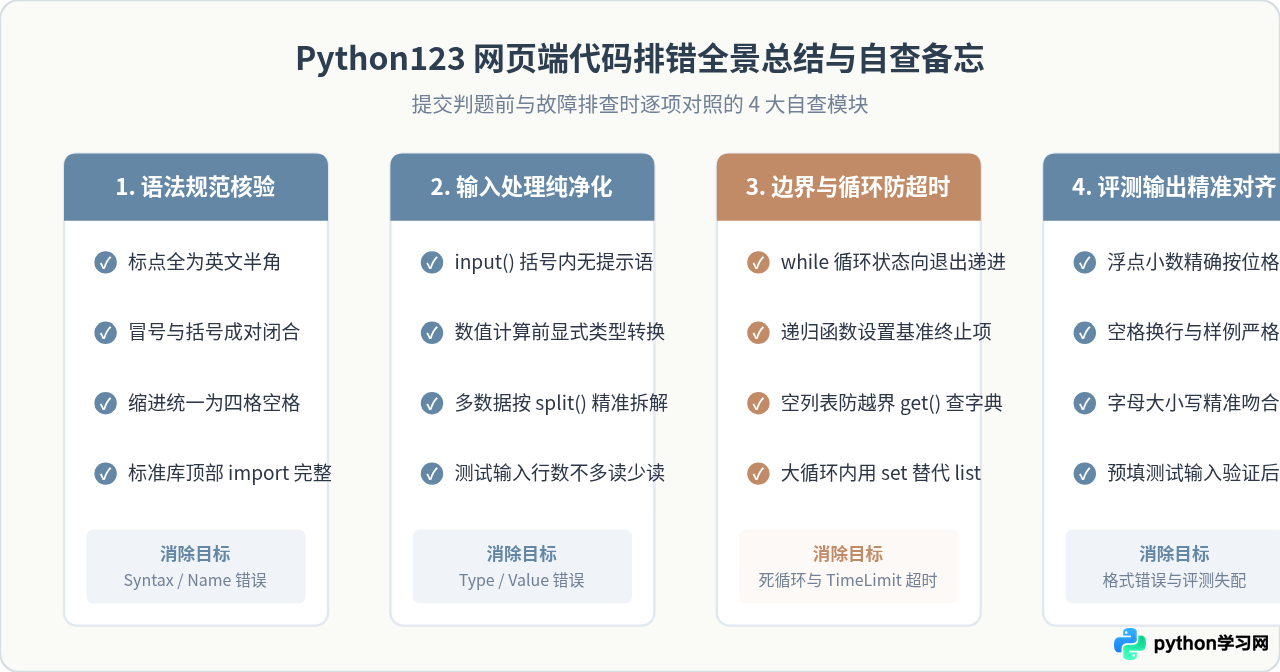
在 Python123 网页端做题或调试作业时,遇到控制台报错或程序无响应超时,是学习者最常遇到的两类阻碍。网页端运行代码并非在本地终端无约束执行,而是由云端沙箱容器在限定资源与非交互输入流下完成评测。排查的核心路径是:首先根据控制台打印的 Traceback 提示定位异常类型与所在行号,优先纠正全半角符号、未声明变量及类型转换疏漏;若页面持续转圈或提示超时,则重点审查代码是否因等待 input() 输入而阻塞挂起,以及循环计数是否推动了退出条件。按照这一顺序分步处置,可以快速解决绝大部分常见异常。
一、认识网页端沙箱执行机制与故障形态
与本地安装的 Python IDLE 或 VS Code 不同,Python123 网页版采用基于 Linux 容器的在线判题(Online Judge)沙箱架构。当点击“运行”或“提交评测”时,服务器接收源码并分配独立的执行进程,其具备三个关键约束:
- 严格的时间限制:平台单次执行通常设定了 1 到 5 秒的时间上限(Time Limit),超过此阈值进程会被系统强行中断。
- 静态模拟输入流:网页端通常无法像本地终端那样“运行到某行弹起时光标等待你敲键盘”。平台是将预先设置的测试数据一次性喂给标准输入流(sys.stdin)。
- 标准输出捕获:程序打印的所有字符都会被重定向,与标准答案逐字进行纯文本比对,任何多余的提示词或换行都会影响判题。
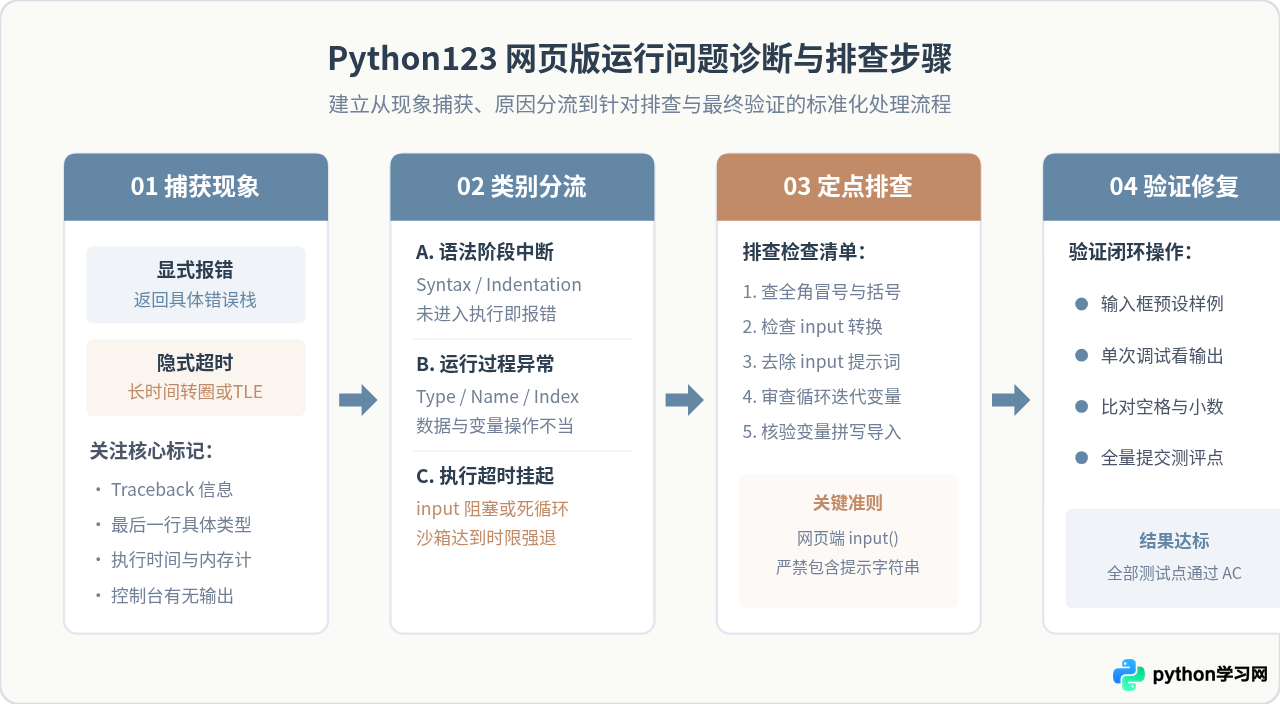
了解这一底层机制后,我们可以将所有问题归纳为清晰的四步排查流程,从现象判断到分流定位,再到针对性修改与验证。
二、常见代码报错的成因与修复方案
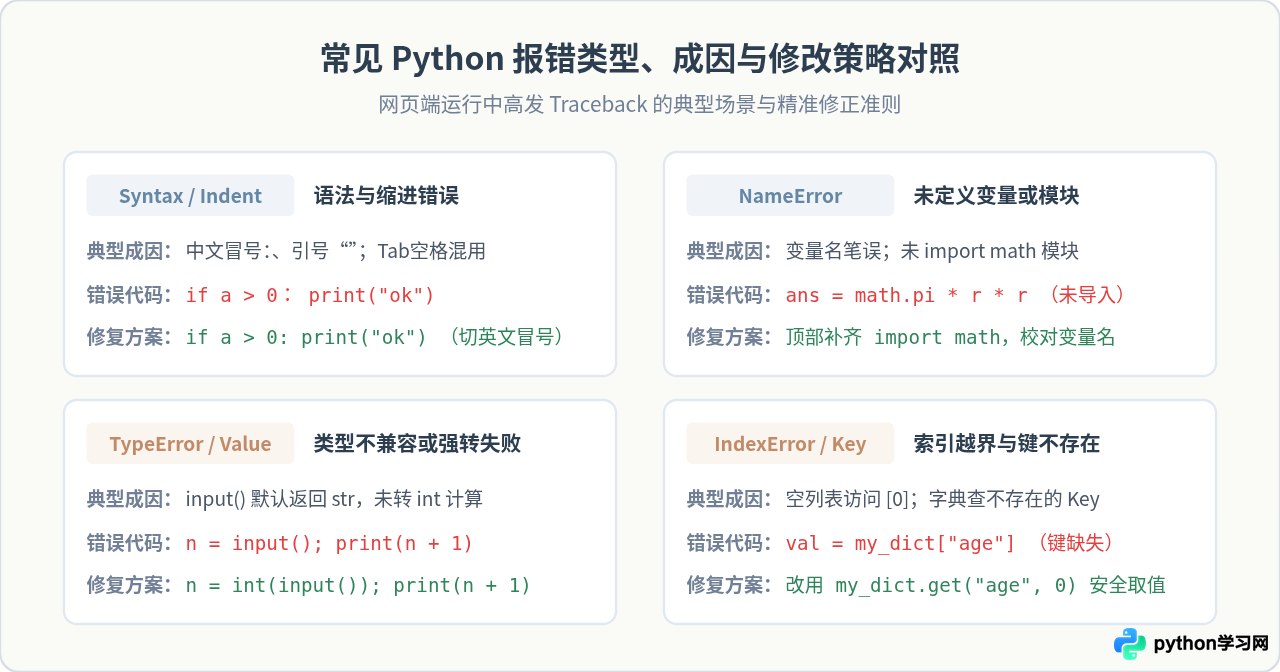
当平台直接抛出异常信息时,控制台最底部的那一行文字是解决问题的直接线索。以下是网页端出现频率最高的四类报错及其确切诱因:
1. SyntaxError 与 IndentationError(语法与缩进)
这是在代码真正运行之前由 Python 解释器在语法解析阶段报出的错误。最典型的原因包括:
- 使用了中文标点:在中文输入法状态下误输入了全角冒号(
:)、中文双引号(“”)、中文逗号(,)或中文括号(())。Python 只能识别英文半角标点。 - 缺少括号或冒号:在
if、for、while、def语句末尾遗漏了英文冒号:,或者圆括号未正确闭合。 - 缩进混乱:在 Python123 网页编辑框内,复制代码或直接按键时混合使用了制表符(Tab)和空格键。Python 要求同一层级缩进量必须严格一致,建议统一使用 4 个空格。
2. NameError 与 AttributeError(命名与引用)
NameError: name 'xxx' is not defined 表示使用了未曾定义的标识符。主要产生于:
- 变量名拼写不一致:例如上方定义的是
total_sum = 0,下方循环体内误写为total_sun += i。 - 调用未导入的标准库:直接使用了
math.sqrt()或random.randint(),但文件顶部未写import math或import random。 - 作用域问题:在函数内部定义的局部变量试图在外部直接读取。
3. TypeError 与 ValueError(类型与数值转换)
这是初学者在在线判题系统中触发率最高的一类运行时错误:
- 未做类型转换直接运算:Python 中
input()函数读取到的内容无论看起来像不像数字,其返回类型均为字符串(str)。如果写成num = input()紧接着res = num + 10,会立即触发TypeError: can only concatenate str (not "int") to str。必须显式写为num = int(input())。 - 解包数量不匹配:题目要求一行输入两个数字以空格分隔,通常使用
a, b = map(int, input().split())。如果测试用例中输入的是三个数字或仅有一个数字,就会触发ValueError: too many values to unpack或not enough values to unpack。 - 强转空字符串:
int("")会报ValueError: invalid literal for int() with base 10: '',通常发生在测试数据包含末尾空行但代码仍强行调用input()时。
4. IndexError 与 KeyError(容器越界)
IndexError: list index out of range 通常发生在通过下标访问列表时,索引超过了 len(list) - 1。例如对空列表执行 nums[0] 或多次 pop()。字典取值时若键可能不存在,建议使用 dict.get(key, 默认值) 代替直接下标取值 dict[key],以避免触发 KeyError。
三、网页版“运行超时”的三大根源与针对性解决
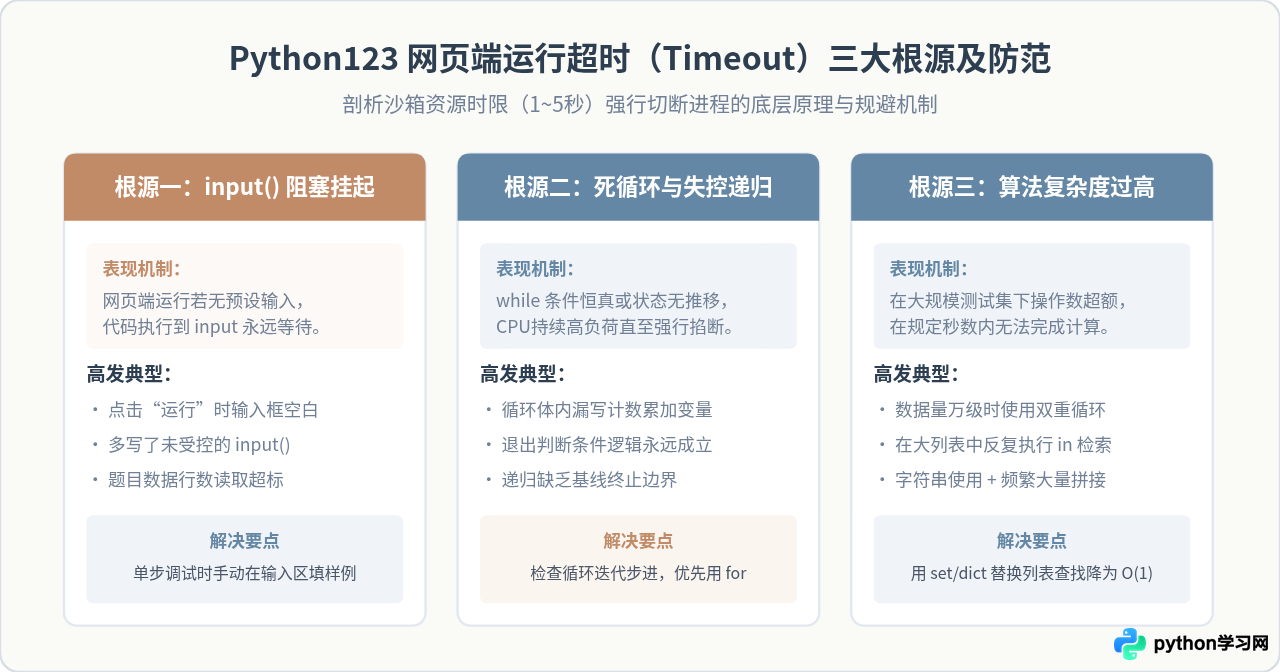
在 Python123 界面中,如果点击运行后持续显示转圈,十几秒后控制台弹出“运行超时”、“Time Limit Exceeded”或直接空白中断,说明程序在沙箱规定的时间内未能自然结束。这一现象极少是服务器故障,绝大多数由以下三个核心原因导致:
根源一:input() 阻塞挂起(最易被误判为卡顿的原因)
在本地电脑上执行 input() 时,程序会暂停等待用户在键盘上敲击回车。但在 Python123 网页端,如果在“运行”面板中没有在“输入数据”文本框里填写数据,程序执行到 input() 时就会进入无限期挂起状态,系统等不到输入,最终触发沙箱的时限强制切断进程,表现出来的就是“运行超时”。
解决策略:
- 在网页端单步点击“运行”调试时,如果代码中写了
input(),必须在编辑区下方的“输入”窗口中手动粘贴对应的测试行。 - 提交评测时,不要写超出题目输入行数的
input()。如果测试样例只有 2 行数据,代码却执行了 3 次input(),第三次读取就会因输入流耗尽而永久卡死。
根源二:死循环与迭代失控
while 循环缺乏正确的终止条件,导致 CPU 占用率瞬间达到 100% 并持续运转直至超额。常见场景为:
# 典型死循环示例
i = 1
total = 0
while i <= 100:
    total += i
    # 忘记写 i += 1,导致 i 永远为 1,循环永远无法结束!
另外,当递归调用缺乏基线条件(Base Case),或者递归收敛极其缓慢时,不仅可能触发 RecursionError: maximum recursion depth exceeded,也往往在深层递归消耗大量时间直接引发超时。
根源三:算法时间复杂度过高
如果代码既没有死循环,输入也正确,但依旧超时,则属于算法复杂度超标。当题目给出的测试数据规模较大(例如 $N \ge 10^5$)时:
- 使用双层嵌套循环导致计算量达到 $O(N^2)$(例如 $10^{10}$ 次操作),在 Python 解释器中必然需要十几秒甚至数分钟,远超沙箱规定的数秒时限。
- 在长列表中频繁使用
if x in my_list,列表查找的时间复杂度为 $O(N)$,放入循环后总体退化为 $O(N^2)$。此时应将列表转换为集合(set)或字典(dict),将查询操作降为 $O(1)$。
四、规避判题常见坑点与最终提交自查清单
在 Python123 判题系统中,即便代码没有语法报错也没有超时,仍然可能遇到“答案错误”(Wrong Answer)或“格式错误”(Presentation Error)。这多半是因为学习者沿用了初学阶段针对本地控制台的编写习惯:
1. 坚决去除 input() 中的提示文字
初学者习惯写:
# 错误写法:提示语会被系统视作输出内容!
n = int(input("请输入一个整数:"))
在 Python123 等 OJ 平台中,input() 括号内的字符串会被原封不动地输出到标准输出中。系统判题机在比对你的输出与标答时,就会看到前缀凭空多出了“请输入一个整数:”,从而直接判定为错误。正确写法应当保持 input 纯净:
# 正确写法:只保留纯净输入
n = int(input())
2. 精准匹配 print() 输出格式
判题系统是按字符比对的,以下细节至关重要:
- 空格与分隔符:如果题目要求“两个数以单个空格分隔”,使用
print(a, b)会默认插入空格;如果题目要求紧凑无空格,必须加上sep=''。 - 保留小数位数:题目要求保留 2 位小数时,直接使用
round()可能会省略末尾的 0(如3.5而非3.50)。应使用格式化字符串:print(f"{ans:.2f}")。 - 字母大小写:例如输出
True/False,若题目要求小写true/false,直接打印布尔值就会被判错。
五、总结
Python123 网页版代码运行报错或超时的排查过程,本质上是一次对代码规范性、数据类型严谨度与环境执行逻辑的系统梳理。遇到问题时不必盲目修改,首先依靠控制台给出的异常类别快速定性,消除全角符号、未定义变量和未转换的数据类型;当面临超时中断时,第一时间确认 input() 是否处于无数据等待状态,并检查循环递增条件;最后核对输出格式细节。养成这种条理清晰的排查习惯,不仅能高效完成平台作业,也将为后续深入学习编程打下扎实的基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















