


pandas2.2和2.3在字符串推断上有什么差别?
深入对比 pandas 2.2 与 2.3 在字符串自动推断(future.infer_string)机制上的核心差别,系统解析 PyArrow 依赖解耦、缺失值一致性、索引规则统一与平滑迁移指南。
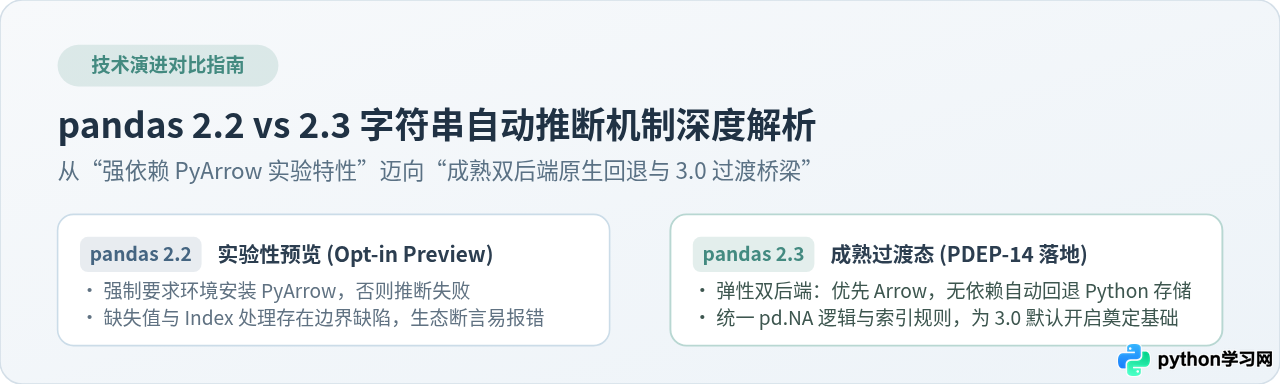
pd.options.future.infer_string = True 是告别低效 object 类型的关键开关。pandas 2.2 将该功能作为早期实验性预览(Opt-in Preview)推出,强绑定 PyArrow 后端,缺失 PyArrow 时无法正常工作,且在索引、缺失值及混合类型比较中存在边缘异常;pandas 2.3 则完成了机制的标准化演进(落实 PDEP-14 规范),引入了弹性双后端与优雅回退机制,在无 PyArrow 环境下自动回退为原生 Python 字符串存储,同时统一了 pd.NA 语义与索引推断行为,成为官方推荐的 3.0 前瞻升级基准版。
一、字符串推断的诞生背景与核心原理
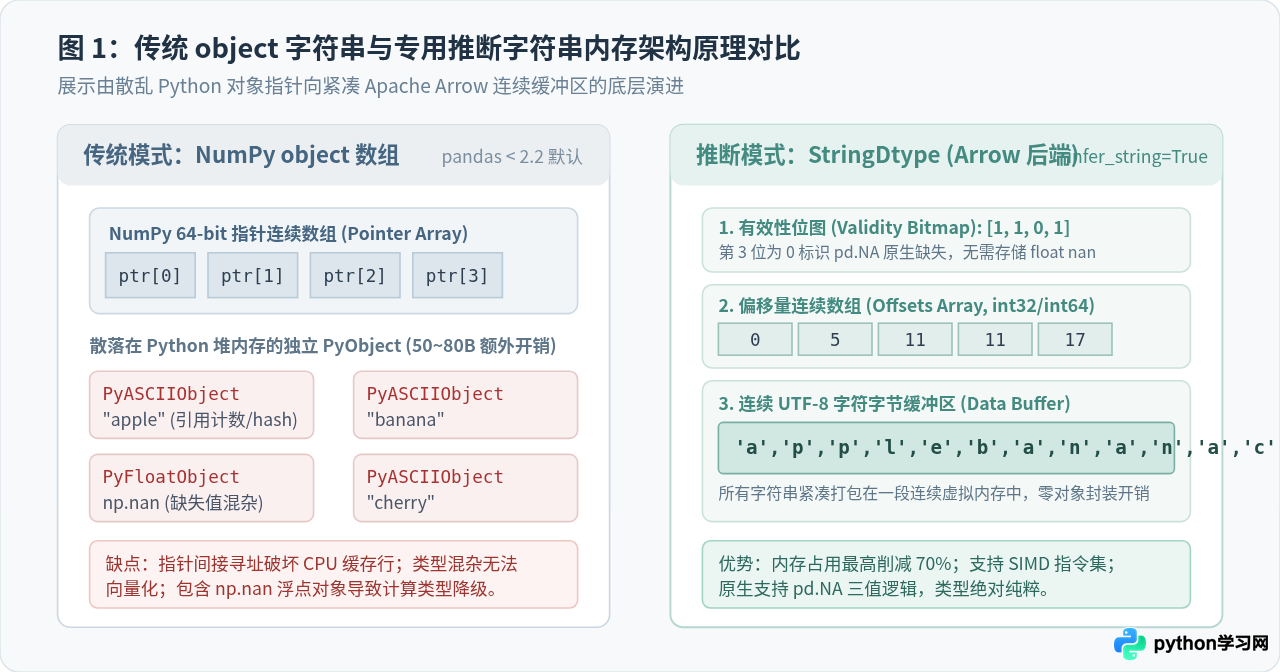
长期以来,pandas 处理文本列时默认回退为 NumPy 的 object 类型。表面上看 object 能承载任意文本,但其底层只是一组指针数组,实际字符串作为独立的 Python 原生对象分散存储在堆内存中。这种设计带来了两大痛点:内存膨胀(通常比纯文本本身大 3 至 5 倍)以及破坏 CPU 缓存行命中率,导致无法利用现代化 SIMD 向量化加速指令。
为了彻底解决该问题,pandas 社区制定了 PDEP-14 提案,核心目标是将默认的文本数据类型由 object 全面转为专用的 StringDtype。通过设置 pd.options.future.infer_string = True,用户创建数据或读取文件时,包含字符串的列将被自动识别并推断为专用字符串类型,而不再被标记为 object。
二、pandas 2.2 与 2.3 的四大核心机制差异
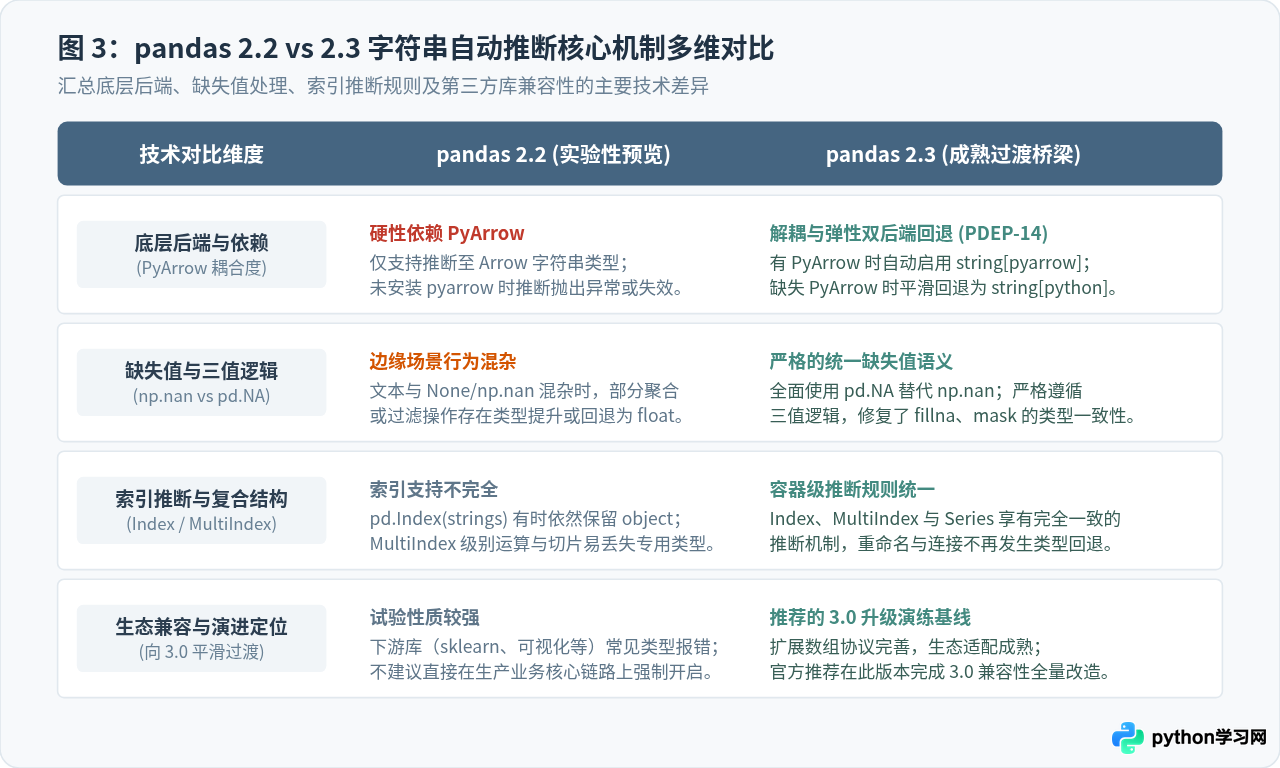
虽然两个版本使用完全相同的配置选项 future.infer_string,但其内部实现、依赖宽容度与类型规范性经历了重大的工程重构:
1. 底层存储后端的依赖解耦(PyArrow 强绑定 vs 弹性双后端)
在 pandas 2.2 中,字符串推断属于实验特性,其内部实现与 Apache Arrow 深度绑定。开启该开关后,pandas 必须依赖已安装的 pyarrow 扩展库,所有字符串推断均强制指向 string[pyarrow]。如果当前 Python 环境中未安装 pyarrow,执行推断就会引发异常或静默退化,限制了轻量级环境或无 C 扩展环境的采用。
在 pandas 2.3 中,社区正式落地了双后端架构:
- 若环境中已安装 PyArrow:默认推断为高性能的
string[pyarrow],享有极致的内存压缩与向量化计算优势。 - 若环境中未安装 PyArrow:不再报错,而是优雅降级为基于 Python 内存优化的
string[python]。无论运行环境是否包含重量级二进制包,都能稳定享受到类型推断带来的好处。
2. 缺失值表示与三值逻辑的一致性
在 pandas 2.2 的早期实现中,文本列中的缺失值处理较为混乱。当从字典、列表或外部 CSV 导入带有 None 或 np.nan 的文本时,特定运算或聚合有时会将空值还原为浮点数 NaN,甚至在跨类型合并时破坏整列类型。
pandas 2.3 规范了标量缺失值在字符串推断下的表达,严格执行三值逻辑:
- 所有推断为字符串类型的列中,缺失值统一由
pd.NA表达,彻底摒弃np.nan。 - 布尔判断(例如
s.str.startswith('A'))在遇到空值时返回可空布尔类型(boolean),空值处依然保持<NA>,逻辑闭环更加严谨。
3. 索引(Index / MultiIndex)推断的完全统一
在 pandas 2.2 中,字符串推断的覆盖范围存在盲区。Series 和 DataFrame 的普通列能够被正确推断,但在构建 pd.Index、多层索引 pd.MultiIndex 或执行 df.set_index() 时,文本索引仍然极易残留为 object 类型,导致列与索引之间类型行为不一致。
pandas 2.3 统一了容器级别的推断规范。无论构造标量索引还是复合索引,只要元素均为文本或文本与空值的组合,均一律按照与 Series 完全相同的规则推断为专用字符串类型,保障了索引对齐与连接计算的一致性。
4. 下游生态与扩展数组协议兼容度
在 pandas 2.2 推出推断选项之初,scikit-learn、SQLAlchemy 以及部分数据可视化库内部普遍充斥着 assert col.dtype == 'object' 或显式转换为 NumPy 数组的代码,直接导致大量现有代码在开启推断后崩溃。经过 2.2 至 2.3 期间整个开源生态的协同升级,pandas 2.3 完善了扩展数组(ExtensionArray)的互操作协议与标量装箱机制,显著降低了与三方库协同使用时的破坏性风险。
三、具体操作与验证步骤
要在项目中验证字符串推断的实际效果,建议按照以下具体操作步骤进行测试:
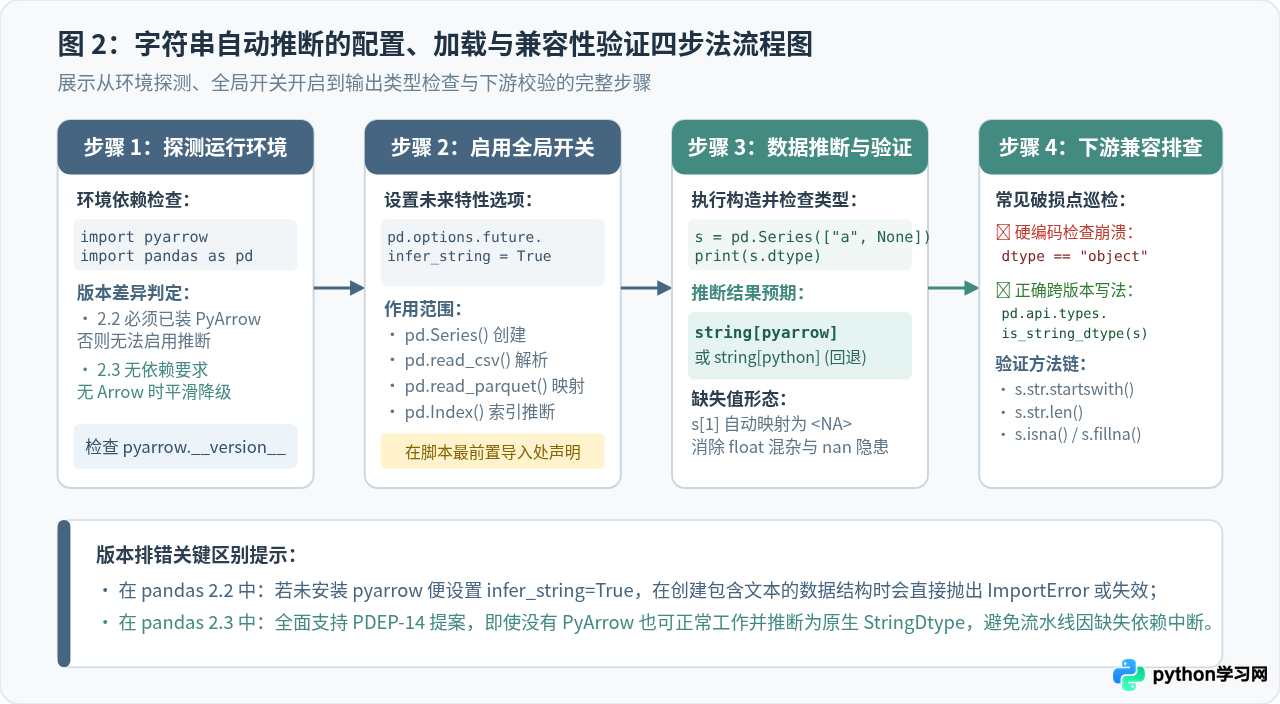
步骤 1:在业务代码入口开启全局选项
该选项属于未来行为标记,建议在导入 pandas 之后的最早位置统一配置:
import pandas as pd

# 开启未来推断行为,提前体验 pandas 3.0 的文本处理模式
pd.options.future.infer_string = True
步骤 2:创建数据并检查推断类型
构造包含文本与缺失值的列表,观察其推断出的数据类型:
# 包含正常字符串与空值的样本
data = ["pandas", "pyarrow", None, "data_science"]
s = pd.Series(data)

print("推断类型结果:", s.dtype)
print("样本数据输出:")
print(s)
预期运行输出示例:
# 在已安装 pyarrow 的环境下输出:
推断类型结果: string[pyarrow]
0          pandas
1         pyarrow
2            <NA>
3    data_science
dtype: string

# 在未安装 pyarrow 的 pandas 2.3 环境下输出:
推断类型结果: string[python]
...
步骤 3:验证向量化字符串方法与缺失值处理
执行常见的字符串操作,验证返回值的数据类型纯度:
# 向量化方法计算长度
lengths = s.str.len()
print("字符串长度类型:", lengths.dtype)
print(lengths)

# 布尔前缀筛选
mask = s.str.startswith("p")
print("筛选掩码类型:", mask.dtype)
print(mask)
预期运行输出示例:
字符串长度类型: Int64
0       6
1       7
2    <NA>
3      12
dtype: Int64

筛选掩码类型: boolean
0     True
1     True
2     <NA>
3    False
dtype: boolean
可以看到,返回的长度列自动推断为支持可空整数的 Int64,而判断掩码返回的是支持三值逻辑的 boolean,不再含有浮点数 nan。
s.dtype == "object" 或 s.dtype == np.object_ 的硬编码断言。这类写法在开启字符串推断后必定抛出 False。规范的跨版本判断方式应当改为:pd.api.types.is_string_dtype(s)。
四、升级与演进策略建议
理解 pandas 2.2 和 2.3 的技术演进节点,能够帮助团队避免踩坑并制定明确的迁移方案:
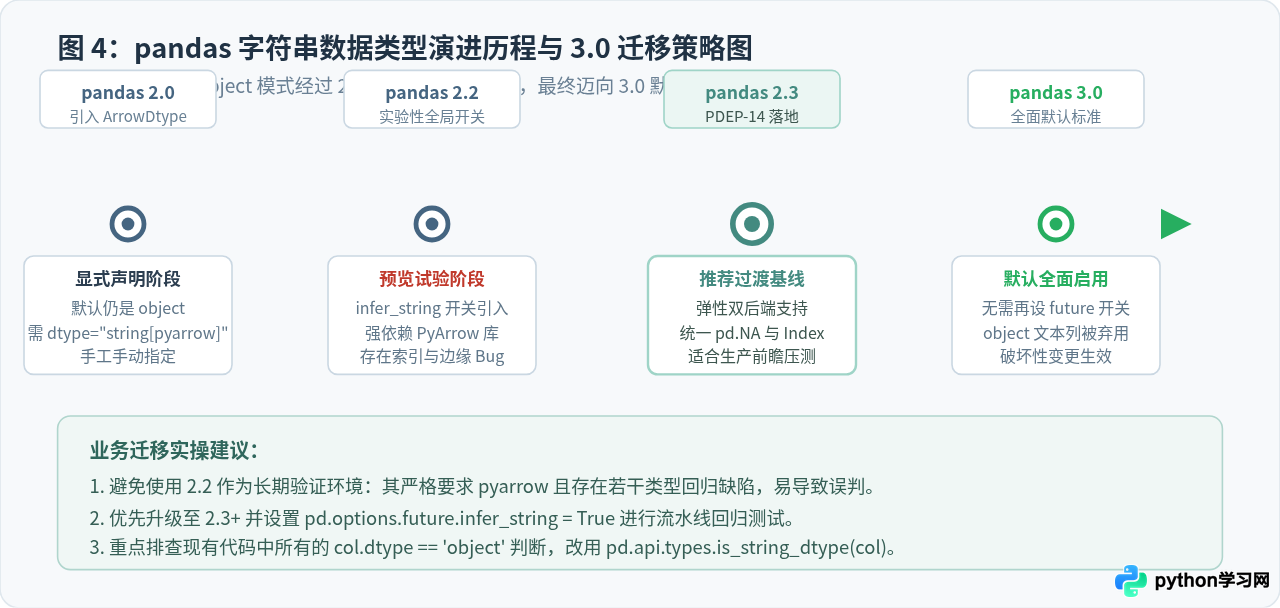
| 版本阶段 | 字符串推断状态 | 生产环境建议 |
|---|---|---|
| pandas 2.0 ~ 2.1 | 无全局推断,仅支持显式指定 dtype="string[pyarrow]" |
仅建议在内存受限的大型单点任务上手动声明使用。 |
| pandas 2.2 | 实验性 infer_string 开关(强绑定 PyArrow) |
适合本地探索性测试,不建议作为生产流水线的长期配置。 |
| pandas 2.3 | 成熟的过渡桥梁,落实 PDEP-14,弹性双后端 | 极力推荐。可在回归测试套件中全局开启,作为升级 3.0 的试金石。 |
| pandas 3.0 | 默认开启,全面废弃文本的 object 存储 | 最终技术形态。未在 2.3 完成代码兼容改造的业务将面临断言中断风险。 |
infer_string = True 是最稳妥、兼容性最佳的技术路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















