


Python打印中文乱码怎么解决
深入解析Python打印中文乱码与UnicodeEncodeError的成因,提供Windows终端、VS Code、PyCharm、管道重定向以及文件读写等全场景实战解决方案与排查流程。
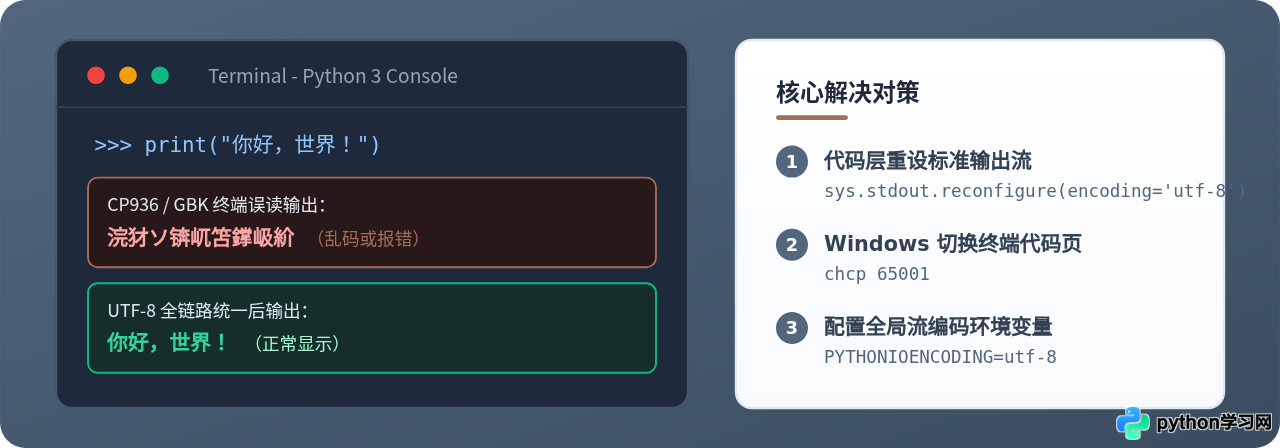
UnicodeEncodeError,本质是标准输出流(sys.stdout)的字符编码与当前控制台终端所使用的代码页不匹配。在大多数 Windows 场景下,只需在脚本最上方加入 sys.stdout.reconfigure(encoding='utf-8'),或者在运行前在终端执行 chcp 65001,即可立刻恢复正常中文显示。
一、乱码从何而来:Python 字符流与终端编码的“脱节”
很多开发者在刚刚接触 Python 时都会遇到一个怪现象:一段包含中文 print("你好,世界") 的代码,在 macOS 或 Linux 上运行一切正常,但在 Windows 的 CMD 或部分编辑器内置终端里运行,要么打印出一长串毫无意义的古怪文字(如 浣犲ソ),要么直接抛出红色异常:
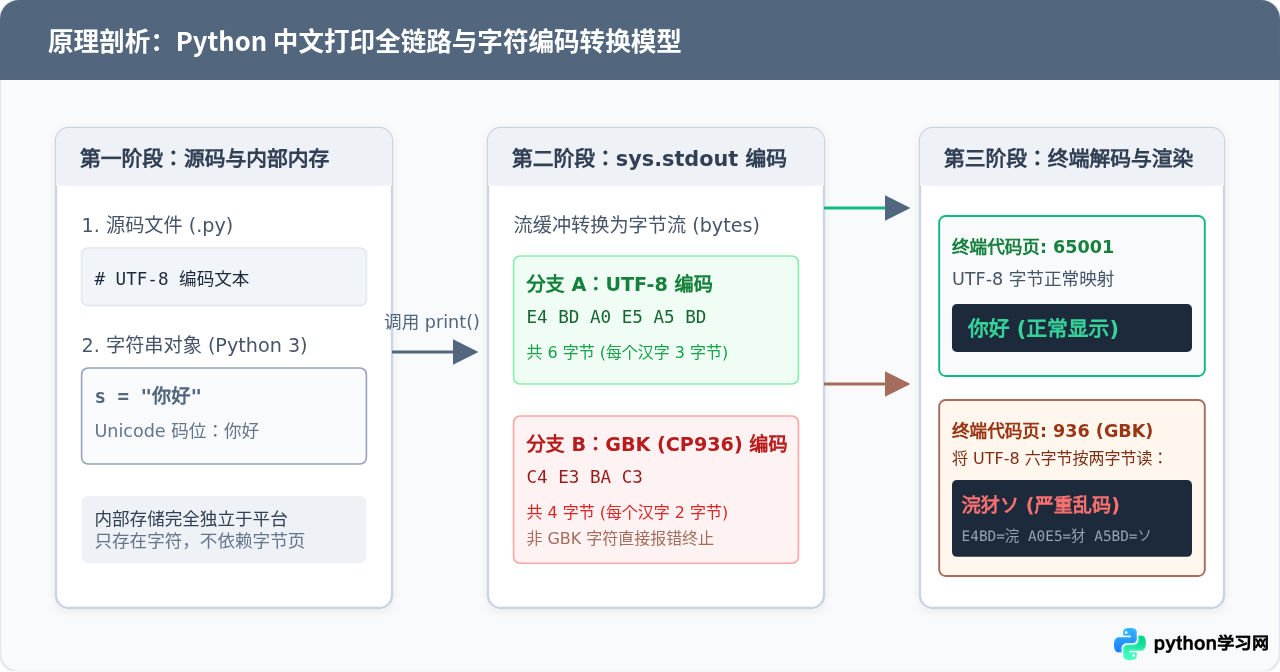
要彻底解决这个问题,需要先厘清 Python 打印字符串时的完整流转路径。在 Python 3 中,所有内存中的字符串(str)都是以无歧义的 Unicode 码位 形式保存的。当调用 print() 函数时,数据并不能直接把抽象的字符扔给屏幕,而是必须经历以下三个环节:
- 内存层: Python 内部维护 Unicode 字符串对象,例如
"你好"对应码位你好。 - 流管道层(sys.stdout): Python 将字符串转换为特定编码的底层字节序列(bytes)。默认情况下,Python 会探测宿主操作系统的终端编码设置。
- 终端显示层: 终端(CMD、PowerShell、Bash 或 IDE 终端)接收到字节序列,依据自己当前激活的代码页(Code Page)去查找字形并渲染。
当第二步与第三步出现脱节时,乱码便不可避免:
- 典型乱码“浣犲ソ”的诞生: Python 以现代标准的 UTF-8 编码输出了 6 个字节:
E4 BD A0 E5 A5 BD;但 Windows 控制台当时处于默认的CP936 (GBK)代码页,GBK 是双字节编码,终端强行将这 6 个字节两两合并解码:E4BD映射为“浣”,A0E5映射为“犲”,A5BD映射为“ソ”,最终拼凑出令人哭笑不得的乱码。 - UnicodeEncodeError 的触发: 若 Python 侦测到底层终端是 GBK,在流管道阶段就会主动尝试把字符编码为 GBK 字节。一旦字符串中包含了 GBK 字符集未收录的冷僻汉字、特殊符号或 Emoji 表情,编码器无法找到对应编码,就会立即抛出异常终止程序。
二、系统化排查:四步锁定乱码根源
遇到中文打印异常,切忌盲目地在代码中胡乱尝试 encode() 和 decode()。请按照以下四个标准步骤逐项排查:
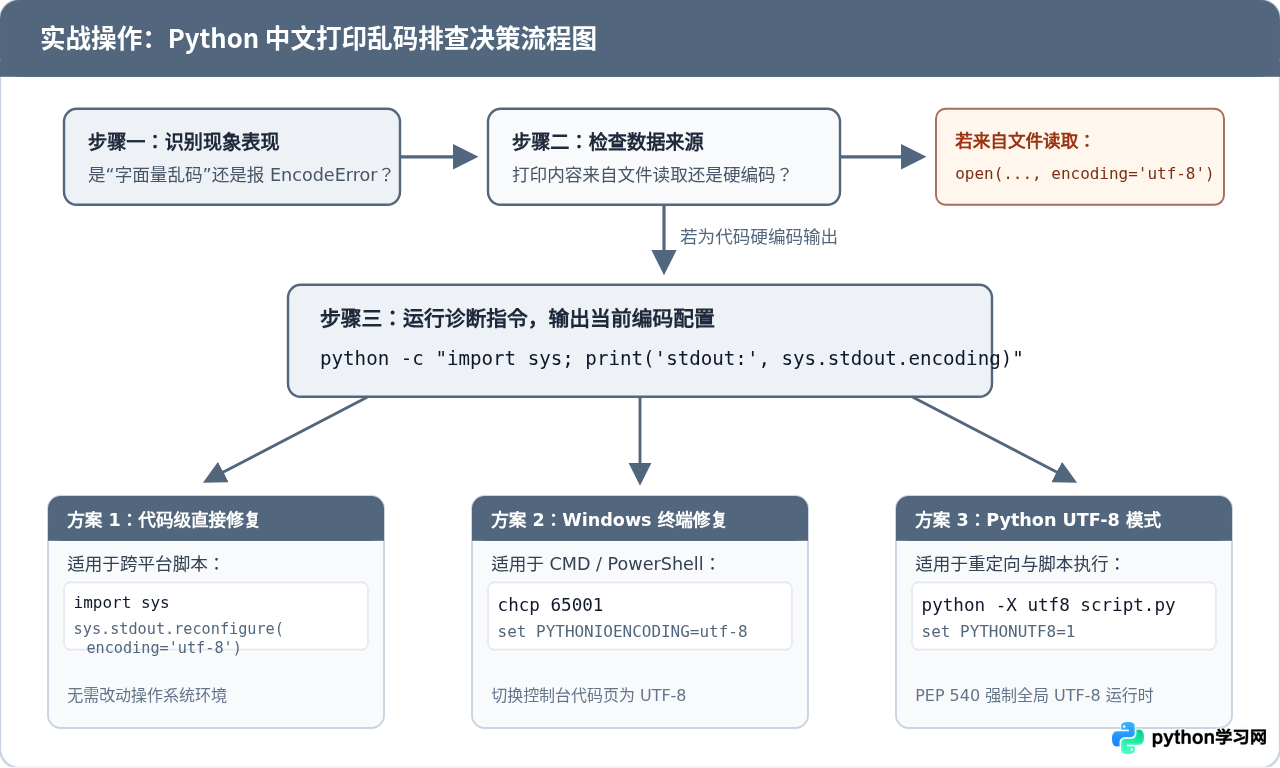
第 1 步:确定问题属于“纯乱码”还是“异常报错”
仔细观察终端输出。如果程序能够正常结束,但文字变成了乱七八糟的乱码,说明编码与解码使用了两套不同的规则;如果程序直接崩溃并伴随 UnicodeEncodeError 或 UnicodeDecodeError,说明存在非法字节输入或无法映射的字符集冲突。
第 2 步:区分打印内容是“代码字面量”还是“外部读取”
在代码中单独打印一行简单的中文测试字面量:
# 隔离测试
print("测试中文直接输出")
如果这行字面量打印正常,只有当你从文本文件、CSV 文件或网络 API 抓取数据并打印时才报错,那么根本原因出在数据输入阶段(如 open() 没有指定正确的编码),而不是 print() 自身。
第 3 步:运行单行诊断命令检查 Python 当前标准流配置
在当前终端中执行以下 Python 诊断指令:
default: utf-8
如果 stdout 显示为 cp936 或 ascii,这就是导致打印报错的直接元凶。
第 4 步:检查 Windows 当前控制台代码页
在 Windows 命令提示符(CMD)中执行:
936 代表简体中文 GBK 代码页,而标准 UTF-8 的代码页代号是 65001。
三、针对不同运行环境的具体解决办法
1. 代码级通用解法(推荐首选):sys.stdout.reconfigure
如果你编写的 Python 脚本需要在多台不同系统或不同配置的电脑上分发运行,最优雅、对外部环境改动最小的方案是在 Python 代码层面主动重置标准输出流的编码。在 Python 3.7 及以上版本中,标准库提供了极其便捷的 reconfigure 方法:
import sys

# 将标准输出和标准错误输出流强制重新配置为 UTF-8
if sys.stdout.encoding.lower() != 'utf-8':
    sys.stdout.reconfigure(encoding='utf-8')
if sys.stderr.encoding.lower() != 'utf-8':
    sys.stderr.reconfigure(encoding='utf-8')

# 此时无论终端处于何种环境,均会以标准的 UTF-8 字节流向外传输
print("中文输出已成功锁定为 UTF-8!")print() 语句或依赖标准输出的第三方库初始化之前完成流重构。
2. 原生 Windows 控制台环境(CMD 与 PowerShell)
在原生 Windows 环境中,无需修改代码,也可以通过控制台命令或环境变量直接完成修复:
方法 A:临时切换活动代码页为 UTF-8
执行该命令后,当前 CMD 窗口将全局以 UTF-8 方式解读流数据。随后运行你的 Python 脚本即可正常显示汉字。
方法 B:设置 PYTHONIOENCODING 环境变量
PYTHONIOENCODING 是 Python 官方提供的标准环境变量,用于显式覆盖 stdin、stdout 和 stderr 的编码:
- 在 CMD 中运行:
set PYTHONIOENCODING=utf-8 - 在 PowerShell 中运行:
$env:PYTHONIOENCODING="utf-8"
3. 使用 Python 3.7+ 官方 UTF-8 模式(PEP 540)
Python 3.7 引入了极具实用价值的 UTF-8 运行模式。在此模式下,Python 会完全忽略操作系统的当前区域设置(Locale),强制全局使用 UTF-8 作为默认编码,并将 sys.stdin 和 sys.stdout 的错误处理器设为 surrogateescape:
若希望在开发机器上全局永久开启该模式,可在系统环境变量中添加 PYTHONUTF8=1。
4. VS Code 与 PyCharm 编辑器内置终端配置
有时候系统控制台打印正常,但在 VS Code 的终端里却出现问号或乱码。这通常是因为集成终端启动时没有正确注入字符集环境变量。
VS Code 解决步骤:
- 按快捷键
Ctrl + ,打开设置,搜索settings.json。 - 在配置项中加入针对 Windows 终端的环境变量注入:
"terminal.integrated.env.windows": { "PYTHONIOENCODING": "utf-8" } - 重启 VS Code 终端后再次运行。
PyCharm 解决步骤:
在菜单栏选择 Run -> Edit Configurations,在 Environment variables 中加入 PYTHONIOENCODING=UTF-8;同时确保在 File -> Settings -> Editor -> File Encodings 中,将 Global Encoding 与 Project Encoding 均统一设置为 UTF-8。
5. 管道重定向场景(python script.py > output.log)
许多运维脚本在交互式终端运行时中文显示完美,但一旦通过定时任务或命令行重定向输出到日志文件(如 python main.py > run.log),程序就会突然报出 UnicodeEncodeError 崩溃。其原因是:当输出流重定向到文件时,Python 会检测到当前不是交互式终端(isatty() 为 False),此时 Python 可能会回退到操作系统默认编码(Windows 下为 GBK)。
对策: 在执行重定向时,务必加上 UTF-8 参数或设置环境变量:
6. 数据读取引起的“连带乱码”
在处理文件读取后打印的场景时,乱码往往发生在 open() 阶段。在 Windows 平台下,若调用 open('data.txt', 'r') 而不指定 encoding 参数,Python 会隐式使用操作系统当前区域编码(GBK)去解读本属于 UTF-8 的文件内容。
# 错误示范:依赖系统隐式编码,在 Windows 上必然翻车
# with open('info.txt', 'r') as f:
#     text = f.read()

# 正确示范:永远显式指定 encoding='utf-8'
with open('info.txt', 'r', encoding='utf-8') as f:
    text = f.read()

# 若文件包含 Windows 记事本自动附带的 UTF-8 签名(BOM 头),使用 'utf-8-sig'
with open('data_with_bom.txt', 'r', encoding='utf-8-sig') as f:
    clean_text = f.read()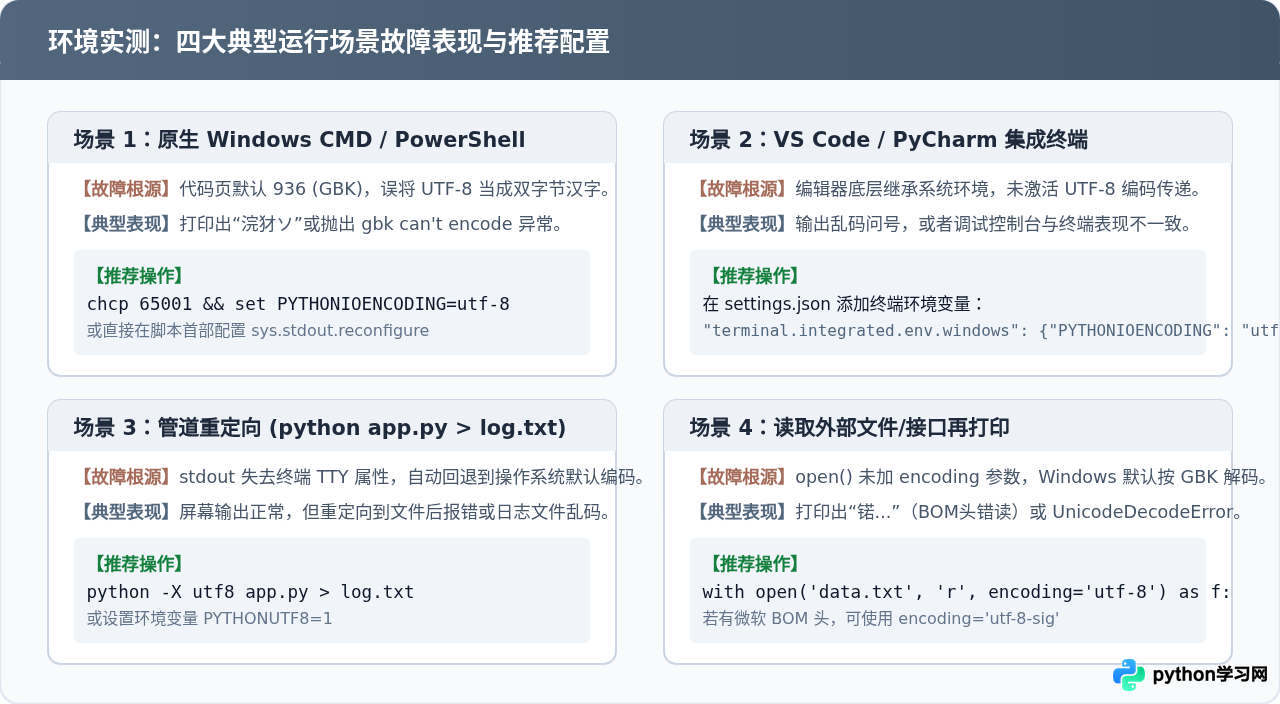
四、预防与总结:避免中文乱码的三条黄金法则
为了在以后的开发中不再为字符编码问题耗费排障时间,请在日常编码习惯中严格遵循以下三条准则:
| 准则维度 | 核心要求 | 实操代码 / 命令推荐 |
|---|---|---|
| 全链路统一 UTF-8 | 消除系统间 GBK/ANSI 夹层,源码、文件、终端统一标准 | chcp 65001 / python -X utf8 |
| 显式声明编码 | 杜绝任何依赖默认编码的隐式行为 | open(..., encoding='utf-8') |
| 流配置代码级兜底 | 在脚本入口重置输出流,确保分发即用 | sys.stdout.reconfigure(encoding='utf-8') |
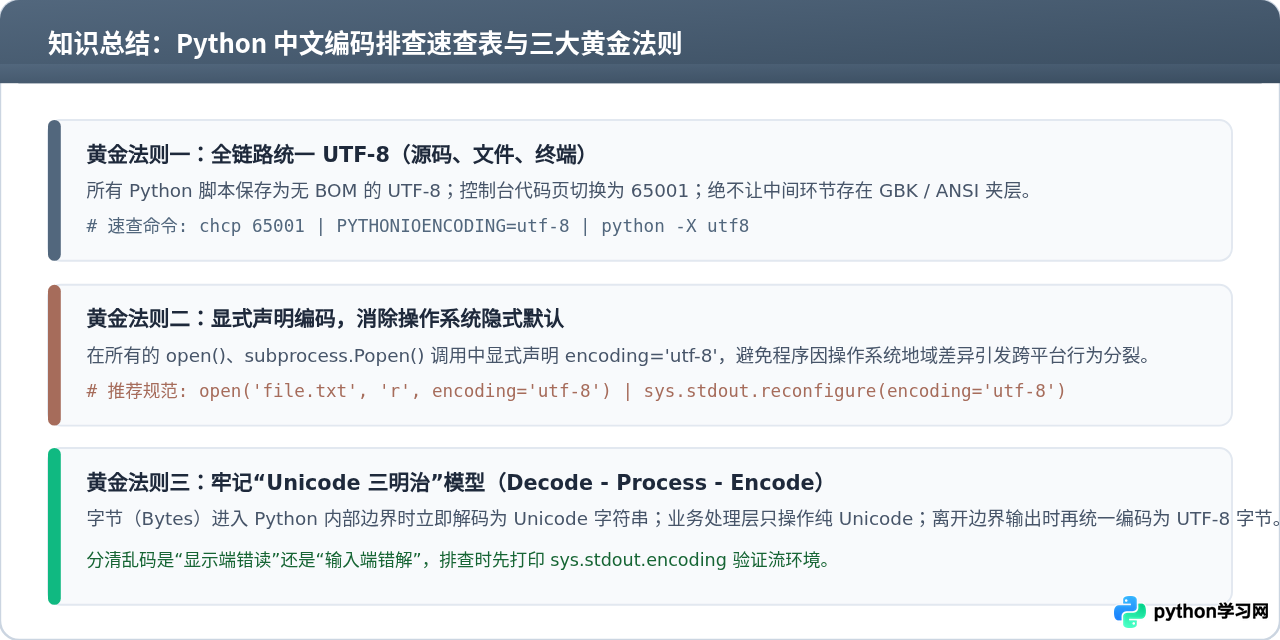
总结来说,Python 打印中文乱码并不是深奥的玄学,而是一道纯粹的“编码转换对应题”。只要牢牢把握数据在进入 Python 内存、流过标准输出管道、抵达终端屏幕这三道关卡的编码形式,遇到问题时按图索骥,便能在任何环境下迅速定位并解决问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















