


怎么回答pandas3.0迁移到生产环境的风险?
详解在技术评审与工程面试中如何系统回答pandas 3.0迁移到生产环境的风险,涵盖显式报错、静默计算结果漂移、上下游生态耦合以及灰度验证落地方案。
回答“pandas 3.0 迁移到生产环境的风险”时,无论是在架构变更评审会还是工程技术面试中,最忌讳的做法是零散地背诵更新日志。稳妥且有说服力的回答方式是按“故障可观测性”将风险拆分为三个层级:容易拦截的显式接口报错、极易漏检的静默数据结果漂移、以及上下游二进制与 Schema 契约断裂,并紧接着给出“在 pandas 2.2/2.3 开启未来特性开关预检 + 影子流量结果比对”的落地方案。本文先拆解回答该问题的标准表达框架,再逐项讲清核心风险点的触发代码、排查方法与上线验证流程。
一、回答框架:用“风险分级 + 控制闭环”代替罗列更新项
当评审人或面试官提问迁移风险时,对方真正关心的是两个问题:你是否清楚哪些改动会让线上任务直接挂掉,更关键的是,你是否知道哪些改动不会报错但会悄悄算错账或写坏下游表。因此,开篇应先给出结构化结论,再展开技术细节。
可直接复用的两分钟核心回答口径:
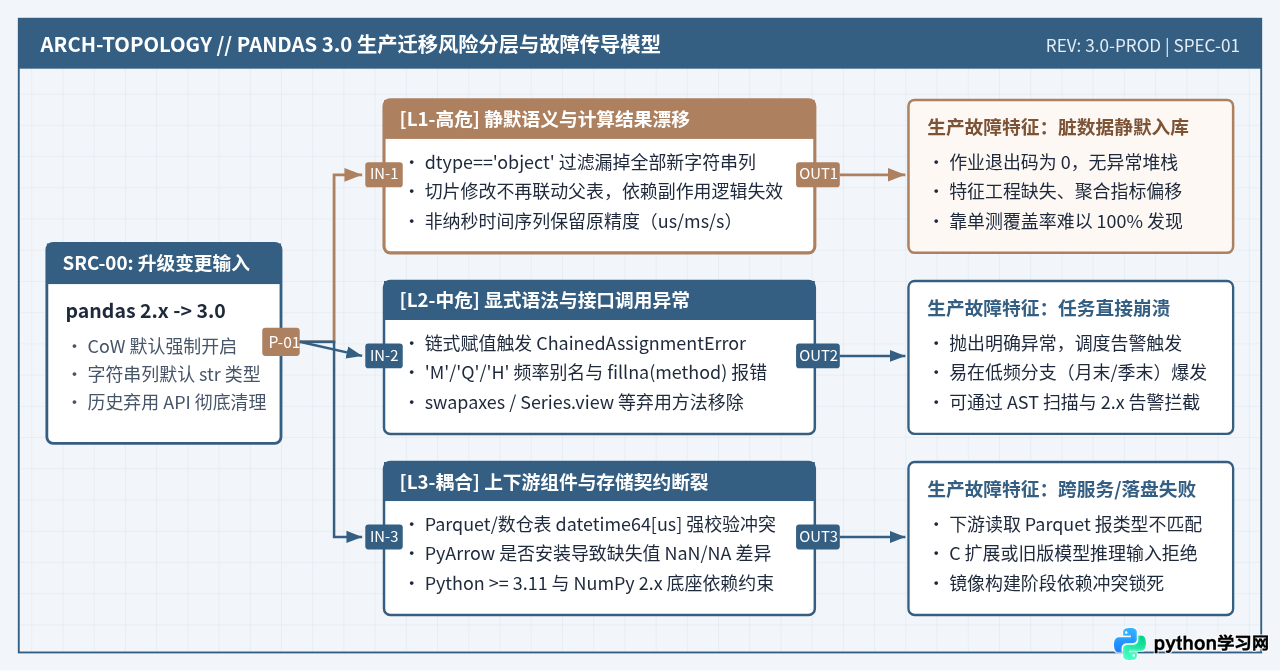
“评估 pandas 3.0 迁移到生产环境的风险,我通常会按影响程度分成三类,并配套渐进式验证:第一类是静默语义与类型漂移风险,这是生产最危险的部分,包括 Copy-on-Write(写时复制)全面强制生效导致部分隐式引用修改失效、字符串列默认不再是 object 而是专用 str 类型导致基于 dtype == 'object' 的清洗分支被跳过、以及时间精度不再强制转为纳秒(ns);第二类是显式接口中断风险,例如链式赋值直接抛出 ChainedAssignmentError、旧周期别名(如 'M'、'H')和 fillna(method=...) 被彻底移除;第三类是上下游生态耦合风险,主要是 PyArrow 依赖行为、Parquet/数据库落盘 Schema 精度变化以及科学计算库对新类型的兼容。工程落地时,我们不会直接把线上镜像升到 3.0,而是先在 pandas 2.2/2.3 环境中开启 future.infer_string 和 mode.copy_on_write 跑通回归,通过影子比对确认输出哈希与 Schema 完全一致后,再切入灰度发布。”
先抛出这个全景分类,能够立刻体现出你区分了“报错停机”与“脏数据入库”的严重程度差异。下图展示了回答该问题时的三维风险拓扑与生产影响路径。
二、核心风险拆解:哪些改动会导致生产故障?
把框架立住之后,需要针对上述三个层级各举出 1 到 2 个最典型的代码级诱因。回答时讲清楚“以前怎么写、3.0 变成了什么样、为什么在生产环境危险”,能体现扎实的工程经验。
1. Copy-on-Write(写时复制)强制生效:链式赋值报错与引用副作用消失
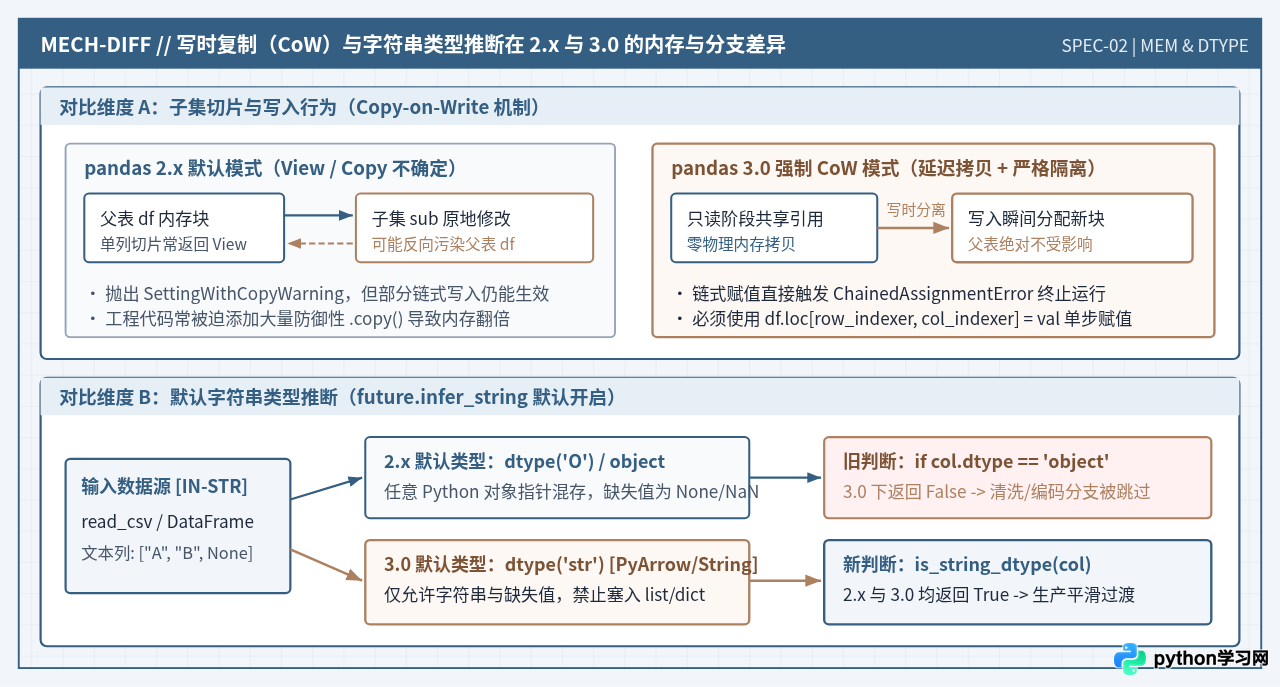
在 pandas 3.0 中,写时复制(Copy-on-Write,简称 CoW)成为唯一且默认开启的行为模式,原有的 mode.copy_on_write 配置项被弃用。CoW 的核心规则只有一条:任何索引切片或子集选择操作,在行为上都表现为一个独立的副本(底层共享内存直到发生写入),修改子集绝对不会影响原始 DataFrame,反之亦然。
这在生产环境中会引发两类问题。第一类是显式的链式赋值直接报错中断,例如 df[df["score"] < 60]["status"] = "fail" 在 pandas 3.0 中由于先生成临时子集再对其赋值,不会修改原表,并直接抛出 ChainedAssignmentError。第二类更隐蔽:历史代码里有人利用了“先取切片赋给变量,修改该变量顺便联动更新原表”的副作用,在 3.0 中这段代码不会报错,但原表数据不再被更新。
# 执行环境:Python 3.11+ / pandas 3.0+
import pandas as pd

df = pd.DataFrame({
    "order_id": [101, 102, 103],
    "amount": [200.0, -50.0, 320.0]
})

# 风险场景 A:依赖切片引用副作用修改原表(静默失效!)
sub_view = df["amount"]
# 在旧版本中,如果 sub_view 是视图,原地修改可能传导回 df
# 在 pandas 3.0 中,CoW 触发写时复制,df["amount"] 保持原样不变

# 风险场景 B:链式赋值(直接抛出 ChainedAssignmentError)
# 错误写法:df[df["amount"] < 0]["amount"] = 0.0

# 正确写法:统一收敛为单步 .loc 明确写入
df.loc[df["amount"] < 0, "amount"] = 0.0
print(df)df = df.copy() 不再立即复制物理内存,只有在真正修改数据时才按列拷贝,因此升级后内存峰值通常会下降,但前提是清理掉所有链式原地修改(如 df["col"].fillna(0, inplace=True) 应改为 df["col"] = df["col"].fillna(0))。
2. 默认字符串类型(String Dtype)变更:类型判断分支静默漏检
这是生产迁移中最容易造成静默业务逻辑错误的改动。在 pandas 2.x 及更早版本中,读取 CSV、JSON 或字典生成的文本列,默认类型是 object。而在 pandas 3.0 中,字符串列默认推断为专用的 str 类型(当环境安装了 PyArrow 时底层由 Arrow 字符串数组支撑,未安装时回退为 Python 字符串专属类型,但 dtype 名称不再是 object)。
生产环境中有大量特征工程、数据脱敏、空值清洗或通用序列化代码,习惯通过 df[col].dtype == "object" 或 df.select_dtypes(include="object") 来筛选文本列。升到 pandas 3.0 后,这些条件会返回空结果,导致文本清洗、去空格、类别编码逻辑被整段跳过,而程序不报任何异常。
# 对比演示:pandas 3.0 中字符串列检测的失效与兼容写法
import pandas as pd
from pandas.api.types import is_string_dtype, is_object_dtype

df = pd.DataFrame({
    "user_name": [" Alice ", "Bob ", None],
    "age": [25, 31, 28]
})

# 危险写法:在 pandas 3.0 中,df["user_name"].dtype 为 'str',不再等于 'object'
legacy_str_cols = [c for c in df.columns if df[c].dtype == "object"]
print("旧写法识别到的文本列:", legacy_str_cols)

# 兼容 2.x 与 3.0 的稳健写法 1:使用 pandas 类型判断 API
safe_str_cols = [c for c in df.columns if is_string_dtype(df[c])]
print("API 识别到的文本列:", safe_str_cols)

# 兼容 2.x 与 3.0 的稳健写法 2:select_dtypes 同时包含 object 与 "str" / "string"
selected_cols = df.select_dtypes(include=["object", "string"]).columns.tolist()
print("select_dtypes 识别到的文本列:", selected_cols)下图对比了 Copy-on-Write 与默认字符串类型推断在 2.x 与 3.0 之间的底层行为变化,可以直接作为讲解原理时的参考依据。
3. 时间序列精度保留与频率别名废弃:Parquet 契约冲突与定时任务报错
在时间处理上,pandas 3.0 有两处直接影响生产批处理任务的改动:
- 非纳秒时间精度保留(Resolution Inference):以前 pandas 会强制把所有输入的日期时间转换为纳秒精度(
datetime64[ns])。在 pandas 3.0 中,从字符串、Pythondatetime对象或 NumPy 数组解析时间时,默认推断为微秒(datetime64[us])或保留输入本身的精度(如秒s、毫秒ms)。这虽然解决了datetime64[ns]无法表示公元 1677 年以前或 2262 年以后日期的限制,但如果生产环境采取“计算写出 Parquet 分区文件,再由 Hive/Spark/ClickHouse 外部表加载”的架构,或者代码里写了硬编码的df["ts"].astype("int64") // 10**9来换算秒级时间戳,精度从ns变成us会导致换算出来的秒数缩小 1000 倍,或者触发下游外部表的 Schema 校验报错。 - 旧版频率别名与填充参数彻底移除:在 2.2 版本标记弃用的周期频率别名(如月末
'M'、季末'Q'、年末'Y'、小时'H'、分钟'T'、秒'S')在 3.0 中直接抛出ValueError,必须替换为显式的'ME'、'QE'、'YE'、'h'、'min'、's'。同时,df.fillna(method="ffill")已移除,必须改调df.ffill()或df.bfill()。这类风险的特点是平时日跑任务不触发,一到月末、季末重采样报表任务才突然崩溃。
# 时间戳换算与重采样在 pandas 3.0 中的避坑写法
import pandas as pd

s = pd.to_datetime(["2026-03-31 12:00:00", "2026-04-30 18:30:00"])
df_ts = pd.DataFrame({"event_time": s, "val": [10, 20]})

# 风险写法:直接 view/astype 为 int64 并除以 10**9(若底层为 datetime64[us],结果将错乱 1000 倍!)
# 稳健写法:先显式指定到秒或纳秒精度,或使用 .dt.total_seconds()
epoch_seconds = (df_ts["event_time"] - pd.Timestamp("1970-01-01")) // pd.Timedelta("1s")
print("稳健计算秒级时间戳:", epoch_seconds.tolist())

# 重采样频率别名:将旧版 'M' 替换为 'ME'(Month End)
monthly = df_ts.set_index("event_time").resample("ME").sum()
print("按月末重采样结果:\n", monthly)4. 上下游依赖与分组默认参数(如 observed=True)
如果生产环境大量使用 Categorical(分类类型)列做分组聚合,还必须在回答中提及 groupby 的默认值变更:当对分类列执行 df.groupby("cat_col") 时,observed 参数默认值已由 False 改为 True。这意味着当前数据批次中未出现的枚举类别,不再以全 0 或 NaN 行的形式出现在聚合结果中。如果下游报表或特征宽表依赖固定行数的全量枚举笛卡尔积,升级后输出行数会动态缩减,必须显式补上 df.groupby("cat_col", observed=False)。
在运行环境底座上,pandas 3.0 要求 Python 版本不低于 3.11,并深度适配 NumPy 2.x 与 PyArrow。如果生产容器基础镜像仍停留在 Python 3.9 或 3.10,迁移就不只是升级一个 pip 包,而是涉及基础镜像、C 扩展重编译以及 scikit-learn、LightGBM、SQLAlchemy 等上下游包协同升级的系统工程。
| 风险类别 | pandas 2.x 历史行为 | pandas 3.0 变更后行为 | 生产故障形态 | 标准修复与防御措施 |
|---|---|---|---|---|
| 写时复制 (CoW) | 切片可能是视图也可能是副本;链式赋值发出警告但可能生效 | 全面强制 CoW;修改子集绝不改动父表;链式赋值直接报错 | ChainedAssignmentError 停机,或依赖引用修改的逻辑静默失效 |
统一改用 df.loc[mask, col] = val;移除对切片的 inplace=True |
| 默认字符串类型 | 文本列默认存储为 object 类型 |
默认推断为 str 类型(优先使用 PyArrow 后端) |
dtype == 'object' 判断全部返回 False,清洗逻辑被漏掉 |
改用 is_string_dtype() 或 select_dtypes(include=['object', 'string']) |
| 时间精度推断 | 默认强制转换为纳秒 datetime64[ns] |
根据输入保留精度,常见输入推断为微秒 datetime64[us] |
除以 10**9 算错时间戳;Parquet 写入下游数仓报 Schema 类型冲突 |
换算时间戳统一用 pd.Timedelta('1s');落盘前显式 .astype('datetime64[ns]') 或用 use_nullable_dtypes 对齐 |
| 频率别名与 API 清理 | 支持 'M'、'H'、fillna(method='ffill') 等并抛出弃用警告 |
彻底移除旧别名与旧参数,调用即抛异常 | 月度/小时级定时调度作业在特定时间窗口突然报错失败 | 全局替换为 'ME'、'h'、.ffill()、.bfill() |
| 分类数据分组 | groupby 中 observed 历史默认曾为 False |
observed=True 成为固定默认行为,仅返回实际出现的类别 |
聚合表行数变少,下游按固定行数拼接或透视时产生错位 | 在所有涉及 Categorical 的分组处显式声明 observed=True/False |
三、实操步骤:如何在不中断生产的前提下完成迁移验证?
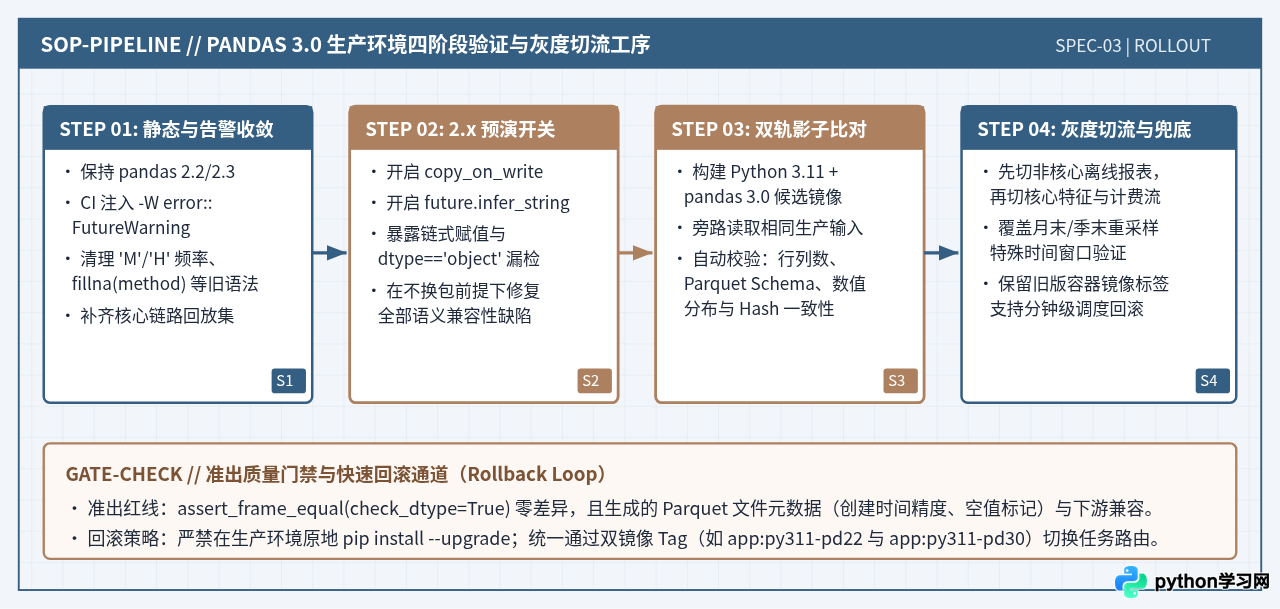
回答完风险点后,紧接着说明“怎么把风险关进笼子里”,是区分普通开发者与资深工程师的关键。pandas 官方专门在 2.2 和 2.3 版本中提供了过渡开关,使团队无需直接安装 3.0 就能在现有生产镜像中提前暴露 90% 以上的兼容性问题。以下是标准的四步迁移操作流程。
步骤 1:在 pandas 2.2/2.3 环境中将 FutureWarning 升级为异常
不要直接在生产或测试分支把依赖改成 pandas>=3.0.0。先确保当前环境运行在 pandas 2.2 或 2.3,在 CI 测试流水线或预发回放脚本启动入口处,把 pandas 抛出的弃用警告(FutureWarning 和 DeprecationWarning)提升为阻断异常。这一步能一次性揪出所有 'M' 频率别名、fillna(method=...) 和未显式传参的 groupby(observed=...)。
# 在测试入口 conftest.py 或预发启动脚本顶部加入以下代码
import warnings
import pandas as pd

# 将 pandas 相关的未来不兼容警告全部转为显式报错,强制在上线前修复
warnings.filterwarnings("error", category=FutureWarning)
warnings.filterwarnings("error", category=DeprecationWarning)
步骤 2:在 pandas 2.x 中开启 3.0 预演开关(最关键的排雷手段)
清理完语法级警告后,依然保持在 pandas 2.2/2.3 环境,在程序初始化配置中打开两个 3.0 行为预演开关:mode.copy_on_write 和 future.infer_string。这样无需升级底座包,就能让现有代码直接运行在 CoW 和新字符串类型规则下。
# 在 pandas 2.2 / 2.3 的预发或灰度任务入口配置预演开关
import pandas as pd

# 1. 提前激活写时复制(等同于 pandas 3.0 默认行为)
pd.set_option("mode.copy_on_write", True)

# 2. 提前激活新字符串类型推断(要求环境已安装 pyarrow)
pd.set_option("future.infer_string", True)

# 随后执行业务 ETL 或特征计算主函数
# run_daily_feature_pipeline()pd.set_option 会收到选项已弃用的提示。如果同一套代码需要在过渡期同时兼容 2.x 与 3.0 两个镜像,可以用版本判断包裹:if int(pd.__version__.split(".")[0]) < 3:。
步骤 3:编写影子比对脚本校验输出数值与落盘 Schema
对于核心计费、风控特征或财务报表任务,单靠单元测试通过还不够。稳妥的做法是抽取线上真实的一天或一周输入样本,分别用旧版镜像(pandas 2.x)和新版候选镜像(pandas 3.0)各跑一份输出文件,再用校验脚本比对两份结果的列名、物理数据类型(特别是时间戳精度与字符串类型)、缺失值分布以及浮点误差范围内的数值一致性。
# shadow_diff_check.py:用于比对 2.x 基准结果与 3.0 候选结果的验收脚本
import pandas as pd
from pandas.testing import assert_frame_equal

def verify_migration_outputs(baseline_parquet: str, candidate_parquet: str) -> None:
    df_base = pd.read_parquet(baseline_parquet)
    df_cand = pd.read_parquet(candidate_parquet)

    print("=== 1. 检查行列维度 ===")
    assert df_base.shape == df_cand.shape, f"维度不一致: {df_base.shape} vs {df_cand.shape}"
    print(f"维度校验通过: {df_cand.shape}")

    print("=== 2. 检查各列物理 Dtype 差异 ===")
    for col in df_base.columns:
        b_dtype, c_dtype = str(df_base[col].dtype), str(df_cand[col].dtype)
        if b_dtype != c_dtype:
            print(f"[需确认] 列 '{col}' 类型变化: {b_dtype} -> {c_dtype}")

    print("=== 3. 检查数值与内容一致性(允许字符串新旧类型映射) ===")
    # check_dtype=False 用于排除 object 与 str 名字差异,重点核对实际单元值与空值位置
    assert_frame_equal(
        df_base,
        df_cand,
        check_dtype=False,
        check_exact=False,
        rtol=1e-6,
        atol=1e-8
    )
    print("结论:数据内容与数值精度 100% 校验通过!")

if __name__ == "__main__":
    # 演示自测:构造两份模拟落盘数据验证脚本工作正常
    df1 = pd.DataFrame({"id": [1, 2], "name": ["a", "b"], "val": [1.0000001, 2.5]})
    df2 = pd.DataFrame({"id": [1, 2], "name": pd.Series(["a", "b"], dtype="string"), "val": [1.0000002, 2.5]})
    assert_frame_equal(df1, df2, check_dtype=False, check_exact=False, rtol=1e-5)
print("自测通过:影子比对逻辑可正常识别并校验跨版本 DataFrame。")在运行上述脚本时,如果第 2 步打印出某个时间列从 datetime64[ns] 变成了 datetime64[us],就需要立即去核对下游读取该 Parquet 文件的引擎(如旧版 Spark、Impala 或 C++ 推理服务)是否支持微秒级时间戳。如果下游只认纳秒,需在写出前显式转换:df["ts"] = df["ts"].astype("datetime64[ns]")。
四、针对不同提问场景的回答侧重点与速查总结
在实际沟通中,提问者的身份决定了你应该把篇幅放在哪一部分。下图整理了回答逻辑的全景速查卡,将技术风险点、排查手段与上线门禁汇总为一张工程蓝图。
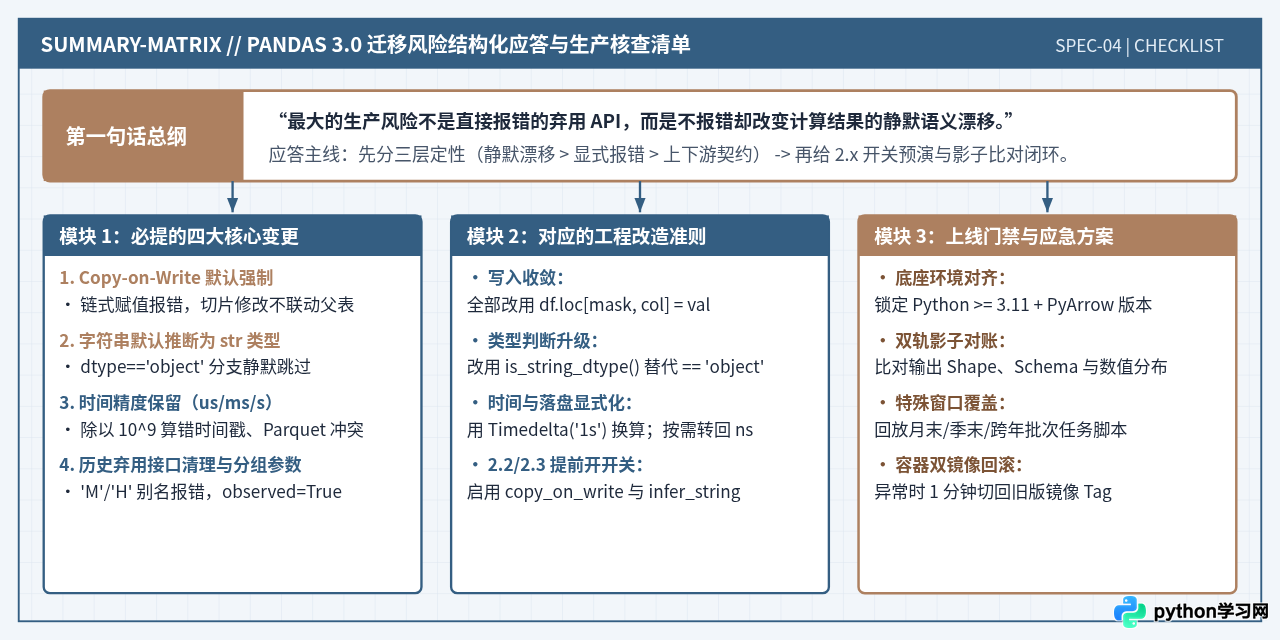
根据提问场景的不同,可以在这套框架上微调表达重心:
- 在技术面试中回答:重点讲透 Copy-on-Write 的内存机制与链式赋值为什么失效,以及
dtype == 'object'为什么会导致特征清洗漏检。这两个点能直接证明你理解 pandas 3.0 的底层重构逻辑,而不是死记硬背 API 名字。最后补上一句“我们会先在 2.2 开启mode.copy_on_write和future.infer_string做预演”,面试得分就会非常完整。 - 在团队内部变更评审会上回答:重点放在“下游契约影响与回滚成本”。主动说明新版本对 Parquet 时间精度(
us与ns)、缺失值语义以及基础镜像(Python 3.11+)的要求,并展示影子比对脚本的校验结果和容器镜像分钟级回滚预案,消除业务方和 SRE 对线上数据质量的顾虑。
五、常见追问与补充注意事项
追问 1:如果生产环境没有安装 PyArrow,升到 pandas 3.0 会报错吗?
不会报错,但会产生行为差异风险。在 pandas 3.0 中,PyArrow 属于强烈推荐的可选依赖而非硬性强制依赖:当环境安装了 PyArrow 时,新的 str 类型底层使用高吞吐、低内存的 Arrow 连续内存块;若未安装 PyArrow,pandas 会自动回退为基于 Python 对象的字符串数组(对外 dtype 依然显示为 str)。最大的隐患在于开发环境装了 PyArrow 而生产精简镜像没装,或者反过来,导致两边的内存占用、大文本正则处理速度以及边界缺失值表现不一致。因此生产迁移时,应当在 requirements.txt 或 pyproject.toml 中显式固定 pyarrow 的版本号。
追问 2:升级到 pandas 3.0 后,原本到处写的 .copy() 需要全部删掉吗?
不需要为了迁移而强行批量删除已有的 .copy()。在 CoW 机制下,调用 df.copy() 只是创建一个共享底层数据块的浅层惰性引用,并不会像 2.x 那样立刻触发全表物理内存复制,因此保留原有的 .copy() 既不会破坏代码正确性,也不会带来明显的额外内存开销。迁移期的精力应集中在修复链式赋值(df[a][b] = c)和移除序列上的原地修改(inplace=True),待系统稳定运行后再在日常重构中逐步简化冗余的 .copy() 调用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















