


Python中为什么不能用MD5存储密码
深入解析在Python中为什么绝对不能使用MD5存储密码。从设计初衷、计算速度、彩虹表与碰撞缺陷切入,揭示简单加盐的局限性,并提供bcrypt、Argon2及标准库安全哈希的完整Python实战方案。
一、设计初衷的错位:为什么“快”反而是密码哈希的灾难
很多初学者接触哈希算法时,最先在Python标准库中见到的就是 hashlib.md5()。由于调用直观、输出固定为32位十六进制字符串,且具有单向不可逆的数学特性,很多人顺理成章地将其当作密码加密工具使用:
import hashlib

# 典型的不安全示例:直接使用 MD5 存储密码
password = "user_password_2026"
hash_val = hashlib.md5(password.encode("utf-8")).hexdigest()
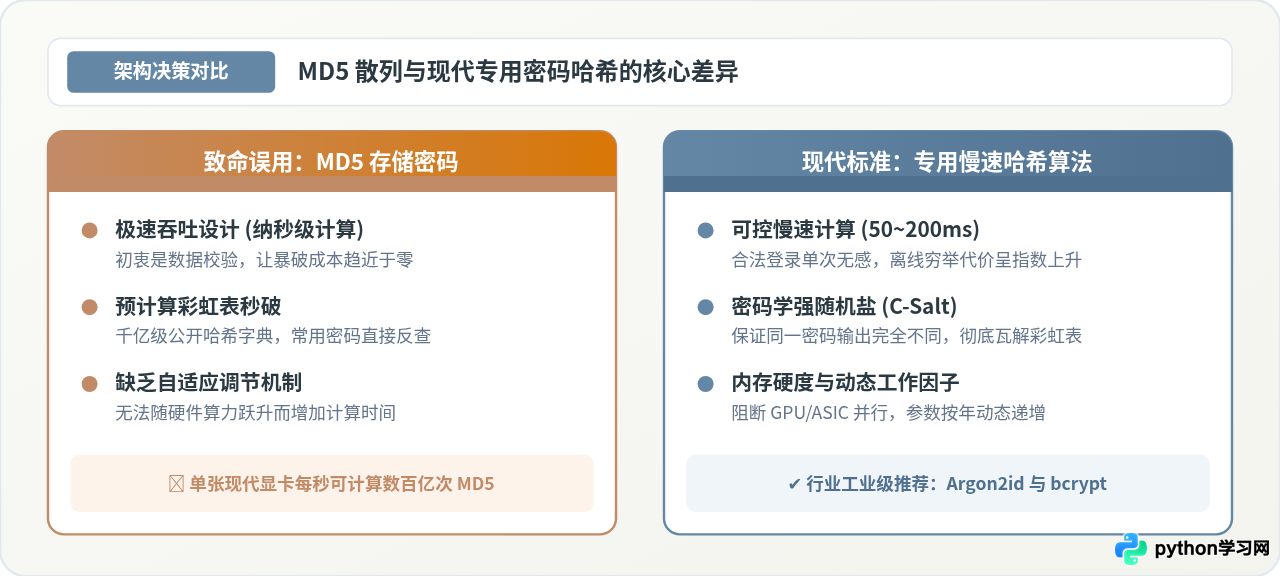
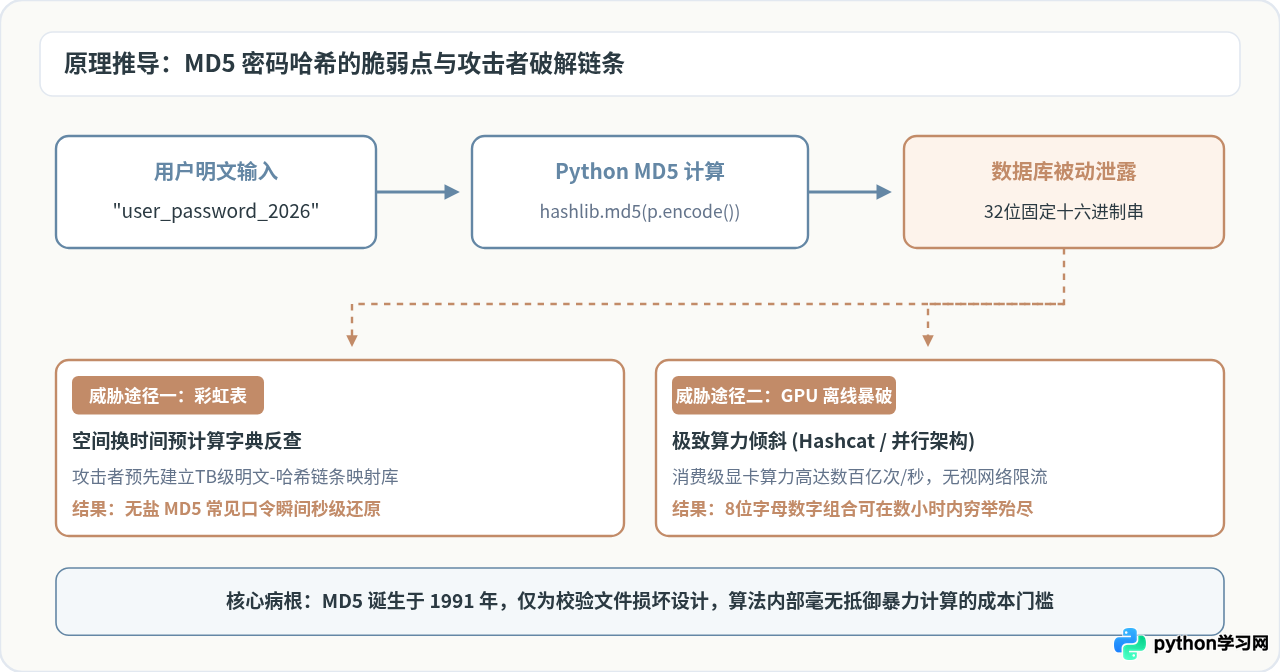
# 输出: 3a7f858... 存入数据库这种做法的问题不在于Python语言本身,而在于MD5算法的设计初衷与密码安全需求的根本对立。MD5(Message-Digest Algorithm 5)由罗纳德·李维斯特(Ronald Rivest)于1991年提出,其核心目标是在极短时间内生成一段数据的校验指纹(Checksum),用于校验网络传输中文件是否损坏或被误修改。因此,MD5追求的是极致的运算效率与极低的CPU开销。
然而,密码安全存储所追求的属性恰恰相反。系统需要满足两个看似矛盾的条件:
- 对正常登录用户友好:单次密码验证耗时50毫秒到200毫秒之间,用户在界面交互上毫无卡顿感。
- 对离线攻击者极度昂贵:攻击者哪怕掌握了泄露的哈希数据库,想要通过离线猜测明文,每尝试一次都要付出数千万倍于MD5的运算成本。
当开发者使用MD5处理密码时,算法的高速特性完全转化成了攻击者的武器。单台配备主流消费级显卡(如RTX 4090)的设备,利用优化后的CUDA核心每秒可执行超过1500亿次(150 GH/s)的MD5哈希运算。这意味着8位以内的纯数字密码可在数毫秒内被瞬间跑完,哪怕包含字母与数字组合,也只需几小时即可穷举完毕。
二、彩虹表与碰撞:让MD5防线全面崩溃的双重打击
除了高速运算带来的离线暴破风险,未加盐的MD5还面临着两个致命的密码学打击:预计算彩虹表与哈希碰撞漏洞。
1. 彩虹表(Rainbow Table)实现秒级逆向查表
由于MD5是确定性函数,相同的字符串必然产生相同的哈希值(例如 123456 的MD5永远是 e10adc3949ba59abbe56e057f20f883e)。安全研究者和黑客组织早在数十年前就开始预先计算海量常用口令与字典组合的哈希值,并利用特殊数学压缩算法整理成“彩虹表”。
一旦数据库泄露且密码使用纯MD5存储,攻击者甚至不需要开动显卡穷举,直接将泄露的哈希字符串作为键输入公开的在线反查库或本地彩虹表,只需一次常数级时间复杂度的查询(O(1))即可在几毫秒内秒级还原密码明文。
2. 碰撞攻击彻底摧毁抗伪造信任
在密码学中,“抗碰撞性”(Collision Resistance)是指极难找到两个内容不同的明文输入 $M_1 eq M_2$,使得它们的散列值相同 $H(M_1) = H(M_2)$。早在2004年,中国密码学家王小云教授团队就提出了针对MD5的高效碰撞攻击方法。现代计算设备可以在几十秒甚至几毫秒内构造出碰撞对。MD5不仅丧失了抗原像性,也彻底失去了作为可信密码学摘要的资格。
三、常见防范误区:为什么“加盐MD5”依然不堪一击
许多开发者意识到彩虹表反查的危险后,会尝试使用“加盐(Salt)”来弥补缺陷,写出类似如下的代码:
import hashlib

# 常见的加盐自救写法
salt = "my_custom_secret_salt_2026"
password = "user_password_2026"

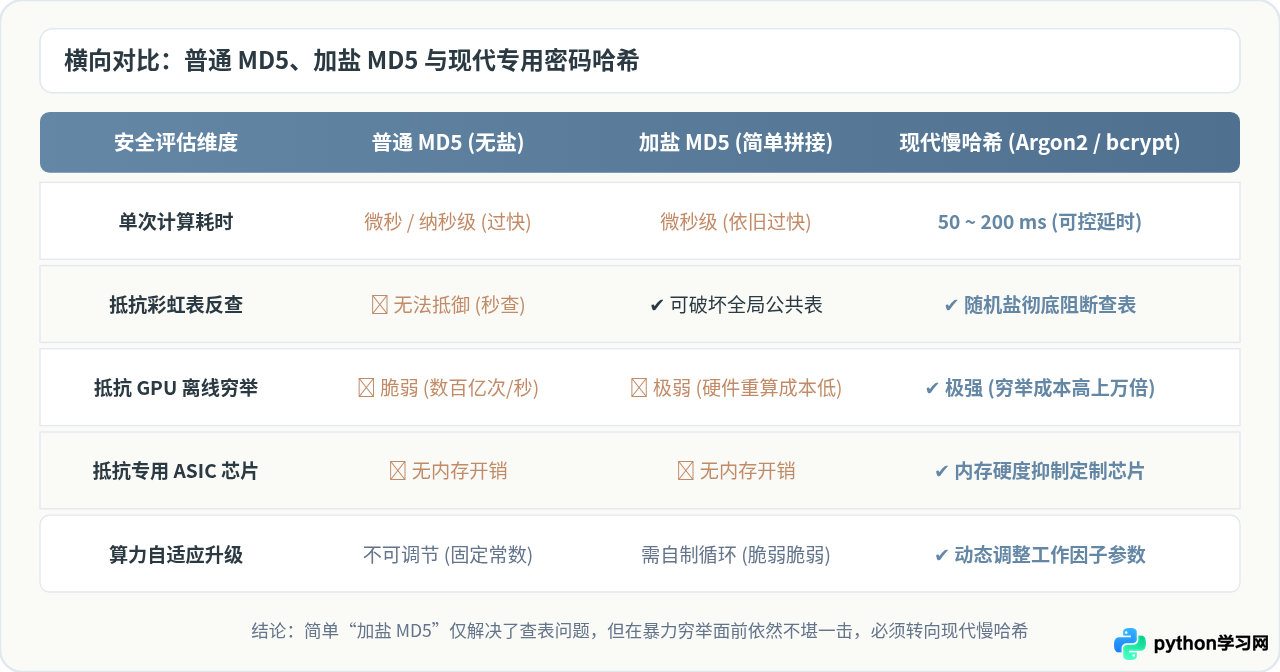
salted_hash = hashlib.md5((salt + password).encode("utf-8")).hexdigest()加盐确实产生了一个正面效果:它改变了输入串的前缀或后缀,破坏了原有的固定对应关系,从而使网络上公开下载的通用彩虹表彻底失效。因为攻击者的预计算字典中并没有包含 my_custom_secret_salt_2026 + 123456 这样的复合字符串。
更关键的是,现代硬件针对特定盐进行重算的速度依然在每秒数十亿次(GH/s)量级。只要明文密码本身的熵值有限(例如用户习惯使用的8~12位常见词汇加数字组合),在专用攻击集群面前依然撑不过一天。此外,部分开发者尝试通过多次嵌套循环哈希(例如 for _ in range(1000): p = md5(p))来人为加慢速度,这种非标准做法缺乏数学证明,容易产生意外的安全收敛,且无法抗衡定制硬件的算力倾斜。
四、安全密码存储的核心机制:慢速哈希与内存硬度
既然简单的哈希与加盐都无法抵挡硬件算力,现代密码学是如何保护密码的?核心答案在于“人为可调节的计算成本”与“硬件架构压制”。
1. 密码学强随机盐(Cryptographic Salt)
合规的密码加盐必须满足两个条件:每个用户独一无二且由密码学安全伪随机源生成。如果全站共用同一个静态“全局盐”,一旦泄露,攻击者只需针对该全局盐生成一次定制彩虹表,即可批量破解全站用户的哈希。使用动态独立盐可以迫使攻击者必须对数据库中的每一个用户哈希分别单独暴破,无法复用任何算力。
2. 可调节的工作因子(Cost Factor / Iterations)
现代算法允许开发者显式指定计算迭代轮数(如bcrypt的 cost=12,即 $2^{12}=4096$ 次内部状态迭代)。这被称为“自适应算法”:随着摩尔定律推动GPU性能翻倍,开发者无需修改业务逻辑或重构数据库结构,只需将工作因子从12调高至13或14,即可将计算耗时成倍增加,始终把攻击成本压制在不可接受的区间。
3. 内存硬度(Memory Hardness)遏制专用芯片
GPU和ASIC矿机之所以在暴破MD5时拥有成千上万倍的优势,是因为它们拥有极高并发但每个核心仅有极小的板载缓存。像 Argon2id 和 scrypt 这类现代算法引入了“内存硬度”,在计算单次哈希时强制分配数兆甚至数十兆字节(例如 64MB)的活动内存空间,并在其中频繁进行伪随机读写。这使得GPU的片上显存迅速被占满、并发度急剧下跌,从而彻底剥夺了专用硬件的大规模并行算力优势。
五、Python中的正确实现方式与完整代码
在Python实际工程中,推荐根据运行环境依赖要求选择以下三种标准方案之一:
方案一:工业界标配——使用 bcrypt(推荐主流方案)
bcrypt 是目前工业界生产环境最普及的方案。它自动处理高强度随机盐的生成,并将算法版本、计算轮数(Cost)、随机盐和哈希结果序列化为一个紧凑的字符串,存入数据库一个字段即可,极简且健壮。
import bcrypt

# 1. 注册/修改密码:生成高安全哈希值
def hash_password(plain_password: str) -> str:
    # 密码转为 UTF-8 字节流
    password_bytes = plain_password.encode('utf-8')
    # 自动生成随机盐,rounds=12 表示 2^12 次迭代运算
    salt = bcrypt.gensalt(rounds=12)
    # 计算哈希
    hashed_bytes = bcrypt.hashpw(password_bytes, salt)
    # 转为 UTF-8 字符串存储在数据库的单一 VARCHAR 字段中
    return hashed_bytes.decode('utf-8')

# 2. 登录验证:校验用户输入的密码是否匹配
def verify_password(plain_password: str, hashed_str: str) -> bool:
    password_bytes = plain_password.encode('utf-8')
    hashed_bytes = hashed_str.encode('utf-8')
    # checkpw 会自动从 hashed_bytes 头部提取出原始的 salt 和 rounds 参数进行计算
    # 且内部使用恒定时间比较函数,免疫时序攻击
    return bcrypt.checkpw(password_bytes, hashed_bytes)

# 示例执行与验证
if __name__ == "__main__":
    raw_input = "Secret_Pass_2026!"
    stored_hash = hash_password(raw_input)
    print("生成的标准存储哈希:", stored_hash)

    # 验证正确口令
    is_valid = verify_password(raw_input, stored_hash)
    print("正确密码验证结果:", is_valid)

    # 验证错误口令
    is_wrong = verify_password("WrongPassword!", stored_hash)
print("错误密码验证结果:", is_wrong)正确密码验证结果: True
错误密码验证结果: False
方案二:现代密码学首选——使用 argon2-cffi
Argon2是2015年密码哈希竞赛(Password Hashing Competition)的官方获胜算法,也是目前OWASP官方推荐的安全首选。在Python中可通过 argon2-cffi 库直接使用其 Argon2id 混合模式:
from argon2 import PasswordHasher
from argon2.exceptions import VerifyMismatchError

# 创建 Argon2 密码处理器,内置了合理的默认内存和时间开销参数
ph = PasswordHasher(
    time_cost=3,        # 迭代次数
    memory_cost=65536,  # 内存消耗 64MB
    parallelism=4       # 并行线程数
)

# 密码哈希
hashed_record = ph.hash("user_secret_phrase_2026")

# 登录验证
try:
    ph.verify(hashed_record, "user_secret_phrase_2026")
    print("Argon2 验证通过!")

    # 检查工作参数是否过时,若过时可在用户登录成功后无感升级
    if ph.check_needs_rehash(hashed_record):
        new_hash = ph.hash("user_secret_phrase_2026")
        # 将 new_hash 异步更新至数据库
except VerifyMismatchError:
    print("密码错误,验证失败!")
方案三:纯Python标准库原生方案(无第三方包依赖)
如果所在生产环境限制安装第三方C扩展,可以使用Python标准库内置的 hashlib.scrypt 或 hashlib.pbkdf2_hmac。注意:自制存储结构时必须使用 secrets 模块生成盐,并在比对时使用 hmac.compare_digest 防止时序侧信道攻击:
import hashlib
import secrets
import hmac

def std_hash_password(plain_password: str) -> str:
    # 1. 采用密码学安全伪随机数生成 16 字节唯一盐
    salt = secrets.token_bytes(16)
    # 2. 使用 scrypt 算法,n=16384 (CPU/内存成本), r=8 (块大小), p=1 (并行度)
    key = hashlib.scrypt(
        plain_password.encode('utf-8'),
        salt=salt,
        n=16384,
        r=8,
        p=1,
        maxmem=0,
        dklen=64
    )
    # 3. 将 salt 与 key 一同编码存储 (格式: salt_hex$key_hex)
    return f"{salt.hex()}${key.hex()}"

def std_verify_password(plain_password: str, stored_record: str) -> bool:
    try:
        salt_hex, key_hex = stored_record.split('$')
        salt = bytes.fromhex(salt_hex)
        expected_key = bytes.fromhex(key_hex)

        # 提取盐以相同参数重新计算
        derived_key = hashlib.scrypt(
            plain_password.encode('utf-8'),
            salt=salt,
            n=16384,
            r=8,
            p=1,
            maxmem=0,
            dklen=64
        )
        # 4. 关键安全细节:必须使用常量时间比对,阻断时序侧信道攻击
        return hmac.compare_digest(derived_key, expected_key)
    except Exception:
        return False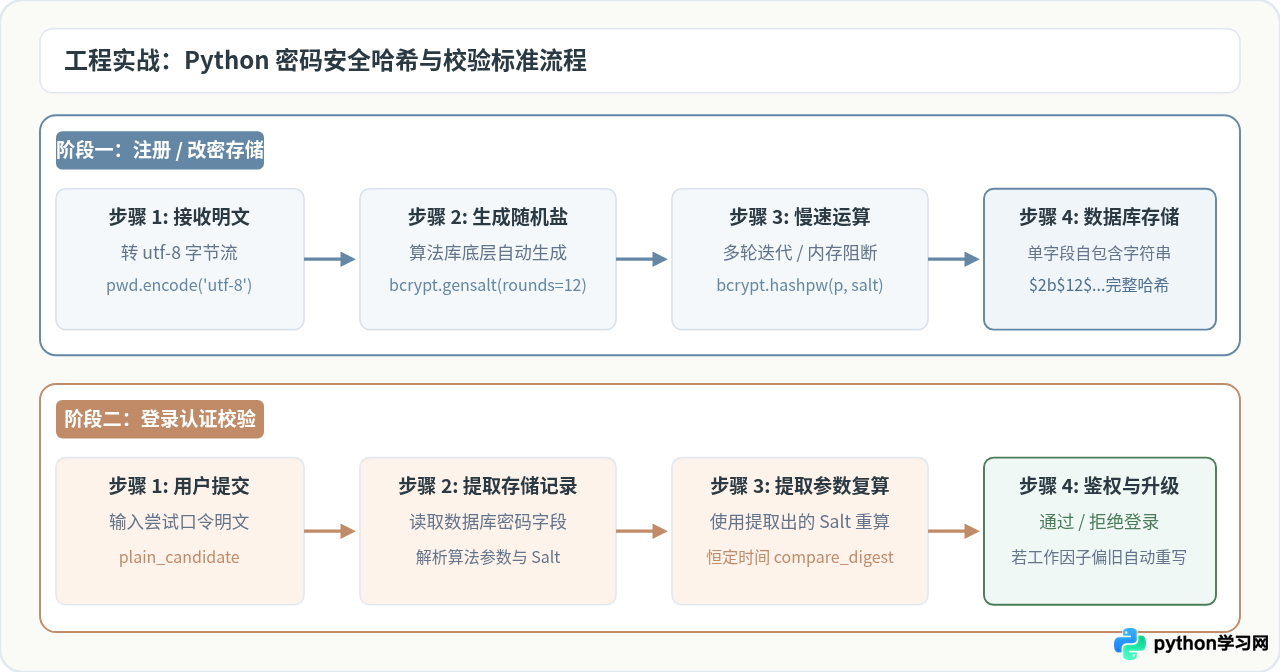
六、生产系统旧密码迁移与最佳实践
1. 老系统遗留 MD5 密码的平滑迁移方案(登录即升级)
很多历史遗留系统由于架构陈旧,数据库中仍存储着数万到数百万条旧的MD5哈希值。由于哈希具备单向不可逆性,系统管理员无法在后台批量将MD5直接解密并转换成bcrypt哈希。工程上最稳妥的演进策略是“用户登录即透明升级”(Transparent Re-hashing):
- 识别哈希格式:在数据库中为密码字段记录当前采用的哈希算法类型,或者通过前缀长度区分(MD5为32位hex,bcrypt以
$2b$开头)。 - 双重验证分支:当老用户发起登录请求时,若其处于MD5状态,先使用历史的MD5逻辑核验其输入的明文。
- 在内存中立即重新哈希:验证通过后,此时内存中正持有用户刚提交的合法明文密码。立即调用
bcrypt.hashpw()生成全新的现代哈希值。 - 覆写数据库字段:将生成的bcrypt串更新至数据库,并切换用户算法标识。随着时间推移,活跃用户的凭证将逐步被安全汰换。
2. 防范时序侧信道攻击(Timing Attack)
在密码验证环节,绝对不能使用Python原生的常规字符串比较运算符 if input_hash == db_hash:。因为普通字符串相等性判断在底层是按字符逐个扫描的,一旦遇到第一个不匹配的字符就会立即提前返回(Short-circuit)。
高精度的网络探针可以通过统计大量请求的微秒级响应时间偏差,推断出前几个字符是否猜测正确,从而逐位拼凑出目标哈希。必须始终使用标准库的 hmac.compare_digest() 或安全库自带的 verify() 函数,它们在底层执行恒定周期循环比对,消除了时间差异泄露的信息。
七、总结
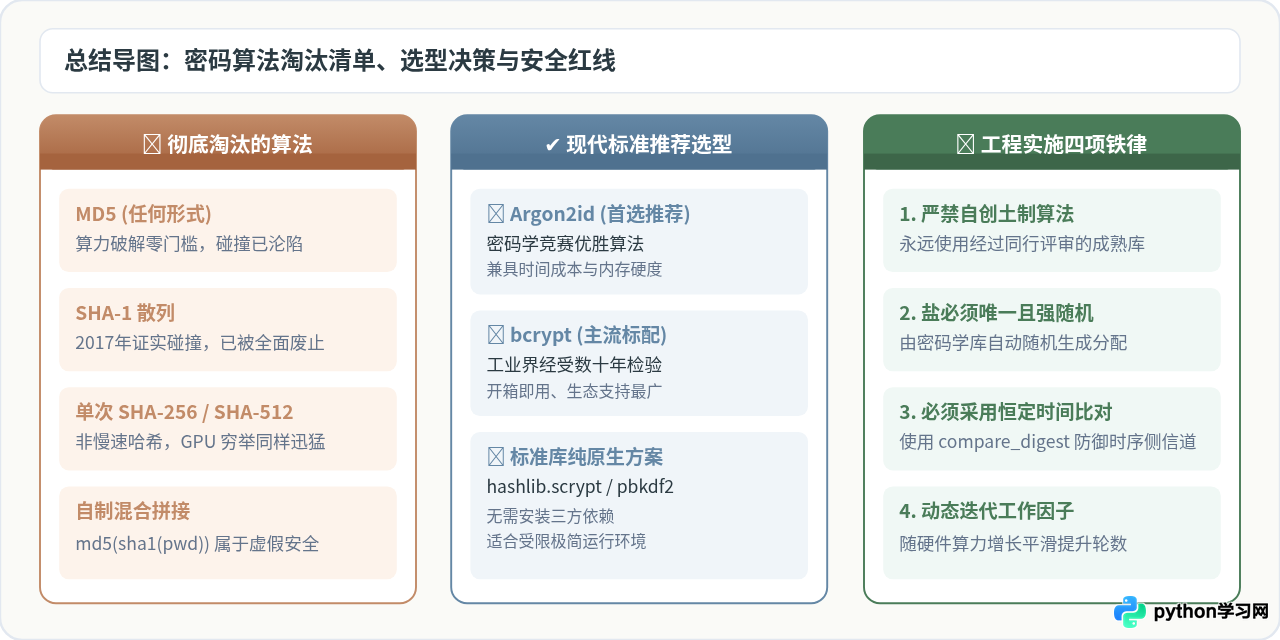
MD5是一个历史悠久、功勋卓越的数据校验算法,但它在诞生时从来没有被赋予保护人类密码的使命。它的高速、无内存限制以及早已证实的数学缺陷,使其在现代GPU算力面前如纸糊般脆弱。
在Python开发中,保护密码安全的底线准则是:永远不要将MD5用作密码哈希;不要依赖自己拼凑的加盐逻辑;全面转向以Argon2id和bcrypt为代表的自适应慢速哈希算法。通过合理的工程设计拉高攻击者的计算门槛,才是保障用户资产与系统安全的长久之道。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















