


模拟浏览器行为:Python爬虫设置User-Agent与请求延时的基础技巧
深入讲解Python爬虫中模拟浏览器行为的两项核心基础技巧:合理配置User-Agent请求头与设置请求延时抖动,附带完整代码示例、踩坑提醒与全套内联SVG架构流程图。
许多刚接触网络数据采集的开发者常常遇到这样的情况:一段逻辑看似完全正确的抓取脚本,刚运行没几步就遭遇 403 Forbidden 拦截,或者频繁收到目标服务器的验证提示与断开连接。出现这种现象的核心原因,在于脚本发送的请求带着非常明显的非人工痕迹——它既暴露了默认的代码请求头标识,又以机械且极高密度的速率连续撞击服务器。要让爬虫稳定且合规地获取公开内容,最基础、最关键的两步操作,就是正确配置 User-Agent 请求头以及引入科学的请求延时与随机抖动。
识破身份标记:User-Agent 的工作机制与默认特征
在 HTTP 协议中,客户端发起网络请求时,会在请求头(Headers)中附带一个名为 User-Agent 的字符串。这个字段的原本作用是告诉目标服务器:“我是谁、我运行在什么操作系统上、我使用的是什么浏览内核与版本”。目标服务器据此决定返回针对特定设备优化的页面布局,或者识别访问来源的合法性。
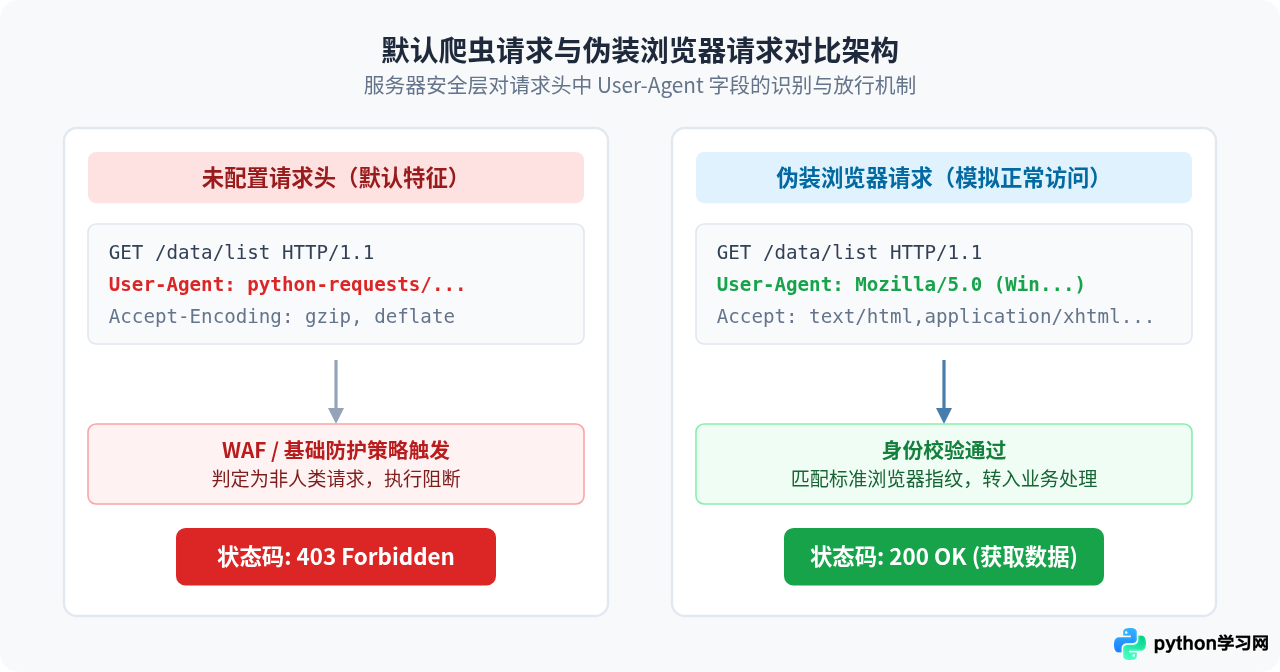
当开发者使用 Python 最常用的 requests 库发送请求且未作任何头信息配置时,程序并不会自动借用你本地浏览器的标识,而是会在请求头中写入类似下面的字串:
User-Agent: python-requests/2.31.0对于配置了基础安全防护与反爬规则的网站而言,此类请求特征一目了然。服务器的安全网关(WAF)甚至不需要分析访问频率,仅凭请求头过滤即可在毫秒级内直接阻断连接。因此,把请求头伪装成真实用户的桌面或移动端浏览器,是所有爬虫开发的基本守则。
实操步骤:如何正确获取、配置与校验 User-Agent
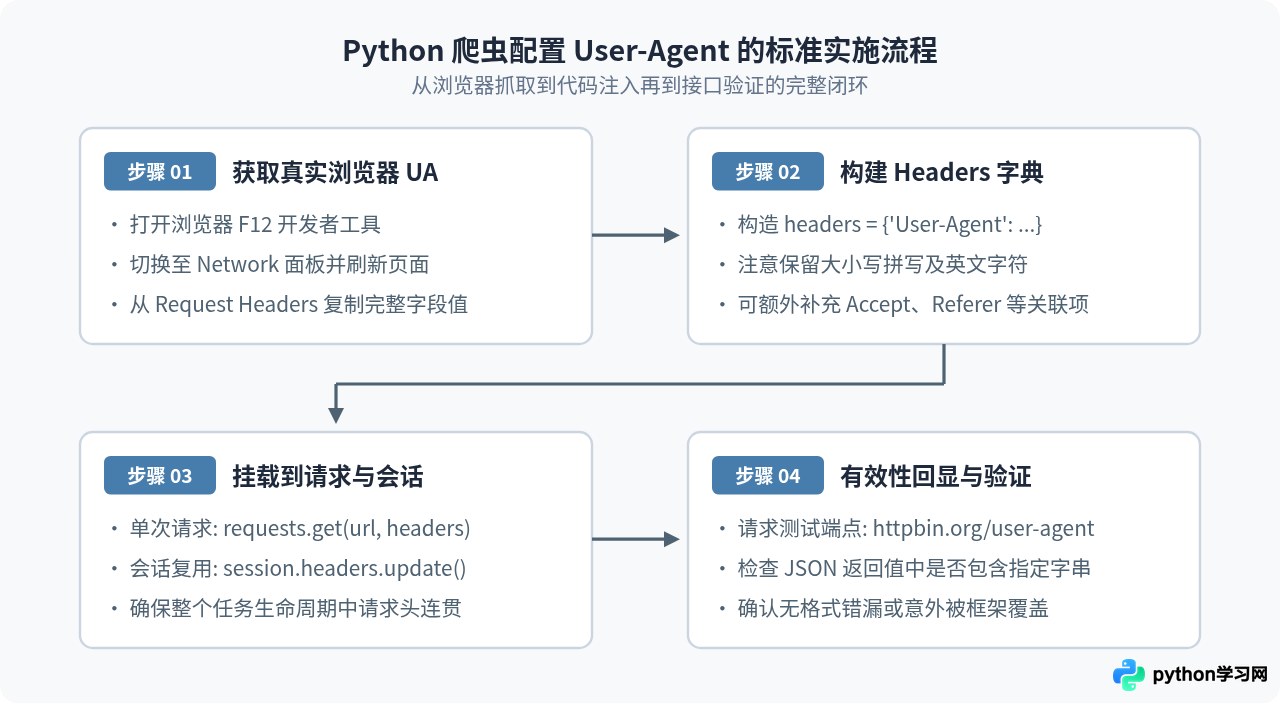
为 Python 爬虫配置 User-Agent 并不复杂,整个过程可以拆分为四个标准化步骤:捕获真实值、构建标头字典、注入请求逻辑以及回显验证。
第一步:从本地浏览器捕获真实有效的值
不要凭空捏造不符合规范的 User-Agent 字符串。最直接、稳妥的方式是直接复制你当前使用浏览器的真实信息:
- 在日常使用的浏览器(如 Chrome、Edge、Firefox)中按下
F12打开“开发者工具”(或在网页任意位置右键选择“检查”)。 - 切换到 Network(网络) 标签页,并勾选 Preserve log(保留日志)。
- 刷新当前页面,在左侧请求列表中随便点击一项(通常是主文档或第一个 HTML 请求)。
- 在右侧详情栏中找到 Headers(标头) -> Request Headers(请求标头),向下滚动找到
User-Agent项,将其对应的值完整复制出来。
常见的桌面 Chrome 浏览器 User-Agent 格式通常如下所示:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36第二步与第三步:在代码中声明并传入请求函数
在 Python 代码中,请求头以标准键值对字典(dict)的形式进行维护。将 headers 字典作为参数传给 requests.get() 或挂载到 requests.Session() 对象中:
import requests

# 1. 声明自定义请求头
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36'
}

# 2. 发起请求时传入 headers 参数
target_url = 'https://httpbin.org/user-agent'
response = requests.get(target_url, headers=headers)

# 3. 校验回显结果
print(response.json())
在上述代码中,我们请求了专门用于网络调试的 httpbin.org/user-agent 接口。该接口会原封不动地返回它所接收到的客户端 User-Agent。当控制台输出中的 user-agent 字段显示为你自定义的 Chrome 字符串而非 python-requests 时,即证明设置已经成功生效。
进阶补充:配置 User-Agent 随机池
在批量采集不同网页时,如果全部并发或长期循环始终只用单一固定的 User-Agent,虽然能过掉最简单的非空检查,但仍可能被更严格的统计分析系统关联。我们可以准备一个包含多款主流浏览器(Chrome、Firefox、Safari、Edge)的列表,在每次会话或请求时使用 Python 标准库 random.choice() 随机选取:
import random

UA_POOL = [
    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36',
    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36',
    'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:125.0) Gecko/20100101 Firefox/125.0',
    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/17.4.1 Safari/605.1.15',
    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36 Edg/124.0.0.0'
]

def get_random_headers():
    return {
        'User-Agent': random.choice(UA_POOL),
        'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8',
        'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8'
    }
节奏控制:请求延时与动态随机抖动
许多初学者在伪装了 User-Agent 之后,写了一个 for page in range(1, 1000): 循环直接狂奔抓取,几秒钟内发出了几百次请求。结果不仅程序迅速报错中断,甚至导致本地 IP 被对方服务器封禁数小时。这是因为忽略了爬虫行为的另一个关键维度:请求节奏。
真实人类在浏览器中阅读网页,从打开链接、浏览内容、滚动页面到底部再点击“下一页”,通常需要耗费数秒乃至数十秒的时间。如果一个客户端虽然声称自己是 Chrome 浏览器,但能在 1 秒钟内连续翻完 50 个复杂网页,后台的数据风控与限流算法(Rate Limiting)会立即将其判定为自动化脚本。
固定延时的局限性
在 Python 中,暂停程序执行最直接的办法是调用 time.sleep(seconds)。例如每次抓取完一页后休眠 2 秒:
import time
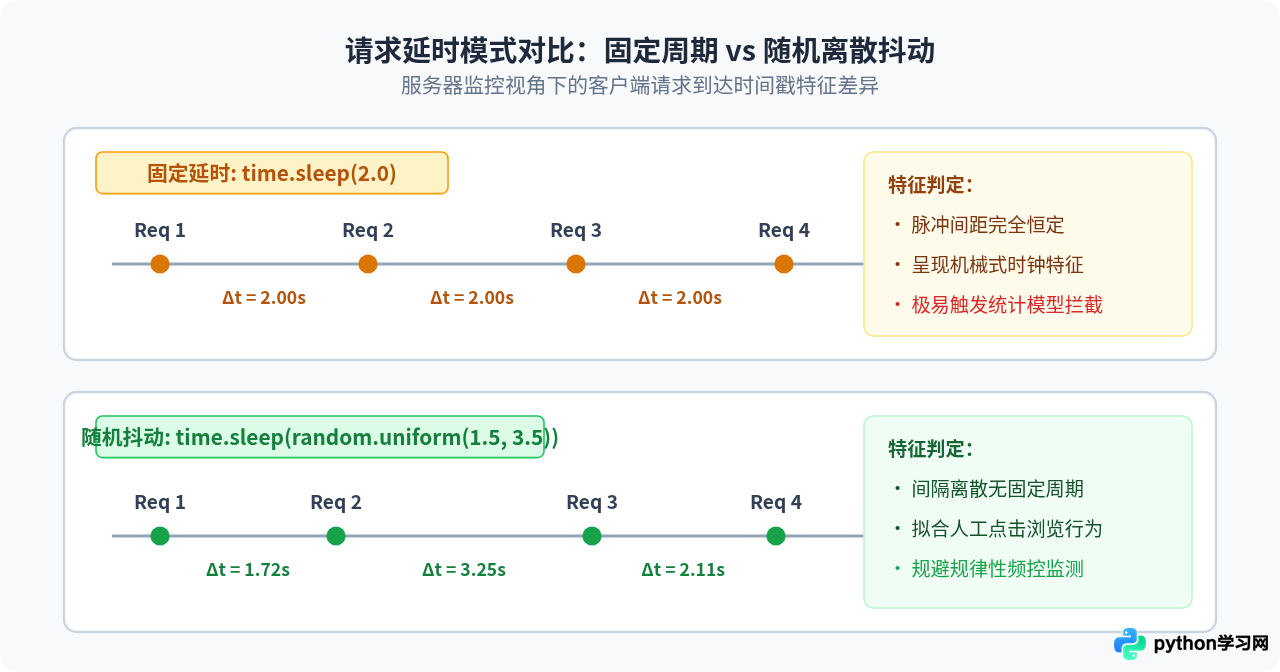
time.sleep(2) # 每次固定暂停 2.0 秒虽然固定延时确实降低了对目标站点的瞬时压力,但在风控较为严格的现代系统中,固定周期本身也是一种显眼的机器指纹。正常人类不可能严格精确地每隔 2.000 秒点击一次翻页。在服务器的请求时间戳日志中,如果两个请求的间隔每次都是整整齐齐的 2 秒,仍然很容易被统计学规则捕获。
使用 random.uniform 实现自然抖动
更为科学的做法是为延时引入浮点数范围的随机波动(Jitter),使用 Python 的 random.uniform(a, b) 生成指定区间内的均匀随机小数。例如设定在 1.5 秒到 3.5 秒之间浮动:
import time
import random

# 生成介于 1.5 秒与 3.5 秒之间的连续随机浮点数
sleep_time = random.uniform(1.5, 3.5)
time.sleep(sleep_time)
通过这种微小的改进,连续请求的时间间隔就会变成诸如 1.82s、3.14s、2.45s、2.09s 这样离散分布的波形,极大地贴近了人类交互的自然节奏,从而大幅提升长周期爬取任务的隐蔽性与稳定性。
综合实战:多页面翻页爬取的规范模版
了解了 User-Agent 伪装与随机延时的原理之后,我们需要将它们整合到实际的代码流程中。在工程实践中,推荐使用 requests.Session() 对象来管理网络会话。Session 对象不仅能够自动维护服务端返回的 Cookie 状态、复用底层的 TCP 连接,还可以统一托管请求头,避免每次调用函数时重复传递。
以下是一个具备生产可用雏形的多页面采集范例:
import time
import random
import requests

def create_crawler_session():
    """创建并配置具备真实浏览器请求头的会话对象"""
    session = requests.Session()
    session.headers.update({
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36',
        'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8',
        'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8',
        'Connection': 'keep-alive'
    })
    return session

def fetch_pages(total_pages=5):
    """循环分页抓取数据,并在每次抓取后增加随机抖动延时"""
    session = create_crawler_session()
    base_url = 'https://httpbin.org/get'  # 替换为实际采集目标

    for page in range(1, total_pages + 1):
        params = {'page': page, 'page_size': 20}
        print(f"[*] 正在抓取第 {page}/{total_pages} 页...")

        try:
            response = session.get(base_url, params=params, timeout=10)
            if response.status_code == 200:
                print(f"[+] 第 {page} 页获取成功 (状态码 200)")
                # 此处进行网页解析与数据持久化逻辑...
            elif response.status_code == 429:
                print(f"[!] 触发服务端速率限制(429),执行后退重试...")
                time.sleep(15)  # 遇频控时适度延长退避时间
                continue
            else:
                print(f"[-] 请求异常,状态码: {response.status_code}")

        except requests.exceptions.RequestException as e:
            print(f"[x] 网络请求异常: {e}")

        # 核心关键:只有在非最后一页时,才执行页面之间的随机延时
        if page < total_pages:
            delay = random.uniform(2.0, 4.5)
            print(f"[-] 页面处理完成,随机休眠 {delay:.2f} 秒以模拟人类行为...\n")
            time.sleep(delay)

if __name__ == '__main__':
fetch_pages(total_pages=3)注意请求延时的摆放位置:延时应当置于每一次成功的网络请求或常规循环的末尾,而不是放在可能出现异常重试的死循环前部。如果目标站点返回了 429 Too Many Requests,应当使用更长的指数退避(Exponential Backoff)策略(例如依次休眠 5s、15s、45s),而不是继续按原频率强行重试。
常见踩坑要点与技术防御边界
在掌握了上述基础技巧后,初学者在实际运用中仍容易陷入一些理解误区。认清这些误区与技术手段的适用边界,有助于建立更清晰的爬虫工程思维。
| 常见误区与问题 | 具体表现与错误原因 | 正确处理方案 |
|---|---|---|
| 只配 UA,忽略其他头 | 现代浏览器除了 User-Agent,还会发送 Referer、Accept-Language 以及 Sec-Ch-Ua 等客户端提示头。若仅有一个孤立的 UA,某些高阶 WAF 仍能识别出特征不全。 | 为关键请求补充对应的 Referer(来源页面路径)与 Accept-Language,保持上下文自洽。 |
| 延时位置放置不当 | 将 time.sleep 放在发生异常的捕获分支之外,导致网络超时重试时以极短微秒级间隔狂刷接口。 |
明确区分正常翻页延时与异常重试退避延时,确保每一次发起网络调用之间都有缓冲。 |
| 过于频繁地随机切换 UA | 在同一个由 Session 维持的长连接会话内,每一秒都换一个完全不同的系统与浏览器版本,显得极不真实。 | 以一个会话(Session)或一次完整的业务流程为粒度固定一个 UA;仅在重新开启全新任务或轮转代理 IP 时才更换。 |
了解防线阶梯:这两个基础技巧不能解决什么?
必须明确的是,设置 User-Agent 和控制请求延时是网络爬虫最基本的门槛,但绝不是万能的银弹。现代互联网的反爬技术是一个分层的防御体系:
- JavaScript 动态渲染:如果网页内容是由前端 Vue、React 或复杂 Ajax 异步执行加密算法渲染出来的,光改请求头只拿到空的 HTML 骨架。此时需要分析网络 XHR 接口或使用 Playwright / Selenium 这类真实的无头浏览器。
- 行为人机验证码:包括滑动拼图、点选文字、Google reCAPTCHA 等。这些验证基于鼠标滑动轨迹、Canvas 指纹与环境探测,无法通过单纯设置标头穿透。
- TLS / JA3 指纹识别:服务器在 SSL 握手阶段即可检测到 Python
urllib或requests采用的密码套件与扩展顺序与真实 Chrome 不同。 - 严格的 IP 访问频控:即便是加入了随机延时,若全天 24 小时源源不断地从同一个公网 IP 发出大量请求,仍然可能超出单个 IP 的日访问阈值,这就需要结合代理 IP 池进行横向分流。
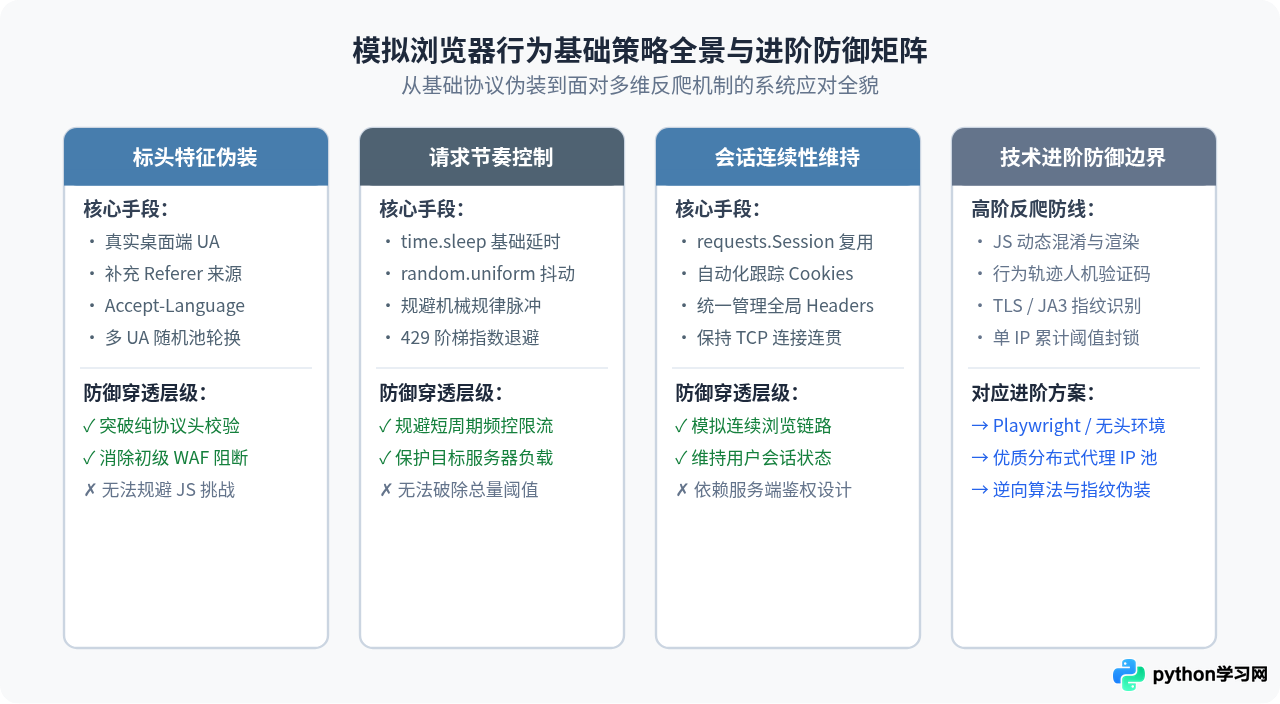
网络数据采集是一门讲究“克制”与“真实”的实践技术。只要在编写脚本之初就养成好习惯,始终为每个请求赋予合法的浏览器身份,并在每次循环中留足合理的呼吸时间,就能在绝大多数公开数据采集任务中保持稳定顺畅的运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















