


Python机器学习模型评估:准确率计算与参数调优方法
深入解析Python机器学习中的模型评估体系,涵盖准确率数学计算、类别不均衡场景分析、K折交叉验证流程,以及基于Scikit-Learn的网格搜索与随机搜索参数调优实战。
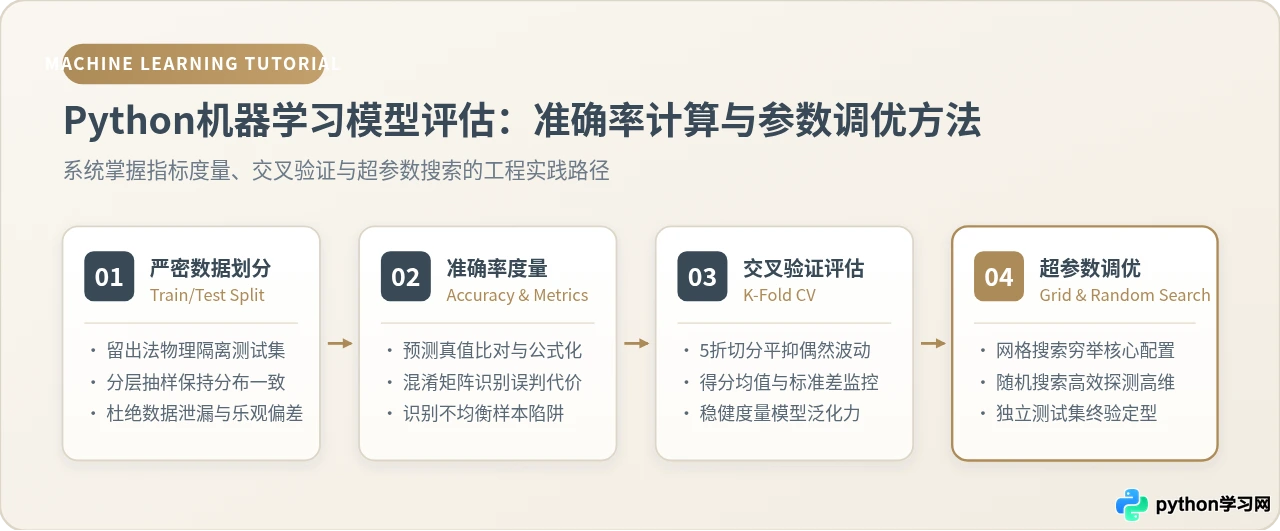
一、准确率计算的核心原理与适用边界
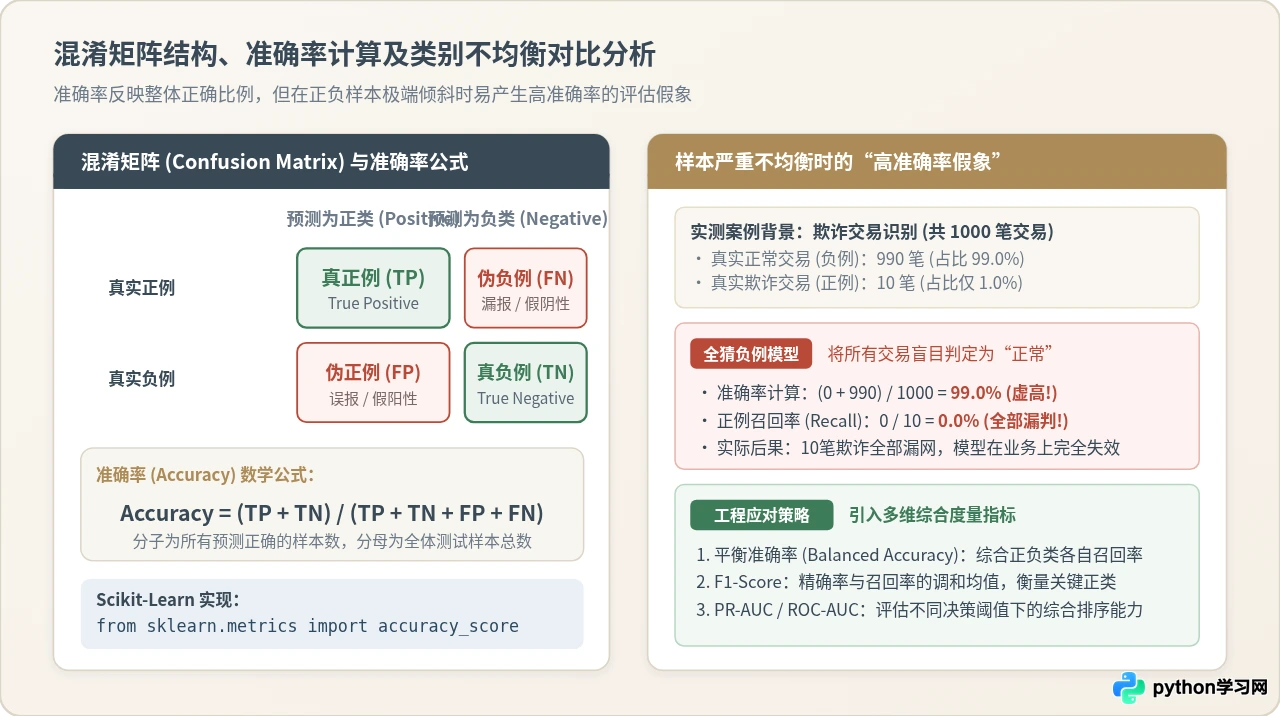
准确率是分类问题中最为基础的量化评价指标。要精确理解准确率的计算过程,需要先梳理分类预测中的混淆矩阵(Confusion Matrix)。在二分类任务中,模型的所有预测结果与真实标签的比对可以穷举为四种基本状态:
- 真正例(True Positive, TP):真实类别为正类,模型正确预测为正类;
- 真负例(True Negative, TN):真实类别为负类,模型正确预测为负类;
- 伪正例(False Positive, FP):真实类别为负类,模型误报预测为正类(第一类错误);
- 伪负例(False Negative, FN):真实类别为正类,模型漏报预测为负类(第二类错误)。
准确率的数学本质,即所有预测正确的样本(真正例与真负例之和)在总体测试样本中所占的百分比。其标准计算公式如下:
Accuracy = (TP + TN) / (TP + TN + FP + FN)
在Python的机器学习核心库Scikit-Learn中,准确率既可以通过 sklearn.metrics.accuracy_score 函数直接计算,也可以通过各个分类器自带的 score(X, y) 方法获取。
import numpy as np
from sklearn.metrics import accuracy_score, confusion_matrix

# 模拟真实标签与模型预测标签
y_true = np.array([1, 0, 1, 1, 0, 1, 0, 0, 1, 0])
y_pred = np.array([1, 0, 1, 0, 0, 1, 0, 1, 1, 0])

# 1. 直接调用 accuracy_score 计算准确率
acc = accuracy_score(y_true, y_pred)
print(f"模型准确率 (Accuracy): {acc:.2%}")

# 2. 输出混淆矩阵验证各象限分布
cm = confusion_matrix(y_true, y_pred)
print("混淆矩阵 [ [TN, FP], [FN, TP] ]:")
print(cm)
模型准确率 (Accuracy): 80.00%
混淆矩阵 [ [TN, FP], [FN, TP] ]:
[[4 1]
 [1 4]]
在上述示例中,10个样本里有8个被正确分类(4个TN与4个TP),因此准确率为80.00%。虽然计算直观明了,但必须高度警惕类别不均衡陷阱。
二、验证流程规范:从数据切分到K折交叉验证
在模型评估过程中,新手常犯的根本性错误是在训练集上直接测算准确率。当模型在训练集上被充分拟合甚至过拟合时,训练准确率往往接近100%,但这仅仅代表模型“死记硬背”了已有数据的特征与噪声,无法反映其面对未知新样本时的真实泛化能力。
1. 留出法(Train/Test Split)与分层抽样
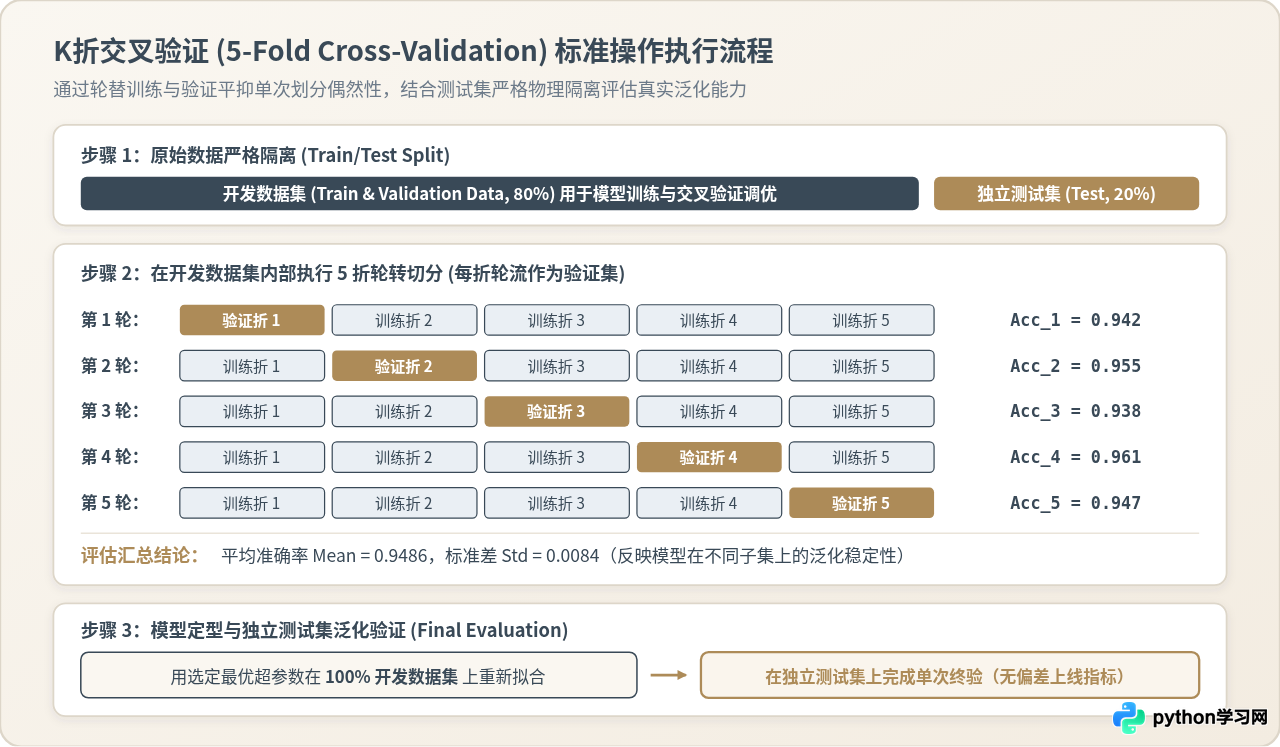
构建可信评估的第一步是将原始数据集划分为互斥的两个部分:训练集(例如70%~80%)与独立测试集(例如20%~30%)。测试集在模型调优阶段必须被严格隔离,绝不能参与任何参数学习或超参数决策。
在数据切分时,务必使用分层抽样参数 stratify=y。分层抽样能够确保训练集和测试集中的各个类别比例与原始数据集保持严格一致,避免因随机抽样导致训练集缺失少数类样本。
from sklearn.model_selection import train_test_split
from sklearn.datasets import load_breast_cancer

# 加载经典二分类数据集
data = load_breast_cancer()
X, y = data.data, data.target

# 采用分层抽样划分 80% 开发集与 20% 最终独立测试集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.20, random_state=42, stratify=y
)

print(f"训练集规模: {X_train.shape[0]} 样本,测试集规模: {X_test.shape[0]} 样本")
2. K折交叉验证(K-Fold Cross-Validation)运算机制
虽然留出法能够隔离测试数据,但单次切分具有偶然性:如果恰好切分进测试集的样本较难分类,评估得分就会偏低;反之亦然。为了客观、平稳地衡量模型在开发集上的表现,标准做法是在开发集上运行K折交叉验证(常用K=5或K=10)。
K折交叉验证将开发数据均分为K个互斥子集(折,Fold)。在每一轮循环中,挑选其中1折作为验证集,其余K-1折合并为训练集来训练模型,并在验证集上计算准确率。循环重复K次后,每个子集均恰好担任过一次验证集,最终得到K个验证准确率。计算这K个得分的均值(Mean)与标准差(Std),即可全面掌握模型的预测精度及在不同样本划分下的稳定性。
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score, StratifiedKFold

# 实例化基础分类器
rf_baseline = RandomForestClassifier(n_estimators=50, random_state=42)

# 构造分层 5 折交叉验证迭代器
cv_stratified = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

# 评估模型在各折上的准确率
cv_scores = cross_val_score(rf_baseline, X_train, y_train, cv=cv_stratified, scoring='accuracy')

print(f"5折各轮准确率: {[round(s, 4) for s in cv_scores]}")
print(f"平均交叉验证准确率: {cv_scores.mean():.4f} (±{cv_scores.std():.4f})")
5折各轮准确率: [0.9560, 0.9670, 0.9451, 0.9451, 0.9780]
平均交叉验证准确率: 0.9582 (±0.0125)
三、超参数调优方法:网格搜索与随机搜索
在机器学习中,必须清晰区分模型参数与超参数:
- 模型参数(Parameters):模型内部通过训练算法自动拟合学习得到的数值,例如逻辑回归与线性回归中的回归系数 $w$ 与偏置项 $b$;
- 超参数(Hyperparameters):在模型开始训练前必须由人工预先指定的结构与控制参数,例如随机森林中树木的数量(
n_estimators)、决策树的最大深度(max_depth)、支持向量机的正则化惩罚强度(C)与核函数系数(gamma)。
超参数直接决定了模型的学习容量与过拟合/欠拟合倾向。寻找最佳超参数组合的过程称为参数调优(Hyperparameter Tuning)。Scikit-Learn提供了两大主流调优工具:GridSearchCV(网格搜索)与 RandomizedSearchCV(随机搜索)。
1. 网格搜索(GridSearchCV):笛卡尔积穷举
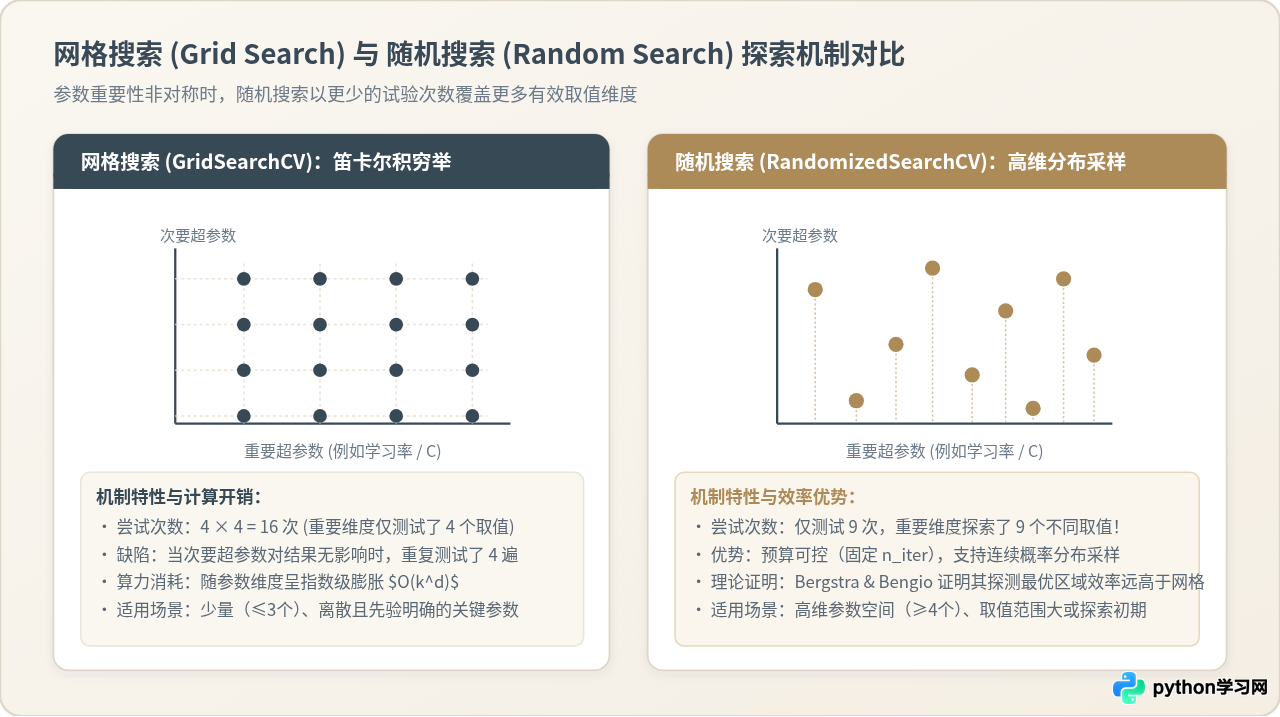
网格搜索的原理非常朴素:为每一个目标超参数提供一组离散的候选数值,算法将计算这些候选参数的笛卡尔积,穷举遍历全部可能的参数组合。针对每一组特定的超参数配置,算法都会在内部执行指定次数的K折交叉验证,最终输出平均验证指标最高的那一组作为最优参数。
- 适用场景:超参数数量较少(通常在3个以内)、候选取值范围小且离散、算力充足的精调阶段;
- 局限性:算力开销随超参数维度呈指数级爆炸。若优化4个超参数,每个参数设定5个候选值并采用5折交叉验证,总训练次数将达到 $5^4 \times 5 = 3125$ 次,极易造成算力灾难。
2. 随机搜索(RandomizedSearchCV):高维分布高效采样
针对高维参数空间,统计学家James Bergstra与Yoshua Bengio在经典论文中证明:在机器学习模型中,不同超参数对预测结果的敏感程度往往极不均衡(通常仅少数参数起决定性作用)。在网格搜索中,次要超参数的固定网格会浪费大量算力重复测试相同的关键参数;而随机搜索在每次迭代中均从连续概率分布或离散列表中随机抽取取值,能以固定算力预算(由参数 n_iter 控制)在主要超参数维度上探索远多于网格搜索的有效取值点。
- 适用场景:超参数维度较多(≥4个)、参数取值跨度大(如学习率跨越几个数量级)、支持连续概率分布采样的探索阶段;
- 优势:试验次数完全由用户通过
n_iter自主掌控,算力开销线性可预测,极大提升探索效率。
四、端到端实战:从基线构建、参数寻优到泛化验证
接下来通过一个完整的端到端工程示例,演示如何在Python中规范完成数据切分、基线构建、超参数调优与独立测试集泛化验证的全流程。
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, GridSearchCV, StratifiedKFold
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, classification_report

# 1. 准备数据并执行严格分层切分
data = load_breast_cancer()
X, y = data.data, data.target

X_dev, X_test, y_dev, y_test = train_test_split(
    X, y, test_size=0.20, random_state=42, stratify=y
)

# 2. 构建基线模型评估(默认参数)
baseline_model = RandomForestClassifier(random_state=42)
baseline_model.fit(X_dev, y_dev)
baseline_test_acc = accuracy_score(y_test, baseline_model.predict(X_test))
print(f"[基线模型] 默认参数在独立测试集上的准确率: {baseline_test_acc:.4f}")

# 3. 定义待调优超参数候选网格
param_grid = {
    'n_estimators': [50, 100, 200],
    'max_depth': [3, 5, 8, None],
    'min_samples_split': [2, 5],
    'criterion': ['gini', 'entropy']
}

# 4. 初始化 5 折交叉验证网格搜索
cv_strategy = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
grid_search = GridSearchCV(
    estimator=RandomForestClassifier(random_state=42),
    param_grid=param_grid,
    cv=cv_strategy,
    scoring='accuracy',
    n_jobs=-1,       # 启用所有CPU核心并行加速
    refit=True       # 锁定最佳参数后自动在全部开发集上重新拟合
)

print("正在执行网格搜索超参数拟合...")
grid_search.fit(X_dev, y_dev)

# 5. 提取最优配置与交叉验证指标
print(f"[调优结果] 最佳参数组合: {grid_search.best_params_}")
print(f"[调优结果] 最佳交叉验证平均准确率: {grid_search.best_score_:.4f}")

# 6. 使用最优模型在完全独立的测试集上完成单次最终验证
best_model = grid_search.best_estimator_
final_test_pred = best_model.predict(X_test)
final_test_acc = accuracy_score(y_test, final_test_pred)

print(f"[最终终验] 调优后模型在独立测试集准确率: {final_test_acc:.4f}")
print("\n最终测试集分类报告 (Classification Report):")
print(classification_report(y_test, final_test_pred, target_names=data.target_names))
[基线模型] 默认参数在独立测试集上的准确率: 0.9561
正在执行网格搜索超参数拟合...
[调优结果] 最佳参数组合: {'criterion': 'entropy', 'max_depth': 8, 'min_samples_split': 2, 'n_estimators': 200}
[调优结果] 最佳交叉验证平均准确率: 0.9670
[最终终验] 调优后模型在独立测试集准确率: 0.9737

最终测试集分类报告 (Classification Report):
              precision    recall  f1-score   support

   malignant       0.98      0.95      0.96        42
      benign       0.97      0.99      0.98        72

    accuracy                           0.97       114
   macro avg       0.97      0.97      0.97       114
weighted avg       0.97      0.97      0.97       114
从实际运行结果可见,调优后的模型在开发集上的交叉验证平均准确率提升至96.70%,在从未参与调优决策的测试集上的泛化准确率从基线的95.61%提升至97.37%。更重要的是,分类报告中良性与恶性样本的精确率和召回率均达到了95%以上,充分证明模型调优具备真实、稳健的泛化收益。
五、模型评估与调优的常见陷阱与避坑准则
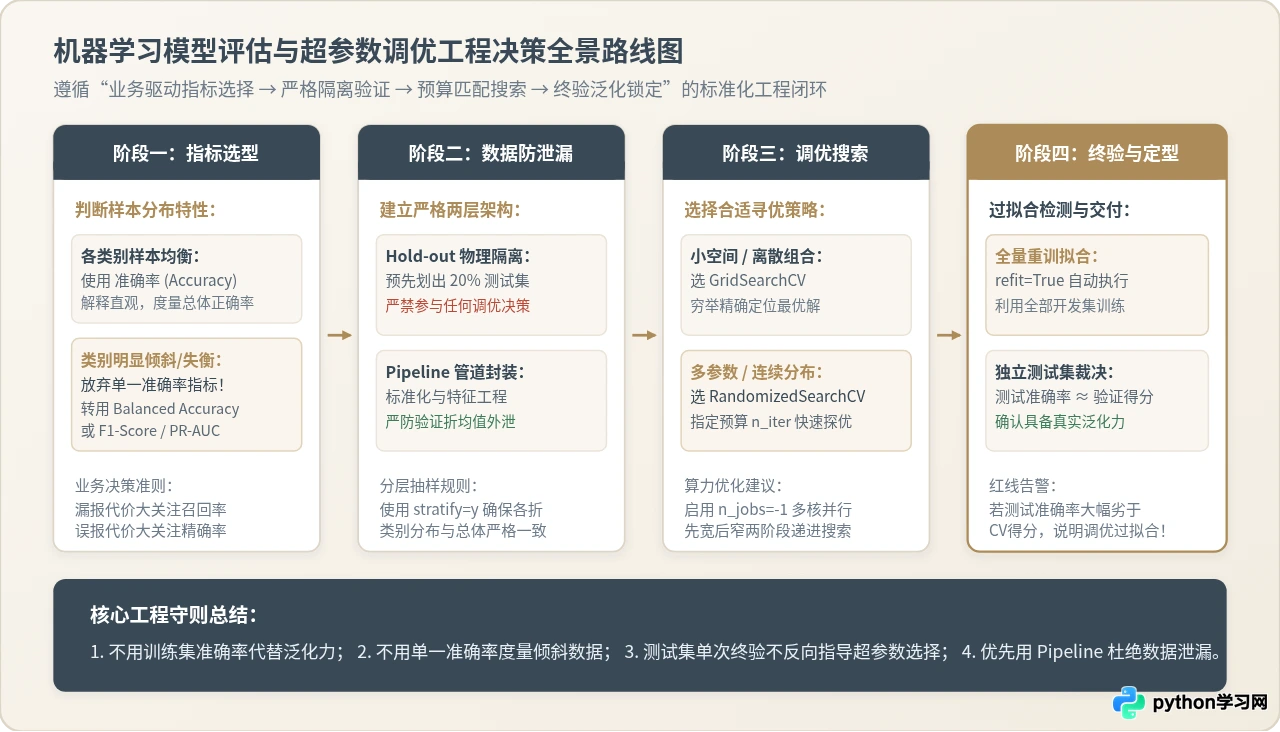
在机器学习工程落地中,调优与评估环节极易因为操作不规范引入系统性偏差,导致“实验室指标亮眼、线上推理崩盘”。以下是三大最常见陷阱与标准工程防范对策:
1. 陷阱一:数据泄漏(Data Leakage)导致虚假高分
成因:如果在将数据划分进交叉验证之前,就对全体数据集执行了标准化(如 StandardScaler)、缺失值中位数填充或基于卡方检验的特征筛选,那么验证集的数据分布信息就已经提前被统计并“泄漏”进了训练特征中。
对策:必须使用 Scikit-Learn 的 Pipeline 将数据预处理步骤与模型估计器打包绑定。在每一折验证中,仅利用当前训练折计算均值与方差,并严格应用到验证折上,从而从根源上杜绝跨折信息泄漏。
2. 陷阱二:调优过拟合(Over-tuning on Validation Set)
成因:交叉验证虽然比单次划分更为稳健,但如果尝试了成千上万种参数组合,超参数搜索算法可能仅仅选出了“恰好在当前验证集切分下表现异常优异”的参数,形成对验证集的过拟合。
对策:预先严格物理隔离独立测试集(Hold-out Test Set)。只有当所有超参数调优、特征工程全部收敛定型后,才对测试集执行单次评估;若最终测试集准确率显著低于交叉验证得分,说明模型已发生调优过拟合,需收缩参数搜索空间并增强正则化。
3. 陷阱三:算力失控与盲目搜索
成因:不考虑参数重要性与模型复杂度,在网格搜索中堆叠大量连续浮点数或大跨度整数,导致模型训练数十个小时仍无法收敛。
对策:遵循“两阶段递进搜索”法则。第一阶段使用 RandomizedSearchCV 在宽广的参数空间中快速探索(设定 n_iter=20~50),定位出具有高潜力的参数敏感区间;第二阶段针对该核心区间使用小步长的 GridSearchCV 进行细粒度精调。
六、总结
准确率计算是评估分类模型最直观的起点,但绝非终点。在实际工程落地中,准确率必须建立在严谨的数据隔离基石之上:
- 以混淆矩阵为显微镜,结合样本类别分布识别准确率的有效性,警惕高准确率下的漏报灾难;
- 以分层K折交叉验证为标尺,平抑单次数据划分的偶然性,通过均值与方差同步度量预测精度与鲁棒性;
- 以网格搜索与随机搜索为杠杆,在有限的算力预算内科学探索超参数空间,并依托独立测试集进行无偏终验。
严格遵循这一套标准化闭环流程,能够确保模型不仅在开发阶段交出高准确率答卷,更能稳定适应真实生产环境中的未知数据。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















