


菜鸟教程Python内容深度够就业吗?实战局限性分析
深入分析菜鸟教程Python内容的深度与局限性,对比企业就业岗位技能要求,解析单文件示例与工程化落地之间的鸿沟,并提供系统进阶实战路线。
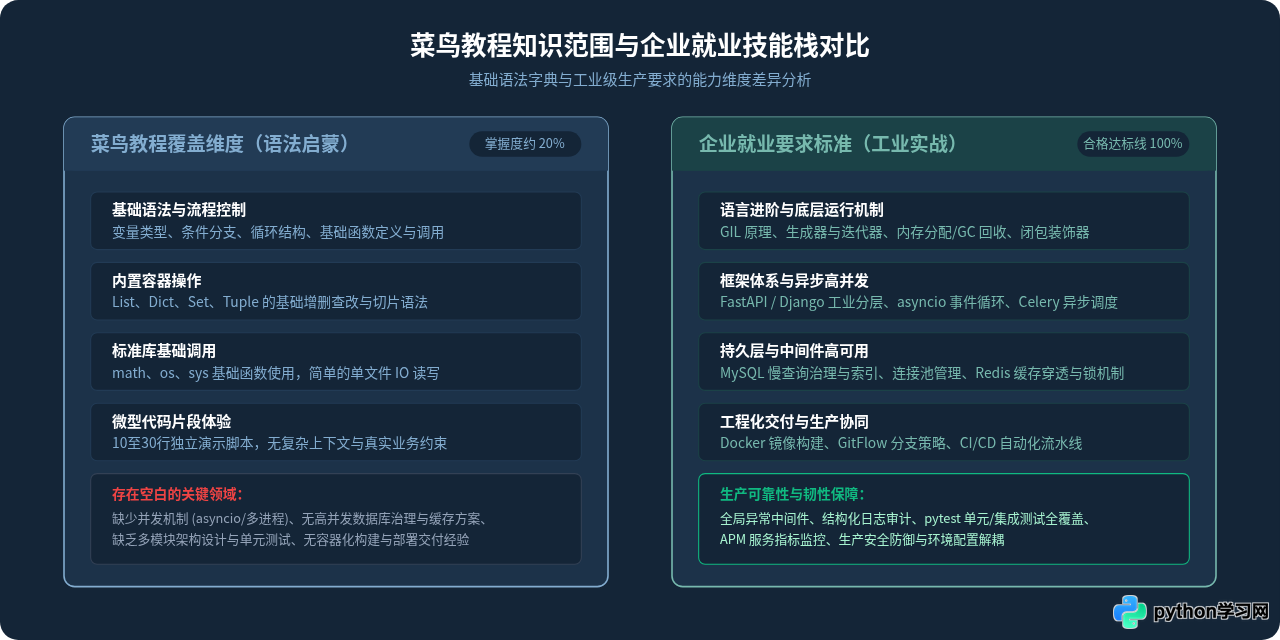
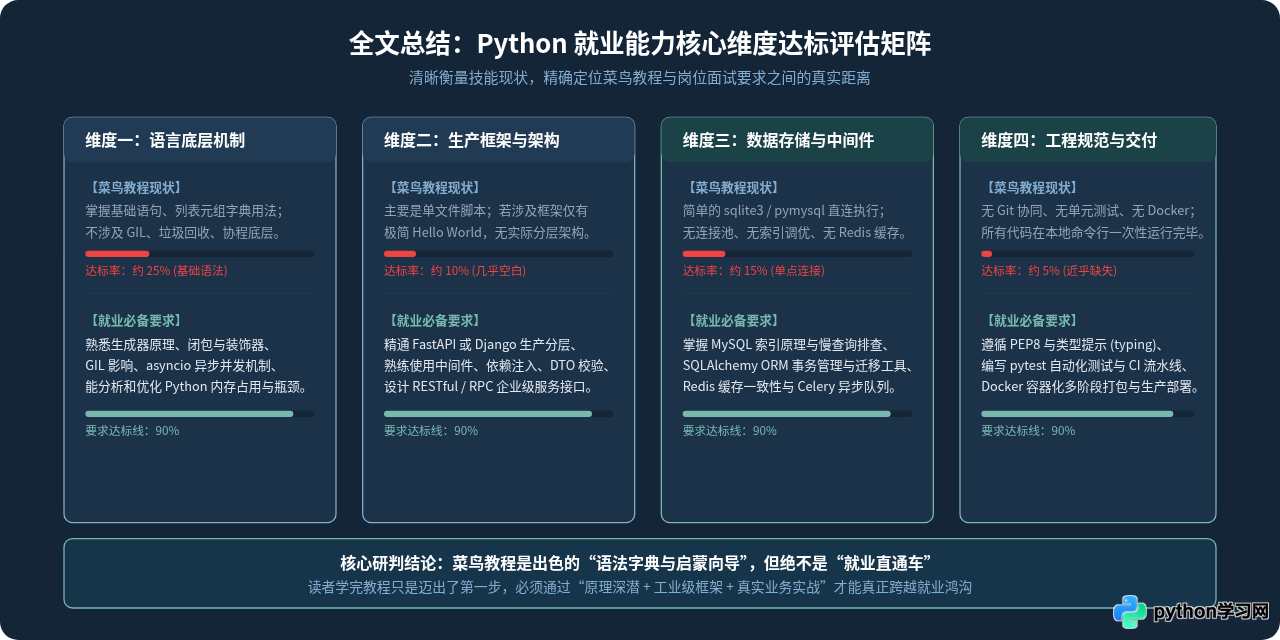
核心结论:菜鸟教程的 Python 内容深度完全无法满足企业直接就业的要求。菜鸟教程的本质是一部轻量级的“初学者语法字典与入门启蒙索引”,能够帮助零基础读者在数天内建立起变量、循环、分支与简单函数的语法概念;然而现代企业招聘 Python 岗位(无论是后端服务开发、自动化测试还是数据与运维工程),考察的核心是底层运行机制、生产级框架分层、数据库事务与性能优化、高并发异步模型以及团队工程化交付能力。两者之间存在 70% 至 80% 的实战技术断层,仅凭学完菜鸟教程绝不可能直接拿到就业 Offer。
一、定位认知:菜鸟教程到底是一本什么书?
假设你是一名刚学完编程的新人,花了三周时间完整浏览了菜鸟教程的 Python3 专栏,从 print("Hello, World!") 逐节运行到了面向对象基础和文件操作,甚至把每一个交互式示例都点击运行并通过。当你信心满满地打开招聘软件,搜索“Python 工程师”或“Python 后端开发”时,岗位 JD(岗位职责与任职要求)上列出的往往是类似这样的要求:
- “熟练掌握 Python 高级特性,深入理解 GIL 机制、闭包、生成器及垃圾回收机制;”
- “精通 FastAPI 或 Django 框架,熟悉异步并发编程与事件循环(asyncio);”
- “熟练掌握 MySQL 数据库索引优化、事务隔离级别与锁机制,具备慢 SQL 排查与连接池调优经验;”
- “熟练使用 Redis 实现分布式锁、热点缓存设计与消息队列;”
- “熟悉 Docker 容器化打包、GitFlow 规范、自动化测试(pytest)及 CI/CD 交付流水线。”
面对这一系列工业级要求,你可能会产生巨大的困惑:“为什么我学完了整个教程,这些词汇在教程里几乎从未见过,或者仅仅是一句话带过?”这就是对教程工具定位认知的偏差。菜鸟教程的目标受众是完全没有编程概念的初学者,其内容编排采用“单点式语法陈列”原则:输入一行代码、输出一个结果,力求让初学者用最低的认知成本看懂什么是列表、字典或类定义。它是一部优秀的“语法词典”,但绝不是一套培养职业工程师的“工程教材”。
二、实战局限性深度剖析:为什么学完写不出真实项目?
很多学习者在学完基础语法后,尝试自己写一个简易项目(如博客系统或电商接口),却立即陷入“无从下手”的瘫痪状态。造成这种现象的根源在于四个不可逾越的实战局限性:
1. 缺乏工业级架构分层与解耦思维
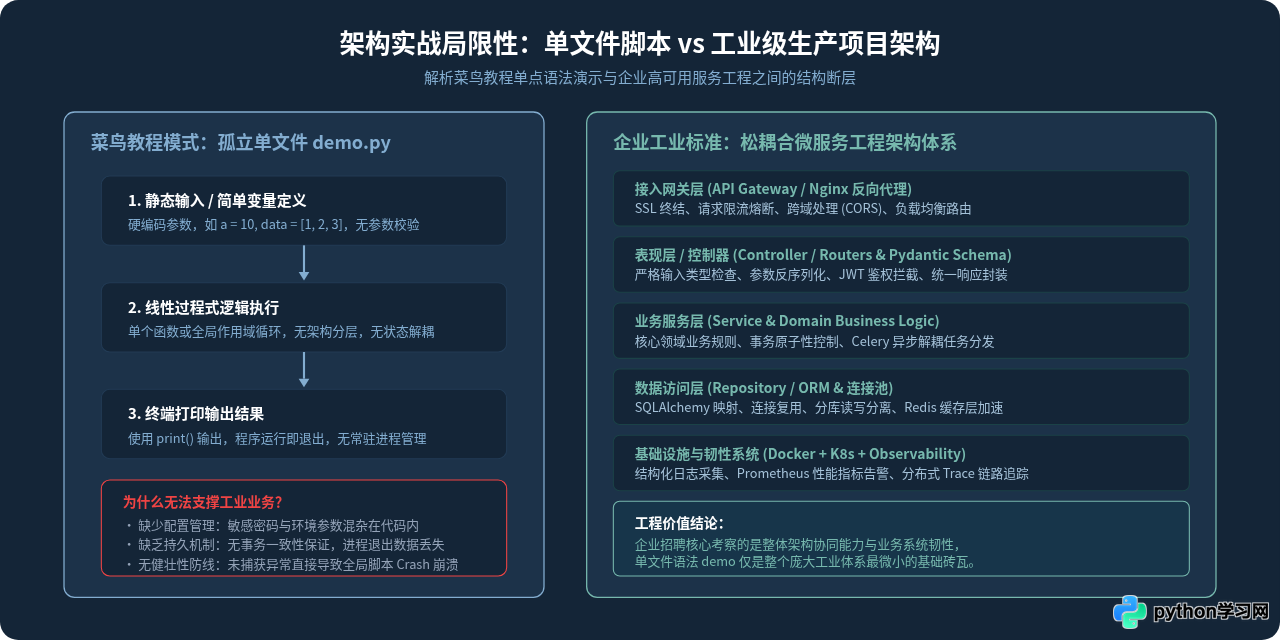
菜鸟教程中的代码通常存放在单个 .py 文件中,所有的业务逻辑、输入输出与数据处理均混杂在同一个脚本的作用域内。例如,教程在讲解函数时,演示代码往往是直接定义一个处理函数并在下方直接传入硬编码参数运行:
# 菜鸟教程风格:高度简化的单文件演示
def calculate_discount(price, rate):
    return price * rate

final_price = calculate_discount(100, 0.8)
print("折后价格:", final_price)
然而在真实企业的 Web 服务或后台系统中,任何一个业务接口都必须经过严格的分层解耦设计:表现层(Controller/Router)负责请求参数的反序列化与 DTO 校验;业务逻辑层(Service)负责事务控制、领域模型计算与第三方调用;数据持久层(DAO/Repository)负责构造查询语句、防范 SQL 注入并管理数据库连接。单文件脚本完全无法培养模块化设计、依赖注入(Dependency Injection)和领域驱动设计的工程能力。
2. 忽略高并发环境下的数据持久化与连接池管理
菜鸟教程涉及数据库交互的内容通常极为简略,一般仅用几行代码演示通过 sqlite3 或 pymysql 建立直接连接、执行一条简单的 SELECT 或 INSERT 语句后立即关闭连接。但在生产环境中:
- 连接复用与连接池:在高并发请求下,为每个请求频繁创建和销毁 TCP 数据库连接会导致服务器端口耗尽和数据库崩溃。企业必须使用连接池(如 SQLAlchemy Pool 或 asyncpg Pool),并精确配置最大连接数、溢出数量与超时回收策略;
- 事务隔离与锁机制:面对多用户并发下单、库存扣减等场景,必须理解数据库的行级锁、悲观锁/乐观锁,以及可重复读(RR)与读已提交(RC)隔离级别下的幻读与脏写问题;
- 缓存一致性:引入 Redis 缓存加速查询时,必须设计应对缓存穿透(布隆过滤器)、缓存击穿(互斥锁)与缓存雪崩(随机过期时间)的防护方案,并保证数据库与缓存的双写最终一致性。这些内容在菜鸟教程中完全缺席。
3. 缺少防御性编程与异常全链路治理
教程中的异常处理通常仅限于演示基础语法:try: ... except Exception as e: print(e)。这种做法在企业生产环境中是严重的质量隐患。真实的生产系统要求:
- 禁止空捕获或简单打印到控制台,必须使用标准化日志系统(如
logging或loguru)输出带有 TraceID、时间戳、调用栈上下文的结构化 JSON 日志; - 设置全局异常捕获中间件,区分客户端业务异常(4xx,返回规范的错误码与提示)与系统内部未知异常(5xx,触发报警并对客户端屏蔽敏感堆栈);
- 在分布式环境中配置健康检查接口、重试机制(指数退避算法)以及服务降级策略。
4. 缺失团队协同工具链与代码规范
单人学习编写小脚本时,代码排版不规范、变量名随意(如 a, b, data1)通常不会阻碍程序运行。然而在企业团队协同中,代码是写给人看的,只是顺便让机器运行。菜鸟教程完全不涵盖现代工业研发的基础工作流:没有 Git 团队分支规范(GitFlow / Trunk-based)、缺少 PEP8 与 Black 自动代码格式化、没有使用 Python 类型提示(Type Hints 与 mypy 静态检查),更没有自动化测试流水线。一个从未接触过这些工具的求职者,甚至无法顺利融入团队的第一轮代码审查(Code Review)。
三、突破局限:从入门走向就业的四阶段进阶路线
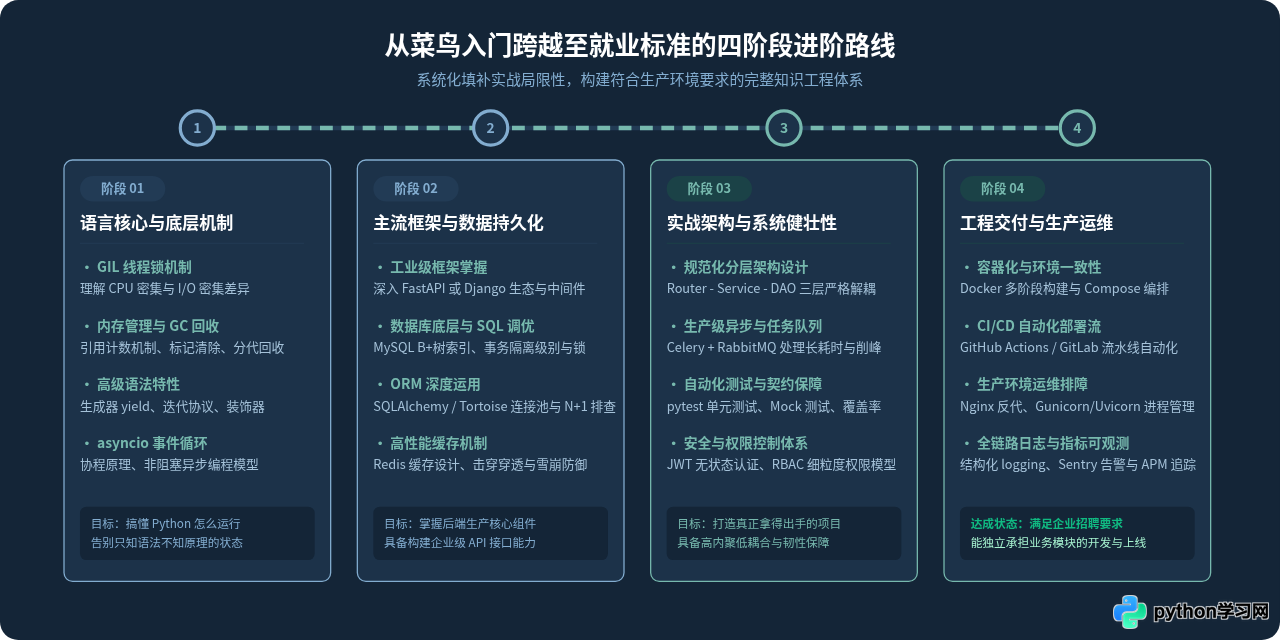
如果你已经完成了菜鸟教程的学习,说明你已经成功迈过了“零基础认识代码”的门槛。此时切忌在基础语法层面反复打转,而应按照以下四个阶段,系统性补齐工业级开发所需的技术图谱:
阶段一:深入 Python 底层机制与高阶特性
摆脱“只会调用函数”的初级阶段,深入探索 Python 解释器(CPython)的运行机制:
- GIL 与并发模型:搞清楚全局解释器锁(GIL)对多线程的制约机制,明确 CPU 密集型任务(使用
multiprocessing进程池)与 I/O 密集型任务(使用threading或asyncio)的技术选型差异; - 内存管理与垃圾回收:理解引用计数为主、标记清除与分代回收为辅的 GC 机制,掌握循环引用如何产生以及
weakref模块的适用场景; - 高级语言语法糖:不仅要会用装饰器,还要能手写带参数装饰器、类装饰器,理解闭包自由变量的绑定;掌握生成器(
yield与yield from)和上下文管理器(__enter__/__exit__)。
阶段二:精通生产级 Web 框架与数据中间件
挑选一个主流框架作为主攻方向(推荐现代化的 FastAPI 或成熟全面的 Django),并深入持久化技术栈:
- API 架构实践:使用 FastAPI + Pydantic 构建严格类型约束的 RESTful 接口,掌握依赖注入系统(
Depends)在数据库 Session 传递与权限鉴权中的应用; - 关系型数据库深度优化:学习 MySQL 的 InnoDB 引擎底层,掌握 EXPLAIN 执行计划分析、最左前缀索引匹配原则、避免隐式类型转换,理解读写分离架构;
- ORM 与连接池:熟练使用 SQLAlchemy 2.0,配置
create_engine的连接池参数(pool_size,max_overflow),解决经典的 N+1 查询问题; - Redis 高阶运用:不仅会使用基础数据结构,还要能编写分布式锁(Redlock/Lua 脚本保证原子性),设计多级缓存失效机制。
阶段三:独立构建包含完整业务闭环的工程项目
抛弃“图书管理系统”或“简易待办清单”等初级 Demo,设计并实现一个具备商业级复杂度的实战项目(例如:支持秒杀排队的高并发电商商城、基于 RBAC 权限的 SaaS 多租户后台管理系统,或者分布式任务采集分析平台):
- 解耦架构设计:严格执行 API-Service-Repository 三层架构,确保核心业务代码与外部依赖解耦;
- 异步任务削峰:接入 Celery + Redis/RabbitMQ,将耗时较长的邮件发送、报表生成、数据清洗异步化;
- 自动化测试驱动:使用
pytest编写单元测试和 API 集成测试,对数据库交互采用 Mock 或专用测试容器,将测试覆盖率提升至 70% 以上。
阶段四:工程化交付、容器化与运维协同
打通将代码从本地仓库部署至线上运行的“最后一公里”:
- 环境一致性与 Docker:编写多阶段构建的
Dockerfile,精简镜像体积;使用docker-compose一键编排 Web 服务、MySQL、Redis 及 Nginx 反向代理; - 生产级进程管理:掌握 Gunicorn / Uvicorn Worker 进程模型,配置合理的进程数与优雅停机(Graceful Shutdown)策略;
- CI/CD 与可观测性:配置 GitHub Actions 或 GitLab CI,实现代码提交后自动执行静态检查(flake8/mypy)、单元测试与镜像自动推流。
四、就业能力达标自测清单
如何客观判断自己的技术水平已经超越了“入门初学者”,达到了能够胜任企业初级工程师的门槛?你可以对照以下可执行的自测标准进行验证:
| 技术模块 | 菜鸟教程水平(不足以就业) | 企业达标水平(达到就业要求) | 验证方法 |
|---|---|---|---|
| 语言底层 | 知道 for 循环和 def 定义函数,能使用内置 list/dict。 | 理解 GIL 限制,清楚协程与线程区别,能手写通用装饰器与生成器。 | 能否在白板上实现一个支持重试次数与超时限制的通用装饰器。 |
| Web 框架 | 仅能在单文件内写出几个接收 GET 参数的简单接口。 | 熟练使用 FastAPI/Django,实现三层架构、DTO 验证、JWT 鉴权及中间件。 | 能否在 2 小时内独立搭建起包含 RBAC 鉴权与参数校验的 RESTful API 骨架。 |
| 数据库与缓存 | 使用直接直连执行简单的 SELECT * FROM table。 |
掌握连接池调优,能使用 EXPLAIN 分析慢查询并合理建立联合索引;掌握 Redis 缓存与分布式锁。 |
面对一条耗时 800ms 的 SQL 语句,能否根据执行计划指出失效原因并完成调优。 |
| 工程化与规范 | 没有分支概念,代码存放在单文件或零散目录,无单元测试。 | 遵循 PEP8 与类型提示规范,熟练使用 GitFlow,编写 pytest 覆盖核心分支,具备 Dockerfile 编写能力。 | 能否提交一个通过 pre-commit 静态检查并通过 CI 自动化测试的合格 Pull Request。 |
五、结语与行动建议
菜鸟教程是一个门槛极低、体验友好的起点,它值得每一位零基础初学者作为第一站。然而,把“学完菜鸟教程”等同于“具备就业资格”,是许多自学者求职碰壁的核心根源。
正确的学习策略是:以菜鸟教程建立基本概念语法感(耗时 1-2 周),随后立即将其作为日常查阅的工具书归入书签;将 80% 以上的时间和精力投入到真实业务场景、主流工程框架、高并发存储方案以及端到端的 Docker 项目交付中。只有当你能够脱离单文件脚本、亲手设计并部署一套高可用、带测试、有日志监控的完整系统时,你才真正具备了叩开软件企业大门的就业实力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















