


Python中展平三维列表:循环、推导式与库函数对比
深入对比Python中展平三维列表的多种方案,涵盖多层for循环、嵌套列表推导式、itertools.chain以及NumPy等库函数,解析执行原理、代码可读性与性能边界。
将一个形如 [[[1, 2], [3, 4]], [[5, 6], [7, 8]]] 的三维嵌套列表拉平成一个纯粹的一维列表 [1, 2, 3, 4, 5, 6, 7, 8],是Python处理数据清洗、图像网格解析或矩阵转置时常遇到的问题。解决这一需求的核心路径主要有三条:常规三层 for 循环、嵌套列表推导式、以及标准库 itertools 或科学计算库 NumPy 的专门方法。本文将依次剖析它们的语法构造、数据解包逻辑与性能特点,并提供场景选择依据。
一、三维列表的数据结构与展平目标
所谓三维列表,在Python本质上是外层容器包裹着次层容器,次层容器再包裹着内层原子元素。展平(Flattening)的过程,就是将这三层括号逐步拆开,将其中的元素按原有顺序收集至单层线性结构中。
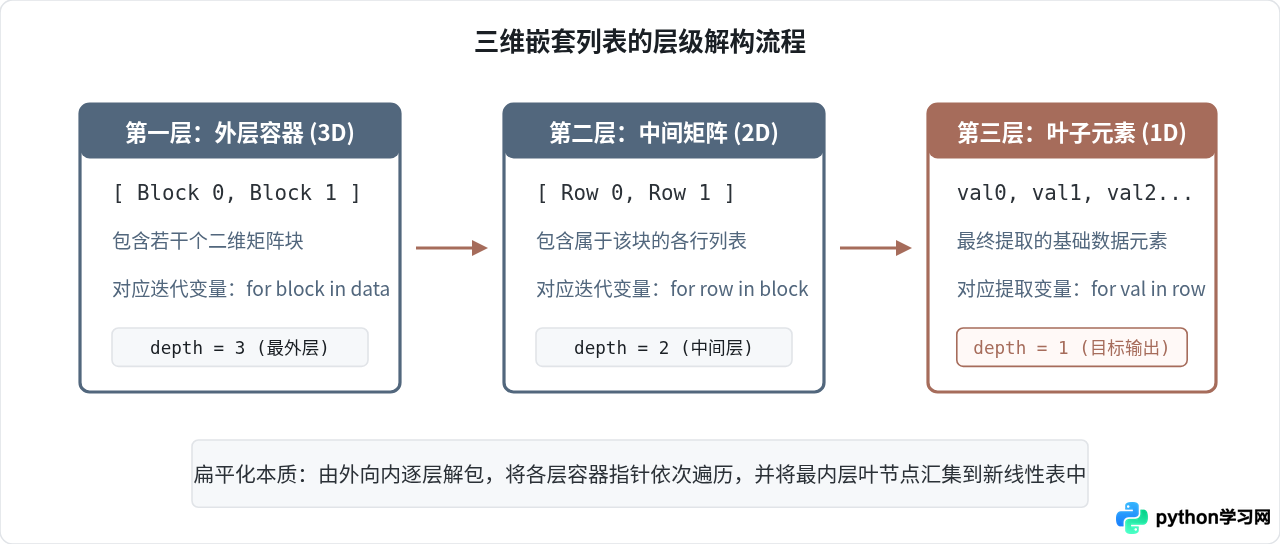
我们定义统一的示例数据,以便后续所有实现方式输出一致的验证结果:
# 示例三维列表:包含2个二维列表,每个二维列表包含2个一维列表
nested_3d = [
    [[1, 2], [3, 4]],
    [[5, 6], [7, 8]]
]
# 预期目标:[1, 2, 3, 4, 5, 6, 7, 8]
二、常规方案:三层 for 循环
三层循环是初学者最容易想到的直观写法。它按照数据实际的嵌套深度依次展开:外层遍历二维矩阵、中层遍历行列表、内层遍历单个元素并将其 append 到目标列表中。
flattened = []
for sub_2d in nested_3d:
    for sub_1d in sub_2d:
        for item in sub_1d:
            flattened.append(item)

print(flattened)
# 示例输出: [1, 2, 3, 4, 5, 6, 7, 8]
这种写法的优点是结构透明,可以在内层循环随意加入条件过滤或类型校验。缺点在于代码行数偏多,且在Python解释器层面,频繁调用 list.append() 会产生不小的函数调用开销,执行速度较慢。
三、Pythonic方案:嵌套列表推导式
嵌套列表推导式是Python处理列表展平时最紧凑且优雅的原生语法。很多开发者初次编写三层推导式时容易将循环顺序写反。在推导式中,for 语句的书写顺序与普通嵌套 for 循环从外到内的阅读顺序是一致的。
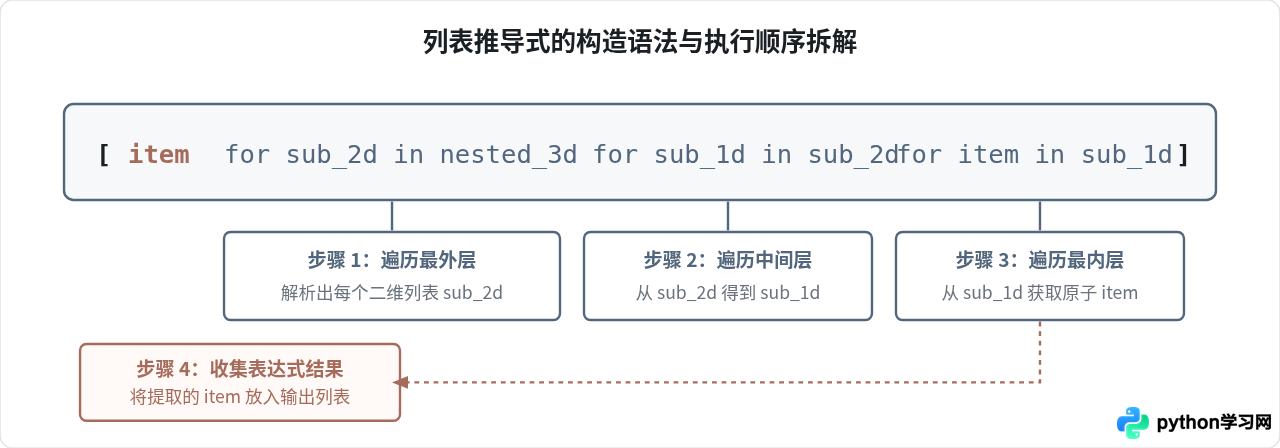
对应实现代码非常简练:
flattened = [item for sub_2d in nested_3d for sub_1d in sub_2d for item in sub_1d]
print(flattened)
# 示例输出: [1, 2, 3, 4, 5, 6, 7, 8]
推导式由底层C代码优化构建,省去了Python层的方法属性解析与每次扩容的显式方法调用,运行速度通常显著快于普通for循环加append。
四、标准库与高性能库函数方案
除了纯语言层面的语法结构,Python标准库与第三方科学计算库也提供了专门的抽象工具。
1. 使用 itertools.chain.from_iterable
itertools.chain.from_iterable 是高效合并可迭代对象的利器。对于三维列表,需要连续进行两次由外向内的链接(因为三维降到一维跨越了两层容器嵌套):
import itertools

# 第一次调用:将 3D 解包为 2D 迭代器
level_2d = itertools.chain.from_iterable(nested_3d)

# 第二次调用:将 2D 解包为 1D 迭代器,最后统一转换为列表
flattened = list(itertools.chain.from_iterable(level_2d))

print(flattened)
# 示例输出: [1, 2, 3, 4, 5, 6, 7, 8]
该方法完全基于生成器惰性求值运行,在中间过程不会分配多余的临时列表内存,非常适合数据量较大、内存受限的环境。
2. 使用 NumPy 的 flatten / ravel
在数值计算或规则多维矩阵处理场景中,numpy.array 提供了硬件级的连续内存拉平能力:
import numpy as np

arr = np.array(nested_3d)
flattened = arr.flatten().tolist()

print(flattened)
# 示例输出: [1, 2, 3, 4, 5, 6, 7, 8]
需要注意:NumPy要求各维度的子列表形状规则一致(矩形/立方体对齐)。如果子列表长短不齐(不规则锯齿列表),转换过程可能会出现警告或类型降级为对象数组,无法发挥连续C数组的性能优势。
五、多维度技术方案对比
为了直观展现各方案在日常开发中的取舍,下表从可读性、执行性能、内存开销及对不规则数据的容忍度四个核心指标进行横向对比:
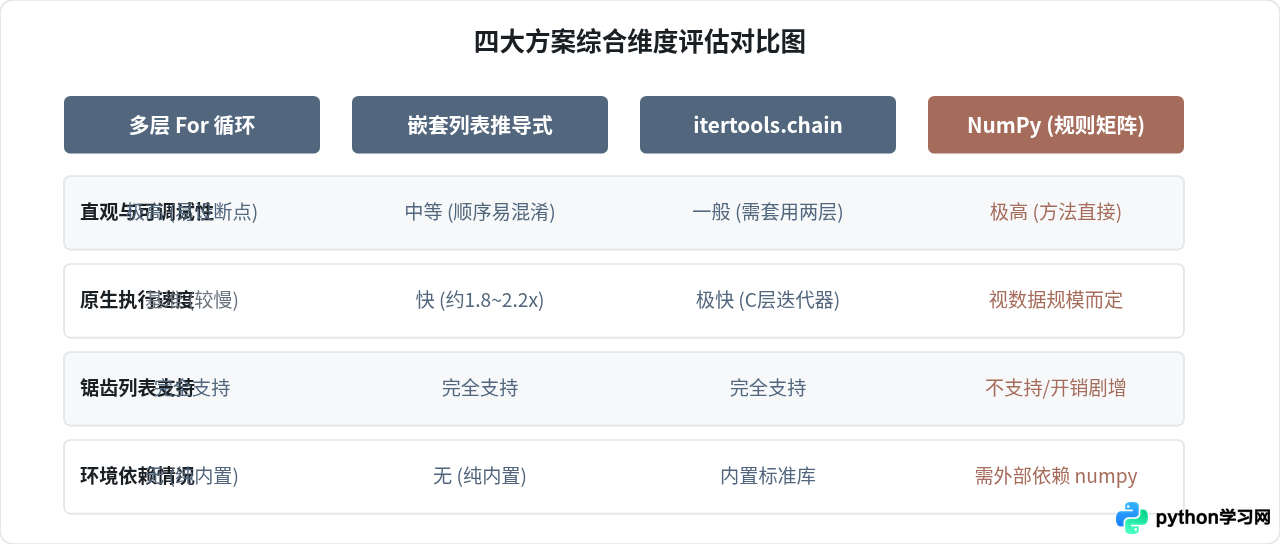
| 实现方式 | 典型耗时对比 (基准相对值) | 主要优势 | 主要不足 |
|---|---|---|---|
| 三层 For 循环 | 1.0x (基准耗时) | 逻辑浅显,容易在内部追加过滤分支与断点 | Python调用开销高,代码冗长 |
| 三层列表推导式 | ~0.48x | 单行简洁,执行速度快,代码地道 | 排版长时不易阅读,顺序颠倒易引发语法错误 |
| itertools.chain | ~0.38x | 生成器内存利用率高,底层C实现流式迭代 | 三维数据需嵌套两层 from_iterable,初看略显抽象 |
| NumPy flatten | 视数据形态差异极大 | 科学计算场景下与数组生态无缝结合 | 非数组工程引入重量级依赖,类型转化有成本 |
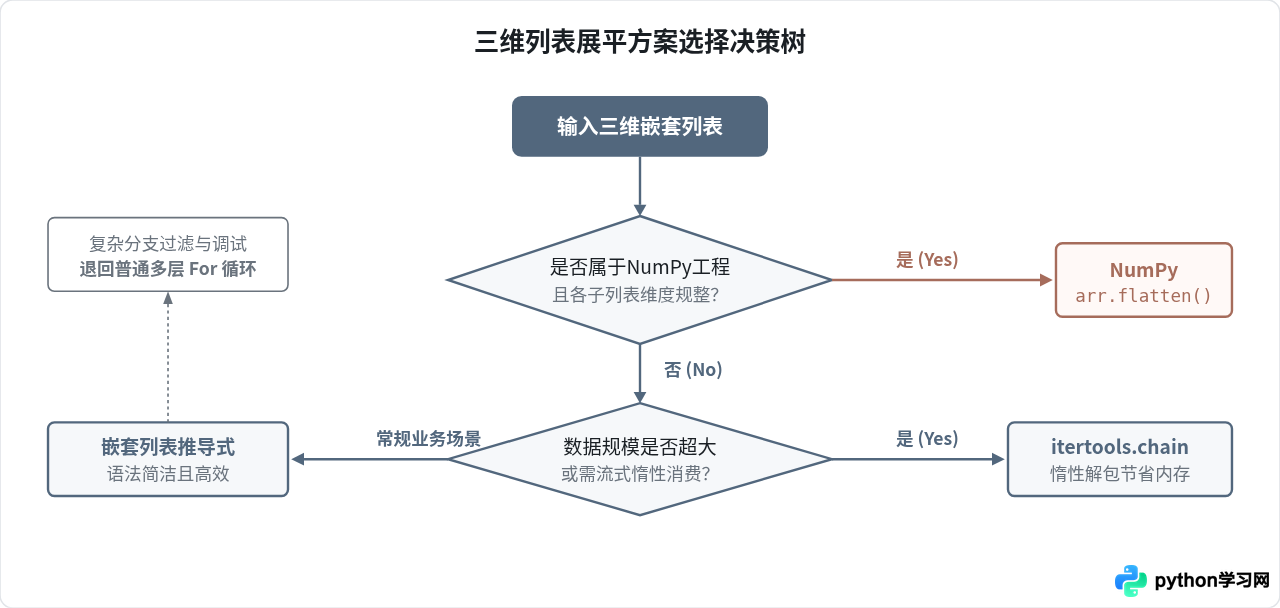
六、决策建议与总结流程
面对具体业务场景,选择哪种方案取决于手头数据的规模、整齐程度以及所处的项目依赖环境:
1. 如果你正在维护一个纯Python工程,追求代码既短小又有良好性能,列表推导式是绝大多数场景下的第一选择。
2. 如果三维列表规模非常大(数十万以上元素),或者你希望以流式生成器逐项产出消费以防爆内存,itertools.chain.from_iterable 表现最为稳健。
3. 如果你的三维列表来自机器学习、图像张量等已经是 numpy.ndarray 的对象,直接调用其 .flatten() 或 .ravel() 即可,无需在纯Python列表层面反复转换。
for 的书写顺序与多层循环展开顺序完全一致(外层在先、内层在后),而用于收集的最内层元素变量则固定放在最左侧。牢记这一顺序规律,即可在兼顾代码可读性的同时规避常见的 NameError 或展开逻辑混乱。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















