


Python基础数据类型练习题:数字、字符串与列表经典例题解析
针对Python初学者在数字、字符串与列表三种核心数据类型中的经典练习题进行详细解析,包含类型转换、字符串清洗回文判断、列表去重与切片变形等典型场景。
在学习 Python 的过程中,数字(int、float)、字符串(str)与列表(list)构成了程序逻辑处理的基石。很多初学者在分别看懂语法规则后,面对实际代码编写仍然会感到无从下手。本文通过精选的几个典型练习题,围绕数值精度与进制转换、字符串清洗与回文判定、列表统计与原地去重等核心操作,逐题解析解题思路、代码实现及常见陷阱,帮助读者切实巩固对基础数据类型的理解与运用能力。
一、数字类型练习:精度控制与进制转换
Python 中的数字主要包括整数(int)与浮点数(float)。由于计算机内部采用二进制表示小数,浮点数运算常常伴随着精度舍入问题;而在不同系统交互或底层数据解析时,进制转换也是极为基础的能力。
例题 1:商品折扣与货币四舍五入计算
题目要求:给定一件商品的原价(如 199.9 元)和折扣率(如 0.85),计算折后价格,并严格保留两位小数输出。要求处理类似 0.1 + 0.2 带来的浮点精度不准确现象。
# 示例代码:商品折后价计算
from decimal import Decimal, ROUND_HALF_UP

original_price = "199.9"
discount = "0.85"

# 使用 Decimal 避免浮点数存储误差
price_dec = Decimal(original_price)
discount_dec = Decimal(discount)
total = price_dec * discount_dec

# 严格执行四舍五入到两位小数
final_price = total.quantize(Decimal("0.01"), rounding=ROUND_HALF_UP)
print(f"原价: {original_price},折后价: {final_price}")

# 示例输出:
# 原价: 199.9,折后价: 169.92避坑提示:Python 内置的 round() 函数采用“奇进偶舍”(Banker's rounding)规则,并非传统数学上的四舍五入。涉及货币等敏感计算时,建议传入字符串构造 Decimal,并指定 ROUND_HALF_UP。
例题 2:十进制转二进制、八进制与十六进制
题目要求:输入一个正整数,输出其对应的无前缀二进制、八进制及大写十六进制字符串。
# 示例代码:格式化进制转换
num = 254

# 使用内置 format 函数,指定格式符 'b'、'o'、'X'
bin_str = format(num, 'b')
oct_str = format(num, 'o')
hex_str = format(num, 'X')

print(f"十进制: {num}")
print(f"二进制: {bin_str}")
print(f"八进制: {oct_str}")
print(f"十六进制: {hex_str}")

# 示例输出:
# 十进制: 254
# 二进制: 11111110
# 八进制: 376
# 十六进制: FE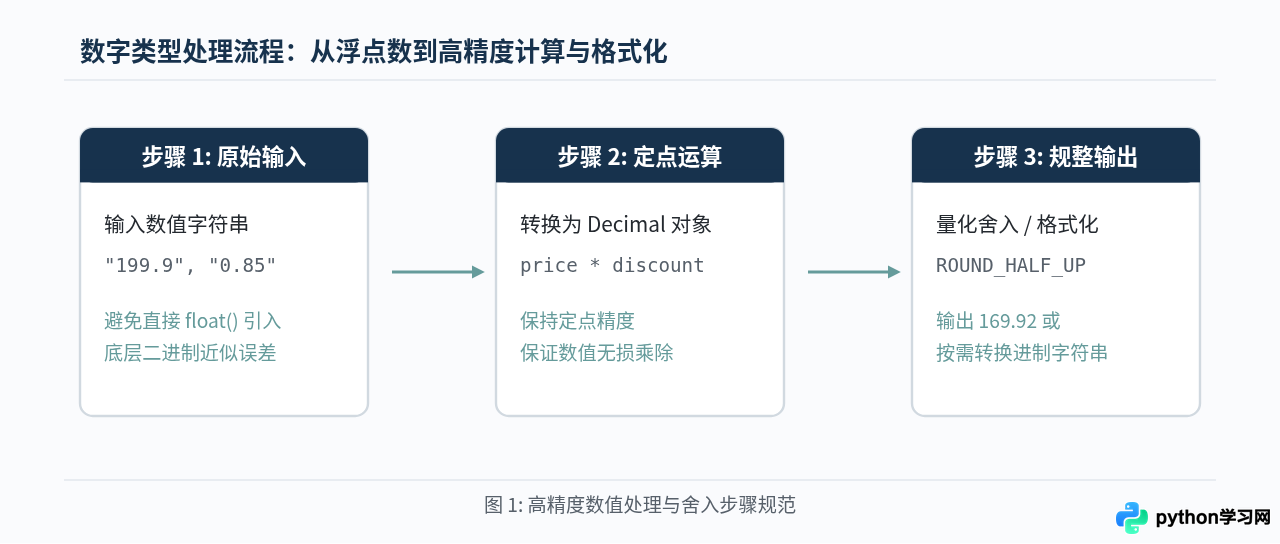
二、字符串类型练习:文本清洗与结构判定
字符串在 Python 中是不可变序列(immutable sequence)。无论对字符串执行何种替换、拼接或切片,原字符串都不会改变,而是返回一个全新的字符串对象。常见练习题通常考查对字符遍历、条件过滤和切片步长机制的熟练度。
例题 3:有效回文字符串检验
题目要求:给定一个可能包含大小写字母、数字、空格及标点符号的字符串,忽略所有非字母数字字符且忽略大小写,判断其是否为回文字符串(正读与反读完全一致)。
# 示例代码:双向验证回文字符串
def is_valid_palindrome(text: str) -> bool:
    # 步骤 1: 过滤字符并统一转为小写
    cleaned_chars = [ch.lower() for ch in text if ch.isalnum()]

    # 步骤 2: 重新组装字符串
    cleaned_text = "".join(cleaned_chars)

    # 步骤 3: 利用切片步长 [::-1] 反转并对比
    return cleaned_text == cleaned_text[::-1]

test_cases = [
    "A man, a plan, a canal: Panama",
    "race a car",
    "No lemon, no melon"
]

for item in test_cases:
    result = is_valid_palindrome(item)
    print(f"原句: \"{item}\" -> 回文判定: {result}")

# 示例输出:
# 原句: "A man, a plan, a canal: Panama" -> 回文判定: True
# 原句: "race a car" -> 回文判定: False
# 原句: "No lemon, no melon" -> 回文判定: True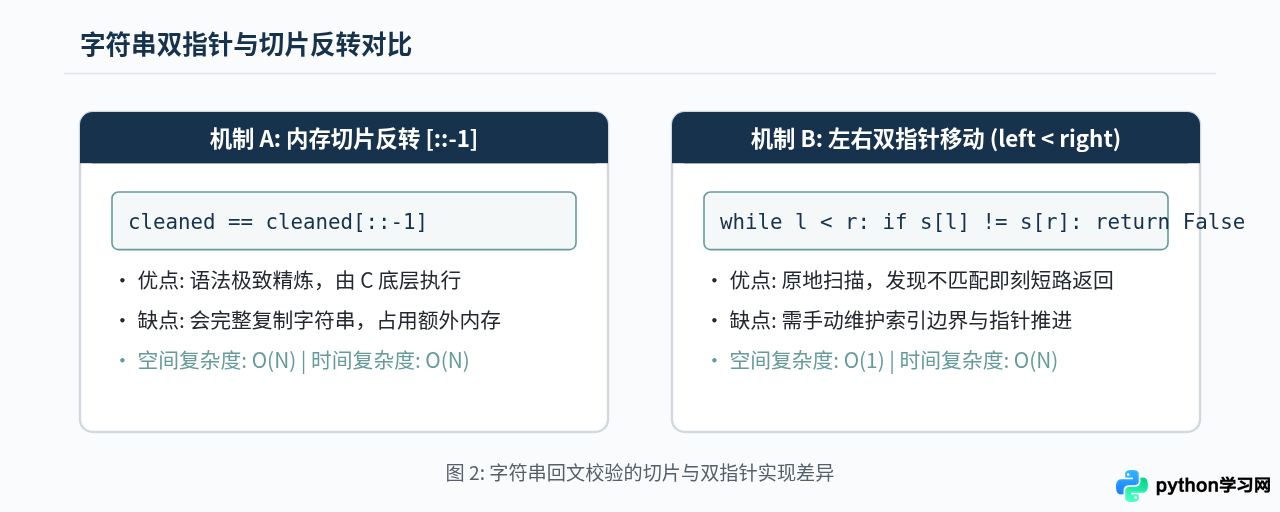
例题 4:词频统计与标点清洗
题目要求:统计一段英文段落中每个单词出现的次数,要求忽略大小写,并去除单词周围的标点符号(如句号、逗号、感叹号)。
# 示例代码:基础词频统计
import string

paragraph = "Python is powerful, and Python is easy to learn! Is it true?"

# 移除标点并转为小写
clean_text = paragraph.lower()
for p in string.punctuation:
    clean_text = clean_text.replace(p, " ")

# 拆分为单词列表
words = clean_text.split()

# 统计词频
word_count = {}
for word in words:
    word_count[word] = word_count.get(word, 0) + 1

# 按出现频次倒序排列
sorted_words = sorted(word_count.items(), key=lambda item: item[1], reverse=True)
for w, count in sorted_words:
    print(f"{w}: {count}")

# 示例输出:
# python: 2
# is: 3
# powerful: 1
# and: 1
# easy: 1
# to: 1
# learn: 1
# it: 1
# true: 1
三、列表类型练习:切片、变异与有序去重
与字符串不同,列表(list)是可变序列(mutable sequence)。你可以随时向列表追加元素、删除指定项或原地排序。初学者的经典痛点主要集中在:在循环遍历列表的同时修改列表元素导致索引错位,以及如何保持元素原有顺序进行去重。
例题 5:保持顺序的列表去重
题目要求:给定一个包含重复元素的列表,移除所有重复项,并且保留元素首次出现的先后次序。
# 示例代码:保序去重方案
raw_list = [3, 1, 2, 3, 4, 1, 5, 2, 6, 4]

# 方法一:利用 Python 3.7+ 字典键有序特性(简洁高效)
unique_ordered_dict = list(dict.fromkeys(raw_list))

# 方法二:集合辅助遍历(逻辑通用)
seen = set()
unique_ordered_loop = []
for item in raw_list:
    if item not in seen:
        seen.add(item)
        unique_ordered_loop.append(item)

print(f"原列表: {raw_list}")
print(f"去重后(字典法): {unique_ordered_dict}")
print(f"去重后(循环法): {unique_ordered_loop}")

# 示例输出:
# 原列表: [3, 1, 2, 3, 4, 1, 5, 2, 6, 4]
# 去重后(字典法): [3, 1, 2, 4, 5, 6]
# 去重后(循环法): [3, 1, 2, 4, 5, 6]避坑提示:许多初学者直接使用 list(set(raw_list)),虽然成功去除了重复值,但由于集合(set)本身是无序哈希表,原有元素的相对次序被打乱。因此需要有序去重时,请使用上述两种方案。
例题 6:滑动窗口均值计算(列表切片进阶)
题目要求:给定一个数值列表和一个固定窗口大小 k,计算每个连续窗口内数字的平均值,返回新的平均值列表。
# 示例代码:滑动窗口计算
def moving_average(data: list, k: int) -> list:
    if not data or k <= 0 or k > len(data):
        return []

    averages = []
    # 窗口起点从 0 遍历到 len(data) - k
    for i in range(len(data) - k + 1):
        window = data[i:i + k]
        window_avg = sum(window) / k
        averages.append(round(window_avg, 2))
    return averages

scores = [10, 20, 30, 40, 50, 60, 70]
window_size = 3
result = moving_average(scores, window_size)

print(f"原始数据: {scores}")
print(f"窗口大小: {window_size}")
print(f"滑动均值: {result}")

# 示例输出:
# 原始数据: [10, 20, 30, 40, 50, 60, 70]
# 窗口大小: 3
# 滑动均值: [20.0, 30.0, 40.0, 50.0, 60.0]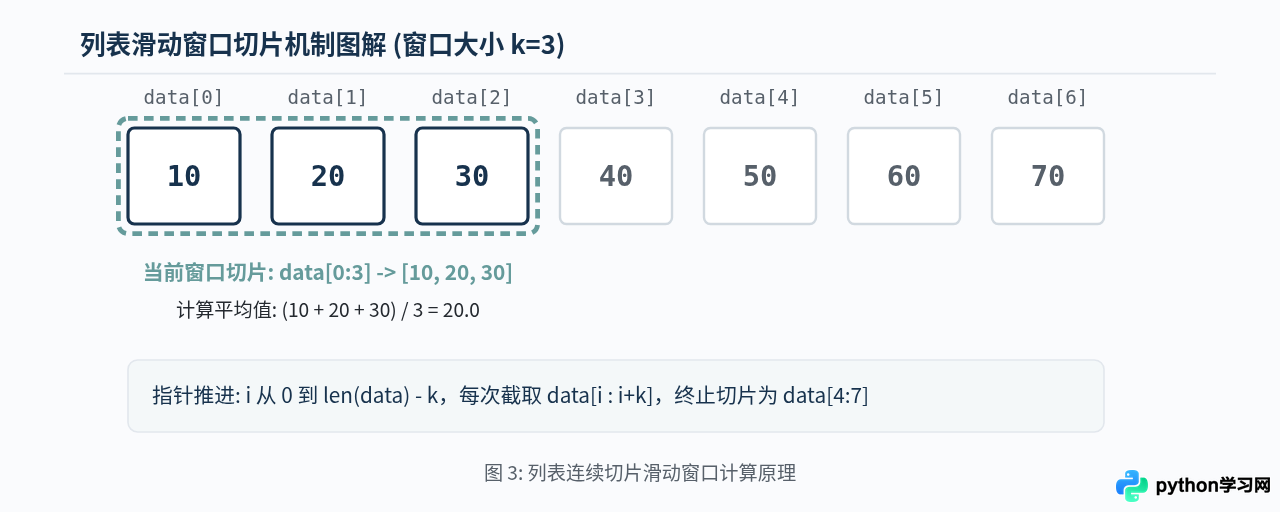
四、三类数据特性对比与总结
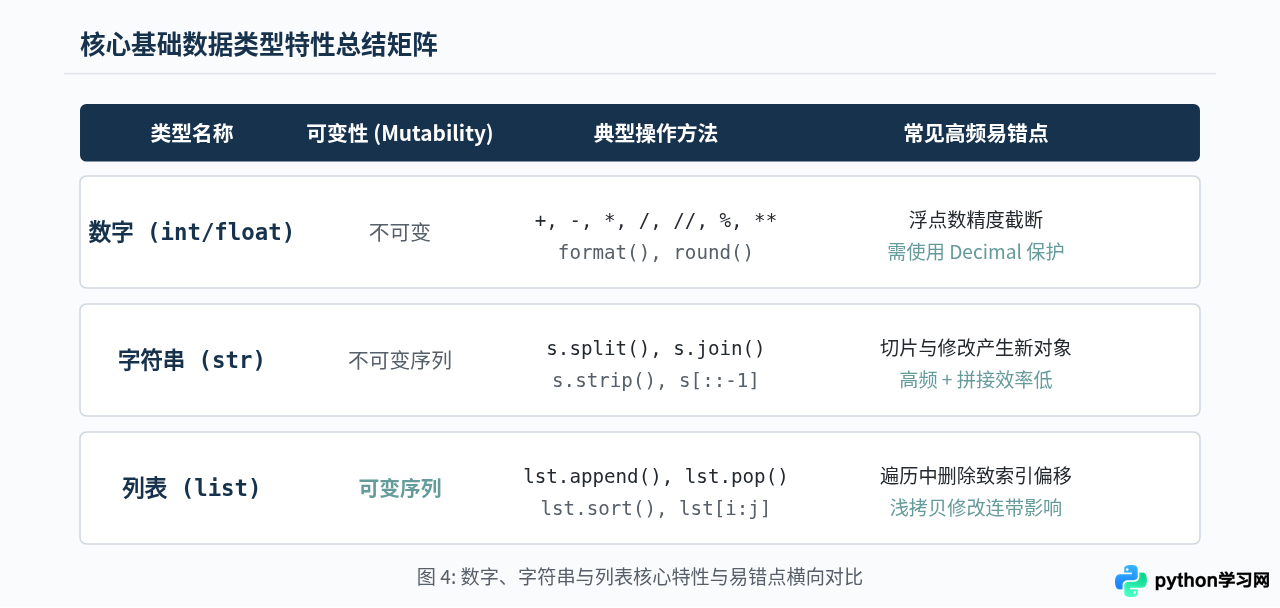
综合以上例题,数字、字符串与列表在底层存储机制与操作行为上有本质区别。在实际开发中,需要根据不可变性(Immutability)、有序性(Order)以及时间复杂度选择合适的数据结构与处理手法。
五、学习建议与常见问题答疑
- 为什么不能在 for 循环遍历列表时直接
list.remove()?
因为remove()会使列表长度即时发生变化,后续元素的索引向前平移,而for循环基于自增索引继续移动,这会导致紧邻被删元素后面的那一项被直接跳过。安全做法是使用列表推导式生成新列表,或者倒序遍历。 - 字符串频次统计时,大量拼接
+=为何较慢?
字符串具有不可变性,每次+=都在内存中重新申请空间并拷贝所有旧字符,当字符串很长或循环次数很多时,时间复杂度会劣化为 \(O(N^2)\)。推荐先收集到列表中,最终使用"".join(list)一次性拼接。 - 如何选择切片还是双指针?
在竞赛或内存受限的大规模数据流场景下,双指针能够实现 \(O(1)\) 的额外空间占用;而在日常业务或简短脚本中,Python 原生切片s[::-1]执行效率极高且可读性最佳。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















