


Python爬虫怎么处理Requests禁止自动重定向
深入讲解在Python爬虫开发中如何使用Requests库禁止自动重定向,涵盖allow_redirects参数配置、301与302状态码捕获、Location头解析与相对路径补全、Session会话保持及反爬风控防御等关键技术细节。
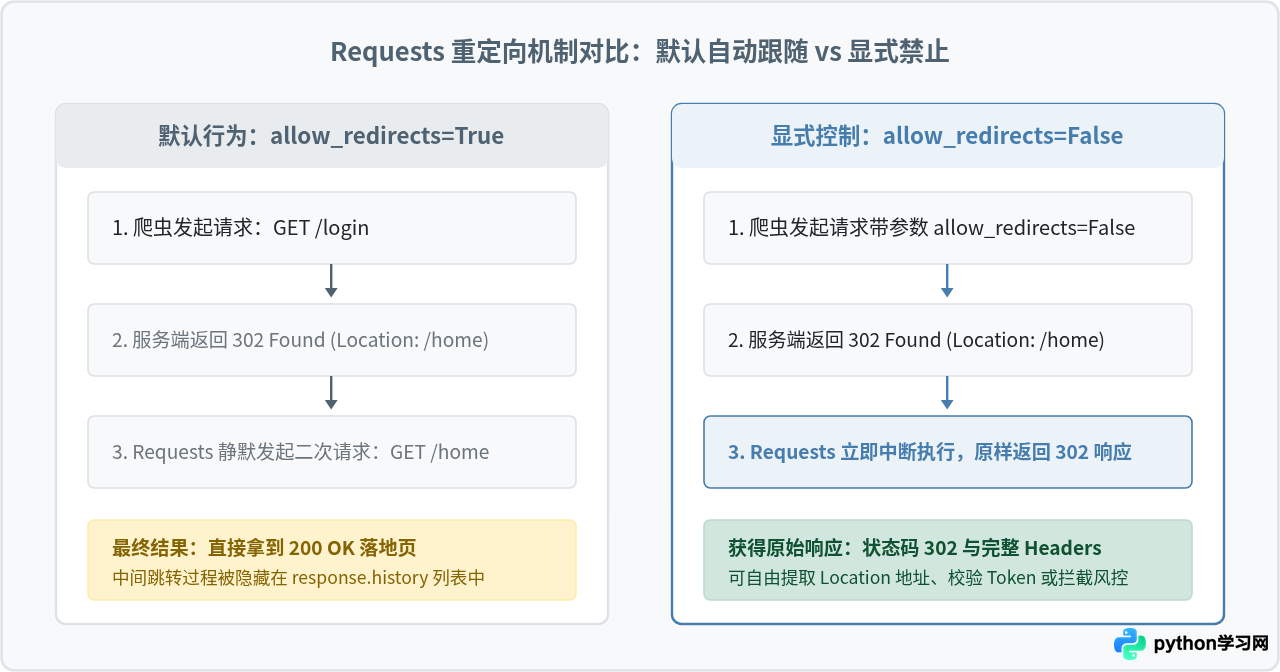
在 Python 爬虫开发中使用 Requests 库时,默认发起的 HTTP GET 或 POST 请求会自动追踪服务端的 301、302 等重定向跳转,直接返回最终落地页的响应内容;若要禁止这种自动跟随行为,只需在请求方法中显式传入 allow_redirects=False 参数。此时 Requests 会在收到第一个跳转响应时立即返回,保留原始的 30x 状态码与完整的响应头,使爬虫能够精准截获重定向中间地址、解析认证凭据或识别反爬风控策略。
一、为什么爬虫需要显式禁止自动重定向
HTTP 协议中,301(永久移动)、302(临时移动)、303(查看其它地址)和 307/308(临时/永久重定向且保持请求方法)是服务端常见的跳转状态。当服务端返回这些状态码时,会在响应头的 Location 字段中指定下一个访问目标。Requests 的默认设计倾向于普通浏览器行为,即底层默默发起后续请求,直到拿到 200 响应为止。然而在很多特定爬虫场景下,这种静默追踪不仅会丢失关键数据,还可能引发异常:
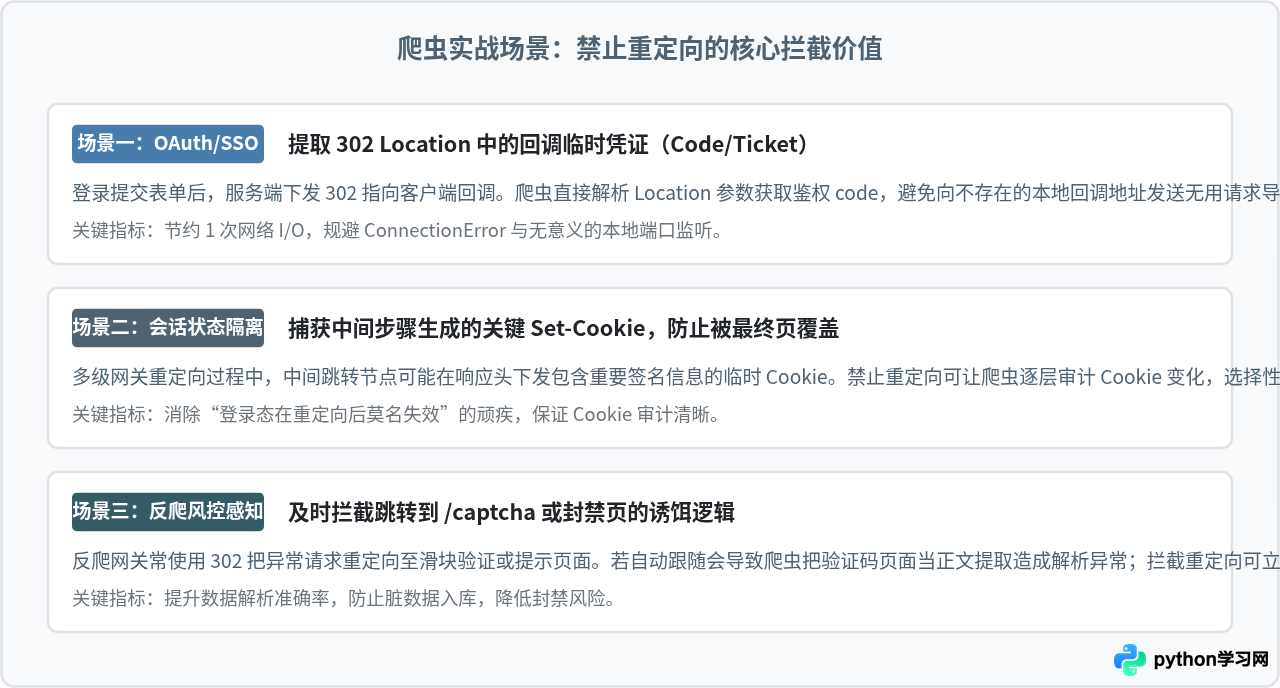
- 截获鉴权凭据与临时令牌:例如 OAuth 2.0 授权、单点登录(SSO)以及各类账号登录流程中,服务端验证成功后通常通过 302 重定向到回调地址,并在 URL 的查询参数中携带
code、token或ticket。若开启自动跳转,不仅多消耗一次网络往返,甚至可能因回调服务未启动或跨域校验而导致请求报错。 - 拦截并隔离中间 Cookies:部分服务端在下发 302 重定向的同时会通过
Set-Cookie返回会话凭据,而随后的目标落地页可能由另一台服务器接管并重写 Cookies。禁止重定向允许开发者精准捕获这一瞬间的状态。 - 规避反爬重定向陷阱:当爬虫请求过于频繁被目标站点识别时,反爬网关往往不会直接返回 403,而是 302 重定向到验证码页面(如
/captcha)或登录拦截页。如果任由程序自动跟随,解析模块可能会因找不到预期的数据节点而崩溃;禁止重定向则能第一时间察觉重定向行为并切换代理。 - 优化探测性能:在检测大量链接是否存活、校验 CDN 跳转规则时,只需读取头部并确认跳转目标,无需下载落地页庞大的 HTML 或多媒体文件。
二、禁止自动重定向的五步标准处理流程
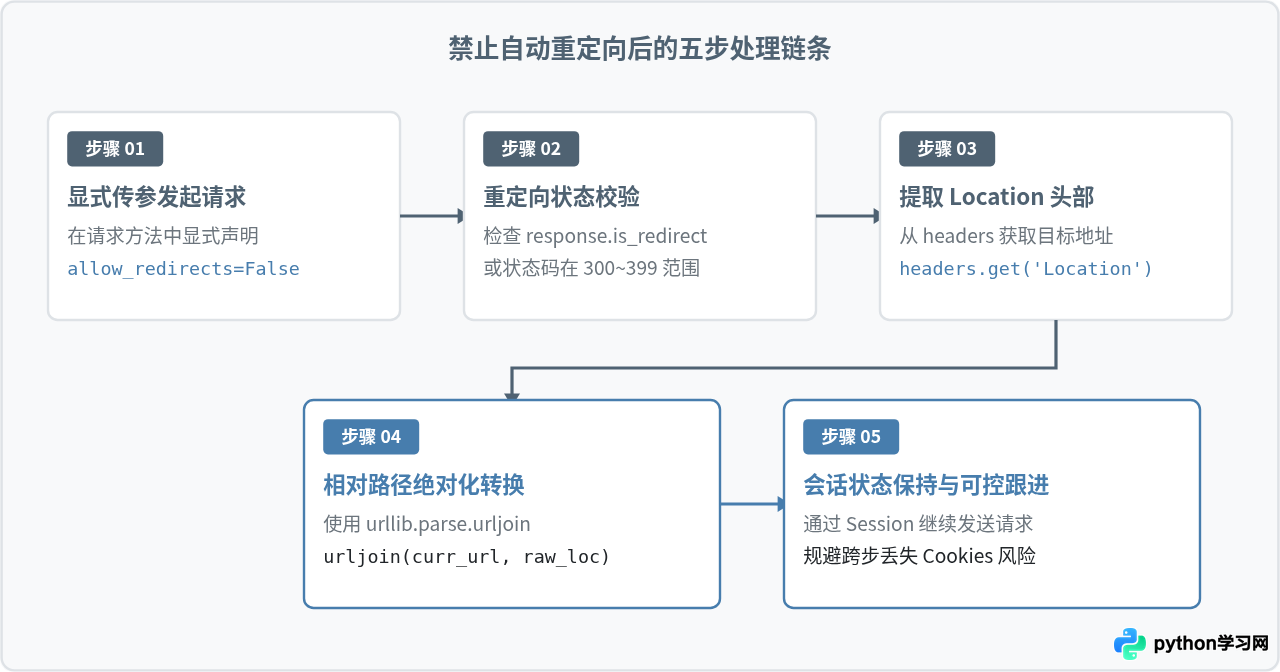
禁止重定向并不是简单地在方法里加一个参数,而是需要配套完整的判断、解析与后继处理逻辑。一个规范的爬虫处理链路通常分为以下五个阶段:
- 发起请求并传参:在
requests.get()或requests.post()中设置allow_redirects=False。 - 验证状态码特征:利用
response.is_redirect属性或显式判断response.status_code in (301, 302, 303, 307, 308)。 - 提取目标重定向地址:从响应头中读取
response.headers.get('Location')。由于 HTTP 头部字段不区分大小写,Requests 的大小写无关字典支持小写或大写读取。 - 相对路径绝对化补全:很多站点返回的
Location仅仅是相对路径(例如/index.html或../welcome),必须使用标准库urllib.parse.urljoin结合请求源地址进行拼接,防止后续请求产生 404 错误。 - 维持会话上下文并按需跟进:如果需要继续追踪,应借助
requests.Session实例发起下一轮调用,以确保服务端下发的Set-Cookie会话状态能够正确沿袭。
三、核心代码实现与边界场景处理
以下示例展示了在 Python 爬虫中通过 requests.Session 捕获重定向、解析参数并安全跟进的完整代码模式:
import requests
from urllib.parse import urljoin, urlparse, parse_qs

def fetch_with_controlled_redirect(target_url, headers=None):
    # 使用 Session 确保多步请求间的 Cookie 能自动传递
    session = requests.Session()
    if headers:
        session.headers.update(headers)

    # 步骤 1:显式禁用自动重定向
    response = session.get(target_url, allow_redirects=False, timeout=10)

    print(f"[示例输出] 响应状态码: {response.status_code}")

    # 步骤 2:校验是否处于重定向状态
    if response.is_redirect:
        raw_location = response.headers.get("Location")
        print(f"[示例输出] 原始 Location 响应头: {raw_location}")

        if not raw_location:
            print("[警告] 状态码为 30x 但未返回 Location 头部")
            return response

        # 步骤 3 与 4:处理相对路径并提取 URL 查询参数
        absolute_next_url = urljoin(target_url, raw_location)
        print(f"[示例输出] 补全后的绝对跳转地址: {absolute_next_url}")

        # 解析重定向 URL 中可能包含的鉴权 Token
        parsed = urlparse(absolute_next_url)
        params = parse_qs(parsed.query)
        if "code" in params:
            print(f"[示例输出] 成功拦截到鉴权 Code: {params['code'][0]}")
            # 若业务仅需该 Code,此时即可终止流程,无需发起后续网络请求
            return response

        # 步骤 5:按需向新地址发起受控的后续请求
        next_response = session.get(absolute_next_url, allow_redirects=False, timeout=10)
        return next_response

return responseRequests 中不同的 HTTP 方法对 allow_redirects 的默认值设置不同:
requests.get()、requests.post()、requests.put():默认allow_redirects=True。requests.head():默认allow_redirects=False。若使用 HEAD 方法探测最终真实目标,需要显式设置allow_redirects=True。
四、爬虫实战进阶场景与核心拦截价值
在面对复杂的生产环境反爬或认证体系时,合理控制重定向行为能够极大提高爬虫的健壮性。以下三个典型业务场景展示了禁止重定向的核心价值:
1. 防范无限重定向与死循环陷阱
有些网站存在配置缺陷或故意设计了反爬“黑洞”(如 A 页面 302 跳到 B,B 页面又跳回 A)。Requests 在默认开启重定向时,内部由 max_redirects 参数(默认 30 次)控制上限,超出后会抛出 requests.exceptions.TooManyRedirects 异常。而在手动控制重定向时,推荐使用计数器维护最大跳转深度(一般设置为 3~5 次):
def safe_manual_redirect(session, start_url, max_hops=5):
    current_url = start_url
    visited = set()

    for hop in range(max_hops):
        if current_url in visited:
            raise RuntimeError(f"检测到重定向死循环: {current_url}")
        visited.add(current_url)

        resp = session.get(current_url, allow_redirects=False, timeout=8)
        if not resp.is_redirect:
            # 已经抵达非重定向页面(如 200 OK)
            return resp

        location = resp.headers.get("Location")
        if not location:
            break
        current_url = urljoin(current_url, location)

    raise RuntimeError("超出最大重定向跳数限制")
2. 查看默认跟随模式下的历史跃点:response.history
如果不需要在中间中断,但事后需要追溯整个跳转链路,Requests 提供了 response.history 列表。该列表包含了最终响应之前的所有历史 Response 对象,按照发生时间升序排列:
# 当 allow_redirects=True 时追溯中间历史
resp = requests.get("http://github.com")  # 会重定向到 https
print("最终落地 URL:", resp.url)
for old_resp in resp.history:
    print(f"中间状态: {old_resp.status_code} -> 目标: {old_resp.headers.get('Location')}")
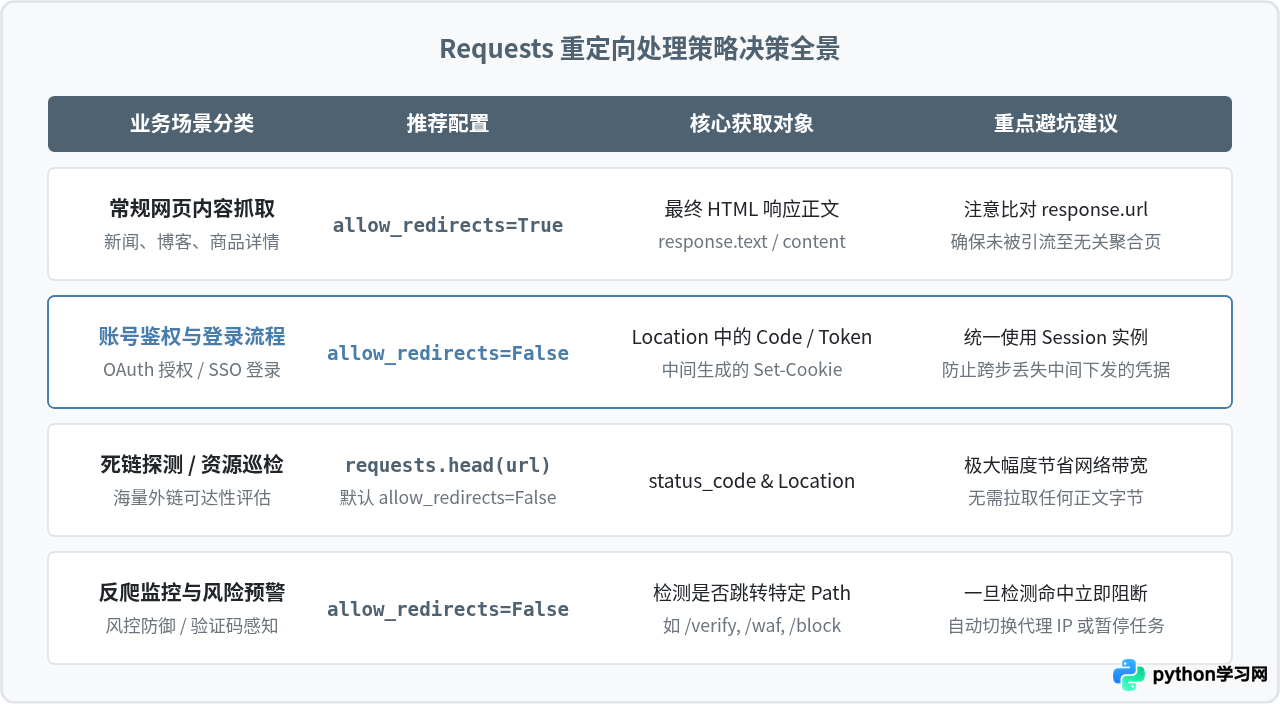
五、Requests 重定向控制策略决策全景
为了在不同业务场景中做出准确的技术选型,以下全景图梳理了常见爬虫场景下的参数搭配与核查要点:
六、常见问题与注意事项
- Location 字段可能包含非法字符:某些服务器在 Location 中直接返回带有中文字符或未编码特殊符号的路径,此时如果直接传入下一次请求可能会触发
InvalidURL。建议在urljoin后使用urllib.parse.quote对路径中的非 ASCII 字符进行安全转义。 - POST 请求重定向时的 HTTP 方法变更:HTTP 规范中,302 和 303 在绝大多数客户端(包括浏览器与 Requests)中会被自动降级为 GET 请求发起二次访问;而 307 与 308 规范要求严格保留原请求方法(如保持 POST)。在手动处理禁止重定向时,务必根据服务端返回的具体状态码决定下一步调用
session.get()还是session.post()。 - 跨域重定向时的 Authorization 头部安全丢失:Requests 在自动跟随跨域重定向时,出于安全考虑会主动剥离请求头中的敏感
Authorization字段。如果业务要求携带认证凭据访问目标域,手动禁止重定向并自行追加头部是唯一稳妥的解决方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















