


Python列表与字典常用操作汇总:增删改查技巧
全面汇总Python列表与字典的常用增删改查操作技巧,结合底层存储机制、时间复杂度对比与高频避坑实践,附4幅高清晰架构与决策SVG图解。
list)与字典(dict)是使用频次最高、功能最核心的两种内置容器。列表基于动态数组构建,以连续数字索引维护有序数据序列;字典基于哈希表构建,通过键的唯一哈希值实现非线性键值映射。本文系统拆解列表与字典在“增、删、改、查”四大维度中的常用原生方法与边界技巧,通过具体代码、内存机理图解及时间复杂度对比,帮助读者掌握高效、安全的操作范式。
一、底层存储结构与寻址逻辑对比
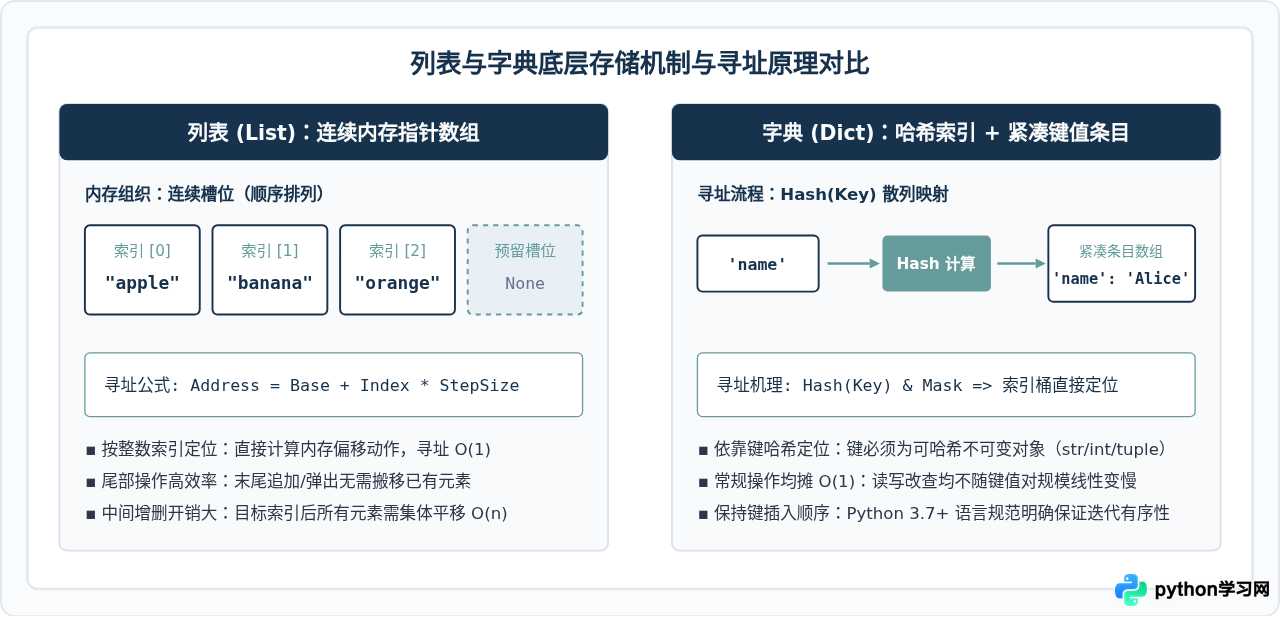
要熟练运用两者的增删改查方法,首先需要理解它们在内存中的组织方式。列表维护一块连续的内存指针数组,所有元素按照排列顺序依次分配索引编号 0, 1, 2, ...。通过索引访问元素时,解释器只需通过公式 基地址 + 索引 × 指针步长 直接定位内存地址,因此索引访问的耗时是恒定的 O(1)。
字典则是典型的关联容器。自 Python 3.7 起,字典在底层采用了紧凑哈希表实现:先用稀疏哈希索引表记录键哈希与具体条目的对应位置,实际的 key、hash、value 则按插入顺序保存在紧凑条目数组中。当检索键时,计算其哈希值并快速命中条目,使得常规查找、插入和删除的均摊时间复杂度同样维持在 O(1)。
二、列表(List)常用增删改查操作实战
1. 增(添加元素)
向列表中添加新元素有三种主要方式:单元素末尾追加 append()、多元素批量追加 extend() 以及指定索引插入 insert()。
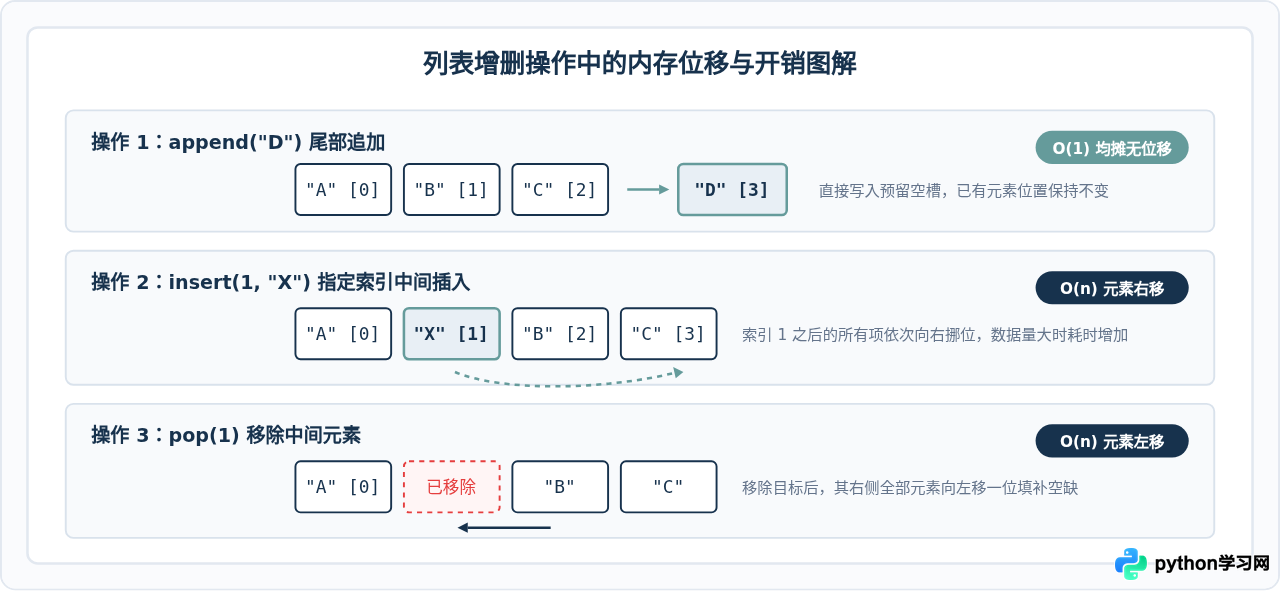
append(x):将元素x作为一个完整对象追加到列表末尾。这是最推荐也是最高效的添加方式,时间复杂度为均摊O(1)。extend(iterable):接收一个可迭代对象,将其中的所有元素解包后依次添加到当前列表末尾。与+=运算符作用一致。insert(index, x):在目标位置index前插入元素x。该操作会导致index及其之后的所有元素向后移动一位,时间复杂度为O(n)。
# 列表“增”操作示例
fruits = ["apple", "banana"]

# 1. append 追加单元素
fruits.append("cherry")
print("append 结果:", fruits)

# 2. extend 批量合并可迭代对象
fruits.extend(["date", "elderberry"])
print("extend 结果:", fruits)

# 3. insert 指定索引插入
fruits.insert(1, "blueberry")
print("insert 结果:", fruits)extend 结果: ['apple', 'banana', 'cherry', 'date', 'elderberry']
insert 结果: ['apple', 'blueberry', 'banana', 'cherry', 'date', 'elderberry']
2. 删(移除元素)
列表的删除操作需要区分“按索引删除”与“按具体值删除”:
pop([i]):移除并返回指定索引位置i的元素。若省略参数i,默认弹出末尾元素(时间复杂度O(1));若指定了非末尾索引,后续元素会向前移动(时间复杂度O(n))。如果列表为空或索引越界,抛出IndexError。remove(x):移除列表中第一个与值x相等的元素。该方法需要从头开始线性扫描列表,时间复杂度为O(n);如果值不存在,抛出ValueError。del list[i]/del list[start:end]:Python 关键字语句,既支持按单索引删除,也支持利用切片批量删除连续区间,不会返回被删除的元素。clear():清空列表中的全部元素,使列表长度归零。
# 列表“删”操作示例
items = ["alpha", "beta", "gamma", "delta", "beta"]

# 1. pop 弹出并返回值
popped_item = items.pop(2)
print("pop(2) 返回值:", popped_item, "| 剩余列表:", items)

# 2. remove 移除首个匹配值(若匹配多次只删第一个)
items.remove("beta")
print("remove('beta') 后:", items)

# 3. del 切片批量删除
del items[0:2]
print("del 切片删除后:", items)

# 4. clear 清空
items.clear()
print("clear 清空后:", items)remove('beta') 后: ['alpha', 'delta', 'beta']
del 切片删除后: ['beta']
clear 清空后: []
3. 改(更新元素)
列表支持通过单项索引直接覆盖,也支持通过切片进行多项区间的批量替换:
- 单索引直接修改:
list[i] = new_value。修改必须在有效索引范围内进行,无法通过超出范围的索引来动态扩容列表(例如空列表执行lst[0] = 1会触发IndexError)。 - 切片赋值:
list[start:end] = iterable。切片赋值具有高度灵活性,替换对象的元素个数不必与切片长度严格相等,从而可以在更新的同时缩短或拉伸列表。
# 列表“改”操作示例
nums = [10, 20, 30, 40, 50]

# 1. 单项索引赋值
nums[0] = 99
print("单项修改后:", nums)

# 2. 切片批量修改(以不同长度的序列进行替换)
nums[1:3] = [200, 300, 400]
print("切片替换后:", nums)切片替换后: [99, 200, 300, 400, 40, 50]
4. 查(检索与统计)
对列表进行查找时,根据诉求不同可选择直接索引、切片切分、成员判定以及索引与频次检索:
- 正向与负向索引:
list[0]获取首项,list[-1]获取末项。 - 成员检查
in:value in list逐项线性比对,平均耗时与列表长度成正比,即O(n)。 index(x, [start, [end]]):返回目标值x在指定区间内首次出现的正向索引。若未找到,抛出ValueError,因此在调用前通常配合in预先检查。count(x):统计目标值x在整个列表中出现的总次数。
# 列表“查”操作示例
letters = ["a", "b", "c", "d", "b", "e"]

# 1. 索引读取
print("第一项:", letters[0], "| 最后一项:", letters[-1])

# 2. 成员存在性检查
target = "b"
if target in letters:
    idx = letters.index(target)
    cnt = letters.count(target)
print(f"元素 '{target}' 首次出现索引: {idx}, 出现总次数: {cnt}")元素 'b' 首次出现索引: 1, 出现总次数: 2
三、字典(Dict)常用增删改查操作实战
1. 增与改(键值绑定与更新)
在字典中,“增”与“改”往往共享同一套语法:当键不存在时为新增,当键已存在时为覆盖。
- 下标赋值
dict[key] = value:最直观的操作方式。如果key存在,更新其对应的value;如果不存在,则插入该键值对。 update([other]):支持传入另一个字典或键值对序列批量合并。如果键存在则覆盖旧值,不存在则新增。setdefault(key, default):当key不在字典中时,将其值设为default并返回该值;如果key已存在,则不作修改并返回字典中现有的值。特别适合在分组汇总等场景下完成按需初始化。- 字典合并运算符
|与|=(Python 3.9+):d1 | d2会生成一个合并后的新字典,d1 |= d2则就地将d2合并至d1。
# 字典“增与改”操作示例
user_profile = {"username": "alex", "level": 1}

# 1. 下标赋值:键不存在则新增,存在则覆盖
user_profile["email"] = "alex@example.com"  # 新增
user_profile["level"] = 2                  # 覆盖修改
print("下标赋值后:", user_profile)

# 2. update 批量更新
user_profile.update({"status": "active", "level": 3})
print("update 后:", user_profile)

# 3. setdefault 按需初始化默认值
# role 键不存在,完成初始化
user_profile.setdefault("role", "member")
# level 键已存在,不会被覆盖为 99
user_profile.setdefault("level", 99)
print("setdefault 后:", user_profile)

# 4. 字典合并运算符 (Python 3.9+)
extra_info = {"theme": "dark", "level": 4}
merged = user_profile | extra_info
print("合并运算符 | 结果:", merged)update 后: {'username': 'alex', 'level': 3, 'email': 'alex@example.com', 'status': 'active'}
setdefault 后: {'username': 'alex', 'level': 3, 'email': 'alex@example.com', 'status': 'active', 'role': 'member'}
合并运算符 | 结果: {'username': 'alex', 'level': 4, 'email': 'alex@example.com', 'status': 'active', 'role': 'member', 'theme': 'dark'}
2. 删(键值移除与清空)
字典的删除操作核心在于“是否需要防范 KeyError”以及“是否需要保留弹出的值”:
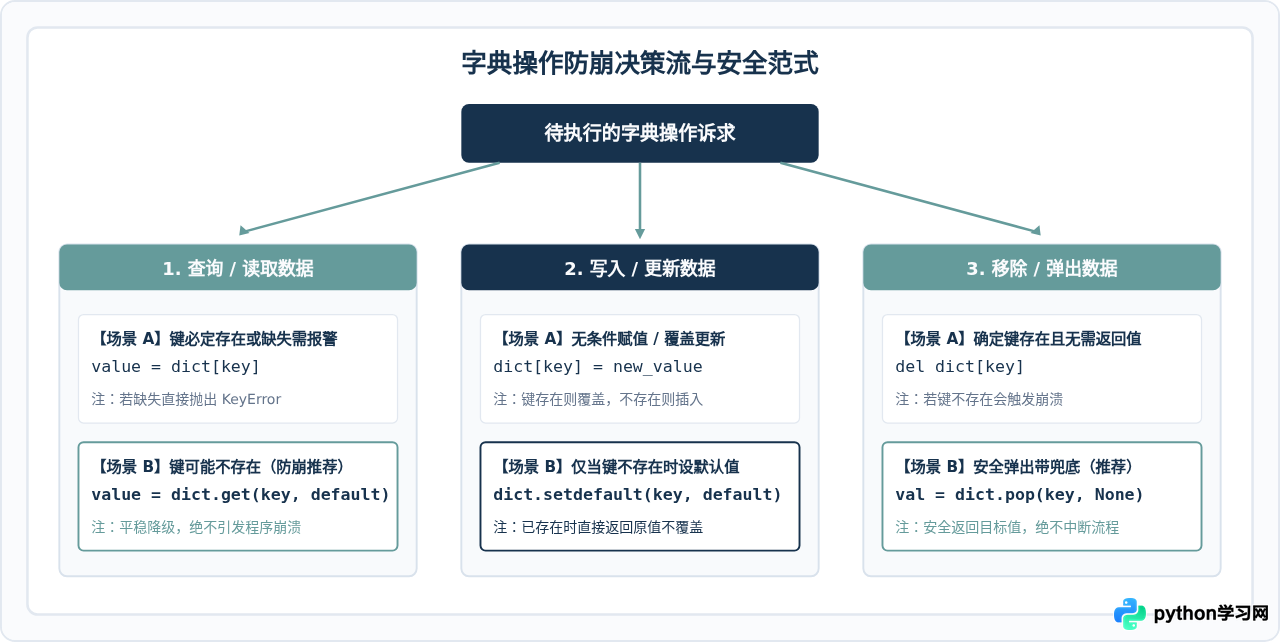
pop(key[, default]):弹出并返回指定键的值。若键不存在且传入了default,则返回该默认值,避免程序抛出异常;若未传入default且键不存在,则抛出KeyError。生产环境下建议始终提供default。popitem():移除并返回字典末尾的(key, value)元组(按后进先出 LIFO 顺序)。如果字典为空,抛出KeyError。del dict[key]:直接删除指定键。如果键不存在,会抛出KeyError。clear():清空整个字典中的所有键值对。
# 字典“删”操作示例
configs = {"host": "127.0.0.1", "port": 8080, "debug": True, "cache": "redis"}

# 1. pop 安全弹出带默认值
debug_mode = configs.pop("debug", False)
non_existent = configs.pop("timeout", 30)
print(f"弹出的 debug: {debug_mode}, 未命中的 timeout: {non_existent}")
print("pop 后的字典:", configs)

# 2. popitem 弹出最后插入的一项
last_pair = configs.popitem()
print("popitem 弹出末项:", last_pair, "| 剩余:", configs)

# 3. del 明确删除
del configs["host"]
print("del 删除 host 后:", configs)pop 后的字典: {'host': '127.0.0.1', 'port': 8080, 'cache': 'redis'}
popitem 弹出末项: ('cache', 'redis') | 剩余: {'host': '127.0.0.1', 'port': 8080}
del 删除 host 后: {'port': 8080}
3. 查(安全检索与视图遍历)
字典提供了多种查询机制,选择合适的方式能有效提升代码鲁棒性:
- 直接下标
dict[key]:要求键必须存在,常用于确信数据完整的严谨逻辑;若键不存在直接中断抛错。 - 安全获取
dict.get(key, default=None):最稳健的查询方式。若键存在返回对应值,若不存在返回默认值(默认为None),绝不抛出KeyError。 - 成员检查
key in dict:在O(1)时间内验证键是否存在,比遍历判断效率高出几个数量级。 - 动态视图对象:
dict.keys():获取所有键的动态视图。dict.values():获取所有值的动态视图。dict.items():获取所有(key, value)元组的动态视图,是遍历字典最地道的方式。
# 字典“查”操作示例
server_meta = {"name": "node-01", "ip": "192.168.1.10", "region": "ap-east"}

# 1. 两种查询方式对比
print("直接下标访问:", server_meta["name"])
print("get 访问已有键:", server_meta.get("ip"))
print("get 访问缺失键 (带默认值):", server_meta.get("port", 80))

# 2. 成员检查
if "region" in server_meta:
    print("区域配置已定义:", server_meta["region"])

# 3. items() 遍历键值对
print("--- 遍历 items() ---")
for k, v in server_meta.items():
print(f"Key: {k:<8} => Value: {v}")get 访问已有键: 192.168.1.10
get 访问缺失键 (带默认值): 80
区域配置已定义: ap-east
--- 遍历 items() ---
Key: name => Value: node-01
Key: ip => Value: 192.168.1.10
Key: region => Value: ap-east
四、高频避坑指南与最佳实践
1. 陷阱一:在遍历列表的过程中直接执行删除
这是初学者最容易踩入的经典误区。当在 for item in list: 循环体内直接调用 list.remove() 或 del list[i] 时,后续元素会立刻向前平移,但迭代器的内部计数指针仍然递增,导致跳过紧随其后的下一个元素。
# 错误示范:遍历中删除导致“跳过漏删”
nums = [1, 2, 2, 3, 4]
for n in nums:
    if n == 2:
        nums.remove(n)
print("错误做法残留结果:", nums)  # 仍残存一个 2!

# 正确方案 A:使用列表推导式构建过滤后的新列表(推荐,简单高效)
nums = [1, 2, 2, 3, 4]
filtered_nums = [n for n in nums if n != 2]
print("方案 A 推导式过滤结果:", filtered_nums)

# 正确方案 B:遍历浅拷贝副本切片 nums[:]
nums = [1, 2, 2, 3, 4]
for n in nums[:]:
    if n == 2:
        nums.remove(n)
print("方案 B 切片遍历修改结果:", nums)方案 A 推导式过滤结果: [1, 3, 4]
方案 B 切片遍历修改结果: [1, 3, 4]
2. 陷阱二:尝试使用可变对象作为字典的键
字典的键必须是可哈希(hashable)对象。Python 中的不可变类型(如 str、int、float、tuple、frozenset)均具备固定哈希值;而列表(list)与字典(dict)属于可变容器,其内容在内存中可以就地更改,因此不可哈希。若使用列表作键,会立即抛出 TypeError: unhashable type: 'list'。
# 键的合法性示例
valid_dict = {}

# 1. 合法:元组作为复合键
valid_dict[("192.168.1.1", 80)] = "Web Service"
print("元组键存储成功:", valid_dict)

# 2. 尝试使用列表作为键(会引发异常)
try:
    bad_key = ["tag1", "tag2"]
    valid_dict[bad_key] = "fail"
except TypeError as e:
print("捕获错误:", e)捕获错误: unhashable type: 'list'
3. 陷阱三:浅拷贝(Shallow Copy)带来的多维嵌套联动修改
无论是使用 list.copy()、dict.copy() 还是切片 list[:],产生的都只是浅拷贝。它们会复制外层容器的结构,但内层引用的子列表或嵌套字典仍然指向原内存对象。当修改内层数据时,原容器与副本会同时变动。如果需要彻底断开关联,必须导入 copy 模块并使用 copy.deepcopy()。
import copy

# 浅拷贝陷阱示例
original_list = [["a", "b"], [1, 2]]
shallow_copied = original_list.copy()
deep_copied = copy.deepcopy(original_list)

# 修改内层嵌套对象
original_list[0].append("c")

print("原列表:", original_list)
print("浅拷贝副本 (受波及):", shallow_copied)
print("深拷贝副本 (完全独立):", deep_copied)浅拷贝副本 (受波及): [['a', 'b', 'c'], [1, 2]]
深拷贝副本 (完全独立): [['a', 'b'], [1, 2]]
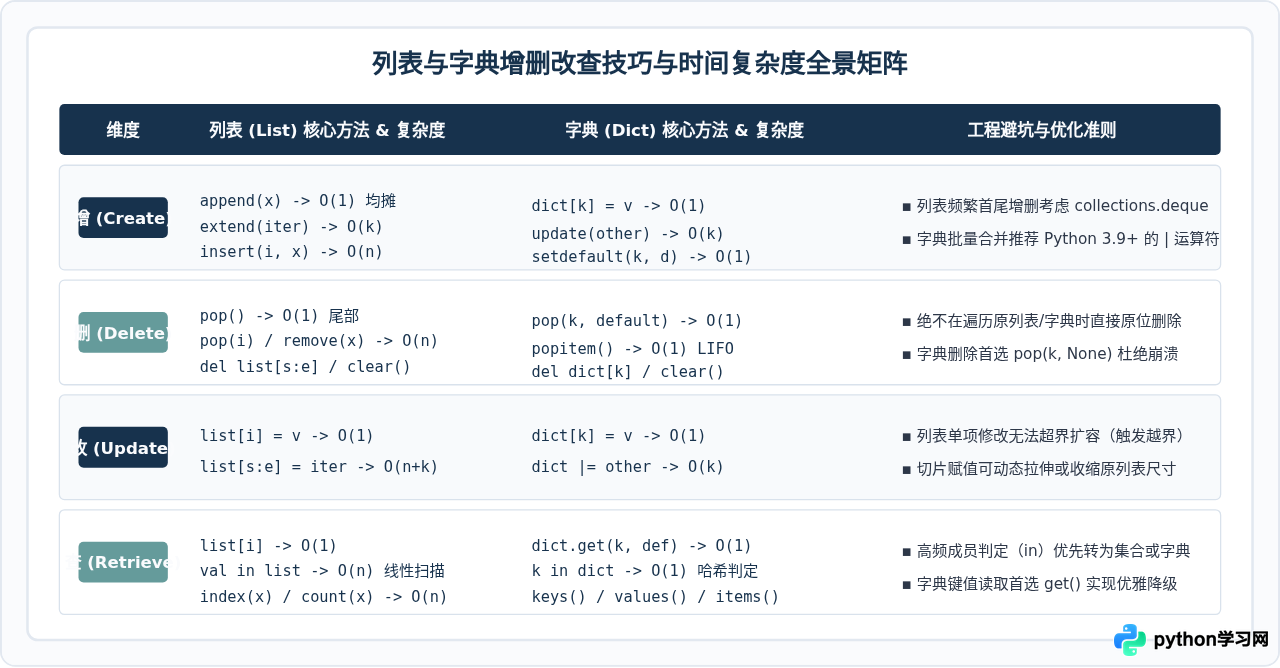
五、总结与选型建议
在实际工程开发中,选择列表还是字典取决于具体数据的组织形态与核心访问路径:
- 列表(List)适用场景:强调元素物理顺序、需要频繁进行切片提取、支持元素重复,且以末尾追加(
append)和按数字索引读取为主要操作的集合。若存在大量在头部或中间位置频繁插入删除的需求,应改用标准库中的collections.deque双端队列。 - 字典(Dict)适用场景:强调键值映射对应关系、以高效检索特定实体为核心目标、需要唯一标识去重,或者作为轻量级结构体传递属性字段。在检索时坚持使用
get()与in,在删除时规范使用pop(key, default),能有效消除由于键缺失引发的线上崩溃。
理解两者底层从“连续指针数组”到“哈希索引映射”的设计差异,能够帮助开发者在编写增删改查逻辑时,天然规避隐藏的 O(n) 性能开销与并发修改异常,编写出既高效又健壮的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















