


Python操作达梦数据库完整代码示例:连接、查询与增删改查
本文提供Python操作国产达梦数据库(DM8)的完整指南与代码示例,涵盖环境依赖安装、驱动配置、数据库连接建立、游标管理以及表创建、数据批量插入、参数化查询、数据更新、删除与事务回滚等全套增删改查操作。
在国产数据库应用开发中,达梦数据库(DM8/DM7)作为主流关系型数据库,提供了遵循 Python DB-API 2.0 规范的官方驱动模块 dmPython。本文通过规范的工程化代码,详细讲解 Python 连接达梦数据库的前置环境配置、驱动调用方式,以及表创建、批量插入、参数化查询、数据更新、删除与事务回滚的全套操作流程。
一、环境准备与驱动依赖
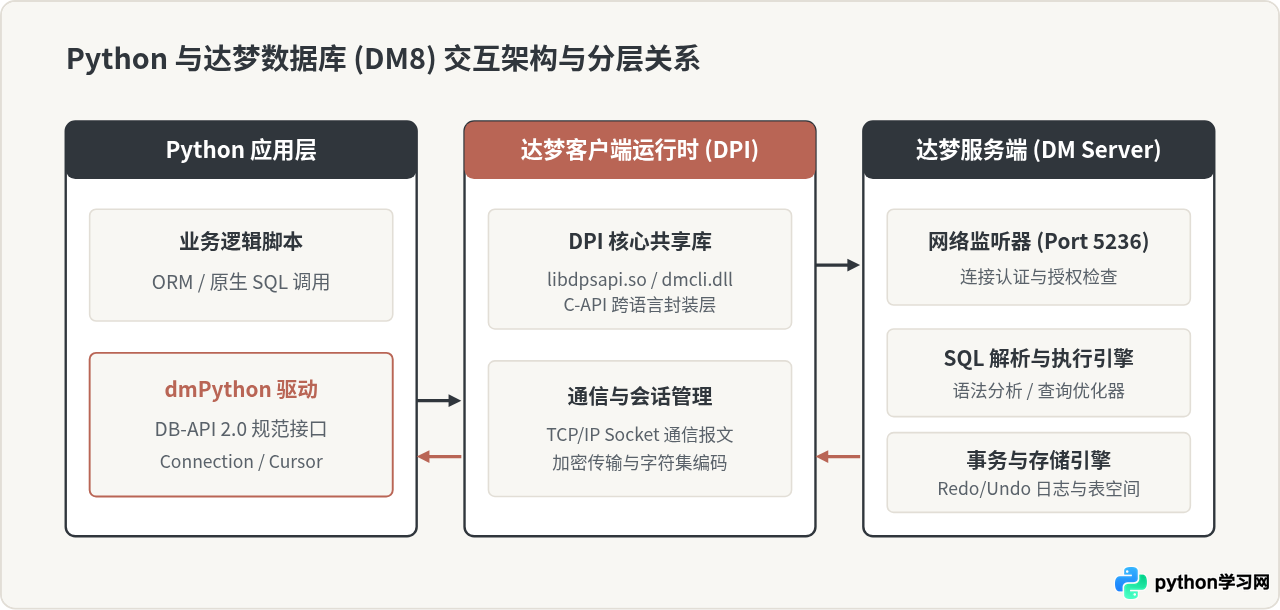
Python 访问达梦数据库的核心驱动为 dmPython。与常见的纯 Python 数据库客户端不同,dmPython 是基于 C 语言扩展实现的驱动程序,底层深度依赖达梦客户端运行时的动态链接库(DPI 接口,如 Linux 系统下的 libdpsapi.so 或 Windows 下的 dmcli.dll / dpsapi.dll)。
1. 驱动安装方法
获取 dmPython 通常有两种途径:
-
通过达梦安装包本地获取(推荐):在安装达梦数据库客户端或服务端后,驱动源码与 wheel 包位于安装目录下的
drivers/python/dmPython目录中。进入该目录后执行:python setup.py install # 或者直接安装预编译的 wheel 包 pip install dmPython-2.4.X-cp3X-cp3X-linux_x86_64.whl -
通过 pip 在线安装:若开发环境具备公网访问权限,可直接通过 PyPI 源安装匹配版本:
pip install dmPython
2. 动态链接库路径配置(避坑重点)
在 Linux 环境下,如果直接运行 Python 脚本导入 import dmPython,最常见的报错是:
ImportError: libdpsapi.so: cannot open shared object file: No such file or directory
原因解释:dmPython 依赖动态库 libdpsapi.so,该文件通常位于达梦安装目录的 bin 目录下(例如 /opt/dmdbms/bin)。必须将该路径加入操作系统的动态库检索路径中。
临时生效配置(可在运行前执行):
export DM_HOME=/opt/dmdbms
export LD_LIBRARY_PATH=$DM_HOME/bin:$LD_LIBRARY_PATH
在 Windows 环境下,则需要将达梦安装路径下的 bin 目录(包含 dmcli.dll 和 dpsapi.dll)加入系统的 PATH 环境变量中。
二、连接建立与生命周期流转
使用 dmPython 操作数据库的核心过程遵循 Python DB-API 2.0 标准规范:通过 connect() 函数建立数据库连接对象,从连接对象创建游标对象(Cursor),借助游标执行 SQL 指令,并在操作完成后显式释放资源。
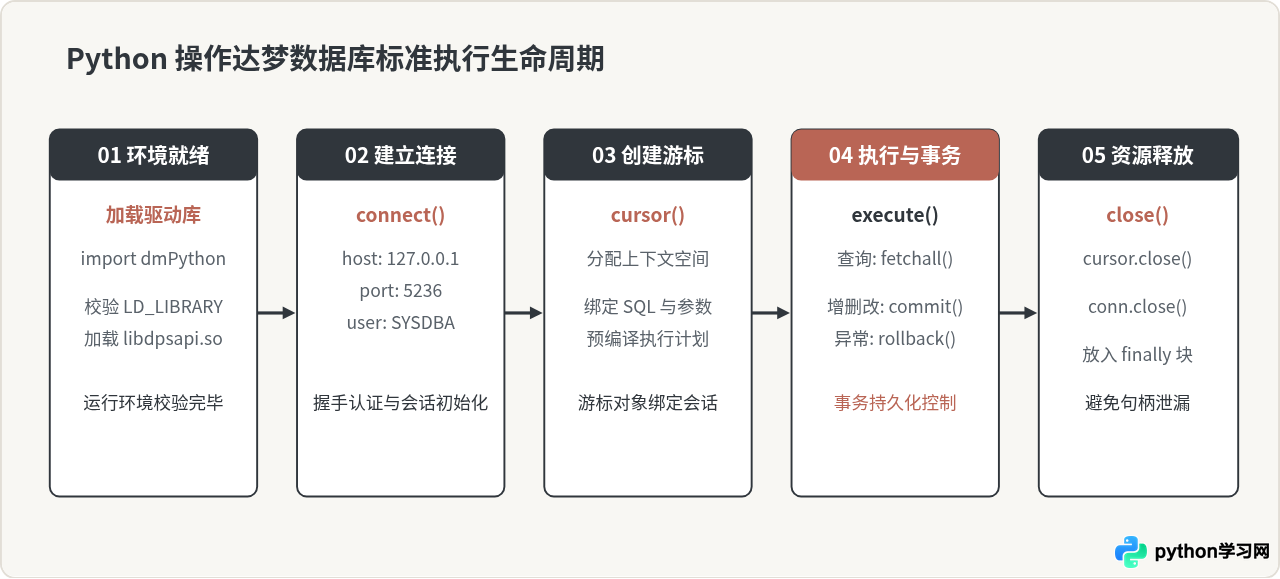
常用的连接参数包括:
| 参数名 | 类型 | 说明 | 默认值 / 示例 |
|---|---|---|---|
server / host |
字符串 | 达梦数据库服务所在 IP 地址或主机名 | "127.0.0.1" |
port |
整数 | 达梦数据库实例通信端口 | 5236 |
user |
字符串 | 登录数据库的用户名 | "SYSDBA" |
password |
字符串 | 登录用户密码 | "SYSDBA001" |
autoCommit |
布尔值 | 是否开启自动提交(建议显式设为 False,由代码控制事务) | False |
三、完整可运行代码示例
以下提供一份结构完整的单文件脚本示例。该示例覆盖从建立连接、建表、单条及批量数据写入(增)、条件查询与结果迭代(查)、更新数据与事务提交(改)、删除数据并检查影响行数(删),到最后安全释放连接的完整业务逻辑闭环。
# -*- coding: utf-8 -*-
"""
Python 操作达梦数据库完整 CRUD 示例代码
支持环境:Python 3.6+ / DM8 / dmPython
"""

import dmPython

# 1. 达梦数据库连接配置参数
DB_CONFIG = {
    'server': '127.0.0.1',
    'port': 5236,
    'user': 'SYSDBA',
    'password': 'SYSDBA_PASSWORD_123',
    'autoCommit': False  # 遵循 DB-API 规范,关闭自动提交,手动控制事务
}

def get_connection():
    """建立并返回达梦数据库连接对象"""
    try:
        conn = dmPython.connect(
            server=DB_CONFIG['server'],
            port=DB_CONFIG['port'],
            user=DB_CONFIG['user'],
            password=DB_CONFIG['password'],
            autoCommit=DB_CONFIG['autoCommit']
        )
        print("[INFO] 成功建立达梦数据库连接。")
        return conn
    except dmPython.Error as e:
        print(f"[ERROR] 连接达梦数据库失败: {e}")
        raise

def setup_table(cursor, conn):
    """创建测试数据表"""
    # 达梦数据库默认在未加双引号时将对象名与列名转换为大写
    create_table_sql = """
    CREATE TABLE IF NOT EXISTS DM_EMP_TEST (
        EMP_ID INT IDENTITY(1, 1) PRIMARY KEY,
        EMP_NAME VARCHAR(64) NOT NULL,
        DEPARTMENT VARCHAR(64),
        SALARY DECIMAL(10, 2),
        CREATE_TIME TIMESTAMP DEFAULT CURRENT_TIMESTAMP
    )
    """
    cursor.execute(create_table_sql)
    conn.commit()
    print("[STEP 1] 测试表 DM_EMP_TEST 创建或确认存在成功。")

def insert_records(cursor, conn):
    """演示单条插入与批量插入数据(增)"""
    # 1. 单条数据参数化插入:使用 ? 作为占位符
    insert_single_sql = """
    INSERT INTO DM_EMP_TEST (EMP_NAME, DEPARTMENT, SALARY)
    VALUES (?, ?, ?)
    """
    cursor.execute(insert_single_sql, ('张三', '技术部', 12500.00))
    print(f"[STEP 2.1] 单条插入成功,影响行数: {cursor.rowcount}")

    # 2. 批量数据插入:使用 executemany 提高多条写入效率
    batch_data = [
        ('李四', '财务部', 9800.50),
        ('王五', '技术部', 15200.00),
        ('赵六', '运营部', 8600.00),
        ('孙七', '技术部', 11000.00)
    ]
    cursor.executemany(insert_single_sql, batch_data)
    print(f"[STEP 2.2] 批量插入成功,写入 {len(batch_data)} 条记录。")

    # 必须显式调用 commit 提交事务,否则连接断开后数据自动回滚
    conn.commit()
    print("[STEP 2.3] 数据插入事务已显式提交。")

def query_records(cursor):
    """演示参数化查询与结果集处理(查)"""
    print("\n--- [STEP 3] 执行数据查询 ---")

    # 示例 A:查询单条记录
    query_single_sql = "SELECT EMP_ID, EMP_NAME, DEPARTMENT, SALARY FROM DM_EMP_TEST WHERE EMP_NAME = ?"
    cursor.execute(query_single_sql, ('张三',))
    row = cursor.fetchone()
    if row:
        print(f"查询单条结果 -> ID: {row[0]}, 姓名: {row[1]}, 部门: {row[2]}, 薪资: {row[3]}")

    # 示例 B:多条件参数化查询多条记录
    query_batch_sql = """
    SELECT EMP_ID, EMP_NAME, DEPARTMENT, SALARY, CREATE_TIME
    FROM DM_EMP_TEST
    WHERE DEPARTMENT = ? AND SALARY >= ?
    ORDER BY SALARY DESC
    """
    cursor.execute(query_batch_sql, ('技术部', 12000.00))

    # 获取字段元信息(列名在达梦中默认全大写)
    columns = [col[0] for col in cursor.description]
    print(f"查询返回字段: {columns}")

    # 抓取全部符合条件的结果列表
    results = cursor.fetchall()
    print(f"技术部薪资 >= 12000 的记录数量: {len(results)}")
    for record in results:
        print(f"  员工详情: ID={record[0]}, 姓名={record[1]}, 薪资={record[3]}, 创建时间={record[4]}")

def update_records(cursor, conn):
    """演示数据更新操作与事务控制(改)"""
    print("\n--- [STEP 4] 执行数据更新 ---")
    update_sql = """
    UPDATE DM_EMP_TEST
    SET SALARY = SALARY + ?
    WHERE DEPARTMENT = ?
    """
    salary_raise = 1000.00
    target_dept = '技术部'

    cursor.execute(update_sql, (salary_raise, target_dept))
    affected_rows = cursor.rowcount
    print(f"更新操作完成,部门【{target_dept}】员工调薪,受影响行数: {affected_rows}")

    # 确认提交更新
    conn.commit()
    print("更新操作事务已提交。")

def delete_records(cursor, conn):
    """演示数据删除操作与条件验证(删)"""
    print("\n--- [STEP 5] 执行数据删除 ---")
    delete_sql = "DELETE FROM DM_EMP_TEST WHERE EMP_NAME = ?"
    cursor.execute(delete_sql, ('赵六',))
    print(f"删除记录【赵六】,受影响行数: {cursor.rowcount}")

    # 提交删除事务
    conn.commit()
    print("删除操作事务已提交。")

def transaction_rollback_demo(cursor, conn):
    """演示异常情况下的事务回滚机制(回滚)"""
    print("\n--- [STEP 6] 事务回滚演示 ---")
    try:
        cursor.execute("INSERT INTO DM_EMP_TEST (EMP_NAME, DEPARTMENT, SALARY) VALUES (?, ?, ?)", ('周八', '人事部', 9500.00))
        print("临时插入一条记录:周八(尚未提交)")

        # 模拟业务中途出现异常
        raise ValueError("模拟业务计算错误,触发主动回滚!")

        conn.commit()
    except Exception as e:
        print(f"[WARN] 捕获业务异常: {e}")
        # 执行回滚,撤销当前事务内未提交的所有 DML 操作
        conn.rollback()
        print("[INFO] 事务已安全回滚,周八的数据不会写入数据库。")

    # 校验周八是否存在
    cursor.execute("SELECT COUNT(*) FROM DM_EMP_TEST WHERE EMP_NAME = ?", ('周八',))
    count = cursor.fetchone()[0]
    print(f"回滚后校验周八的记录数: {count} (预期为 0)")

def main():
    conn = None
    cursor = None
    try:
        # 1. 建立连接
        conn = get_connection()
        # 2. 创建游标
        cursor = conn.cursor()

        # 3. 依次执行生命周期操作
        setup_table(cursor, conn)
        insert_records(cursor, conn)
        query_records(cursor)
        update_records(cursor, conn)
        delete_records(cursor, conn)
        transaction_rollback_demo(cursor, conn)

    except dmPython.Error as db_err:
        print(f"[DATABASE ERROR] 达梦数据库异常: {db_err}")
        if conn:
            conn.rollback()
    except Exception as general_err:
        print(f"[SYSTEM ERROR] 运行异常: {general_err}")
        if conn:
            conn.rollback()
    finally:
        # 4. 安全关闭游标与连接
        if cursor:
            cursor.close()
            print("[CLEANUP] 游标对象已关闭。")
        if conn:
            conn.close()
            print("[CLEANUP] 数据库连接已释放。")

if __name__ == '__main__':
    main()
四、增删改查的数据流与事务机制
在进行达梦数据库开发时,需要清楚读操作(SELECT)与写操作(INSERT/UPDATE/DELETE)在底层的不同数据流与事务机制。
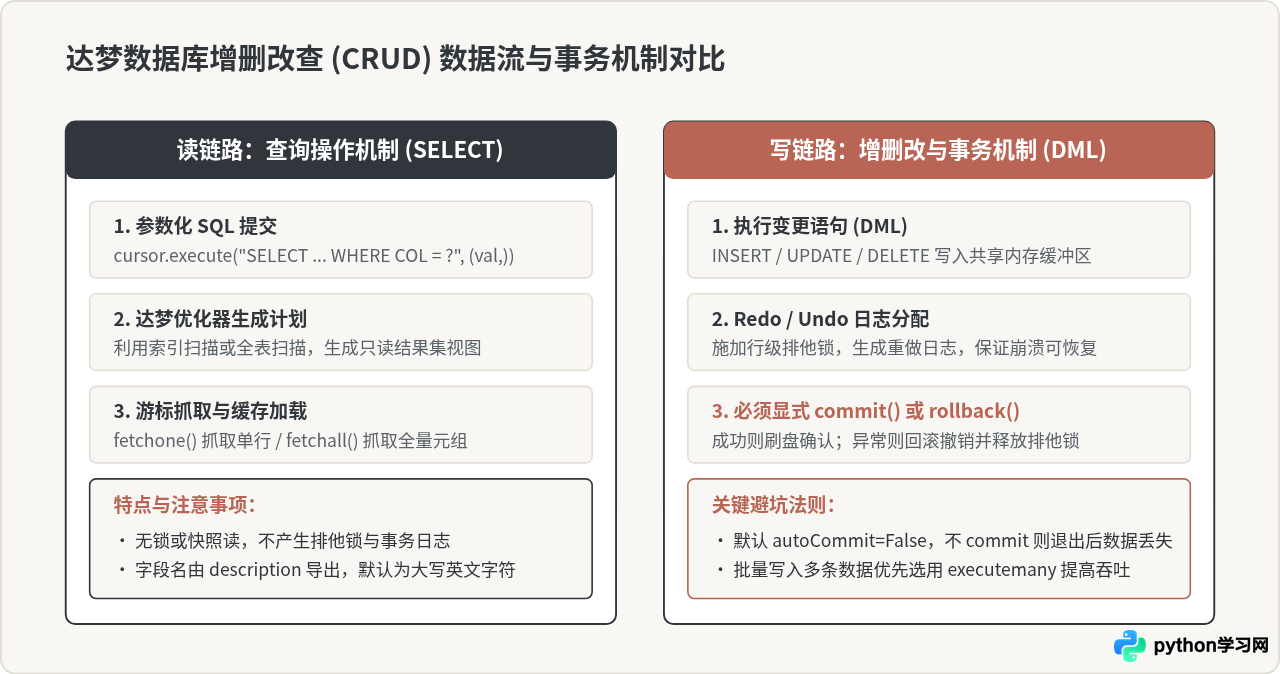
cursor.execute() 插入或修改数据后,程序即使没有报错,若最后遗漏了 conn.commit(),在 Python 进程退出或连接关闭时,达梦服务端将自动回滚该会话未提交的事务,导致数据并未真正落盘。
五、达梦数据库开发避坑指南与规范总结
在实际业务生产中,Python 操作达梦数据库常见的问题多集中在大小写敏感度、事务控制模式、参数化语法以及底层运行库依赖上。以下总结出四个关键维度的最佳开发规范:
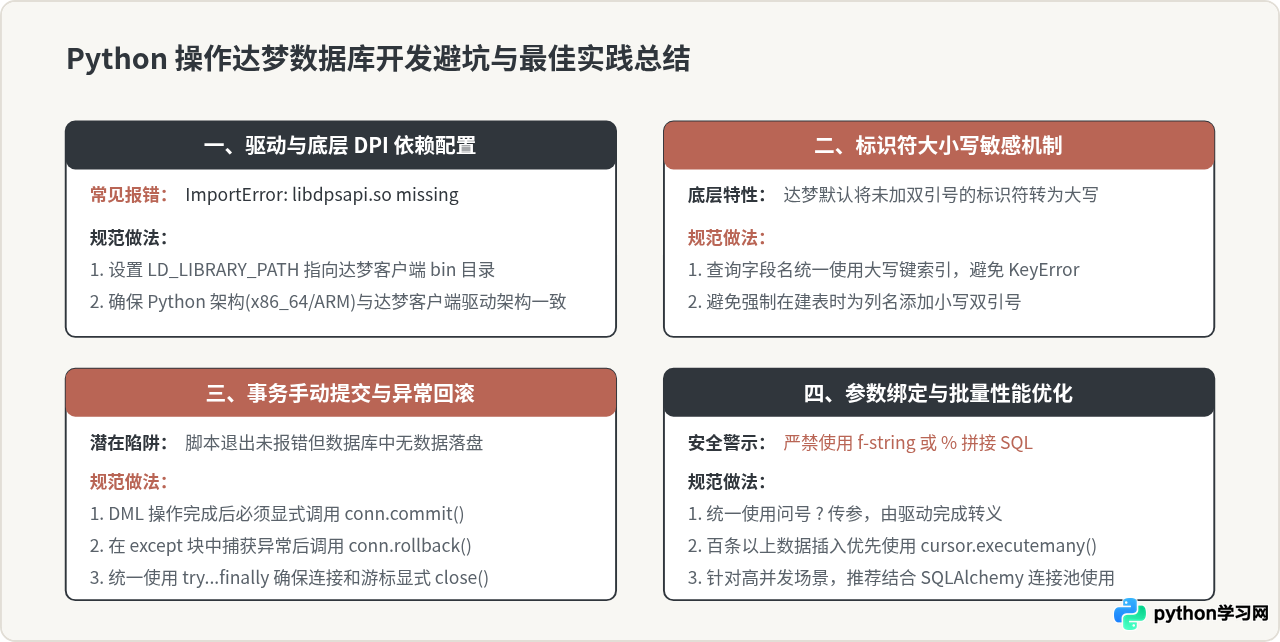
1. 字段名与大小写处理
达梦数据库在默认初始化参数下,对象名(表名、列名、视图名)若不加双引号,系统会自动将其转换为全大写存储。通过 cursor.description 获取到的字段名也是全大写字符串(例如 ['EMP_ID', 'EMP_NAME', 'SALARY'])。如果需要以字典形式解析查询结果,建议将字段名统一转为小写或大写映射:
def fetch_dict_results(cursor):
    """将游标结果转化为字典列表"""
    columns = [col[0].lower() for col in cursor.description]
    return [dict(zip(columns, row)) for row in cursor.fetchall()]
2. 参数化占位符标准
在 dmPython 中,参数化查询使用 ? 作为占位符,传参必须以元组(Tuple)或列表(List)形式传入:
# 正确写法:使用 ? 占位符防范 SQL 注入
cursor.execute("SELECT * FROM DM_EMP_TEST WHERE EMP_NAME = ? AND SALARY > ?", ('张三', 10000))

# 错误写法(严禁使用):字符串拼接存在注入风险
# cursor.execute(f"SELECT * FROM DM_EMP_TEST WHERE EMP_NAME = '{user_input}'")
3. 批量操作效率对比
当需要插入数千条甚至数万条记录时,避免在 for 循环中逐条调用 cursor.execute()。逐条执行会引发频繁的网络 I/O 往返和单独的语句解析开销。改用 cursor.executemany(sql, param_list) 可以将数据打包成批次发送至达梦服务端,大幅缩短入库耗时。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















