


Python标准库array模块用法:怎么创建固定类型数值数组
详细讲解Python标准库array模块的用法,包括类型码选择、创建固定类型数值数组的多种方式、二进制文件读写以及与原生list的内存机制对比。
在 Python 中处理大量数值时,最常用的 list 虽然灵活,但每个元素都是被封装的独立对象指针,存储百万级数字时会带来显著的内存冗余与性能开销。Python 标准库自带的 array 模块提供了一种紧凑存储固定类型数值的轻量解决方案,它直接在连续内存中存放底层 C 语言原生数据,不需要额外安装 NumPy 等第三方扩展包。本文详细介绍 array 模块的核心原理、类型码选择、四种具体创建方式与实际应用中的关键细节。
一、核心原理:array 与原生 list 的内存结构差异
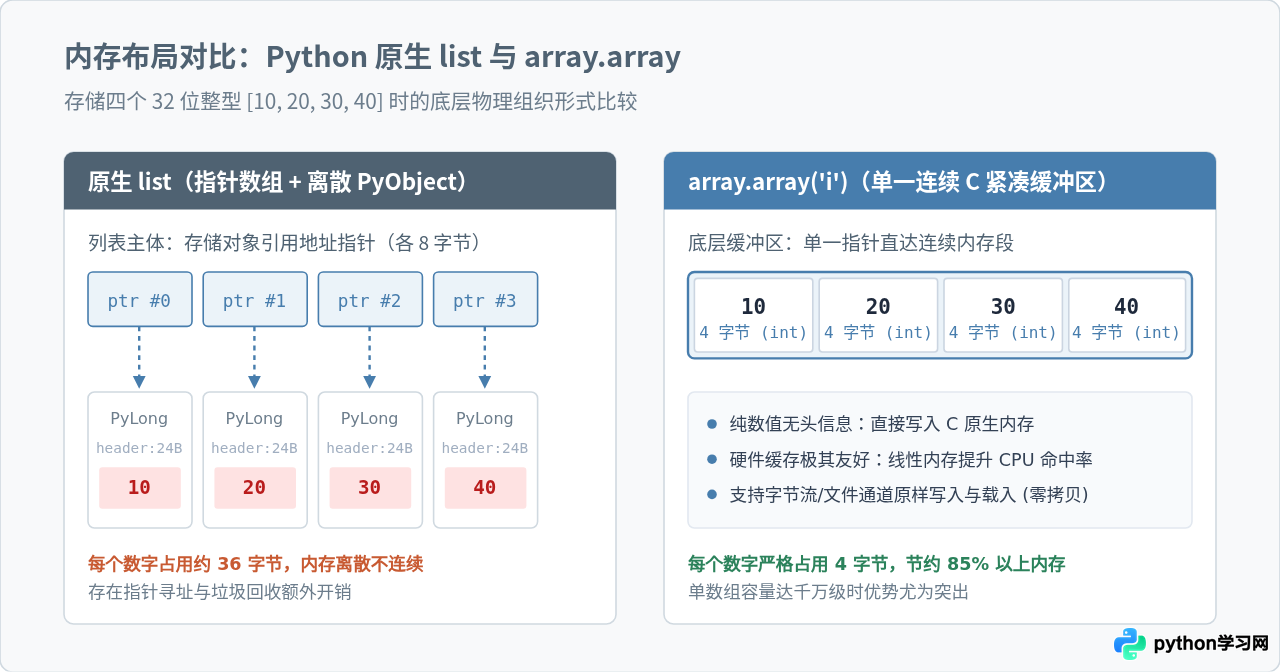
Python 原生列表是一个动态指针数组。当你在列表中存放 [10, 20, 30, 40] 时,列表底层保存的是指向四个独立 PyLongObject 对象的内存地址指针。每一个 Python 整数对象除数值本身外,还附带引用计数、类型指针以及长度信息,通常至少占用 28 字节。再加上指针本身的 8 字节,一个整型的实际消耗高达 36 字节以上。
而标准库的 array.array 直接在单一连续内存块中按字节紧凑存储数值,省去了所有对象封装与指针跳转。以 32 位整型为例,每个数字在 array 中严格只占 4 字节,不仅节省了大量内存,还能让 CPU 缓存更高效地命中,极大提升数据传输和读写速度。
二、核心语法与类型码(Type Code)对照表
创建 array 对象的构造语法如下:
from array import array

arr = array(typecode[, initializer])
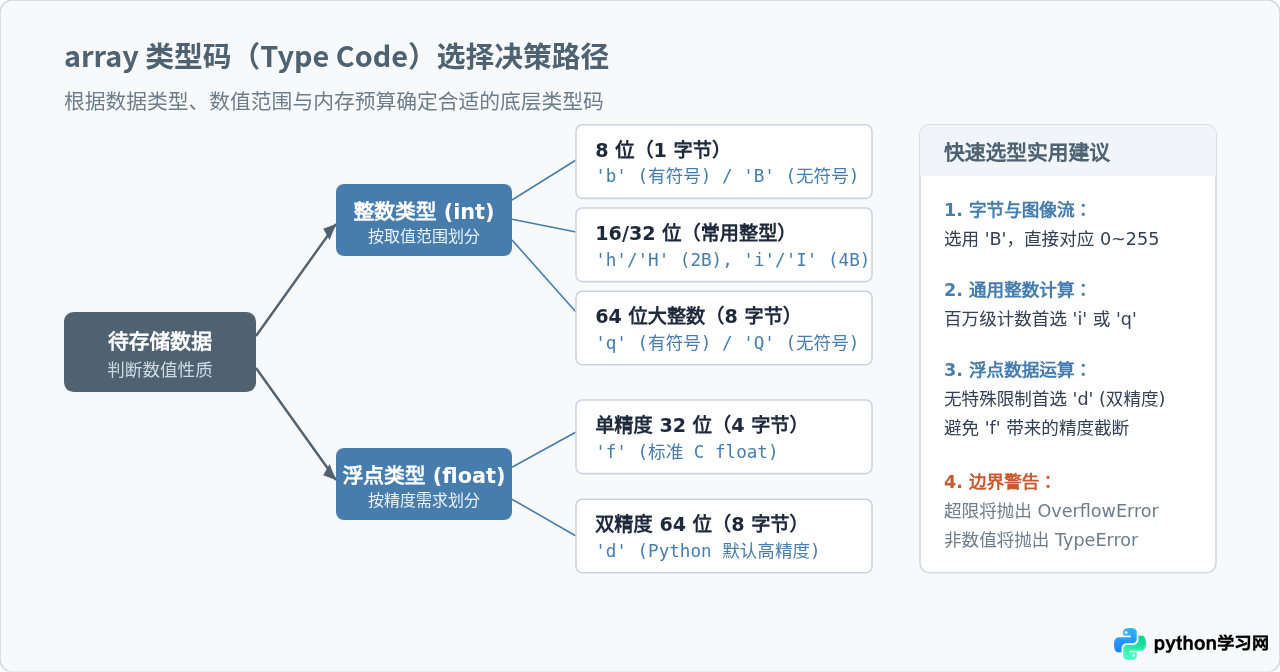
其中,第一个参数 typecode(类型码)是单一字符,用来指定数组中每个元素所采用的底层 C 语言数据类型与字节长度。创建后,该数组只能容纳符合该类型码范围的数值,存入超出边界或不符合类型的元素会直接抛出异常。
| 类型码 (Type Code) | 对应 C 语言类型 | Python 内部映射类型 | 最小占用字节数 | 数值表示范围 |
|---|---|---|---|---|
'b' |
signed char | int | 1 | -128 至 127 |
'B' |
unsigned char | int | 1 | 0 至 255(常用于字节流、灰度像素) |
'h' |
signed short | int | 2 | -32,768 至 32,767 |
'H' |
unsigned short | int | 2 | 0 至 65,535 |
'i' |
signed int | int | 2 (通常为4) | -2,147,483,648 至 2,147,483,647 |
'I' |
unsigned int | int | 2 (通常为4) | 0 至 4,294,967,295 |
'l' / 'L' |
signed / unsigned long | int | 4 (部分64位平台为8) | 通常为 32 位或 64 位整型 |
'q' |
signed long long | int | 8 | -9,223,372,036,854,775,808 至 9,223,372,036,854,775,807 |
'Q' |
unsigned long long | int | 8 | 0 至 18,446,744,073,709,551,615 |
'f' |
float | float | 4 | 标准 IEEE 754 单精度浮点数 |
'd' |
double | float | 8 | 标准 IEEE 754 双精度浮点数(等同于 Python 默认 float) |
三、创建固定类型数值数组的四种典型操作
在实际编码中,创建 array 对象的途径非常灵活,可以根据初始数据的来源(已有列表、原始二进制字节串、磁盘文件或动态追加)选择最便捷高效的方式。
1. 通过现有可迭代对象直接初始化
最直观的方式是将 Python 的 list、tuple 或 range 作为第二个参数传入构造函数:
from array import array

# 使用列表初始化 32 位有符号整型数组
numbers = [10, 20, 30, 40, 50]
int_arr = array('i', numbers)
print("整数数组:", int_arr)
# 示例输出: 整数数组: array('i', [10, 20, 30, 40, 50])

# 使用 range 直接构建连续序列
range_arr = array('l', range(1000))

# 创建双精度浮点数组
float_arr = array('d', [1.25, 3.14159, 2.71828])
print("元素大小(字节):", float_arr.itemsize)
# 示例输出: 元素大小(字节): 8
2. 从原始字节串(bytes)高速解析
在网络通信、底层驱动交互或传感器数据采集中,数据往往以未经包装的二进制 bytes 形式传输。使用 frombytes() 可以直接将连续字节流无拷贝或低开销地映射为数值数组:
from array import array

# 假设接收到底层 8 字节二进制流(包含两个 4 字节小端序 int)
raw_bytes = b'\x0a\x00\x00\x00\x14\x00\x00\x00'

# 创建空数组并从字节加载
arr = array('i')
arr.frombytes(raw_bytes)
print("从字节解析出的数值:", arr)
# 示例输出: 从字节解析出的数值: array('i', [10, 20])

# 同样支持随时导出回原始字节
exported_bytes = arr.tobytes()
print("反向导出字节串:", exported_bytes)
# 示例输出: 反向导出字节串: b'\n\x00\x00\x00\x14\x00\x00\x00'
3. 从磁盘二进制文件直接拉取(超快 I/O)
传统的文本格式(如 JSON、CSV)在读写百万级数值时涉及繁重的字符串编解码。array 提供了 tofile() 和 fromfile(),能直接以 C 数组二进制原样写入或读取文件:
from array import array
import os

# 创建包含 5 个双精度浮点数的数组并直接存入二进制文件
data = array('d', [10.5, 20.3, 30.1, 40.8, 50.2])
with open("sensor_cache.bin", "wb") as fp:
    data.tofile(fp)

# 从文件中精确读取恢复
restored = array('d')
with open("sensor_cache.bin", "rb") as fp:
    # 第二个参数指定读取的元素个数(非字节数)
    restored.fromfile(fp, 5)

print("从文件快速恢复的数组:", restored)
# 示例输出: 从文件快速恢复的数组: array('d', [10.5, 20.3, 30.1, 40.8, 50.2])

if os.path.exists("sensor_cache.bin"):
    os.remove("sensor_cache.bin")
4. 声明空数组后动态追加元素
如果不确定数据总量,可以只指定类型码创建空数组,随后在数据到达时调用 append() 单个追加,或使用 extend() 批量合并:
from array import array

# 声明一个空的无符号 8 位数组(0~255)
buffer = array('B')

# 单个追加
buffer.append(255)
buffer.append(128)

# 批量扩展
buffer.extend([10, 20, 30])
print("动态构建结果:", buffer)
# 示例输出: 动态构建结果: array('B', [255, 128, 10, 20, 30])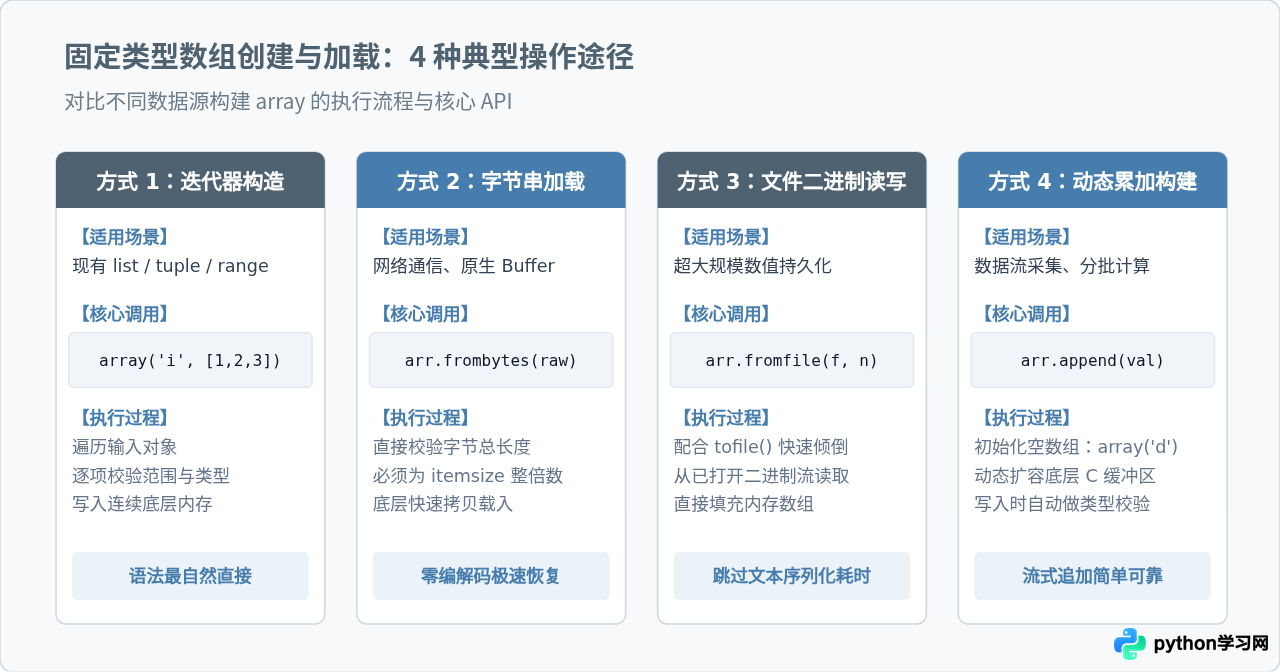
四、内存占用对比实测与关键避坑注意事项
1. 真实内存占用实测对比
我们可以使用 sys.getsizeof() 观察存储 1,000,000 个 32 位整型时,原生列表与 array 的真实内存差异:
import sys
from array import array

N = 1_000_000

# 1. 原生列表
raw_list = list(range(N))
# list 容器本身占用的指针内存 + 每个 PyLongObject 对象内存
list_container_bytes = sys.getsizeof(raw_list)
single_int_bytes = sys.getsizeof(10)
estimated_total_list_mb = (list_container_bytes + N * single_int_bytes) / (1024 * 1024)

# 2. array 模块(32位有符号整型 'i')
arr = array('i', range(N))
array_bytes = sys.getsizeof(arr)
array_mb = array_bytes / (1024 * 1024)

print(f"原生 list 总估计内存: {estimated_total_list_mb:.2f} MB")
print(f"array('i') 总内存:   {array_mb:.2f} MB")
# 示例输出:
# 原生 list 总估计内存: 34.33 MB
# array('i') 总内存: 3.82 MB实测结果清晰表明,在同等规模数据下,array('i') 仅占约 3.82 MB 内存,相比原生列表直接降低了将近 90% 的内存消耗。
2. 常见错误与避坑准则
array 不允许混入异构类型。如果你创建的是整型数组,传入字符串或浮点数会抛出 TypeError;如果传入数值超过该类型码的上下限,会立即抛出 OverflowError:
arr = array('b', [10, 20])
# 错误示范 1: 存入浮点数 -> TypeError: integer argument expected, got float
# arr.append(3.14)

# 错误示范 2: 存入超过 127 的数字 -> OverflowError: signed char is greater than maximum
# arr.append(200)array 只支持一维线性存储。如果需要类似 [[1, 2], [3, 4]] 的二维表格或张量结构,array 无法直接表达多层嵌套。此时建议使用一维数组加步长索引计算(index = row * cols + col),或者直接选用 NumPy。
- 选择原生 list:日常轻量数据、元素数量少于数万、需要存放不同类型对象(如混存字典、字符串)。
- 选择 array 模块:百万级同质数值、希望免除任何第三方库依赖、需要频繁将整块数据做二进制磁盘保存或网络字节流发送。
- 选择 NumPy:需要多维矩阵、向量化广播运算、傅里叶变换或复杂的线性代数运算。
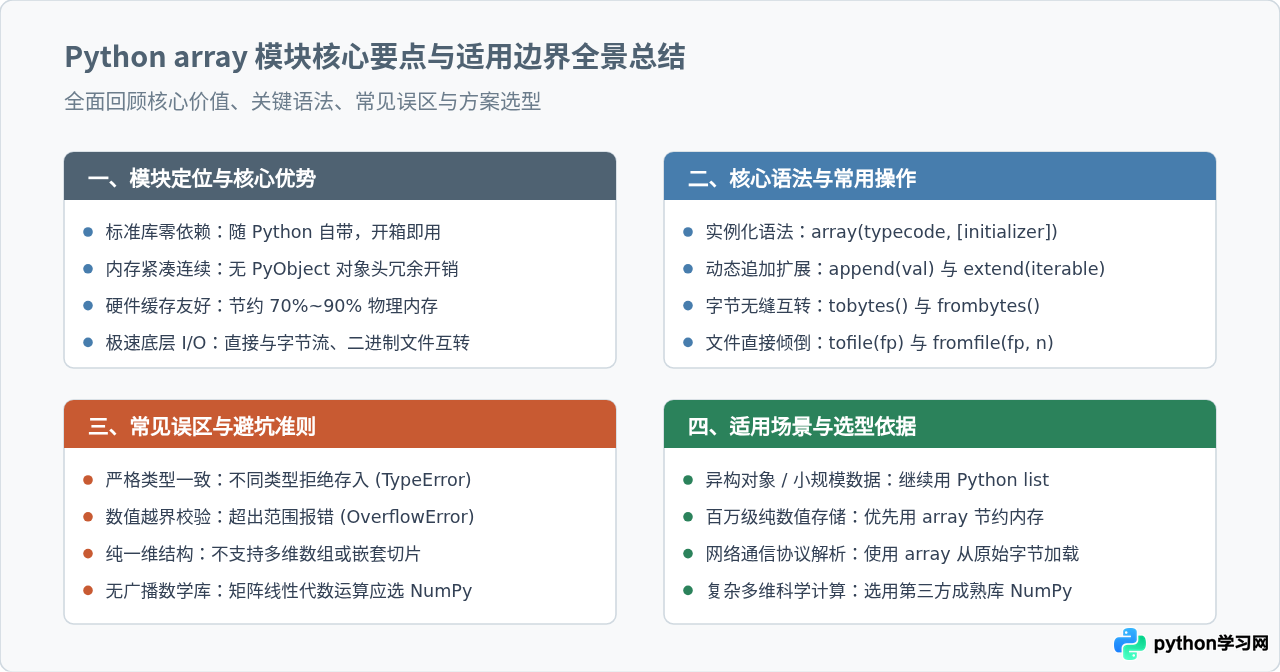
五、全文总结
Python 标准库的 array 模块通过底层 C 语言原生连续内存机制,在无需外部依赖的前提下,以极简的 API 为数值计算与数据传输提供了出色的内存压缩率和读写性能。掌握 typecode 的合理选型,结合从迭代器、字节串与二进制文件的灵活创建方法,即可在面对大量纯数值数据时写出更轻量、更高性能的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















