


Python在人工智能中的应用:从机器学习到深度学习的生态优势
深入解析Python在人工智能领域的技术生态优势,涵盖从Scikit-learn机器学习基石到PyTorch深度学习框架的演进路径、计算架构分层、完整工程代码与选型决策。
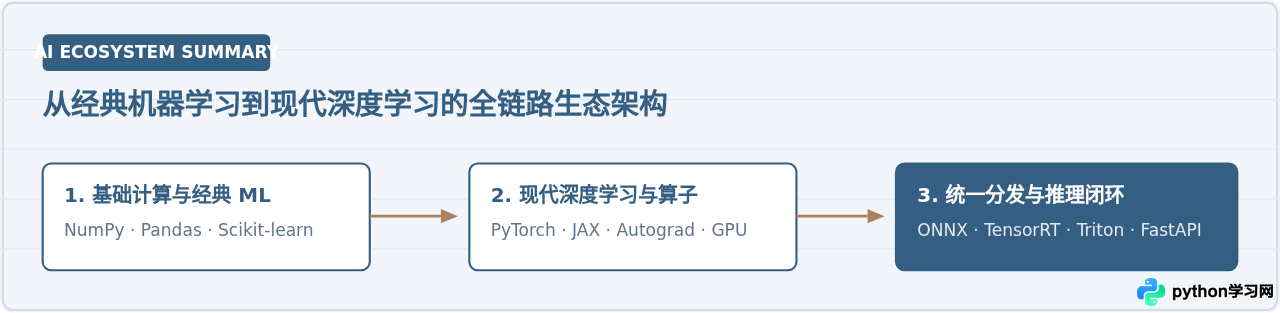
Python 成为人工智能事实上的标准开发语言,根本原因不在于解释器本身的执行速度,而在于其作为“胶水语言”构建的高性能计算抽象分层体系。Python 向上提供清晰、直观的高级声明式接口与动态交互能力,向下通过 C/C++、Fortran 及 CUDA 绑定驱动底层硬件算力,使得开发者无需在执行性能与研发效率之间进行妥协。本文将解析从经典机器学习(Scikit-learn、NumPy、Pandas)到现代深度学习(PyTorch、TensorFlow、JAX)的技术栈演进,揭示两代框架在计算图、内存管理、算子调度上的核心机制与生态优势,并给出实际工程落地的实现范式。
一、计算与交互解耦:Python AI 架构的分层优势
在传统的系统级编程中,若要获得极致的矩阵计算性能,通常需要直接调用 BLAS、LAPACK 或 CUDA 核心函数,但这会导致业务算法的编写极其繁琐且难以快速调试。Python 的生态优势首先体现在严格的计算与交互解耦架构中:
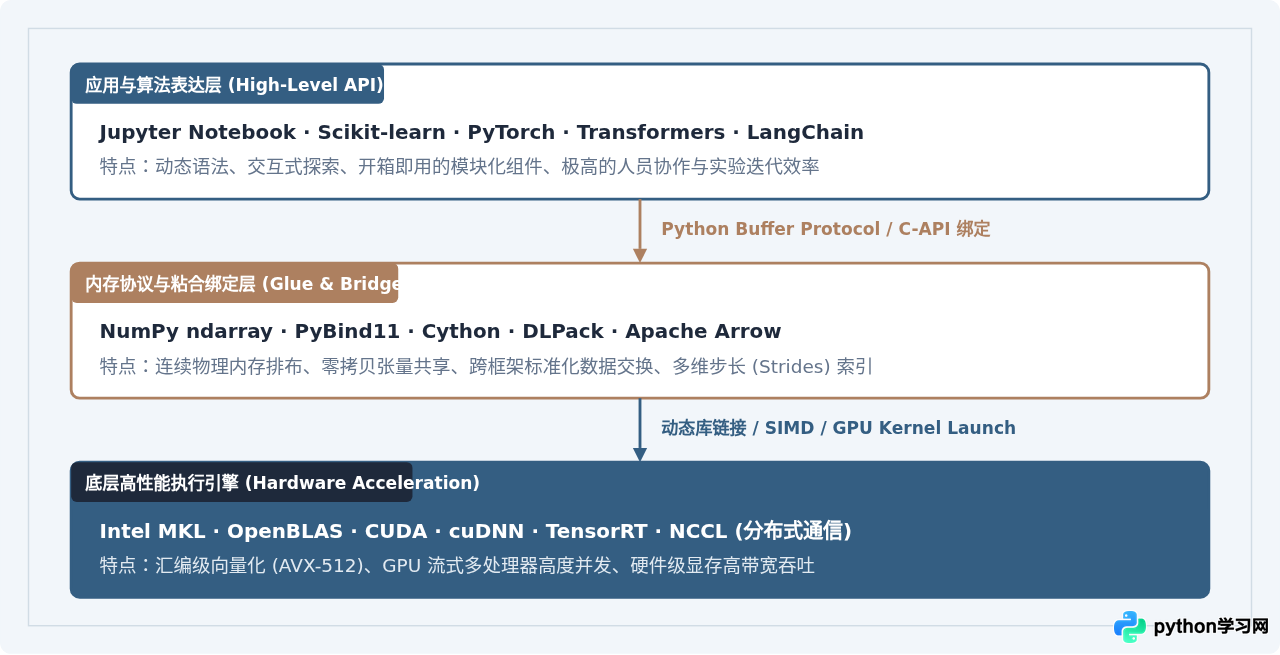
在这种三层架构中,Python 代码仅仅负责调度任务与组织拓扑结构,真正的矩阵乘法、卷积运算与反向传播全部在 C++ 或 CUDA 层面由底层编译优化库执行。这使得执行阶段可以完全绕过 Python 解释器的 GIL(全局解释器锁),充分榨干多核 CPU 与多卡 GPU 的并行计算能力。
二、经典机器学习阶段:标准化接口与流水线工程化
在以表格数据(Tabular Data)和结构化特征为主的传统机器学习场景中,Python 确立了极高的一致性规范。以 NumPy 的 ndarray 为通用数据结构,Scikit-learn 制定了高度标准化的面向对象 API 规范:
- 转换器(Transformer):实现
fit()计算转换参数(如均值与方差),transform()进行数据特征映射。 - 估计器(Estimator):实现
fit()基于特征与标签进行参数求解,predict()进行新样本标签或数值推断。 - 流水线(Pipeline):将特征缺失值填充、归一化、降维与最终模型串联成一个原子化对象,彻底杜绝测试集向训练集泄露(Data Leakage)的工程隐患。
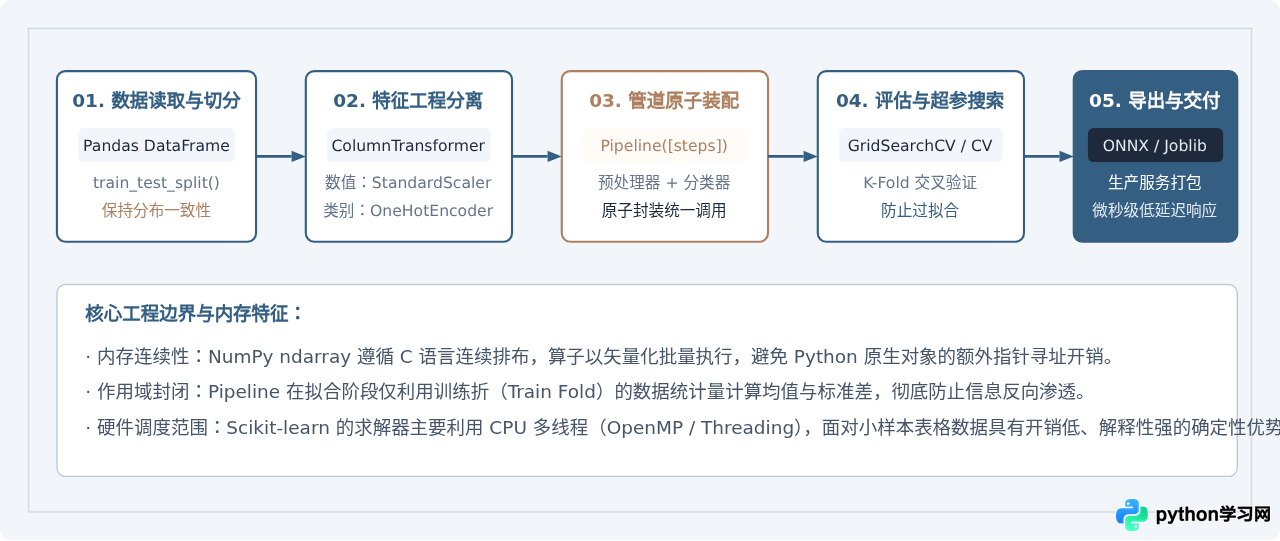
以下代码展示了一个工业级 Scikit-learn 流水线的完整实现,演示了数值与类别特征的混合处理、逻辑回归拟合及评估输出:
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

# 1. 构造演示结构化数据集
np.random.seed(42)
n_samples = 1000
data = pd.DataFrame({
    'age': np.random.randint(18, 70, size=n_samples).astype(float),
    'income': np.random.exponential(scale=50000, size=n_samples),
    'city_tier': np.random.choice(['Tier_1', 'Tier_2', 'Tier_3'], size=n_samples),
    'purchased': np.random.choice([0, 1], size=n_samples, p=[0.7, 0.3])
})

# 模拟缺失值
data.loc[np.random.choice(n_samples, 20), 'income'] = np.nan

X = data.drop(columns=['purchased'])
y = data['purchased']

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 2. 定义特征工程子流水线
numeric_features = ['age', 'income']
numeric_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='median')),
    ('scaler', StandardScaler())
])

categorical_features = ['city_tier']
categorical_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='constant', fill_value='missing')),
    ('onehot', OneHotEncoder(handle_unknown='ignore', sparse_output=False))
])

preprocessor = ColumnTransformer(transformers=[
    ('num', numeric_transformer, numeric_features),
    ('cat', categorical_transformer, categorical_features)
])

# 3. 组装完整端到端模型 Pipeline
clf_pipeline = Pipeline(steps=[
    ('preprocessor', preprocessor),
    ('classifier', LogisticRegression(solver='lbfgs', max_iter=200))
])

# 4. 训练与验证评估
clf_pipeline.fit(X_train, y_train)
y_pred = clf_pipeline.predict(X_test)

print("=== 模型验证评估报告(示例输出) ===")
print(classification_report(y_test, y_pred, digits=4))
该代码在执行时,所有的特征缩放参数均严格在 X_train 上计算得出,并在 transform 步骤中原样套用至 X_test。这种规范在整个 Python 机器学习圈内具有通用性,无论底层模型切换为 LightGBM、XGBoost 还是 CatBoost,皆可直接插拔替换。
三、深度学习演进:计算图、动态求导与异构算力
当人工智能处理的任务从规则结构化表格转向图像、语音和自然语言时,传统机器学习暴露出两个核心瓶颈:其一,人工特征提取无法应对高维非凸流形;其二,NumPy 缺乏自动微分(Automatic Differentiation)机制与原生 GPU 算子加速调度能力。深度学习生态由此催生。
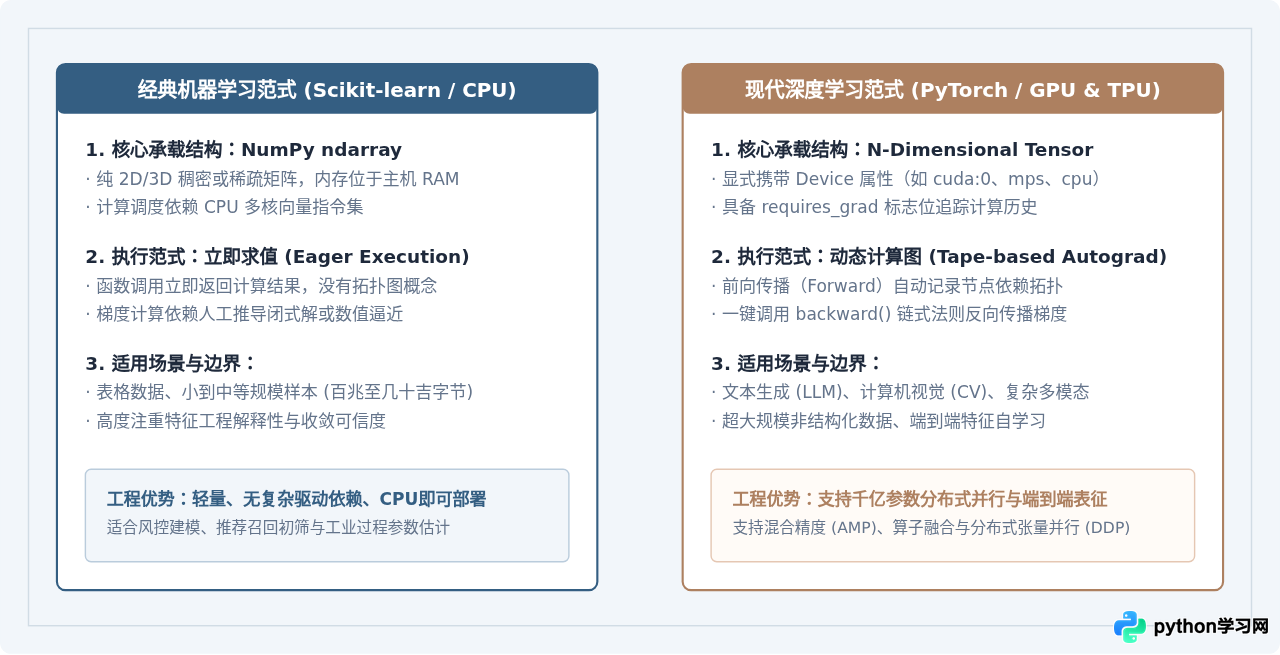
现代深度学习代表框架 PyTorch 之所以能全面超越早期静态图框架,核心在于其**动态计算图(Dynamic Computational Graph)**机制。在前向传播执行的过程中,框架通过 C++ 底层的 Autograd 引擎动态录制有向无环图(DAG),这使得 Python 原生的 for 循环、if-else 条件分支能够直接控制神经网络的拓扑走向,极大降低了复杂模型(如循环神经网络、Transformer 变长序列注意力掩码)的研发与调试门槛。
以下代码展示了一个完整的 PyTorch 神经网络训练范式,演示了张量设备搬运、自动梯度清零、反向传播与参数优化步骤:
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 检查异构算力环境
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(f"当前计算运行时设备: {device}")

# 2. 定义深层多层感知机 (MLP)
class ClassifierNet(nn.Module):
    def __init__(self, input_dim: int, hidden_dim: int, num_classes: int):
        super(ClassifierNet, self).__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.BatchNorm1d(hidden_dim),
            nn.ReLU(),
            nn.Dropout(p=0.2),
            nn.Linear(hidden_dim, num_classes)
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.network(x)

# 3. 构造仿真批数据并搬运至计算设备
torch.manual_seed(42)
batch_size, in_features, classes = 64, 16, 2
dummy_inputs = torch.randn(batch_size, in_features).to(device)
dummy_labels = torch.randint(0, classes, (batch_size,)).to(device)

model = ClassifierNet(input_dim=in_features, hidden_dim=32, num_classes=classes).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = optim.AdamW(model.parameters(), lr=1e-3, weight_decay=1e-2)

# 4. 执行标准训练轮次 (Training Loop)
model.train()
for epoch in range(5):
    # 梯度清零:防止历史批次梯度累加
    optimizer.zero_grad(set_to_none=True)

    # 前向传播:底层动态构建反向求导计算图
    outputs = model(dummy_inputs)
    loss = criterion(outputs, dummy_labels)

    # 反向传播:链式法则求解梯度
    loss.backward()

    # 参数更新:应用优化算法梯度步进
    optimizer.step()

    print(f"Epoch {epoch+1}/5 - Loss: {loss.item():.4f}")
在此范式中,loss.backward() 触发了底层纯 C++ 编译编写的自动微分算子链,Python 解释器本身不参与求导过程的逐行运算,从而保证了即便在复杂深层网络下也能实现极高的算力吞吐。
四、生态连贯性与全链路工业化落地矩阵
Python 在 AI 领域最不可替代的优势,在于跨阶段工具链的无缝互操作性。在工业落地中,极少有业务能够脱离数据处理直接进行深度学习推理:
- 数据层共享:Pandas 与 PyTorch / TensorFlow 共享底层的内存指针映射。通过
torch.from_numpy(),可直接以零内存拷贝(Zero-Copy)方式将 NumPy 连续数组映射为深度学习张量。 - 标准序列化转换:无论是 Scikit-learn 的支持向量机,还是 PyTorch 的 Transformer,均可导出为工业标准的 ONNX(Open Neural Network Exchange) 格式,进而由 C++ 编写的 ONNX Runtime 或 NVIDIA TensorRT 部署在边缘计算芯片或高性能服务器集群中。
- 服务化包装:借由 FastAPI、Ray Serve 等现代异步 Python 框架,算法工程师可以在几行代码内将模型封装为高并发的 RESTful 或 gRPC 微服务。
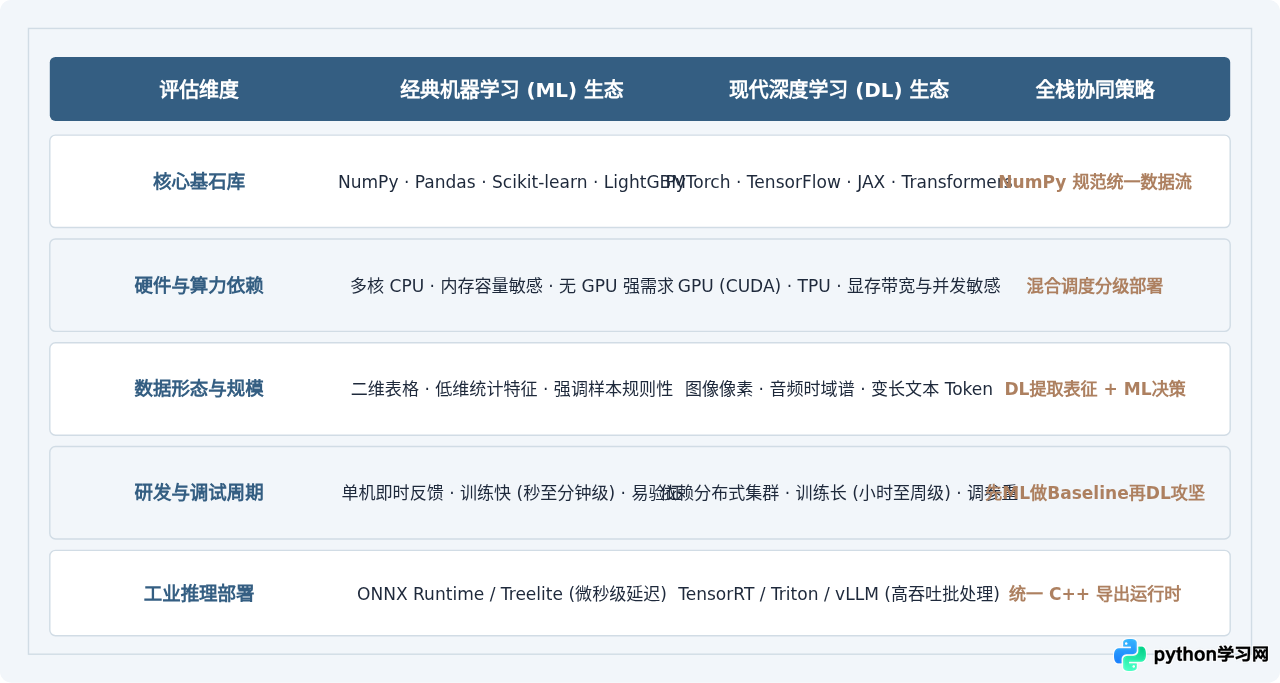
工程实践避坑建议:在构建生产级 AI 体系时,切忌直接在 Web 请求线程中同步执行大张量运算。对于 Scikit-learn 模型,应提前使用 Joblib 或 ONNX 完成序列化固化,避免重复拟合;对于深度学习模型,应开启 torch.inference_mode() 关闭自动求导的历史图追踪,以减少约 40% 的显存占用并提升计算吞吐。
五、总结
从 Scikit-learn 的标准化流水线到 PyTorch 的动态张量计算图,Python 贯穿人工智能技术链条的核心优势在于其**分层设计的生态粘合力**。它为开发者提供了极低心智负担的语法外壳,同时通过底层高度优化的 C/CUDA 算子桥接各类异构硬件芯片。理解这一生态演进路径,不仅有助于根据数据特征选择恰当的技术栈(小样本结构化数据首选 Scikit-learn/LightGBM,高维非结构化任务选用 PyTorch),更能帮助工程师在生产环境中建立起从特征预处理、模型训练到统一推理交付的高效闭环。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















