


对比Java和C++,Python在开发效率上的优势体现在哪
深入对比Python与Java、C++在实际开发效率上的核心差异,分析动态类型、编译周期、语法样板消除、内存管理与生态库对交付速度的具体影响。
在软件开发中,开发效率通常指从明确业务需求到写出可运行、可验证的代码所耗费的工时与心智负担。对比静态编译型语言C++与Java,Python在开发效率上的核心优势,本质上来源于更低的心智摩擦:它通过动态类型推导免除了冗长的样板代码,通过即时解释执行省去了频繁的编译链接等待,通过全自动垃圾回收屏蔽了复杂的底层内存生命周期,并通过极高抽象层级的标准库与生态让开发者得以直接聚焦于业务逻辑本身。
一、语言心智模型:关注底层契约还是直达业务目标
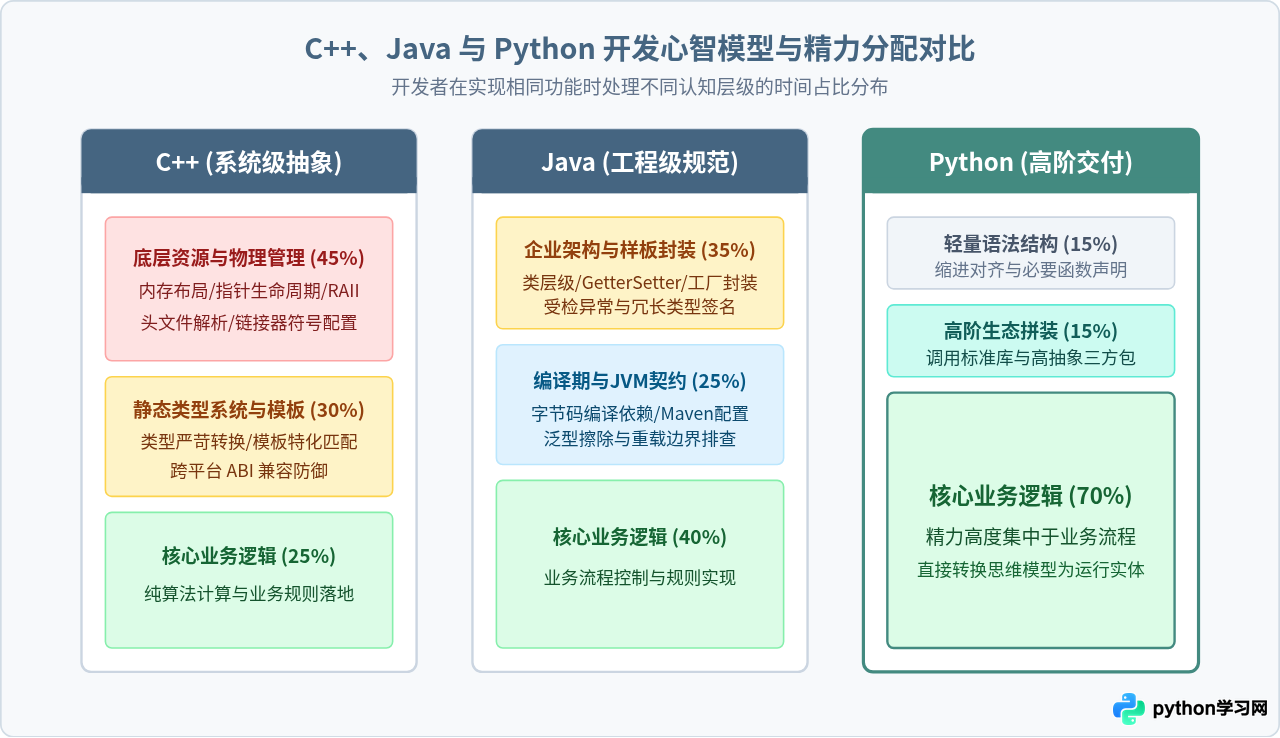
不同编程语言在设计之初设定的抽象层级,直接决定了开发者在键盘前需要思考的信息维度。使用C++编程时,开发者必须时刻关注底层硬件的物理约束,不仅要设计算法流程,还要显式管理内存分配、指针与引用有效性、值语义与移动语义、头文件组织及平台二进制兼容性。这意味着很大一部分开发时间花在“确保程序不崩溃且资源不泄漏”的防御性编码上。
Java在C++的基础上向前迈进了一大步,通过虚拟机规范、垃圾收集机制(GC)与取消裸指针大幅降低了底层内存风险。然而,Java坚守纯面向对象的强类型契约,要求所有逻辑封装在类中,并依赖显式的包路径、访问控制符、接口隔离及复杂的泛型系统。在大型企业级系统维护中这种约束提供了长效规范,但在需求探索与早期功能搭建阶段,开发者必须先编写大量承载架构骨架的“样板工程”,推迟了业务逻辑真正跑通的时间。
相比之下,Python采用高度扁平且高阶的心智模型。它不要求开发者预先为变量划定固定的物理存储类型,也不强制一切行为必须依附于类与层级结构。开发者可以直接编写模块级函数或顶层脚本,直接调用系统内建的高级容器(如列表、字典、集合),把有限的注意力几乎百分之百投入到业务输入与输出的转换中。
二、开发与验证链路:免编译与即时反馈
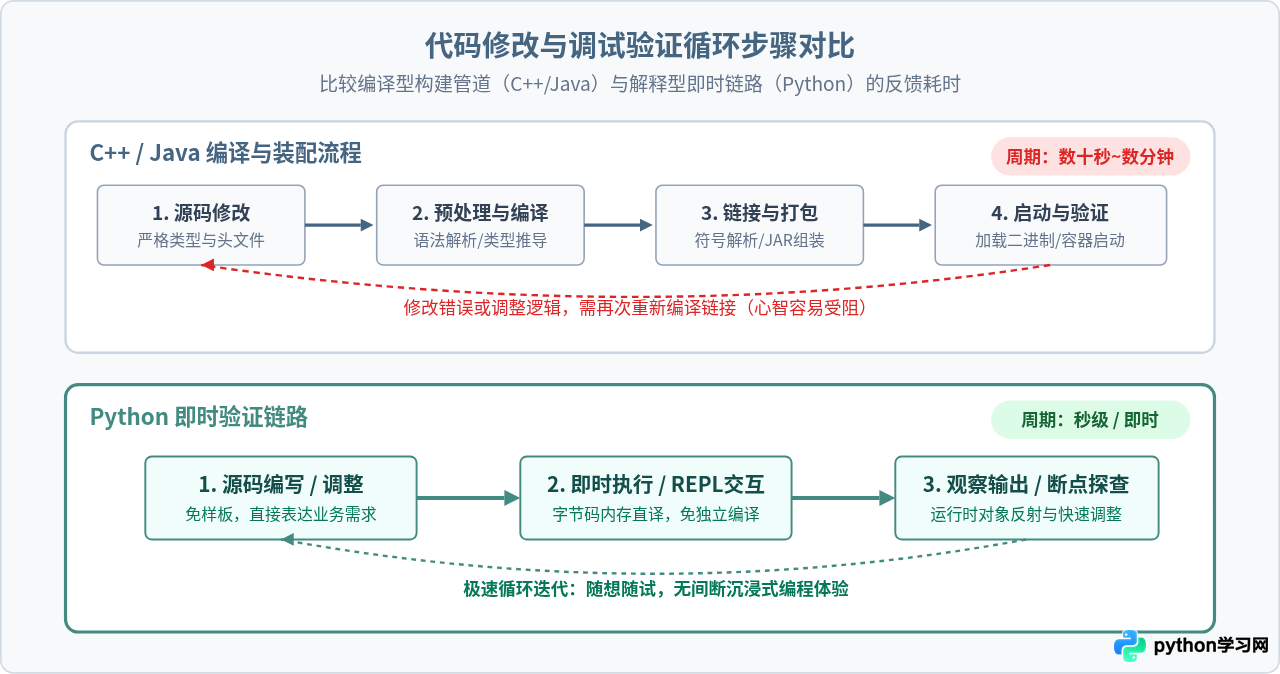
开发效率的高低在极大程度上取决于“代码编写 - 运行测试 - 观察结果 - 调整重试”这一循环周期的转速。在敏捷开发中,反馈环越短,开发者的心智心流越不容易被打断。
在C++中,即便只是修改了一个头文件中的方法签名或常量,往往就会触发整个翻译单元的重新解析,随后还要经历静态类型检查、模板实例化、目标文件生成以及耗时显著的静态/动态链接过程。在大型项目中,哪怕使用Ninja或增量编译技术,等待编译与链接的几十秒或数分钟等待也是家常便饭。这种等待不仅延缓了功能验证,更打碎了思维的连续性。
Java引入了JIT编译器与字节码架构,其单模块编译速度明显优于C++模板展开,现代IDE(如IntelliJ IDEA)也具备强大的后台增量构建与部分热重载能力。但在实际工程中,Java应用通常深度依赖Spring等大型容器框架,应用重启往往涉及复杂的依赖注入、Bean扫描与持久层连接池初始化,一次完整的调试重启仍然需要数秒至数十秒。
而Python作为动态解释型语言,具备天然的免编译优势:
- 即写即跑:保存源码后直接执行,没有独立的预编译或构建步骤,调试循环被压缩至亚秒级别。
- 交互式REPL与Jupyter交互环境:开发者可以在终端或Notebook中逐行载入数据、调用接口、即时检查变量内部结构,而无需为临时测试单独编写并编译一个测试入口。
- 动态热修补能力:在运行过程中可以方便地探查对象属性、替换函数引用,进行探索式编程与快速故障定位。
三、语法样板与认知摩擦:少敲键盘背后的高阶表达
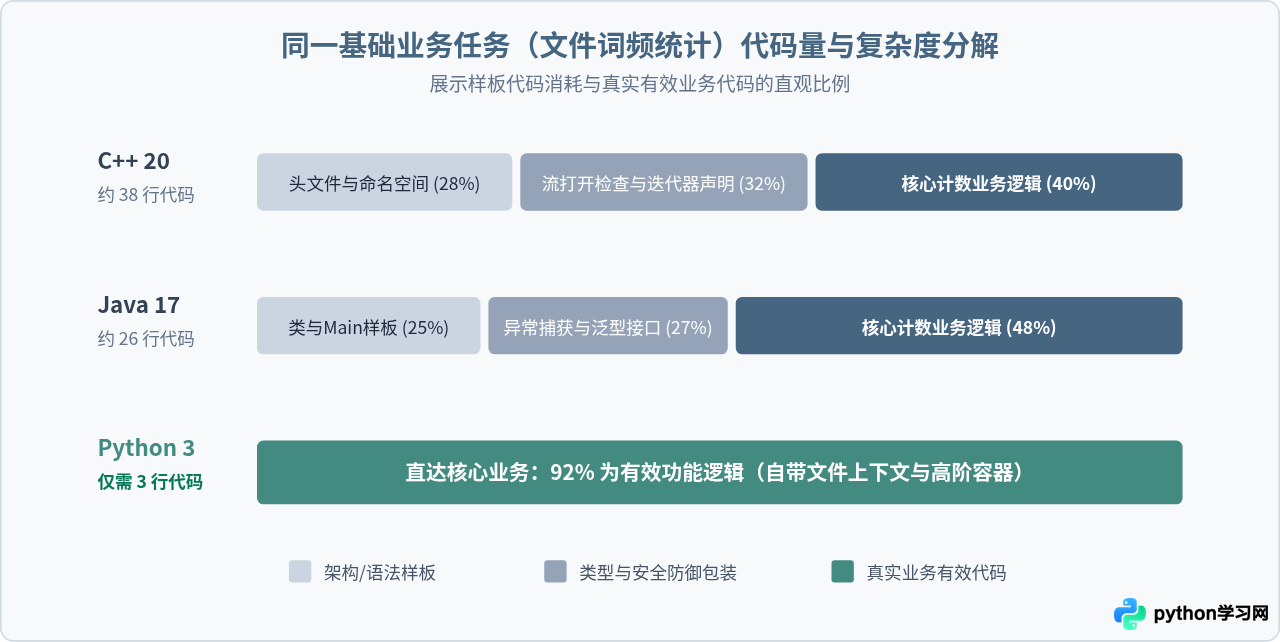
在代码量的统计中,通常有一条规律:完成同一业务功能,C++代码量往往是Java的1.5倍左右,而Java的代码量通常是Python的3至5倍。代码行数不仅直接关联打字速度,更关键的是决定了代码阅读、走查审查以及后期排查隐患所需耗费的脑力成本。
1. 样板代码消除(Boilerplate Elimination)
以一个极度常见的场景为例:从文本文件中读取所有单词,并统计每个单词出现的频次。
- C++ 实现:需要包含
<fstream>、<map>、<string>等多个头文件,声明文件输入流对象,显式检查文件是否成功打开,定义std::map<std::string, int>容器,使用循环读取字符串流,并在必要时考虑空字符或缓冲区异常。 - Java 实现:需要建立类定义与
public static void main样板方法,引入BufferedReader、FileReader,声明Map<String, Integer>接口与具体实现类HashMap,包裹try-catch-finally或使用try-with-resources语法来关闭流,并在循环内部使用map.put(word, map.getOrDefault(word, 0) + 1)。 - Python 实现:直接利用内置容器与现代语法糖:
from collections import Counter

# 仅需两行核心代码即可完成读取与统计
with open("words.txt", "r", encoding="utf-8") as f:
    word_counts = Counter(f.read().split())
在这组对比中,Python内置的 Counter、上下文管理器 with 和动态分词切片,将开发者从烦琐的文件句柄关闭、类型参数化声明和哈希表查找赋值细节中彻底解脱出来。
四、生态系统与“自带电池”哲学
Python诞生时确立了著名的“自带电池”(Batteries Included)设计理念,即标准库中直接提供了大量拿来即用、功能完备的模块。例如处理JSON、解析CSV、生成哈希摘要、建立HTTP服务、解析URL、执行正则表达式以及处理日期时间等,均包含在官方标准库中,不需要安装任何外部依赖,代码就能在标准安装环境下顺利跑通。
在第三方生态领域,Python更表现出了极高的抽象黏合度(Glue Language 特质):
- 数据科学与机器学习:NumPy、Pandas、PyTorch 等主流基础库的核心计算虽然由C/C++与CUDA编写以保证极致算力,但向外暴露的却是高度声明式、极其符合直觉的Python高层API。开发者可以用两三行代码完成矩阵切片、并行运算或大模型推理调度,完全不用介入底层的多线程锁与内存SIMD矢量化指令。
- Web开发与网络爬虫:使用 FastAPI 或 Requests,几分钟内就可以搭起一个支持自动校验Schema与自动生成Swagger文档的RESTful服务,或者写出一个具备重试与连接池特性的抓取脚本。而在Java中,往往需要配置Maven/Gradle依赖树、处理版本冲突,并书写DTO实体与Controller注解。
五、效率边界与权衡:何时不该单纯依赖Python
讨论开发效率不能脱离具体的工程规模与运行场景。Python在开发初期的“高生产率”,在某些边界条件下需要付出相应代价,开发者应当客观权衡:
AttributeError)。因此现代Python开发普遍引入了 type hints(类型注解)结合 mypy 静态分析工具来稳固大型系统的可维护性。
| 对比维度 | C++ | Java | Python |
|---|---|---|---|
| 原型构建耗时 | 长(需搭建完整编译体系与内存模型) | 中(需构建包、类结构与依赖环境) | 极短(脚本化即时执行,几行出结果) |
| 语法与样板密度 | 极高(指针、头文件、模板报错繁复) | 较高(纯面向对象、样板注解与受检异常) | 极低(可读性高,接近伪代码语法) |
| 运行时计算性能 | 极致原生硬件性能(零运行时开销抽象) | 极高(经过成熟JIT优化后非常逼近原生) | 相对较慢(需通过C扩展或高层封装弥补) |
| 并发与多线程 | 原生多线程支持,对底层锁完全可控 | 完备的企业级线程并发模型与虚拟线程 | 受限于GIL(全局解释器锁),多偏向多进程或异步IO |
| 最适用业务场景 | 操作系统、游戏引擎、高频交易、底层驱动 | 大型分布式微服务、金融系统、高并发后台 | AI/机器学习、数据分析、自动化工具、快速Web原型 |
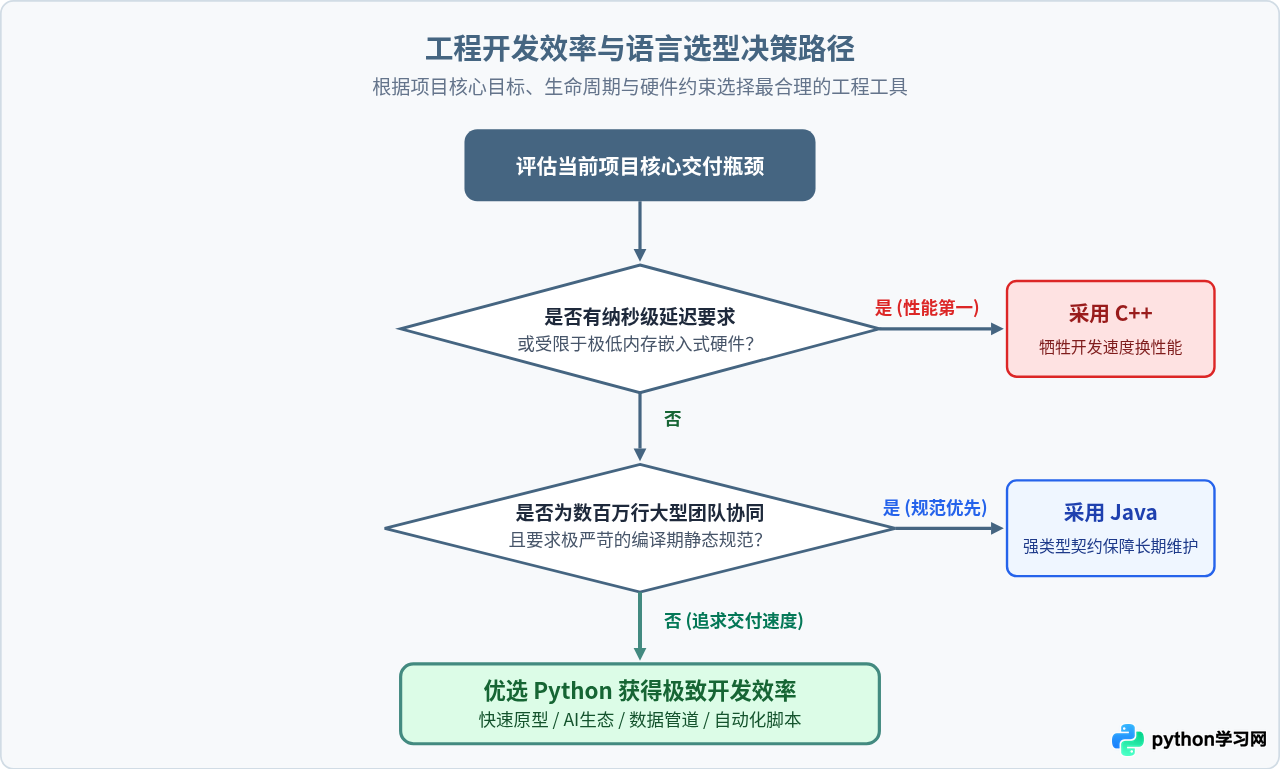
六、总结
对比Java和C++,Python在开发效率上的优势并非建立在某种神秘黑盒之上,而是来自于明确的工程取舍:以牺牲少许底层机器执行效率与编译期强契约为代价,换取开发者编码心智的极大解放。它通过免去编译等待、剔除样板结构、内置高级容器以及直接站在成熟生态的肩膀上,让程序员能够以最短的路径把脑海中的业务需求转换为可执行的软件实体。在业务瞬息万变、需要快速验证与频繁迭代的场景中,这种开发效率上的代差优势正是其核心竞争力所在。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















