


Python函数参数定义顺序规则:解决non-default argument follows default argument错误
深入解析Python中non-default argument follows default argument报错原因,讲解位置传参底层机制、排查修复步骤、完整参数定义规范及关键字参数进阶特例。
在编写 Python 函数时,如果你将没有默认值的参数写在了带默认值的参数后面,Python 解释器在语法解析阶段就会直接抛出 SyntaxError: non-default argument follows default argument 异常。解决这个问题的核心规则非常明确:在常规函数形参列表中,所有没有默认值的必填参数,必须严格定义在所有带有默认值的可选参数之前。本文将深入剖析该报错的底层解析原理,通过实际开发案例演示排查与重构步骤,并梳理 Python 完整的函数参数顺序规则与进阶特例。
一、报错原因与底层解析机制
很多初学者会将该错误视为普通的运行时逻辑错误,但实际上它是一个 语法错误(SyntaxError)。这意味着甚至在代码执行前、Python 解释器将源码编译为抽象语法树(AST)和字节码的过程中,就会立即拒绝编译。之所以做出如此强硬的语法限制,根本原因在于位置实参匹配的二义性(Ambiguity)。
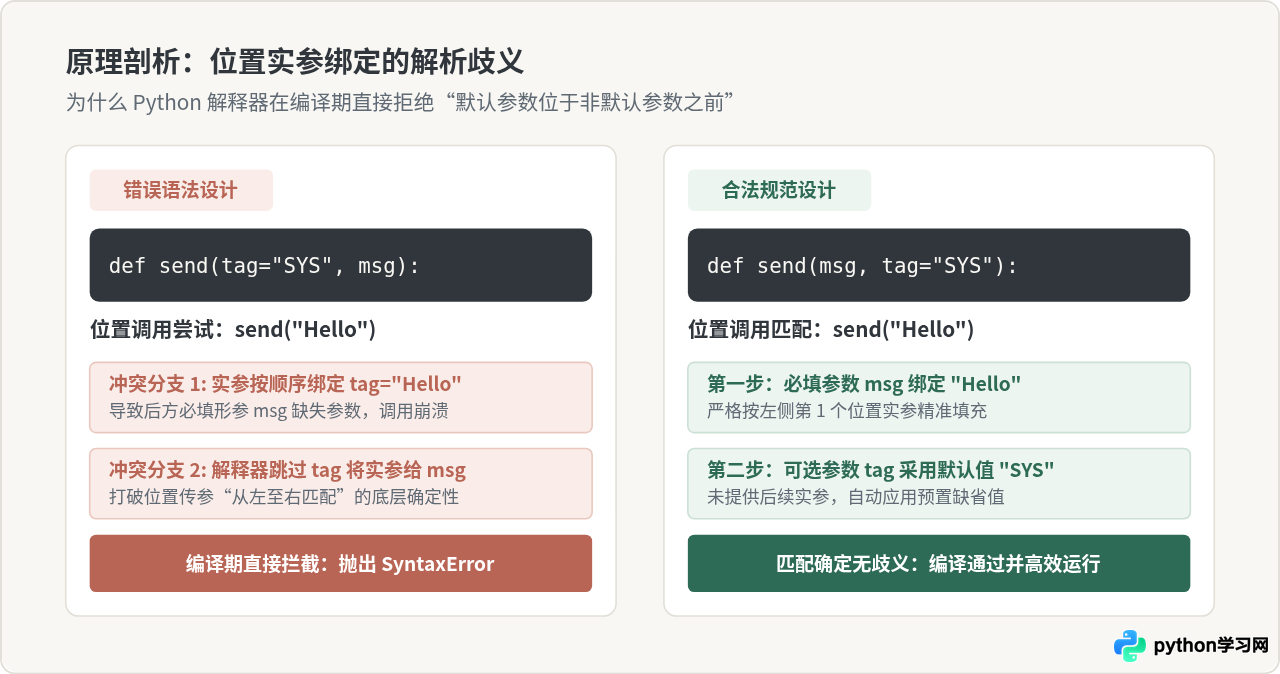
假设 Python 允许违背这一规则,允许写出形如 def send(tag="SYS", msg): 的定义。那么当调用者执行 send("Hello") 时,解释器将陷入两难困境:
- 假设赋值给第一个形参
tag:传入的字符串"Hello"覆盖了默认值"SYS",但紧随其后的必填参数msg就没有接收到任何实参,导致函数在调用时必然报错缺失参数。 - 假设跳过
tag赋值给第二个形参msg:虽然参数得到了满足,但这彻底摧毁了编程语言中最基本的“位置参数自左向右按序绑定”的确定性原则。若函数有多个默认与非默认混合参数,解释器根本无法推断调用者想跳过哪一个。
为了保证位置传参的纯粹与可预测性,Python 强制要求:一旦某个形参赋予了默认值,其后同一区域内的所有形参都必须赋予默认值。
二、典型报错场景与现场代码修复
在日常开发中,该错误往往出现在以下三种典型场景中:
场景 1:在已有函数末尾随手追加必填参数
这是最常见的人为疏忽。原有函数定义已经包含带默认值的参数,后续迭代时开发者直接在括号最右侧追加了新功能所需的参数,却忘记它没有默认值。
# 错误写法:在默认参数 timeout 之后追加了必填参数 retry
def fetch_api(url, timeout=10, retry):
    pass

# 终端报错:
# SyntaxError: non-default argument follows default argument
修复方式 A(调整顺序):如果 retry 是必填项,将其前移至所有默认参数左侧:
def fetch_api(url, retry, timeout=10):
    pass
修复方式 B(赋予默认值):如果 retry 本身可以有合理的预设行为(例如重试 3 次),则直接为其指定默认值:
def fetch_api(url, timeout=10, retry=3):
    pass
场景 2:面向对象编程中 __init__ 构造方法的参数混淆
在类的构造函数中,self 作为常规的首位位置参数,同样遵循上述规则。如果在 self 之后先声明了可选配置,再声明必填属性,同样会触发该错误。
class DatabaseConnector:
    # 错误写法:host 与 port 有默认值,但 database 与 user 在其后且无默认值
    def __init__(self, host="localhost", port=3306, database, user):
        self.host = host
        self.port = port
        self.database = database
self.user = user修复后标准写法:严格按照“对象实例 self → 必填业务参数 → 可选配置参数”的层次组织:
class DatabaseConnector:
    def __init__(self, database, user, host="localhost", port=3306):
        self.database = database
        self.user = user
        self.host = host
        self.port = port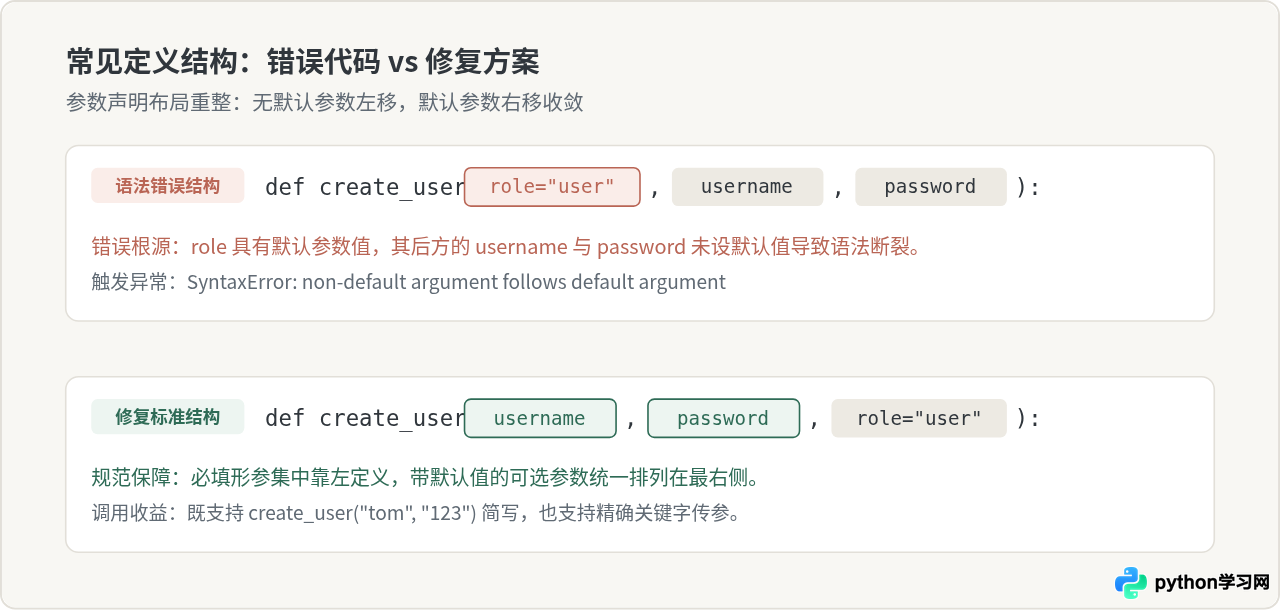
三、排查与安全重构的四步操作流程
当项目规模较大、涉及多处函数调用时,单纯调整形参定义顺序可能引发已有调用方的实参错位。推荐遵循以下四步标准流程进行排查与重构:
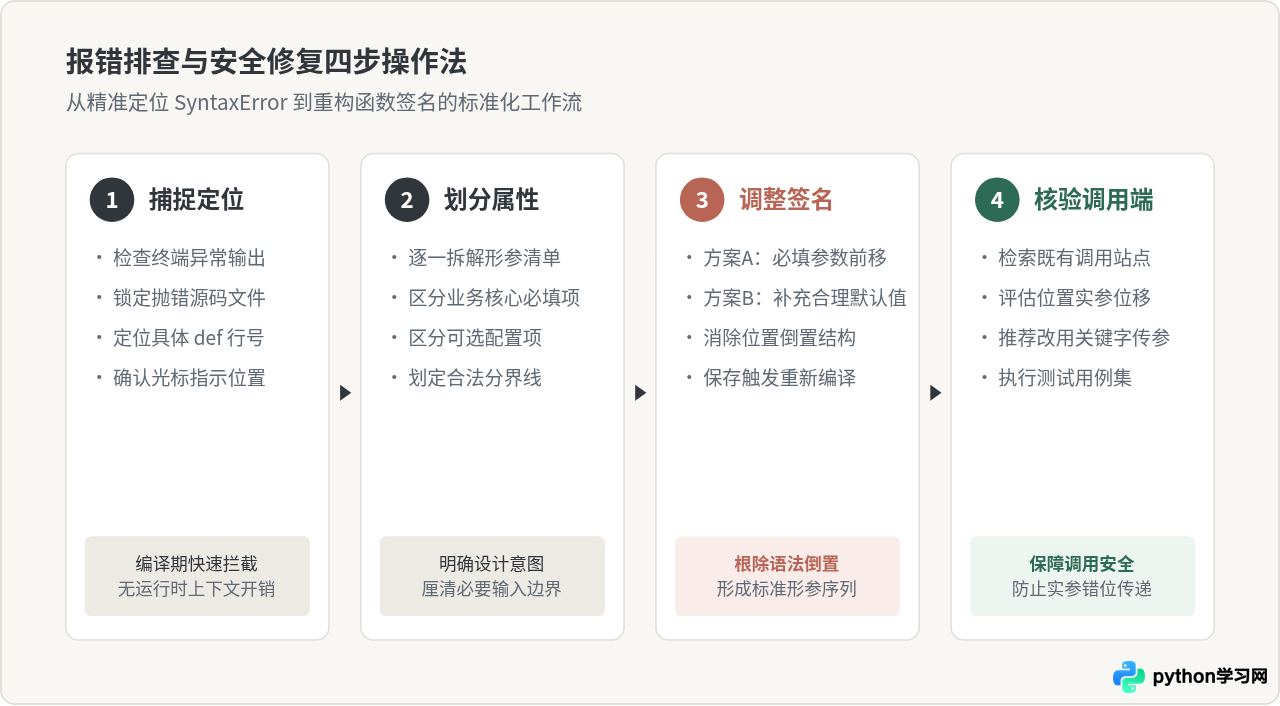
- 第一步:捕捉定位报错行。查看控制台堆栈输出,
SyntaxError会精准标出发生语法倒置的文件路径、具体行号以及指向问题参数的提示符^。 - 第二步:划分参数必选属性。对照业务需求,逐一确定哪些参数是调用方必须明确提供的,哪些参数可以预置缺省行为。
- 第三步:调整函数签名。优先将必选参数移动到所有带默认值参数的前方;如果某些参数本质上是可选的,为其补充符合预期的默认值。
- 第四步:全面核查已有调用端(Call Sites)。如果函数此前已被外部调用,且调用方使用的是纯位置传参(例如
func(1, 2)),形参顺序改变会导致传入值与形参对应关系错位。在此步骤中,应当利用 IDE 的全局引用检索,更新调用端代码;对于参数较多的场景,强烈建议调用端改用显式关键字实参(例如func(url=..., retry=...))以彻底免疫形参位置调整带来的副作用。
四、进阶延伸:Python 完整的函数参数顺序体系
随着 Python 版本的演进(特别是 Python 3.0 引入的仅限关键字参数以及 Python 3.8 引入的仅限位置参数),Python 函数参数的定义规则已经形成了一套严密的六阶段全景体系:
| 阶段顺序 | 参数分类 | 语法标记 / 形式 | 规则约束 |
|---|---|---|---|
| 1 | 仅限位置参数 (Positional-only) | arg, / |
位于斜杠 / 之前,只能通过位置实参传递,禁止使用关键字。 |
| 2 | 标准位置参数(无默认值) | param |
常规必选参数,可按位置或关键字传递。 |
| 3 | 标准位置参数(有默认值) | param=default |
常规可选参数,必须排在无默认值标准参数之后。 |
| 4 | 可变位置参数 | *args |
接收多余的位置实参并打包为元组,每个函数最多一个。 |
| 5 | 仅限关键字参数 (Keyword-only) | *, kw1, kw2=val |
位于单独的 * 或 *args 之后,调用时必须显式指定参数名。 |
| 6 | 可变关键字参数 | **kwargs |
接收所有多余的关键字实参并打包为字典,必须位于形参列表绝对末尾。 |
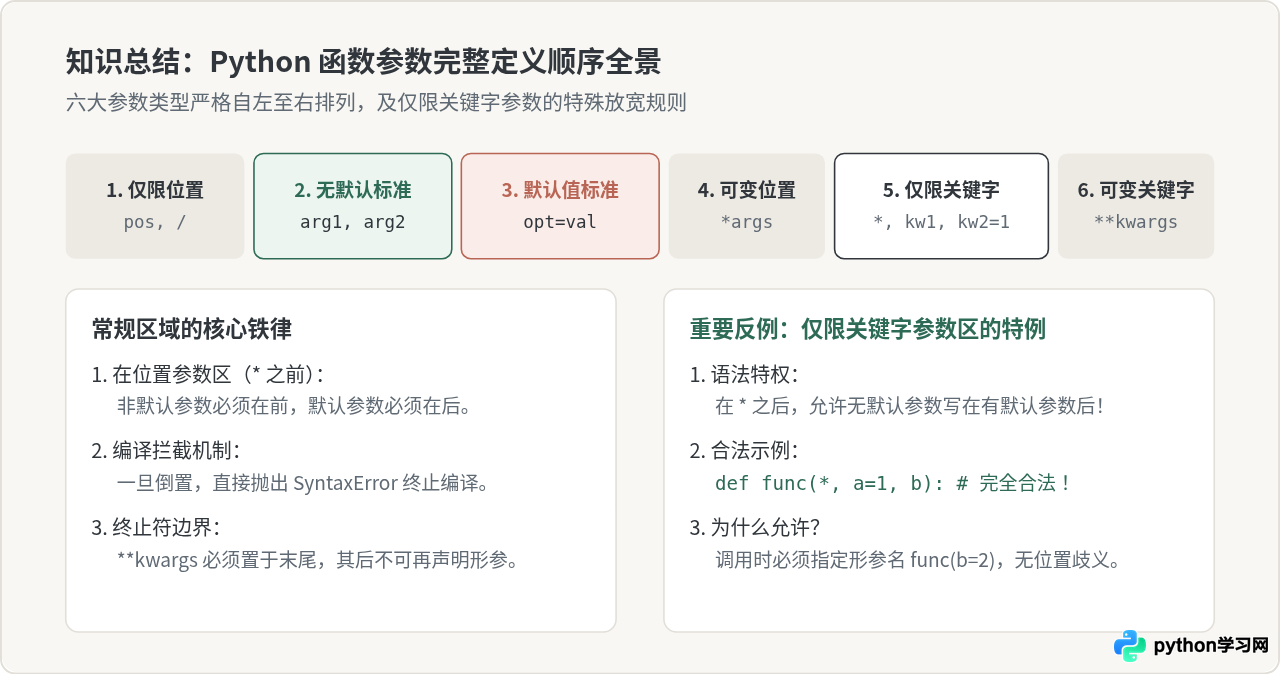
注意这个重要的进阶特例与反例:很多开发者认为“无默认参数绝对不能放在有默认参数后面”,但该规则仅适用于位置参数区域。在单个星号 * 或 *args 之后的仅限关键字参数区域中,无默认值的参数完全可以排在有默认值的参数之后!例如:def config(*, debug=False, api_key): pass 在 Python 中是完全合法的语法,因为调用方必须显式传入 api_key="xxx",不存在任何基于位置绑定的二义性。
五、参数设计最佳实践总结
为了从源头上杜绝参数顺序错误并提升代码的可维护性,建议在编写函数接口时践行以下原则:
- 核心必填参数前置:函数完成其功能最核心的输入(如操作主体、主键 ID、目标资源等)放在最左侧,绝不设置默认值。
- 配置类参数后置并设默认值:影响执行行为的微调参数(如
timeout=30、limit=100、verbose=False)放在必填参数之后。 - 参数超过 4 个时引入仅限关键字参数:通过在参数列表中插入单个
*,强制调用者使用键值对传参,既能消除顺序维护负担,又能大幅提高调用端代码的可读性。 - 警惕可变对象作为默认值:千万不要使用空列表
[]或字典{}作为默认值(应使用None并在函数内部初始化),这虽不报语法错误,却是极其隐蔽的逻辑缺陷。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















