


Python列表与字典常用操作代码举例
系统介绍Python中列表(List)与字典(Dict)的核心操作与代码示例,涵盖增删改查、切片遍历、哈希映射原理及常见开发避坑指南,配备完整内联矢量架构图。
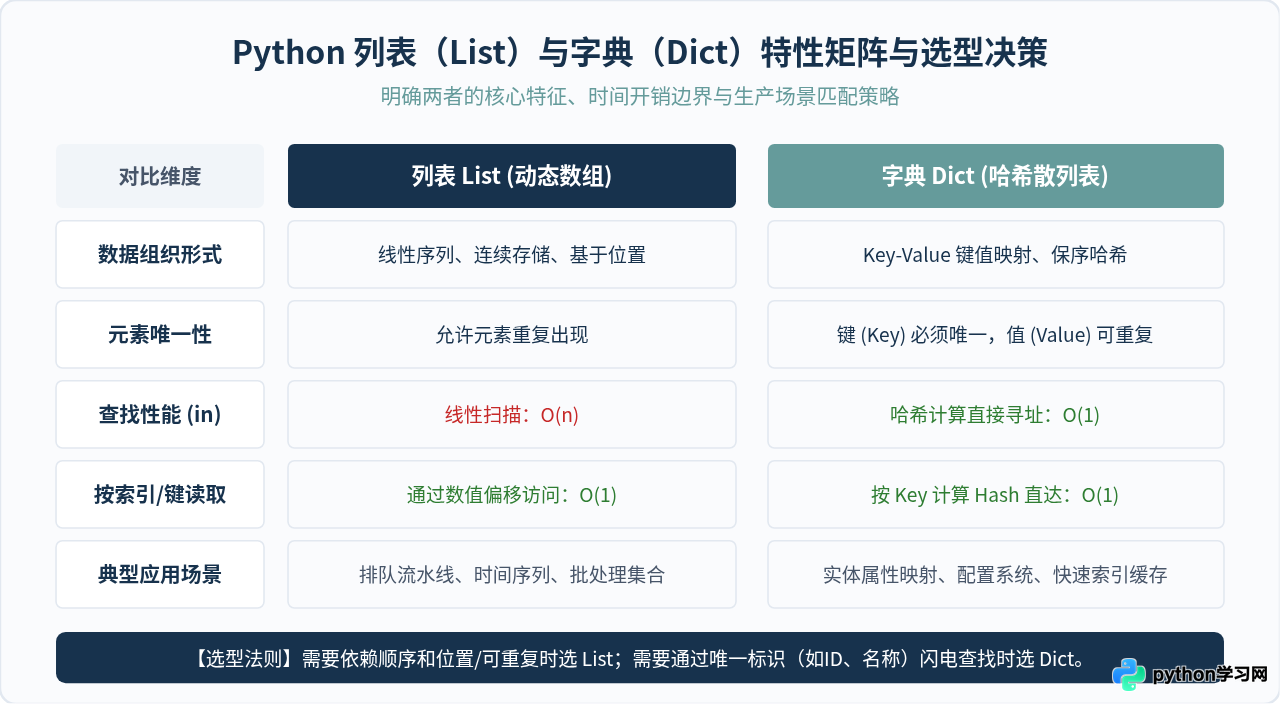
在 Python 编程实践中,列表(list)与字典(dict)是使用频率最高的两大基础复合数据结构。列表属于线性、有序且支持重复元素的可变序列,擅长处理排队、批处理与按位置索引的任务;字典则是基于散列表(Hash Table)实现的键值映射容器,擅长通过唯一的键(Key)实现近似 O(1) 复杂度的极速检索与配置管理。本文针对两者的常见操作提供直接可运行的代码示例与系统图解,帮助开发者建立扎实清晰的内存心智模型与编码直觉。
一、Python 列表(List)常用操作与代码举例
列表是 Python 的动态数组,其内部连续存储着指向各个具体对象的引用指针。由于物理内存地址连续,列表能够通过偏移量以 O(1) 的恒定时间直接访问任意位置的元素。
1. 列表的创建与推导式生成
创建列表最常用的方式是使用方括号字面量 [],也可以利用内置的 list() 构造器将可迭代对象转换成列表。对于有规律的数据序列,列表推导式(List Comprehension)提供了简洁高效的原生构建方式。
# 1. 基础字面量与类型转换
fruits = ["apple", "banana", "cherry"]
chars = list("python")  # 结果: ['p', 'y', 't', 'h', 'o', 'n']

# 2. 列表推导式:生成 0 到 9 中偶数的平方
even_squares = [x ** 2 for x in range(10) if x % 2 == 0]
print("偶数平方列表:", even_squares)
# 示例输出: 偶数平方列表: [0, 4, 16, 36, 64]
2. 元素的索引访问与切片提取
Python 列表支持正向索引(从 0 开始)和逆向索引(从 -1 表示末尾)。切片语法格式为 list[start:stop:step],切片区间为“左闭右开”(包含 start,但不包含 stop)。
skills = ["Python", "Go", "Rust", "Java", "C++"]

# 单个元素读取
print(skills[0])    # 第一个元素: Python
print(skills[-1])   # 最后一个元素: C++

# 切片提取子列表 (左闭右开)
print(skills[1:3])  # 提取下标 1, 2: ['Go', 'Rust']
print(skills[:2])   # 提取前两个: ['Python', 'Go']
print(skills[::2])  # 步长为 2 间隔提取: ['Python', 'Rust', 'C++']
print(skills[::-1]) # 列表快速反转: ['C++', 'Java', 'Rust', 'Go', 'Python']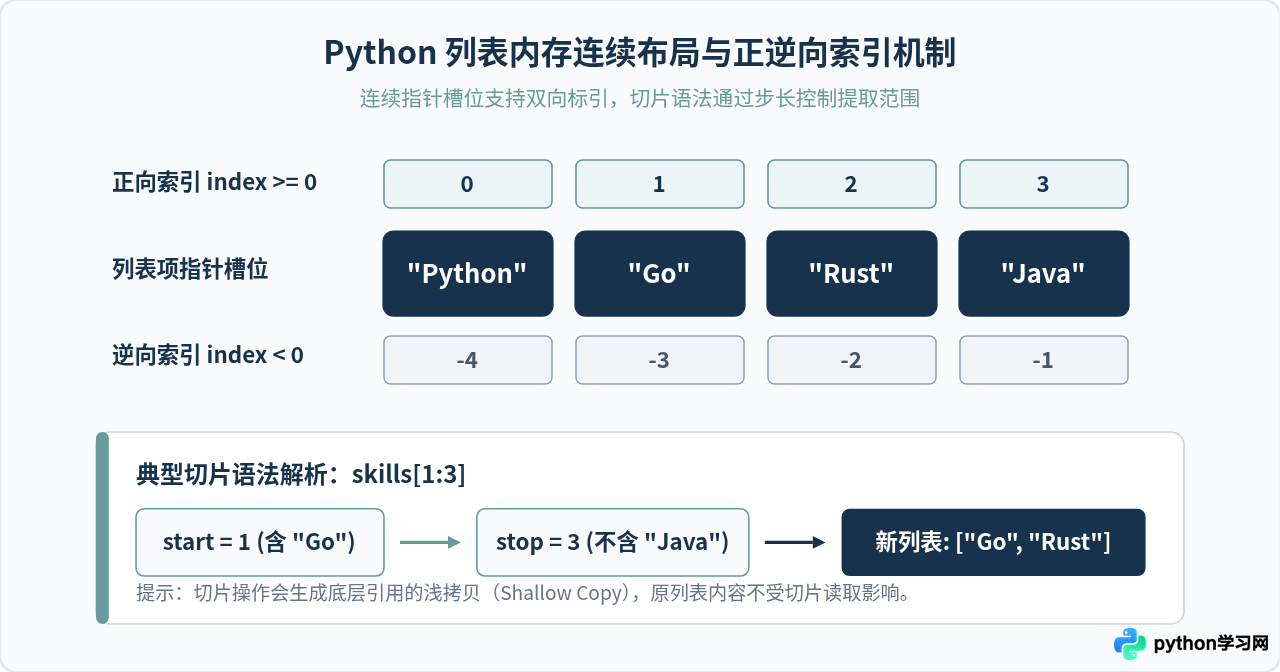
3. 元素的动态增加与批量合并
向列表添加元素主要有三种方法:
append(item):将单个元素完整追加到列表末尾,耗时为摊还 O(1)。extend(iterable):逐个解包可迭代对象并追加至末尾,等同于使用+=拼接。insert(index, item):在指定下标插入元素,导致后续所有元素向右平移,复杂度为 O(n)。
tasks = ["read_config", "init_db"]

# 1. 尾部追加单个项
tasks.append("start_server")
print("append 之后:", tasks)
# ['read_config', 'init_db', 'start_server']

# 2. 批量合并另一个序列
tasks.extend(["listen_port", "log_ready"])
print("extend 之后:", tasks)
# ['read_config', 'init_db', 'start_server', 'listen_port', 'log_ready']

# 3. 指定位置插入(在索引 1 处插入预校验步骤)
tasks.insert(1, "verify_env")
print("insert 之后:", tasks)
# ['read_config', 'verify_env', 'init_db', 'start_server', 'listen_port', 'log_ready']
4. 元素的删除与弹出
删除元素需区分“按值查找删除”与“按位置弹出删除”:
queue = ["req_1", "req_2", "req_3", "req_2"]

# 1. remove(x): 删除首次出现的指定值。若不存在会抛出 ValueError
queue.remove("req_2")
print("remove 之后:", queue)  # ['req_1', 'req_3', 'req_2']

# 2. pop([index]): 移除并返回指定位置元素;默认弹出最后一个
last_item = queue.pop()
print("pop 弹出项:", last_item, "| 剩余队列:", queue)
# pop 弹出项: req_2 | 剩余队列: ['req_1', 'req_3']

# 3. del 语句按索引或切片范围批量销毁
del queue[0]
print("del 之后:", queue)  # ['req_3']

# 4. clear(): 清空列表内所有元素
queue.clear()
print("clear 之后:", queue)  # []
5. 查找、统计与排序
scores = [78, 92, 85, 92, 60, 99]

# 成员检查与统计
print(92 in scores)       # True (是否存在)
print(scores.count(92))   # 2 (出现次数)
print(scores.index(92))   # 1 (首次出现的索引)

# 排序区分:原址修改 vs 返回全新列表
sorted_copy = sorted(scores, reverse=True)
print("sorted() 返回新列表:", sorted_copy)

scores.sort()
print("list.sort() 原址排序:", scores)
# 注意: scores.sort() 返回值为 None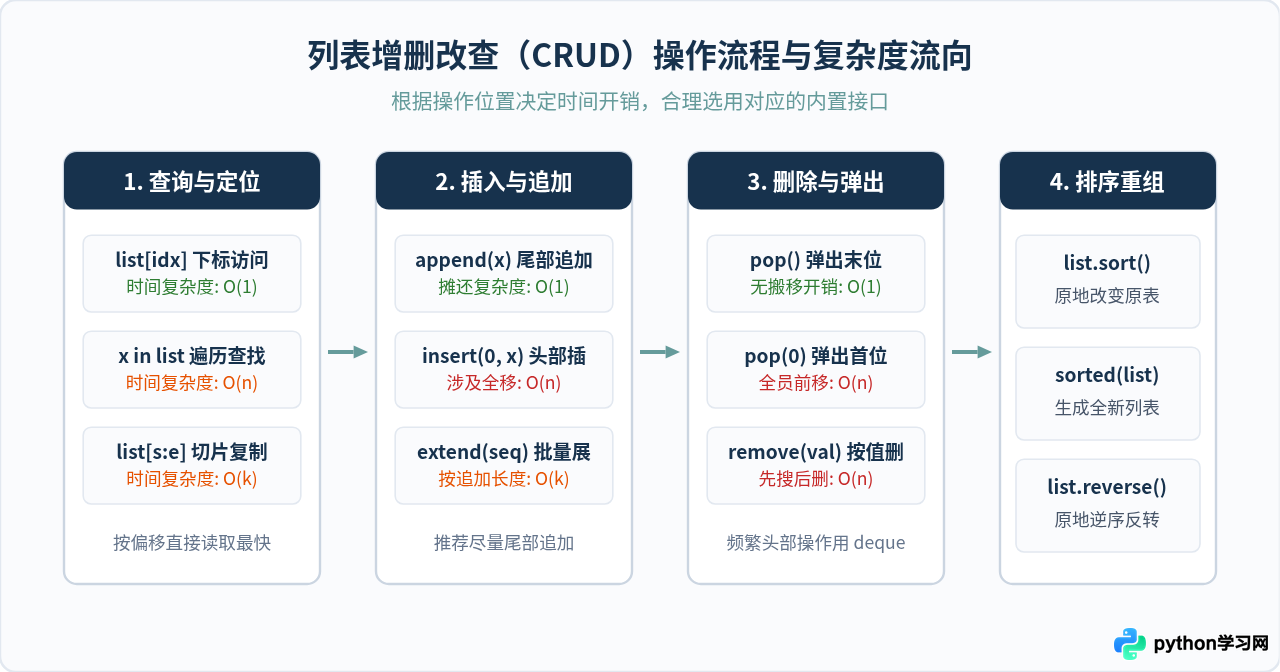
二、Python 字典(Dict)常用操作与代码举例
自 Python 3.7 起,内置字典已正式保证“键值对保持插入顺序”。字典的底层核心是紧凑型哈希表,通过计算键的哈希值(hash(key))直接映射到槽位,因此无论是查找、新增还是删除,其平均时间复杂度均为 O(1)。
1. 字典的声明与动态构建
除花括号 {} 外,还可以通过键值对元组列表、关键字传参、字典推导式快速构建字典:
# 1. 基础字面量与 dict 构造器
user = {"id": 1001, "name": "Alice", "role": "developer"}
config = dict(host="127.0.0.1", port=8080, debug=True)

# 2. 字典推导式:过滤并转换现有数据
raw_scores = {"math": 90, "english": 58, "physics": 82}
passed_scores = {k: v for k, v in raw_scores.items() if v >= 60}
print("及格科目:", passed_scores)
# 及格科目: {'math': 90, 'physics': 82}

# 3. dict.fromkeys 快速赋予默认初始化值
fields = ["read_count", "like_count", "share_count"]
counters = dict.fromkeys(fields, 0)
print("计数器初始化:", counters)
# {'read_count': 0, 'like_count': 0, 'share_count': 0}
2. 安全查询:中括号访问 vs get() 与 setdefault()
直接使用 d[key] 读取不存在的键时会引发 KeyError 异常。在生产环境处理外部不确定输入(如 API JSON 或请求参数)时,推荐使用 .get() 或 .setdefault():
profile = {"name": "Bob", "level": 2}

# 1. 直接访问:键必须存在,否则崩溃
print(profile["name"])  # Bob
# print(profile["email"])  # 触发 KeyError: 'email'

# 2. get(key, default): 键不存在时返回回退值,默认返回 None
email = profile.get("email", "no_email@example.com")
print("获取邮箱:", email)  # no_email@example.com

# 3. setdefault(key, default): 若键不存在,不仅返回该默认值,还会将其写入原字典
tags = profile.setdefault("tags", [])
tags.append("newbie")
print("更新后的 profile:", profile)
# {'name': 'Bob', 'level': 2, 'tags': ['newbie']}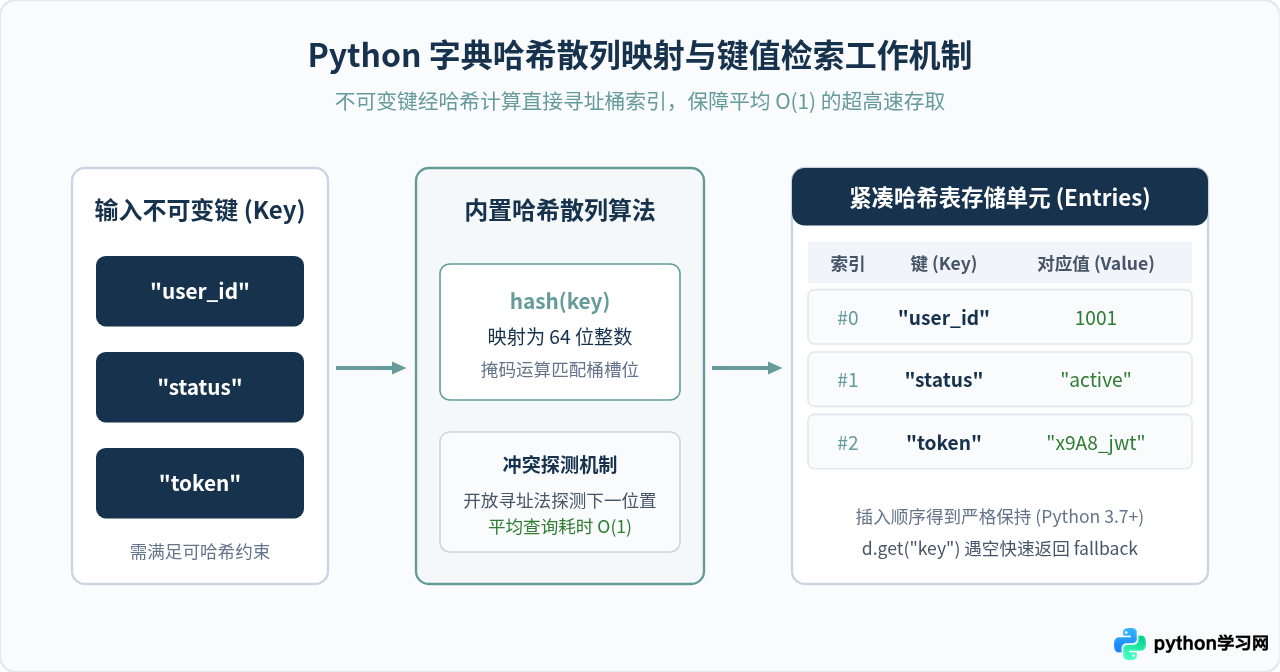
3. 元素的增改与批量合并更新
字典的键是唯一的。若键存在,重新赋值将覆盖原值;若键不存在,则新增该键值对。
app_state = {"version": "1.0.0", "is_running": True}

# 1. 单个键值对的增与改
app_state["is_running"] = False      # 修改已有键
app_state["max_workers"] = 4         # 新增全新键

# 2. update() 批量增量覆盖
app_state.update({
    "version": "1.1.0",
    "environment": "production"
})
print("update 之后的配置:", app_state)
# {'version': '1.1.0', 'is_running': False, 'max_workers': 4, 'environment': 'production'}

# 3. Python 3.9+ 字典合并运算符 (| 与 |=)
patch = {"timeout": 30}
merged_state = app_state | patch
print("合并后的新字典:", merged_state)
4. 字典元素的删除与弹出
cache = {"sess_1": "data_a", "sess_2": "data_b", "sess_3": "data_c"}

# 1. pop(key[, default]): 弹出并返回对应的值;建议配置 default 防止 KeyError
val = cache.pop("sess_2", None)
print("pop 弹出的数值:", val)  # data_b

# 2. popitem(): 按照后进先出 (LIFO) 顺序弹出最后插入的键值对元组
last_pair = cache.popitem()
print("popitem 弹出的键值对:", last_pair)  # ('sess_3', 'data_c')

# 3. del 明确销毁特定键
del cache["sess_1"]

# 4. clear(): 清空整本字典
cache.clear()
print("clear 之后:", cache)  # {}
5. 字典的三种遍历视图
字典提供了 .keys()、.values() 和 .items() 三种动态视图对象。它们与底层哈希表直接联动,内存开销极低。
student_scores = {"Tom": 88, "Jerry": 95, "Spike": 72}

# 1. 默认迭代或 .keys() 遍历所有键
for name in student_scores:
    print(f"学生姓名: {name}")

# 2. 遍历所有值 (.values())
total = sum(student_scores.values())
print(f"总成绩: {total}")

# 3. 解包遍历键值对 (.items()) —— 最推荐写法
for name, score in student_scores.items():
    print(f"{name} 的得分是 {score}")
三、常见开发避坑指南与进阶考量
在 for 循环直接迭代列表或字典的同时执行 remove()、pop() 或删除键,会导致游标错位或抛出异常。
# 错误做法(会导致部分偶数被跳过漏删):
nums = [1, 2, 2, 3, 4]
# for n in nums:
#     if n % 2 == 0: nums.remove(n)

# 正确方案 1:使用列表推导式直接生成过滤后的新列表(最优雅)
nums = [n for n in nums if n % 2 != 0]

# 正确方案 2:迭代副本 nums[:]
for n in nums[:]:
    if n % 2 == 0:
        nums.remove(n)

# 字典同理:遍历字典时不能直接增删键,否则报 RuntimeError: dictionary changed size during iteration
data = {"a": 1, "b": 2, "c": 3}
for k in list(data.keys()):  # 拷贝一份固定的 keys 列表再删除
    if data[k] % 2 == 0:
        del data[k]
Python 的函数默认参数在定义阶段仅求值一次。若将 [] 或 {} 赋给默认参数,所有未传参的函数调用将共享同一个内存容器。
# 危险写法:
# def add_item(item, target_list=[]):
#     target_list.append(item)
#     return target_list

# 工业标准规范写法:
def add_item(item, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(item)
    return target_list
字典的 Key 必须实现稳定的 __hash__() 和 __eq__() 方法。基础数据类型如整数、浮点数、字符串、元组(其内部子项也必须均不可变)可以作键;而列表、字典、集合(set)等可变类型由于内容会动态变化,不可作为字典的 Key,否则会立即触发 TypeError: unhashable type: 'list'。
四、总结速记
Python 中的列表与字典覆盖了绝大多数日常开发的数据聚合场景。在实际开发中,建议遵循以下实践标准:
- 善用推导式:列表与字典推导式不仅语法简练,在 CPython 解释器底层也经过专门的字节码优化,性能通常优于手写
for循环搭配append()。 - 防御性取值:字典取值优先使用
dict.get(key, default),避免因意外缺失字段造成程序异常终止。 - 慎用低效操作:避免在超长列表频繁执行
insert(0, item)或pop(0),如有高频双端操作需求应选用标准库collections.deque。 - 哈希安全:牢记字典键必须是不可变对象,且包含判断
in在字典上是 O(1) 操作,大幅优于长列表的 O(n) 全表扫描。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















