


Python嵌套循环的执行顺序是怎么的?
深入解析Python嵌套循环的执行顺序与底层运作机制,通过直观的步骤拆解、二维坐标轨迹图、break与continue控制流对比以及代码实例,帮助你彻底理清多层循环的运行逻辑。
很多刚接触编程的学习者在面对两层甚至三层循环时,往往容易混淆代码到底先跑哪一行、变量何时发生更新。理解嵌套循环的关键,在于建立清晰的“层级独立性”心智模型。接下来,我们将通过原理解析、时序推导、代码断点对照与控制流跳转,彻底讲透这一执行逻辑。
一、执行顺序的核心规律:外慢内快与“时钟齿轮”模型
理解嵌套循环最经典的类比就是时钟的时针与分针:
- 外层循环相当于“时针”,内层循环相当于“分针”。
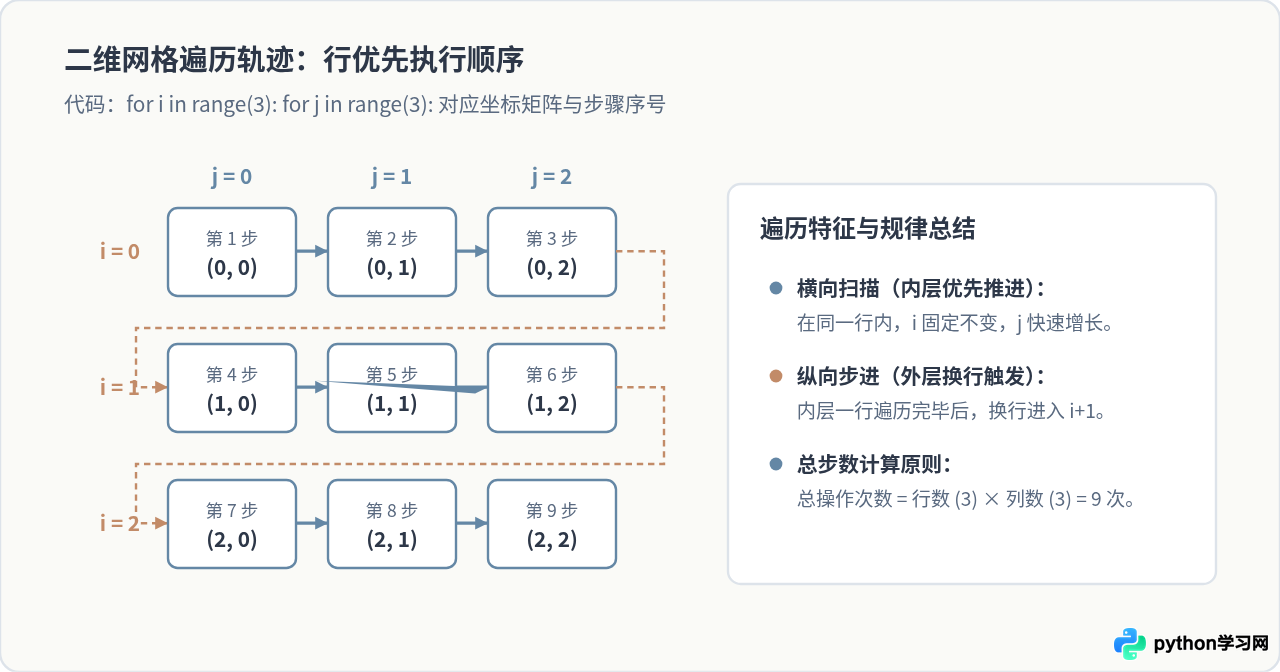
- 时针走一小格(外层完成一次迭代),分针必须完整转动一整圈(内层从起始索引到末尾索引走完所有元素)。
- 只有分针走完一整圈回到起点后,时针才会跳到下一个刻度;接着分针再次重新从第 1 分钟走到底。
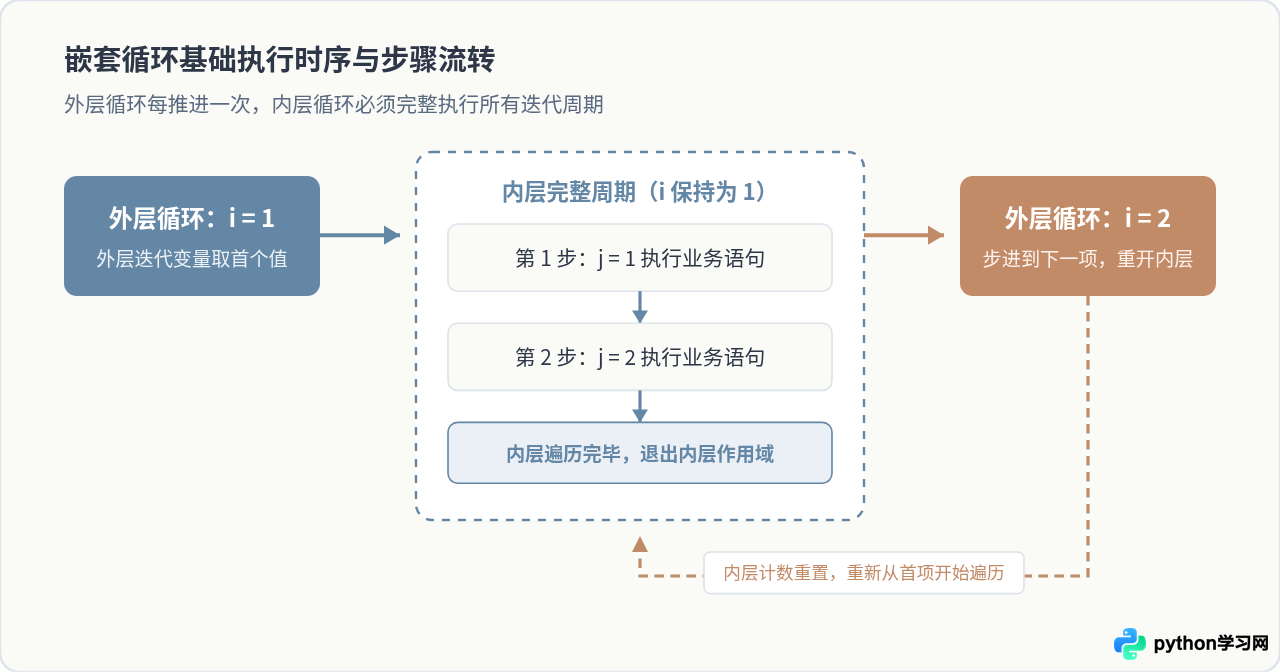
在计算机内部,代码从上至下执行到外层 for 语句时,外层变量被赋予序列中的第 1 个值。紧接着控制流进入循环体,遇到了内层 for 语句。此时,Python解释器会完全专注于将内层循环跑完,内层循环未结束前,外层变量始终保持当前值不变。
二、代码实例逐行推演:观察变量的实际轨迹
让我们通过一段最简单的两层 for 循环代码,直观观察控制台输出与变量值的跳变轨迹:
# 嵌套循环执行示例
for i in range(1, 4):         # 外层循环:i 取值 1, 2, 3
    print(f"--- 进入外层 i = {i} ---")
    for j in ['A', 'B']:      # 内层循环:j 取值 'A', 'B'
        print(f"    执行内层: i = {i}, j = {j}")
    print(f"--- 离开外层 i = {i} ---\n")
运行这段代码后,终端中打印出来的完整内容如下:
--- 进入外层 i = 1 ---
    执行内层: i = 1, j = A
    执行内层: i = 1, j = B
--- 离开外层 i = 1 ---

--- 进入外层 i = 2 ---
    执行内层: i = 2, j = A
    执行内层: i = 2, j = B
--- 离开外层 i = 2 ---

--- 进入外层 i = 3 ---
    执行内层: i = 3, j = A
    执行内层: i = 3, j = B
--- 离开外层 i = 3 ---
我们可以将这段执行过程制作为详细的单步追踪表:
| 执行序号 | 外层变量 i | 内层变量 j | 当前执行的动作与状态 |
|---|---|---|---|
| 1 | 1 | - | 外层取第 1 个元素,打印进入提示 |
| 2 | 1 | 'A' | 内层首次启动,取首项 'A' 并输出 |
| 3 | 1 | 'B' | 内层第 2 次执行,取 'B' 并输出;内层列表耗尽 |
| 4 | 1 | - | 内层结束,打印外层离开提示 |
| 5 | 2 | - | 外层推进到 2,再次准备进入内层 |
| 6 | 2 | 'A' | 注意:内层重新从第 1 项 'A' 开始执行 |
| 7 | 2 | 'B' | 内层再次遍历至末尾并结束 |
| 8 | 3 | - | 外层步进至 3,重复上述内层所有步骤 |
从表格中可以清晰地归纳出一个经常被忽略的细节:每当外层循环进入下一次迭代时,内层循环不是从上次结束的地方继续,而是被重新创建和初始化,完全从头开始。
三、关键控制流:break 与 continue 如何影响执行顺序?
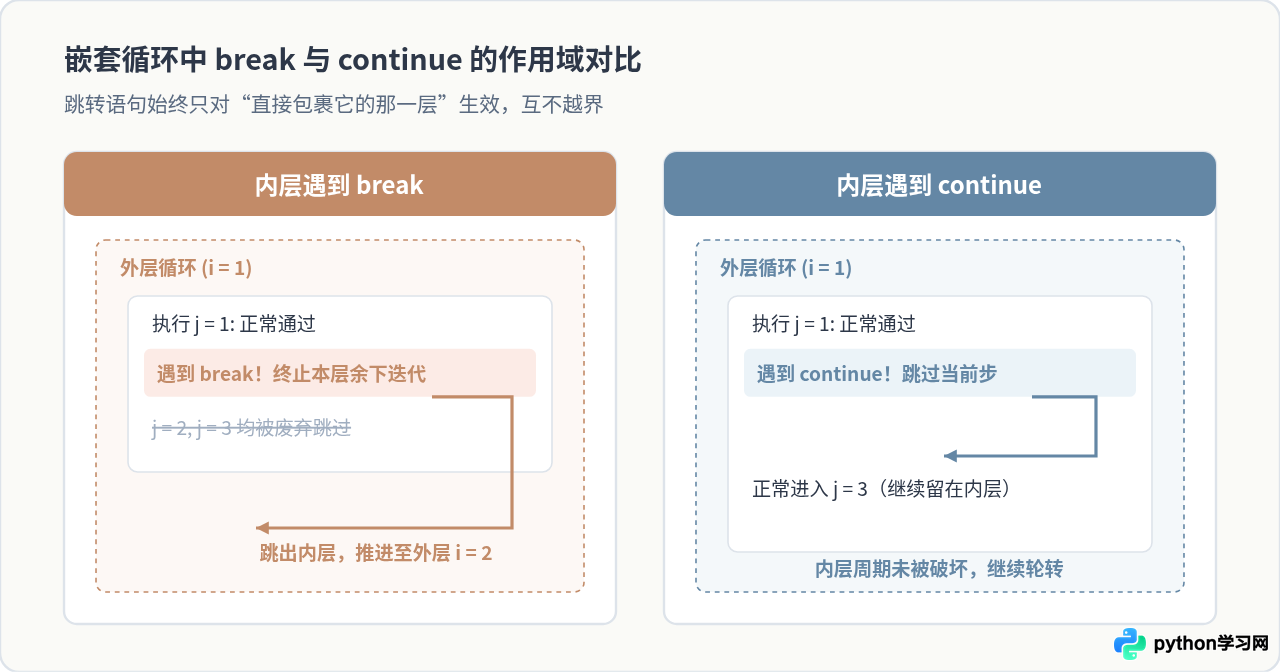
在编写业务逻辑时,我们经常需要在特定条件满足时终止循环或跳过当前项。对于嵌套循环,Python的控制流语句遵循一个极其明确的铁律:break 和 continue 永远只对“直接包裹它的那层循环”生效,不会自动波及外层。
1. break 语句的作用域表现
当 break 放置在内层循环中时,一旦触发,它会立刻终止内层循环的后续所有执行,但控制流会立即返回到外层循环,继续推进外层的下一个元素:
for i in range(1, 4):
    for j in range(1, 4):
        if j == 2:
            break  # 仅终止当前的内层循环,外层循环不受影响
        print(f"i={i}, j={j}")
输出结果为:
i=1, j=1
i=2, j=1
i=3, j=1
可以看到,每次内层 j 遇到 2 就被中断,跳过了 j=2 和 j=3;但外层 i 依然完整执行了 1、2、3。
2. continue 语句的作用域表现
当 continue 出现在内层循环时,它只会放弃内层当前单步的后续代码,直接让内层进入下一个 j,完全不打断内层的整体周期,更不会影响外层:
for i in range(1, 3):
    for j in range(1, 4):
        if j == 2:
            continue  # 仅跳过内层当前的 j=2,继续执行 j=3
        print(f"i={i}, j={j}")
输出结果为:
i=1, j=1
i=1, j=3
i=2, j=1
i=2, j=3
3. 如何同时跳出多层循环?
如果业务场景要求“一旦在内层满足某个条件,整个外层循环也必须立刻全部停下”,由于单层 break 无法越级,通常有两种标准的工程实现方式:
- 使用标志变量(Flag):在内层设置标记(如
found = True),并在外层每次迭代末尾检查该标记,若为True则在外层再次break。 - 封装成函数并直接
return(推荐):将嵌套循环包裹在一个独立的函数中,一旦命中目标条件,直接通过return退出整个函数,同时干净利接地终结所有层级的循环。
四、嵌套循环的执行次数与性能考量
了解嵌套循环的执行顺序后,另一个必须牢记的技术要点是语句的总执行频次与时间复杂度。
在没有任何跳转语句干扰的理想状态下:
例如外层执行 100 次,内层执行 100 次,内层最深处的核心业务语句就会执行 100 × 100 = 10,000 次。如果增加到三层嵌套,执行次数将呈现立方级增长(\(O(N^3)\))。
因此在编写嵌套循环时,应遵循两项实用优化习惯:
- 避免在内层循环内重复计算或执行耗时查询:如果某个变量的值只依赖外层循环变量,务必将其计算提取到内层循环之外,避免成千上万次的无谓重复开销。
- 优先考虑扁平化工具:当仅仅是遍历两个序列的笛卡尔积时,可以使用标准库提供的
itertools.product,这能够提高代码的可读性,并保持执行逻辑的清晰。
五、核心知识点全景总结
为了在实际编写代码与排查故障时能够迅速定位问题,我们可以将 Python 嵌套循环的关键机制凝练为以下三条黄金准则:
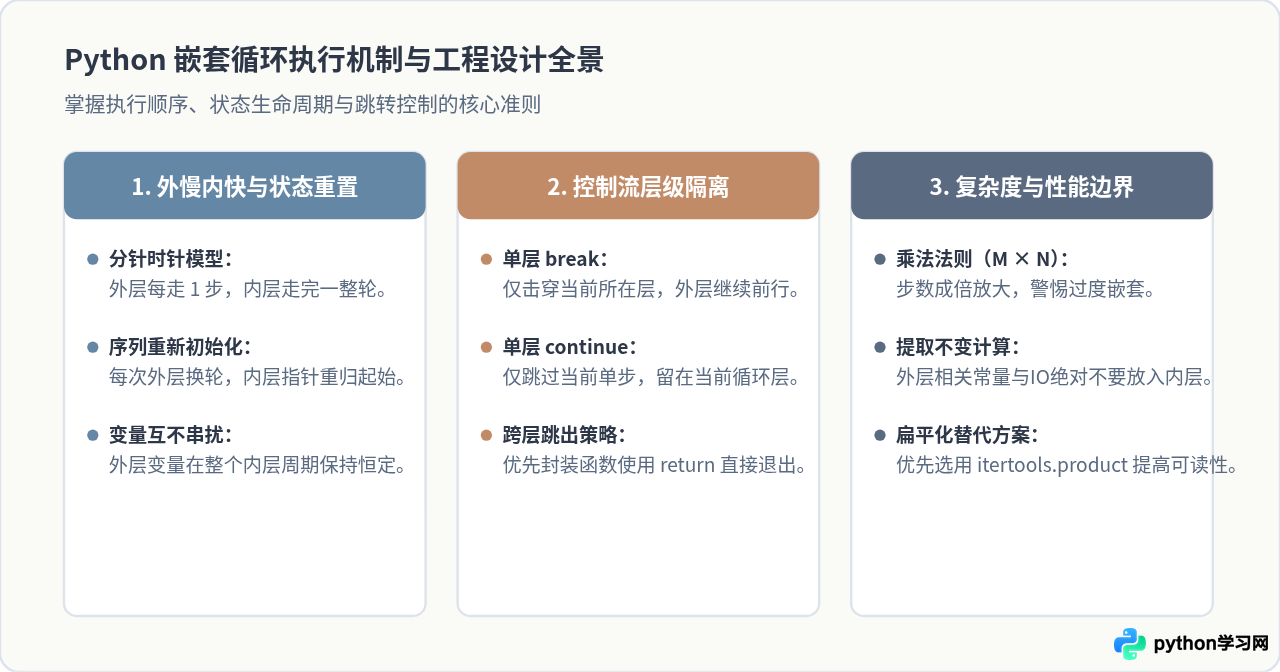
掌握了“外慢内快”的基本节奏与“层级独立”的作用域原则,无论是处理二维数据分析、图像像素矩阵,还是多层树形结构的遍历,你都能准确预判程序的每一个走向,写出严谨、高效且易于维护的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















