


Python数据分析专项练习题推荐:Pandas与NumPy实战
针对Python数据分析核心能力,精选NumPy与Pandas实战专项练习题,详解数组切片、广播机制、透视重塑、窗口函数等典型题型与避坑指南。
掌握 Python 数据分析的核心在于跳出基础语法的机械记忆,通过针对性专项题目建立高阶向量化计算与数据流重塑思维。本文围绕数据预处理、多维计算、索引重构与分组聚合四大实战瓶颈,精选最具代表性的 NumPy 与 Pandas 专项练习题,拆解解题思路与性能规范,帮助你在最短时间内突破分析瓶颈。
一、底层基石:NumPy 向量化与广播计算专项
NumPy 是整个 Python 科学计算生态的物理底座。很多初学者在过渡到 Pandas 时容易写出低效的 Python 显式循环,根源在于没有吃透 NumPy 的底层内存布局和向量化机制。做练习题时,首要目标是不依赖任何 for 循环完成多维数组的高性能计算。
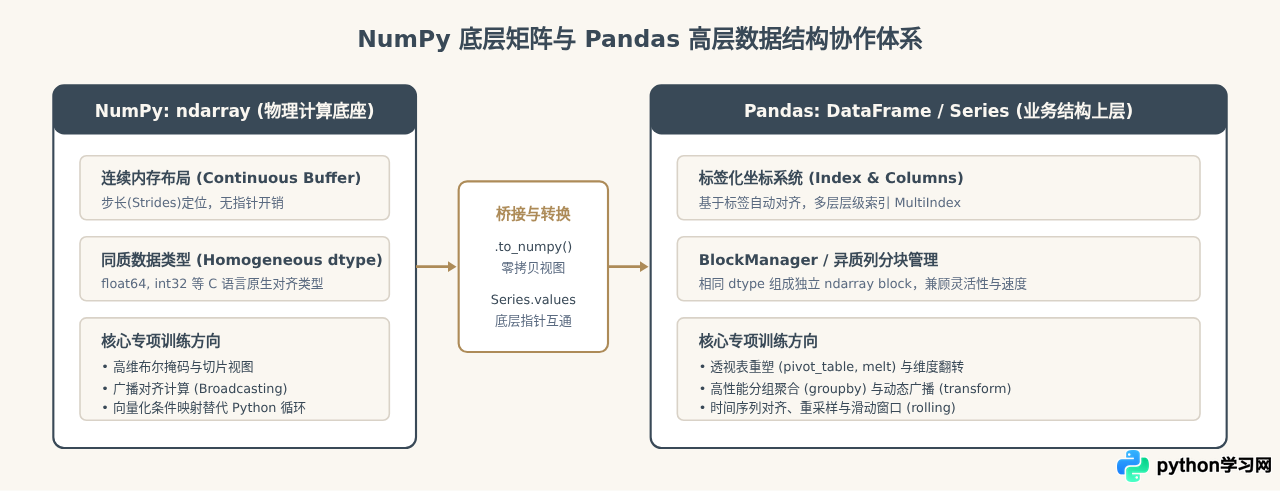
经典专项题 1:多维切片与向量化条件过滤
题目要求:给定一个 10x10 的二维随机浮点数组,找出所有大于 0.5 且位于奇数行、偶数列的元素,并直接在原数组中将这些元素缩放为原来的 10 倍,不得使用任何循环语句。
import numpy as np

# 生成可复现的示例二维数组
np.random.seed(42)
arr = np.random.rand(10, 10)

# 解题:利用切片视图定位奇数行 (1::2) 与偶数列 (0::2)
sub_view = arr[1::2, 0::2]
mask = sub_view > 0.5
sub_view[mask] *= 10

# 结果验证:此时 arr 原数组对应位置已被精准修改考查要点:切片产生的对象是底层内存视图(View)而非拷贝(Copy)。在子视图上直接做掩码运算,能以零内存开销实现对原数组特定几何位置元素的修改。
经典专项题 2:广播机制(Broadcasting)计算样本距离矩阵
题目要求:给定形状为 (N, D) 的数据矩阵 A 和形状为 (M, D) 的数据矩阵 B(N=100, M=50, D=5),要求计算 A 中每个样本点到 B 中每个样本点的欧氏距离,输出形状为 (N, M) 的距离矩阵,全程禁用 Python 双重循环。
import numpy as np

A = np.random.randn(100, 5)
B = np.random.randn(50, 5)

# 解题:利用升维广播触发跨轴差值计算
# A[:, np.newaxis, :] 形状为 (100, 1, 5)
# B[np.newaxis, :, :] 形状为 (1, 50, 5)
diff = A[:, np.newaxis, :] - B[np.newaxis, :, :] # 自动广播为 (100, 50, 5)
dist_matrix = np.sqrt(np.sum(diff ** 2, axis=-1)) # 形状为 (100, 50)考查要点:广播规则要求从末尾维度开始比对,若维度相等或其中一个维度大小为 1,则可以沿该轴隐式复制计算。这种写法是编写机器学习底层模型(如 KNN、K-Means)的必备功底。
二、实战演进:专项练习体系的四个阶段
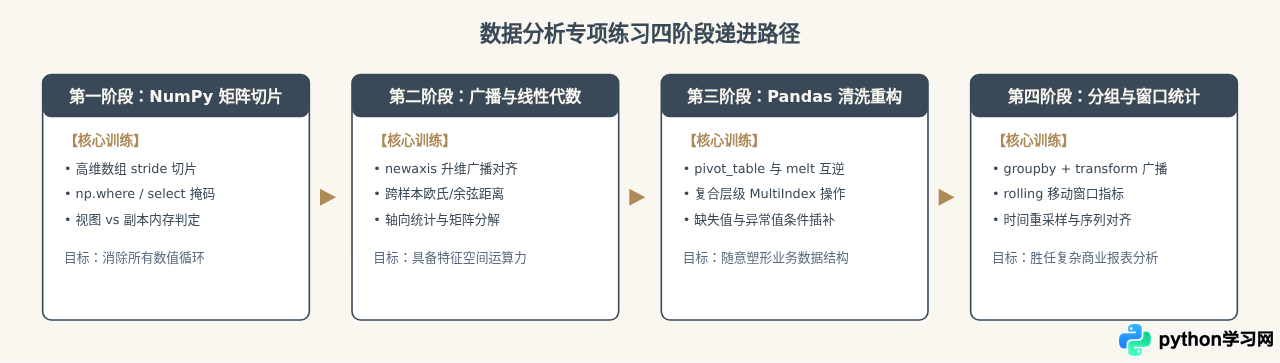
练习题切忌东拼西凑。高效的训练策略应沿着“几何切片 → 广播运算 → 关系重塑 → 窗口统计”的梯形路径逐层递进,确保每个能力模块均有明确的检验标准。
三、进阶突围:Pandas 业务清洗与重塑专项
进入真实业务场景后,数据很少以规整的二维形态直接呈现。掌握结构重塑(Reshaping)和分组聚合(Aggregation)是衡量数据分析实战能力的试金石。
经典专项题 3:宽表与长表互转(Pivot 与 Melt)
题目要求:现有包含员工月度销售记录的长表,包含 ['employee_id', 'department', 'month', 'sales'] 四列。要求:
- 将其转换为以员工和部门为双重行索引、月份为列、销售额为数值的宽表,缺失值填补为 0;
- 计算每位员工的总销售额并添加为新列
'total_sales'; - 再将宽表还原回原本的长表格式。
import pandas as pd

# 构建示例长表数据
data = {
    'employee_id': [101, 101, 102, 102, 103],
    'department': ['IT', 'IT', 'Sales', 'Sales', 'IT'],
    'month': ['Jan', 'Feb', 'Jan', 'Mar', 'Feb'],
    'sales': [3500, 4200, 5000, 6100, 2800]
}
df = pd.DataFrame(data)

# 1. 转换为宽表
pivot_df = df.pivot_table(
    index=['employee_id', 'department'],
    columns='month',
    values='sales',
    fill_value=0
)

# 2. 跨列聚合求和
pivot_df['total_sales'] = pivot_df.sum(axis=1)

# 3. 还原长表(排除 total_sales 后 reset_index 再 melt)
restored_df = pivot_df.drop(columns=['total_sales']).reset_index().melt(
    id_vars=['employee_id', 'department'],
    var_name='month',
    value_name='sales'
)
# 过滤掉填充 0 的非原始记录
restored_df = restored_df[restored_df['sales'] > 0]
经典专项题 4:分组计算占比(Groupby + Transform 广播)
题目要求:给定电商订单数据表,包含 ['city', 'category', 'gmv']。要求在不打乱原始行数和索引的前提下,为每一行新增两列:该城市所在品类的总 GMV,以及该订单在当前城市品类内的金额贡献占比。
import pandas as pd

orders = pd.DataFrame({
    'city': ['Beijing', 'Beijing', 'Shanghai', 'Shanghai', 'Beijing'],
    'category': ['Electronics', 'Books', 'Electronics', 'Electronics', 'Electronics'],
    'gmv': [1200, 300, 2500, 1800, 800]
})

# 核心训练:利用 transform 保留原表索引进行聚合广播
grouped_sum = orders.groupby(['city', 'category'])['gmv'].transform('sum')

orders['category_total_gmv'] = grouped_sum
orders['gmv_ratio'] = (orders['gmv'] / orders['category_total_gmv']).round(4)考查要点:相比 apply,transform 的执行效率高出一个数量级,且能够自动将聚合后的单值广播对齐回原表的每一行,省去复杂的 merge 操作。
四、避坑关键:常见报错与性能优化机制
在做数据分析题目时,往往代码能跑出结果,却伴随红色警告或耗费过多内存。理解底层索引机制能有效避免常见的逻辑与性能隐患。
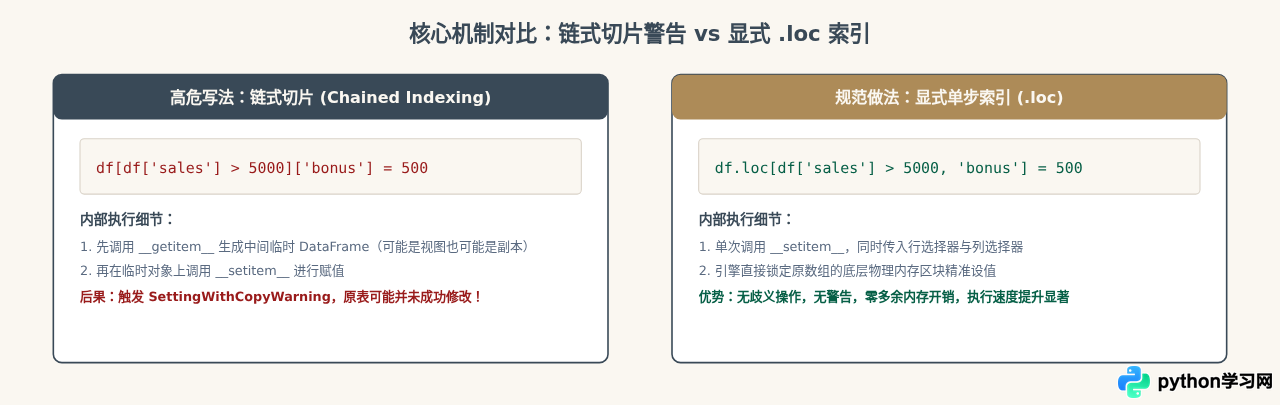
永远不要连续使用两个中括号进行筛选后赋值。凡涉及条件修改,统一采用
df.loc[行条件, 列名] = 新值。如果是为了衍生新的子表分析,请显式使用 sub_df = df[条件].copy() 断开与原表的内存视图关联。
在大规模数据集练习中,若某一列文本(如城市、状态、性别)重复值极多,其默认的
object 类型会消耗大量指针内存。将其转换为 df['city'] = df['city'].astype('category') 可瞬间降低 70% 以上的内存占用,同时大幅提升分组速度。
五、专项题库清单与实战总结
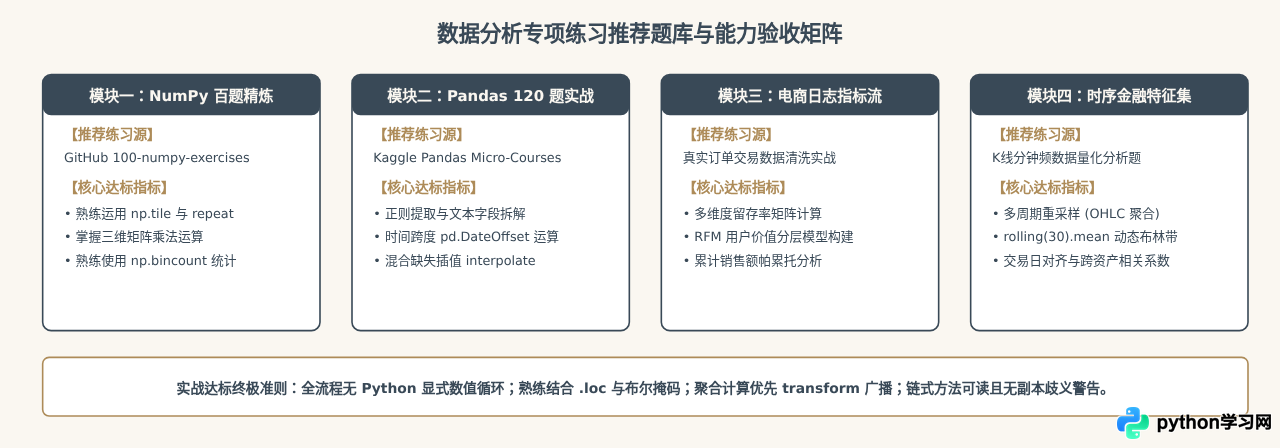
为了系统化检验学习效果,建议读者按照以下题型清单进行针对性闭卷训练。每完成一个模块,对照检验标准确认是否摆脱了低效习惯。
总结
练习 NumPy 与 Pandas 的最终目的,是培养“面向数组与数据框”的直觉思维。遇到分析需求时,先审视数据的维度与标签体系,优先寻找对应的内置向量化算子、广播维度或重塑函数,而不是立刻写 for item in list。按照上述四个阶段的题目进行针对性实操,你就能在最短时间内写出专业、健壮且高效的数据分析代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















