


怎么利用Python编程300例高效提升代码实战能力?
深入讲解如何利用Python编程300例高效提升代码实战能力,建立盲写、对比重构与变式迁移的四步演进闭环,通过分阶攻坚与工程化重写实现从看懂题解到独立交付的跨越。
一、建立四步演进闭环:从“看懂题解”到“独立交付”
许多人在练习300个案例时常陷入“看了就会、关上就忘、自己写就报错”的困境。这种现象通常源于“输入型认知”与“输出型编码”之间的脱节。要真正提升实战能力,必须为每一个案例执行完整的四步闭环。
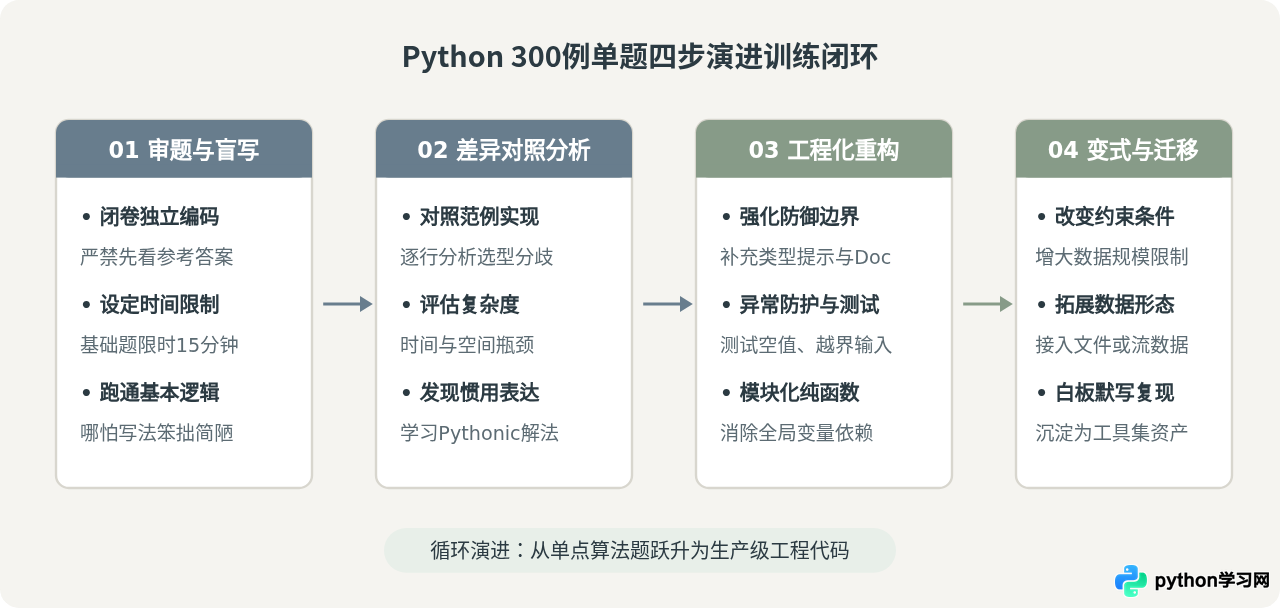
这四个步骤在实操中的具体执行细节如下:
- 第一步:审题与盲写。阅读需求后立即盖住书本或网页答案。先在草稿纸或IDE中梳理出输入参数、预期返回值以及必要的转换过程,限时独立写出可运行的代码。哪怕最初的代码充斥着多层嵌套循环或临时变量,只要逻辑自洽并输出正确结果,就迈出了第一步。
- 第二步:差异对照分析。运行成功后,打开范例解答。逐行对比自己的实现与参考代码:范例使用了哪个标准库?数据结构的选择有何不同?自己的解法在数据量从100扩大到100万时是否会发生性能崩溃?理解两者的认知差异是能力提升的核心契机。
- 第三步:工程化重构。在理解范例精髓的基础上,不要直接复制粘贴,而是对自己的代码进行二次重写。在此阶段主动加入类型注解(Type Hints)、函数文档(Docstrings)、输入边界断言以及恰当的异常处理,使简陋的代码片段达到可维护的工业标准。
- 第四步:变式与场景迁移。完成重构后,思考两个现实问题:“如果输入数据是空列表、巨大文件流或包含非法类型时代码会怎样?”、“如果将此逻辑应用到日常的日志统计或自动化脚本中该如何调用?”通过主动构造边界输入和场景演进,完成知识固化。
二、两种学习模式的关键差异:“机械照抄”与“重构变式”
在面对300个案例的体量时,学习者常会分化为两种截然不同的推进方式。在相同的时间投入(例如每天2小时、持续40天)条件下,不同的学习模式对后续实战能力的影响具有根本性差异。
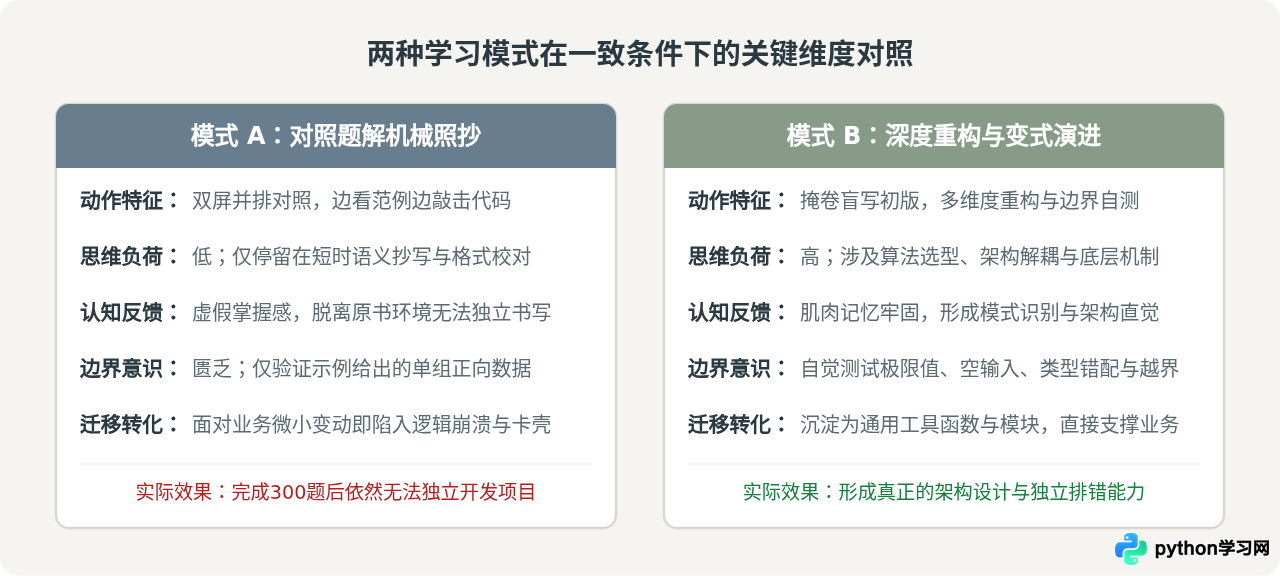
这种差异之所以关键,原因在于软件开发中真正消耗脑力的从来不是敲击语法的速度,而是应对模糊需求时的“问题建模能力”以及应对复杂输入时的“容错防御能力”:
- 大脑记忆机制的差异:照抄代码只激活了大脑的工作记忆,字符一旦从屏幕流经手指就被迅速遗忘;而先盲写、再比对、后重构的痛苦过程,会在大脑皮层中建立强烈的预测误差反馈,从而促成长期记忆和直觉反应。
- 排错定位习惯的差异:照抄代码的人极少遇到复杂的非预期报错,一旦在工作中遇到Traceback堆栈就会手足无措;而在重构与变式测试中,学习者不断主动制造错误、解读异常堆栈,从而培育出敏锐的调试嗅觉。
三、300例的四阶段进阶路线与知识图谱
面对300个案例,不要按照1到300平铺直叙地平均分配精力。科学的做法是将案例按知识维度和工程深度划分为四个阶梯,实施差异化的攻坚重点。
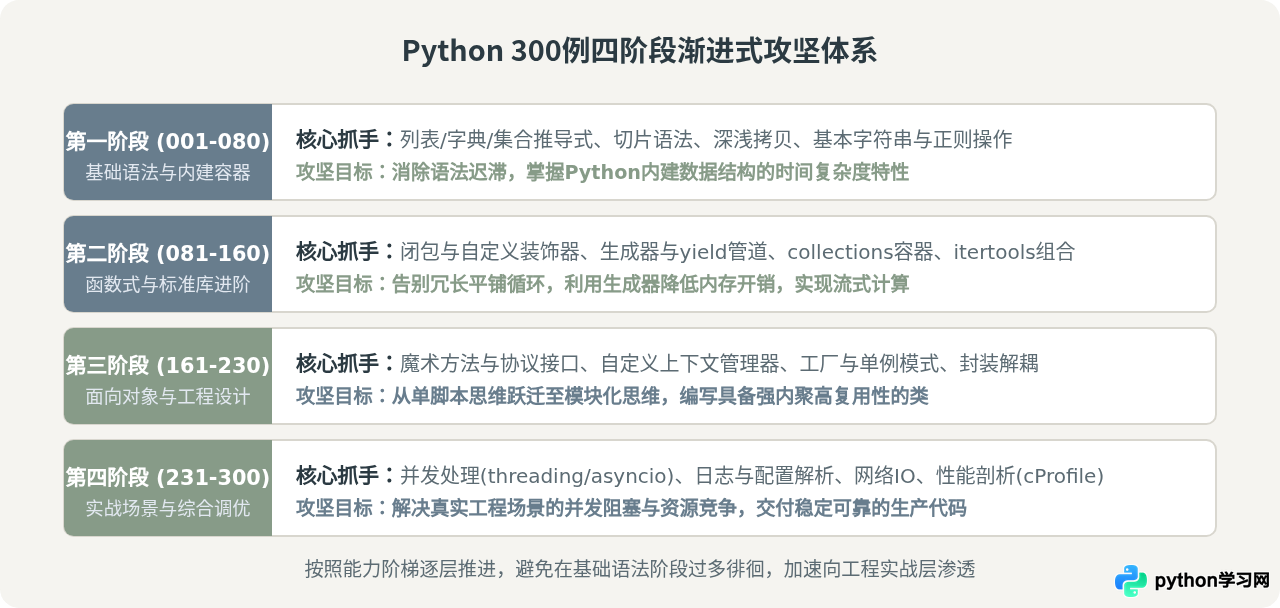
分阶训练的操作建议:
- 第一阶段(001-080例):快速过筛,聚焦Pythonic表达。本阶段多数题目涉及循环、条件分支和字典键值操作。如果发现自己还在用C语言风格的计数器去遍历列表,要强制自己替换为
enumerate()、zip()和列表推导式,建立符合Python惯用哲学的表达习惯。 - 第二阶段(081-160例):重点突破生成器与标准库。本阶段开始出现复杂的数据转换。重点掌握
collections.defaultdict、collections.Counter、itertools.chain等强大内建模块。练习将一次性载入内存的大列表改写为按需产生数据的生成器(yield)。 - 第三阶段(161-230例):由“过程式脚本”转向“工程化模块”。遇到涉及复杂业务逻辑的题目时,强制使用类(Class)和上下文管理器(
with)进行组织。思考魔术方法(如__str__、__getitem__、__enter__)如何使对象具备直观的操作界面。 - 第四阶段(231-300例):直面现实生产边界。重点关注异常处理、数据序列化(JSON/CSV)以及并发编程。编写的代码必须考虑网络断连、文件不存在、脏数据截断等异常场景,从单纯的“算对数学题”升华到“守护程序健壮性”。
四、案例实录:从一段初学者代码到工程级重构
为了直观说明如何把300例中的一道普通题目转化为实战能力,我们以一个高频出现的经典题目为例:“统计文本中出现频次最高的前K个有效单词”。
1. 初学者的原始实现(第1步:盲写初稿)
初学者在不看答案的情况下独立写出的代码往往直接翻译思维过程:拆分字符串、使用嵌套循环与双重遍历统计频次、然后手工排序。
def get_top_words_naive(text, k):
    # 手动处理大小写并分词
    words = text.lower().split()
    word_counts = {}

    # 逐词统计
    for w in words:
        # 去除标点符号(繁琐且低效)
        clean_w = w.strip(".,!?:;\"'()[]")
        if clean_w:
            if clean_w not in word_counts:
                word_counts[clean_w] = 1
            else:
                word_counts[clean_w] += 1

    # 冒泡或手动遍历寻找最大值(耗时昂贵)
    items = list(word_counts.items())
    for i in range(len(items)):
        for j in range(i + 1, len(items)):
            if items[j][1] > items[i][1]:
                items[i], items[j] = items[j], items[i]

    return items[:k]

# 示例输入与输出验证
sample_text = "Python is great. Python is dynamic, and Python code is clean!"
print("初版输出:", get_top_words_naive(sample_text, 2))
# 输出: [('python', 3), ('is', 3)]差异剖析:该实现虽然跑通了极简测试用例,但在实战场景下存在严重隐患:
- 手工双重循环排序的时间复杂度为 \(O(N^2)\),当文本包含上万不同词汇时程序将发生卡顿。
- 函数直接接收整个文本字符串,若待分析文件大小为数GB,将直接引发内存溢出(MemoryError)。
- 缺乏输入校验与类型提示,若传入
None或数字会引发未捕获的 AttributeError 崩溃。
2. 工程化重构与标准库演进(第3步与第4步:重构与变式)
对照高分解答后,我们引入 Python 标准库中的 collections.Counter、正则表达式 re 以及类型标注,并将输入源重构为支持流式处理的生成器(Iterable),实现工业级的高效与健壮。
import re
from collections import Counter
from typing import Iterable, List, Tuple

def extract_tokens(stream: Iterable[str]) -> Iterable[str]:
    """
    流式分词生成器:逐行处理文本,节约内存开销。
    使用预编译正则提取纯单词,自动过滤标点与杂质。
    """
    word_pattern = re.compile(r"[a-zA-Z0-9_-]+")
    for line in stream:
        for match in word_pattern.finditer(line.lower()):
            yield match.group()

def get_top_k_words(
    stream: Iterable[str],
    k: int = 5
) -> List[Tuple[str, int]]:
    """
    高效提取最高频词汇:
    - 时间复杂度:底层基于堆结构实现 O(N log K),远胜于 O(N^2)
    - 空间复杂度:流式迭代读取,支持无限大文本流
    """
    if k <= 0:
        return []

    tokens = extract_tokens(stream)
    counter = Counter(tokens)
    return counter.most_common(k)

# 变式验证:模拟流式分块输入,验证边界稳定性
mock_stream = [
    "Python is great.\n",
    "Python is dynamic, and Python code is clean!\n",
    "Go is fast, but Python is flexible."
]

result = get_top_k_words(mock_stream, k=3)
print("工程级输出:", result)
# 示例输出: [('is', 4), ('python', 4), ('great', 1)]五、避坑提醒与实战能力验收清单
在利用300例进行日常练习时,需要严格戒除三个常见陷阱,并在完成阶段性学习后按照统一指标检验自己的实战转化效果。
1. 必须规避的三种低效练习陷阱
- 陷阱一:只做算法推演,忽视工程规范。许多人把300例当成纯数学计算题,变量随意命名为
a, b, temp, list1,没有函数封装,所有逻辑平铺在全局作用域。这种习惯一旦养成,在进入团队协作和大型项目开发时将造成毁灭性的代码债务。 - 陷阱二:浅尝辄止,放过偶然跑通的代码。代码刚刚出现正确输出就立刻切换下一题,没有分析是否碰巧命中了测试数据。遇到报错时频繁通过
try...except: pass暴力屏蔽异常,彻底失去了排查根本原因的训练机会。 - 陷阱三:依赖IDE强提示,脱离环境无法书写。过度依赖IDE的代码补全功能,离开智能提示就记不清核心函数名、内置模块名和基本参数顺序。
2. 实战能力的四个验收指标
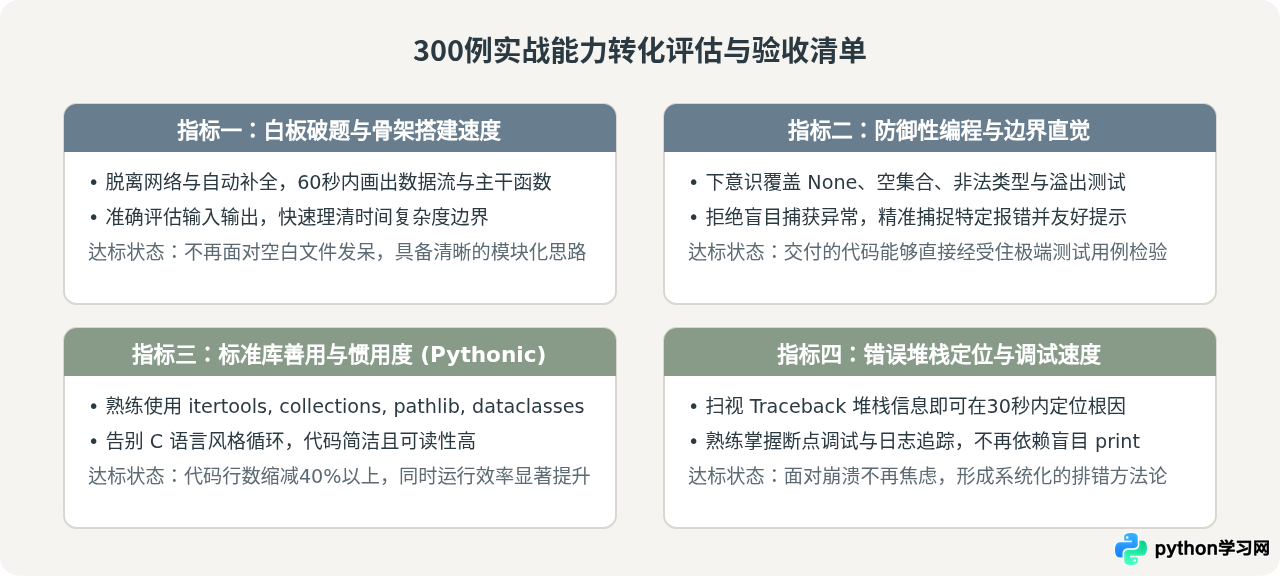
总结
《Python编程300例》不是用来“读完”的,而是用来“榨干”的。在练习过程中,宁可扎扎实实地重构好80个具有代表性的核心案例,也不要浮光掠影地把300个案例照抄一遍。按照“盲写初稿、对比题解、工程重构、场景变式”的闭环严格要求自己,每一行敲下的代码都会转化为实打实的架构设计、系统调试与独立开发能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















