


Python自学路线图:从环境搭建到独立开发
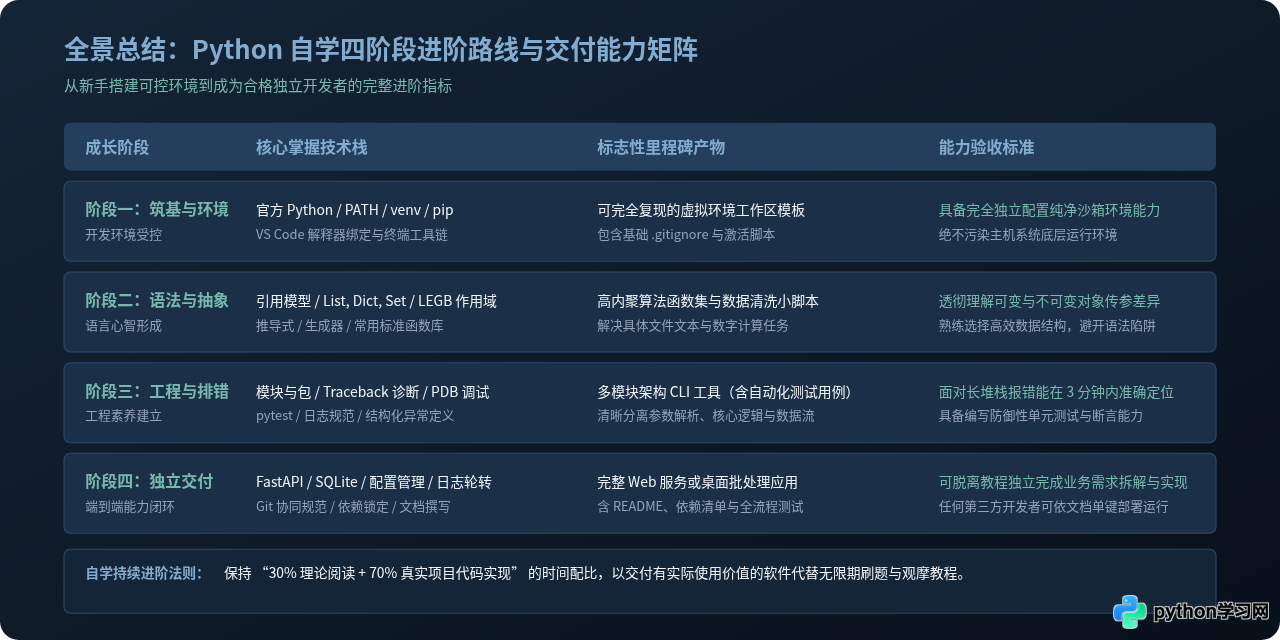
一份结构清晰、注重工程落地的Python自学路线图,从标准开发环境配置、核心语言运行模型、模块化与排错技巧,直至独立开发交付完整项目的四个阶段。
一个初学编程的开发者打开交互式在线教程,跟随指示输入代码,屏幕上很快输出了预期的结果。然而,当他关掉网页,在自己的本地电脑上尝试创建一个新文件并执行时,终端却连续报出 command not found、No module named ... 以及环境变量缺失的错误。这种在“教程环境顺利”与“本地独立开发受阻”之间的落差,是许多自学者停滞不前的常见节点。自学 Python 的核心不是死记几百个孤立的语法片段,而是建立一套稳固的开发工程心智:从可控的环境配置入手,理解代码在计算机中的运作原理,掌握排错闭环,最终有能力独立拆解并交付可运行的项目。
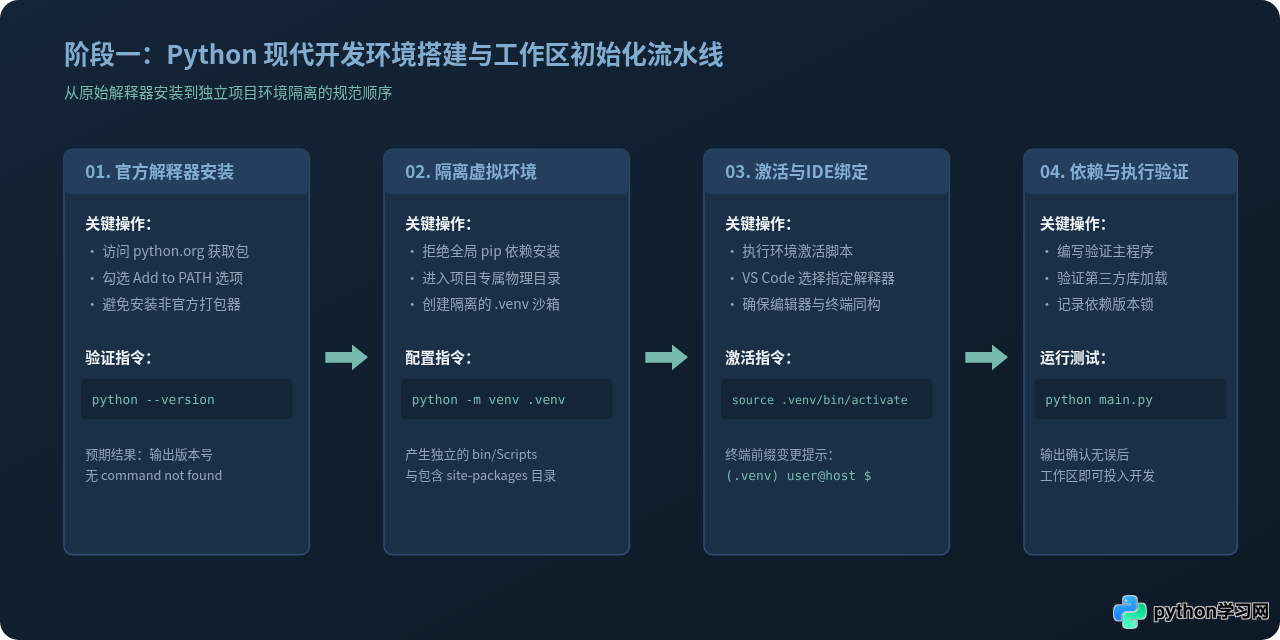
阶段一:标准开发环境搭建与工作区初始化
Python 解释器的安装是所有工程任务的基石。在不同操作系统中,随意下载安装往往会导致全局环境混乱,或者与系统自带的旧版本解释器发生冲突。正确的做法是使用官方发行版,并明确其在系统路径中的位置。
1. 解释器安装与环境变量确认
访问 Python 官方站点(python.org)获取最新的稳定版本。Windows 用户在安装引导的首个界面中,务必勾选 Add python.exe to PATH。此选项将 Python 可执行文件路径注入系统环境变量,使得命令行可以在任何目录下直接识别 python 命令。macOS 用户可以通过官方 PKG 安装包或成熟的包管理工具安装,并确认终端使用的是用户级 Python 而非系统保护目录下的旧版本。
安装完成后,打开全新终端窗口,输入以下命令核对安装结果:
python --version
pip --version
示例输出:
Python 3.12.2
pip 24.0 from .../site-packages/pip (python 3.12)
2. 建立虚拟环境隔离原则
许多初学者习惯直接执行 pip install package_name,将所有第三方库堆积在全局 Python 环境中。随着学习的深入,不同项目依赖的库版本产生冲突,很容易导致全局环境崩溃且难以恢复。因此,必须将“每个项目独立使用虚拟环境”作为第一原则。
在项目根目录中,利用内置模块 venv 创建一个轻量级隔离环境:
# 1. 创建项目目录并进入
mkdir demo_project
cd demo_project

# 2. 在当前目录下创建专属虚拟环境目录 .venv
python -m venv .venv

# 3. 激活虚拟环境
# Windows (PowerShell):
.venv\Scripts\Activate.ps1
# macOS / Linux (bash/zsh):
source .venv/bin/activate
激活成功后,命令行提示符前方会出现 (.venv) 前缀。此时再执行 pip install,所有安装的二进制与库文件都会严格限制在当前 .venv 文件夹内,彻底避免全局污染。
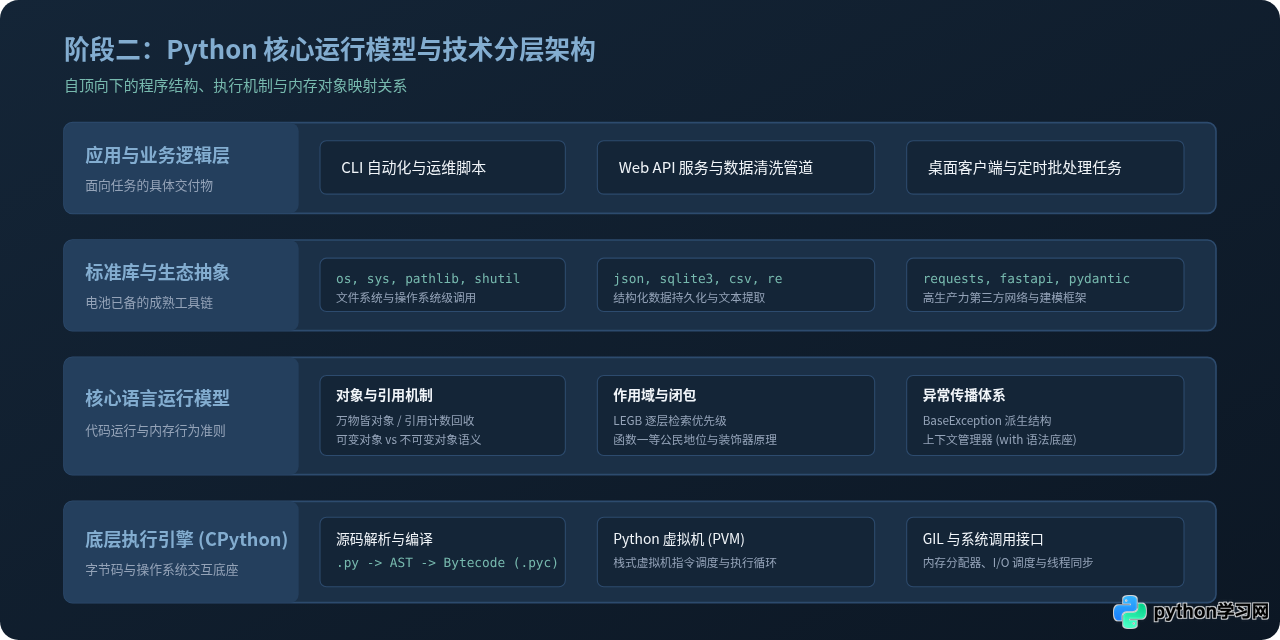
阶段二:核心语法演练与编程心智模型
掌握了环境之后,学习语法的目的不是记住词法规则,而是构建程序运行的心智模型。Python 的底层运行逻辑与其他静态语言存在显著差异,若不能准确理解以下核心概念,后续在面对复杂业务逻辑时极易产生难以定位的逻辑隐患。
1. 变量不是“盒子”,而是对象的“名字标签”
在 C 或 Java 中,变量通常被视作一块预先分配好内存类型的存储空间;而在 Python 中,一切数据皆为对象。赋值语句 a = [1, 2, 3] 的真实含义是在堆内存中分配了一个列表对象,并将名字 a 绑定(引用)至该对象。执行 b = a 时,并没有复制列表,而是让 b 同样指向该列表。
这种引用模型直接决定了可变对象(Mutable)与不可变对象(Immutable)的行为差异。例如列表、字典是可变对象,而整数、浮点数、字符串和元组是不可变对象。理解这一点能够直接避开“可变默认参数”这一高频陷阱:
# 错误示例:默认参数在函数定义时仅初始化一次
def append_item(item, target_list=[]):
    target_list.append(item)
    return target_list

# 预期外的结果:后续调用会共享同一列表对象
print(append_item(1))  # 输出 [1]
print(append_item(2))  # 输出 [1, 2],而非预期的 [2]

# 规范写法:使用 None 作为占位哨兵
def append_item_clean(item, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(item)
    return target_list
2. 四大基础数据结构的选用边界
高效的代码依赖于正确的数据结构。自学阶段需掌握以下四种结构的场景取舍:
- 列表(List):有序、动态数组结构。适合按序存储、频繁追加或根据索引读取;在列表首部插入或删除元素的复杂度为 O(n)。
- 元组(Tuple):有序、不可变序列。适合作为不可更改的常量记录,或作为字典的键使用。
- 字典(Dict):基于哈希表实现的键值对集合。查询、插入和删除的平均复杂度为 O(1)。在 Python 3.7+ 中保留插入顺序。
- 集合(Set):基于哈希表的唯一值集合。适合成员存在性判断(
item in collection)及集合运算(交、并、差集)。
3. 函数与作用域链(LEGB 规则)
Python 解释器在查找一个变量名时,遵循严格的层级顺序(LEGB):首先在当前函数内部查找(Local),未找到则向外层嵌套函数查找(Enclosing),再未找到则查找当前模块的全局作用域(Global),最后查找内置函数与常量(Built-in)。当在函数内对变量直接赋值时,Python 默认将其创建为局部变量。如果需要修改模块级全局变量,必须显式使用 global 关键字(但工程上应当尽量避免滥用全局状态)。
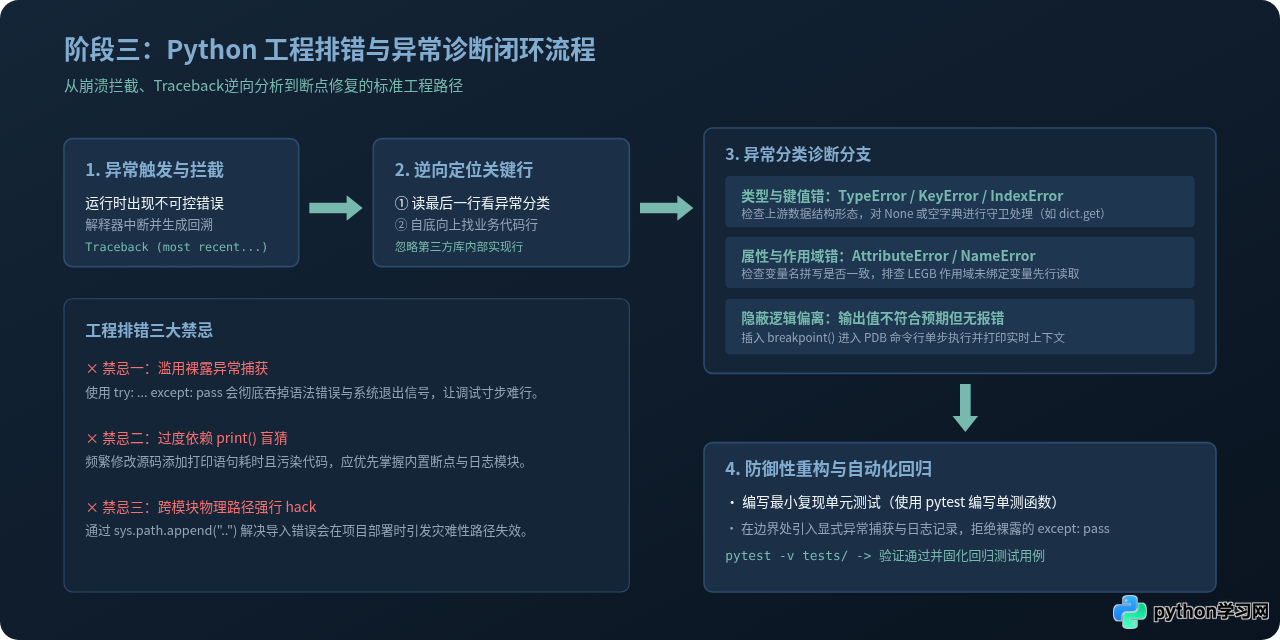
阶段三:模块化拆解、工程素养与排错闭环
写出单一脚本只是入门,而独立开发要求能够将数百行甚至上万行代码合理组织为可读、可测、可维护的工程结构。此阶段的核心任务是掌握模块系统的导入机制,并建立科学的错误诊断能力。
1. 模块(Module)与包(Package)的组织边界
单个 .py 文件即为一个模块,而包含 __init__.py(Python 3.3+ 也支持命名空间包,但显式包含初始化文件利于界定边界)的目录则构成一个包。初学者最常遇到的错误是 ModuleNotFoundError 或由于循环导入(Circular Import)导致的 ImportError。
避免导入混乱的核心法则是坚持自顶向下的绝对导入。假设项目根目录如下:
my_app/
├── .venv/
├── config/
│   ├── __init__.py
│   └── settings.py
├── services/
│   ├── __init__.py
│   └── parser.py
├── tests/
│   ├── __init__.py
│   └── test_parser.py
├── main.py
└── requirements.txt
在 main.py 中引入服务模块时,始终以项目根目录为基准引入:from services.parser import DataParser,而不是通过修改 sys.path 插入硬编码的物理路径。
2. 读懂回溯信息(Traceback)的正确顺序
程序崩溃并打印出一长串错误日志时,不要盲目去每一行代码中乱撞。标准的排错步骤是“先看底部,再看自身”:
- 第一步(看最后一行):确认异常的具体类型和说明文字(例如
KeyError: 'user_id'或TypeError: unsupported operand type(s))。这直接指明了发生冲突的具体操作。 - 第二步(自底向上扫描堆栈):找到倒数第一个属于你自己编写的代码文件和对应行号。很多时候错误发生在第三方库深处,但其根源往往是你向第三方库传入了非法参数或空值(None)。
- 第三步(设置断点现场):不要仅靠
print()盲目猜想,在可疑行前直接插入 Python 内置断点:
当执行到该行时,程序会暂停并进入交互式调试器(PDB)。在此处直接输入变量名查看实际运行态的值,输入# Python 3.7+ 原生支持 breakpoint()n执行下一行,输入c继续运行。
阶段四:从脚本编写到端到端独立开发
“独立开发”与“能够照抄教程”的本质区别,在于面对一个模糊的业务需求时,能否自主完成需求拆解、数据建模、外部依赖接入、健壮异常处理及依赖交付。为了跨越这一鸿沟,自学者应当按照递进难度完成三个代表性项目的完整开发:
1. 第一阶段目标:结构化命令行工具(CLI Tool)
实战课题:批量日志分析与报表提取工具。
技术要点:使用标准库 argparse 解析用户输入的命令行参数;使用 pathlib.Path 遍历文件树;使用正则表达式 re 提取 IP、请求状态码及耗时;使用上下文管理器 with open(...) 保证文件流自动关闭;最后输出汇总的统计表格。此项目能让你摆脱对静态变量的依赖,掌握程序与终端用户的交互界面。
2. 第二阶段目标:网络数据交互与轻量 API 服务
实战课题:定时信息监控与对外提供查询的微服务。
技术要点:使用 requests 或异步 httpx 定时抓取指定公开接口数据;使用第三方轻量框架 FastAPI 构建 RESTful 接口;结合 Pydantic 对传入与传出的数据进行严格的类型校验;采用轻量级内嵌数据库 sqlite3 完成本地数据持久化。此项目能让你理解现代互联网系统的数据流转机制。
3. 第三阶段目标:可分发的全功能业务应用
实战课题:个人自动化记账与资产分析工具。
技术要点:多模块结构组织;面向对象的业务实体抽象(如 Account, Transaction 类);配置与代码分离(采用 .env 或 config.toml 读取环境变量);通过 logging 模块分级记录运行日志;为核心计算逻辑编写 pytest 单元测试;最后生成结构干净的依赖锁定清单:
# 导出当前项目精确安装的依赖版本
pip freeze > requirements.txt独立开发检验标准:把你的代码仓库放到一台完全干净、没有预装任何第三方库的计算机上,仅凭你的 README.md 指引(克隆仓库、创建虚拟环境、执行 pip install -r requirements.txt、运行启动命令),其他人能否在一分钟内完整运行程序?如果能,说明你已经真正具备了独立交付软件的工程能力。
自学关键常见问题与避坑指南
在自学道路上,大部分消耗精力的问题并非高深的算法,而是环境配置与工具使用中的隐性细节。以下是针对典型问题的具体解决手段:
1. pip 安装第三方库时频繁网络超时或中断
原因:默认官方镜像源服务器位于海外,受网络波动影响容易发生握手失败。
解决方法:在虚拟环境中临时指定国内可靠镜像源下载,或者一次性配置为当前项目的全局镜像:
# 单次安装临时指定(以安装 requests 为例):
pip install requests -i https://pypi.tuna.tsinghua.edu.cn/simple

# 为当前虚拟环境永久配置镜像源:
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple
2. 计算机中存在多个 Python 版本时,命令调用混乱
原因:开发机上可能同时存在 Python 3.9 与 3.12,或者系统自带的工具链版本,直接在终端输入 python 无法确定究竟唤醒了哪一个。
解决方法:Windows 用户应优先使用系统自带的启动器命令 py -0 查看所有已登记版本,并通过 py -3.12 -m venv .venv 显式指定版本创建环境;macOS 与 Linux 用户则通过绝对命令(如 python3.12)调用。在创建并激活虚拟环境后,始终通过 python -m pip 代替孤立的 pip 命令,确保安装与调用的解释器绝对一致。
3. 如何摆脱“看教程都会,自己动手一片空白”的瓶颈?
根本原因:被动阅读和抄写代码建立的是短时视觉识别,缺乏“自顶向下拆解需求”的心智训练。
破解方法:停止无休止地通读教程。挑选一个与你当前工作或生活相关的微小需求(例如:将桌面下载文件夹中所有的截图自动归类到带日期的子目录)。在不打开任何教程代码的前提下,用中文写出 1、2、3 步的操作逻辑伪代码,遇到未知的函数时仅针对具体关键词(如“Python 移动文件”、“Python 获取文件修改时间”)查阅官方文档。当依靠自己的拆解跑通第一个 20 行的实用小工具时,你就已经迈出了独立开发最关键的一步。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















