


Python re.search函数用法详解:语法、返回值与Match对象
发布时间:2026-11-15 |
4人浏览过
深入解析 Python 正则模块中的 re.search 函数,涵盖基础语法、参数配置、返回值判断机制,以及 Match 对象的常用方法与分组提取技巧。
在 Python 正则表达式处理中,
re.search() 是检索子字符串最核心的函数之一。它的主要任务是在整个目标字符串中进行全面扫描,寻找第一个与正则表达式模式匹配的子串。若匹配成功,函数立即返回一个封装了匹配元数据的 re.Match 对象;若全串遍历完毕仍未找到匹配内容,则返回 None。本文将从语法参数、执行机制、返回值校验以及 Match 对象的高阶提取方法展开完整讲解。
一、re.search 基础语法与核心参数
在 Python 中调用 re.search 前需要导入内建的 re 模块。该函数的标准调用接口如下:
import re

re.search(pattern, string, flags=0)
该函数接收三个核心参数,各参数的作用与注意事项如下:
- pattern(匹配模式):可以是字符串形式的正则表达式,也可以是经由
re.compile()预编译生成的正则对象。编写模式串时,强烈建议使用原生字符串(加前缀r,如r"\d+"),避免 Python 转义字符与正则转义字符产生歧义。 - string(目标检索文本):待搜索的目标字符串。
re.search不限制匹配发生的起始位置,它会沿着文本从左向右持续扫描。 - flags(匹配标志位,可选):用于控制模式匹配的具体行为,默认为 0(无特殊标志)。常见的标志位包括忽略大小写的
re.IGNORECASE、支持点号跨行匹配的re.DOTALL等。
re.search 与 re.match 的本质区别
初学者极易混淆 re.search() 与 re.match()。二者的关键差异在于检索起点:
re.match()必须从字符串的第 0 个字符(起始位置)即刻开始匹配,若起始字符不匹配,直接判定失败返回None。re.search()则在全字符串范围内寻找匹配项,无论目标子串出现在开头、中间还是末尾,只要存在符合条件的子串,就能定位并返回第一个匹配。
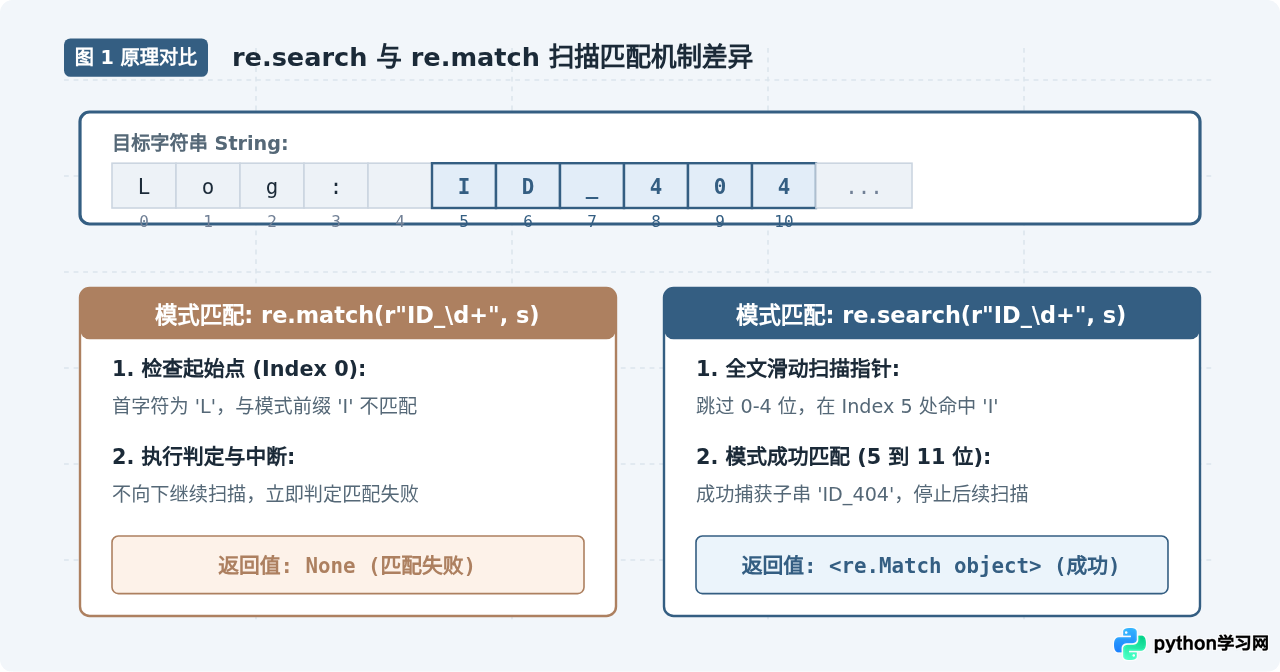
图 1:re.search 全文滑动检索与 re.match 仅首位匹配的扫描过程对比
二、返回值机制与 None 安全防御
理解 re.search() 的返回值是避免程序崩溃的关键。根据匹配结果,该函数只有两种可能的返回形态:
- 匹配成功:返回一个
re.Match实例对象,该对象保存了子串内容、边界索引和分组信息。 - 匹配失败:返回 Python 内置的单例对象
None。
高频报错警示:如果检索失败,
re.search 返回 None。此时若直接链式调用 .group(),例如 re.search(r"\d+", "abc").group(),Python 将抛出致命异常:AttributeError: 'NoneType' object has no attribute 'group'。
在编写业务代码时,必须使用分支条件或海象运算符(Python 3.8+)进行守卫式校验:
import re

text = "用户订单编号: ORD-20261019-889"
pattern = r"ORD-\d+-\d+"

# 方式一:传统 if 条件判断
match = re.search(pattern, text)
if match:
    print("匹配成功:", match.group())
else:
    print("未找到符合格式的订单号")

# 方式二:使用海象运算符 (:=) 简化赋值与判断
if m := re.search(r"ORD-(?P<date>\d{8})-(?P<seq>\d+)", text):
    print("订单日期:", m.group("date"))
    print("序列编号:", m.group("seq"))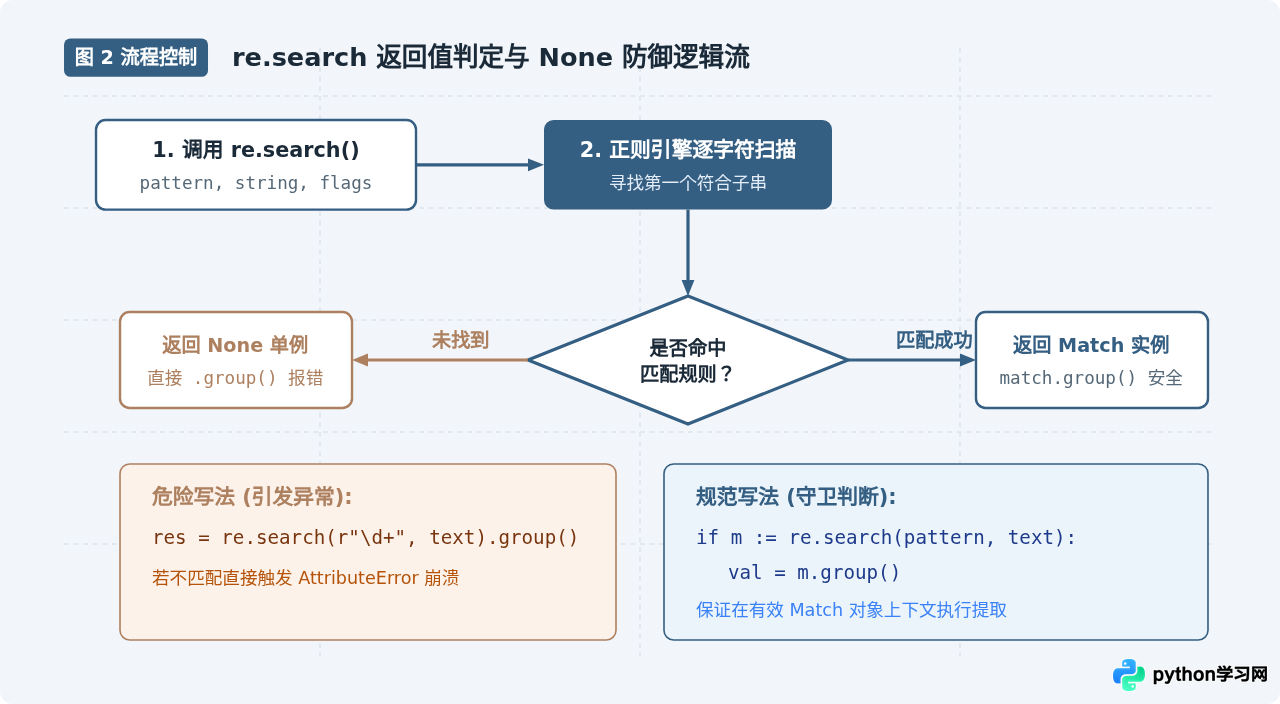
图 2:re.search 函数返回值分支与防御式代码执行流
三、Match 对象的属性与核心方法解析
当匹配成功时,返回的 re.Match 实例包含了丰富的匹配上下文数据。通过调用其内置方法和属性,可以精准提取文本、定位字符偏移量以及检查元信息。
1. 文本提取方法:group、groups 与 groupdict
group([group1, ...]):获取一个或多个子组匹配的字符串。默认参数为0,表示返回整个匹配的完整文本。若传入组索引(如1),则返回对应捕获组的内容。groups(default=None):以元组形式返回所有捕获组匹配的子串。对于未参与匹配的可选子组,默认填充None。groupdict(default=None):以字典形式返回所有命名捕获组的键值对,键为组名,值为匹配文本。
2. 偏移量定位方法:start、end 与 span
start([group]):返回指定捕获组在原始字符串中的起始索引(包含该位置)。end([group]):返回指定捕获组在原始字符串中的结束索引(不包含该位置,遵循 Python 左闭右开切片规范)。span([group]):等价于返回一个二元元组(start, end),可直接用于原字符串切片截取,即string[m.start():m.end()] == m.group()。
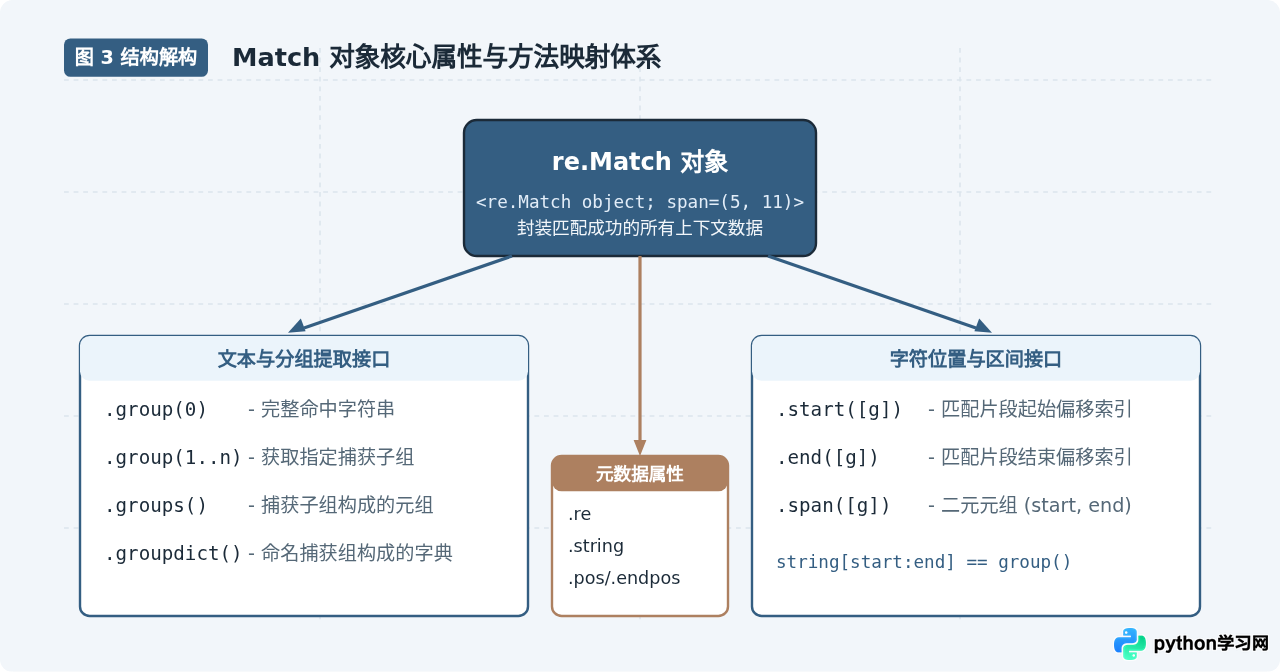
图 3:Match 对象的内部成员组织与常用提取方法映射体系
3. 综合演示示例
import re

raw_log = "2026-10-19 14:32:05 [WARN] Client 192.168.1.105:8080 request timeout"
pattern = r"(\d{1,3}(?:\.\d{1,3}){3}):(\d{2,5})"

match = re.search(pattern, raw_log)
if match:
    # 完整匹配与位置
    print("完整网络地址:", match.group(0))
    print("在原日志中位置区间:", match.span())

    # 子组提取
    ip_addr = match.group(1)
    port = match.group(2)
    print(f"IP: {ip_addr}, 端口: {port}")

    # 验证切片等价性
    start_pos, end_pos = match.span()
    assert raw_log[start_pos:end_pos] == match.group(0)
示例输出:
完整网络地址: 192.168.1.105:8080
在原日志中位置区间: (34, 52)
IP: 192.168.1.105, 端口: 8080
完整网络地址: 192.168.1.105:8080
在原日志中位置区间: (34, 52)
IP: 192.168.1.105, 端口: 8080
四、分组提取技巧:命名捕获组与字典化解析
在复杂的文本分析场景中,纯数字索引(如 match.group(1)、match.group(2))存在可读性差、模式修改后容易错位的问题。Python 正则支持使用命名捕获组(Named Groups),语法为 (?P<name>pattern)。
命名捕获组带来两个显著优势:
- 代码语义清晰:直接通过名称提取业务含义字段,例如
match.group("protocol")。 - 一键导出字典:通过
match.groupdict()直接将结构化数据转为标准 Python 字典,便于后续的数据处理和持久化存储。
import re

url = "https://sub.domain.com:8443/api/v1/users?id=102"
# 定义命名捕获模式
url_pattern = r"(?P<protocol>https?)://(?P<host>[^:/]+)(?::(?P<port>\d+))?(?P<path>/[^?]*)"

if m := re.search(url_pattern, url):
    # 1. 命名方式单独读取
    print("协议:", m.group("protocol"))
    print("主机:", m.group("host"))
    print("端口:", m.group("port"))
    print("路径:", m.group("path"))

    # 2. 导出完整字典
    url_data = m.groupdict()
    print("结构化字典输出:", url_data)
示例输出:
协议: https
主机: sub.domain.com
端口: 8443
路径: /api/v1/users
结构化字典输出: {'protocol': 'https', 'host': 'sub.domain.com', 'port': '8443', 'path': '/api/v1/users'}
协议: https
主机: sub.domain.com
端口: 8443
路径: /api/v1/users
结构化字典输出: {'protocol': 'https', 'host': 'sub.domain.com', 'port': '8443', 'path': '/api/v1/users'}
五、匹配标志位(Flags)详解与组合规则
flags 参数可以显著改变正则表达式的匹配逻辑。多个标志位可以通过按位或操作符(|)进行组合使用,例如 flags=re.IGNORECASE | re.MULTILINE。
| 标志常量 | 简写 | 核心作用 | 适用场景 |
|---|---|---|---|
re.IGNORECASE |
re.I |
忽略字母大小写差异进行匹配 | 匹配 HTTP Header、协议名称、文件扩展名等不区分大小写的字段 |
re.MULTILINE |
re.M |
改变 ^ 和 $ 的行为,使其匹配每行的开头和结尾,而非仅整串首尾 |
多行日志分析、逐行提取以特定标记开头的配置项 |
re.DOTALL |
re.S |
使元字符点号 . 能够匹配包括换行符 \n 在内的任意字符 |
跨多行的 HTML 标签内容提取、多行异常堆栈分析 |
re.VERBOSE |
re.X |
允许在模式串中添加空格、换行和以 # 开头的注释,提升可维护性 |
编写复杂的大型业务正则规则 |
import re

# 跨行文本匹配与忽略大小写
html_doc = """
<DIV class="content">
    Title: Python Guide
    Status: Released
</div>
"""

# 同时启用 re.I (忽略div大小写) 和 re.S (点号匹配跨行文本)
pattern = r"<div[^>]*>(?P<body>.*?)</div>"
if m := re.search(pattern, html_doc, flags=re.IGNORECASE | re.DOTALL):
    print("提取出的内部文本:")
    print(m.group("body").strip())
六、全流程总结与工程最佳实践
在工程项目中运用 re.search() 时,建议遵循以下最佳实践:
- 高频循环下优先预编译:如果在一个循环或高频调用的函数中反复使用相同的正则,应先调用
compiled = re.compile(pattern),然后使用compiled.search(text),避免每次执行时重复进行模式解析与编译。 - 谨防非预期贪婪匹配:默认情况下量词(如
*,+)是贪婪的,尽可能向后吞噬字符。如果需要提取封闭区间内容,请使用非贪婪模式(如.*?)。 - 永远不要省略 None 守卫检查:在生产环境中,网络数据或用户输入极易出现偏离预期格式的情况,省略 None 判断是导致后端脚本意外终止的高发根因。
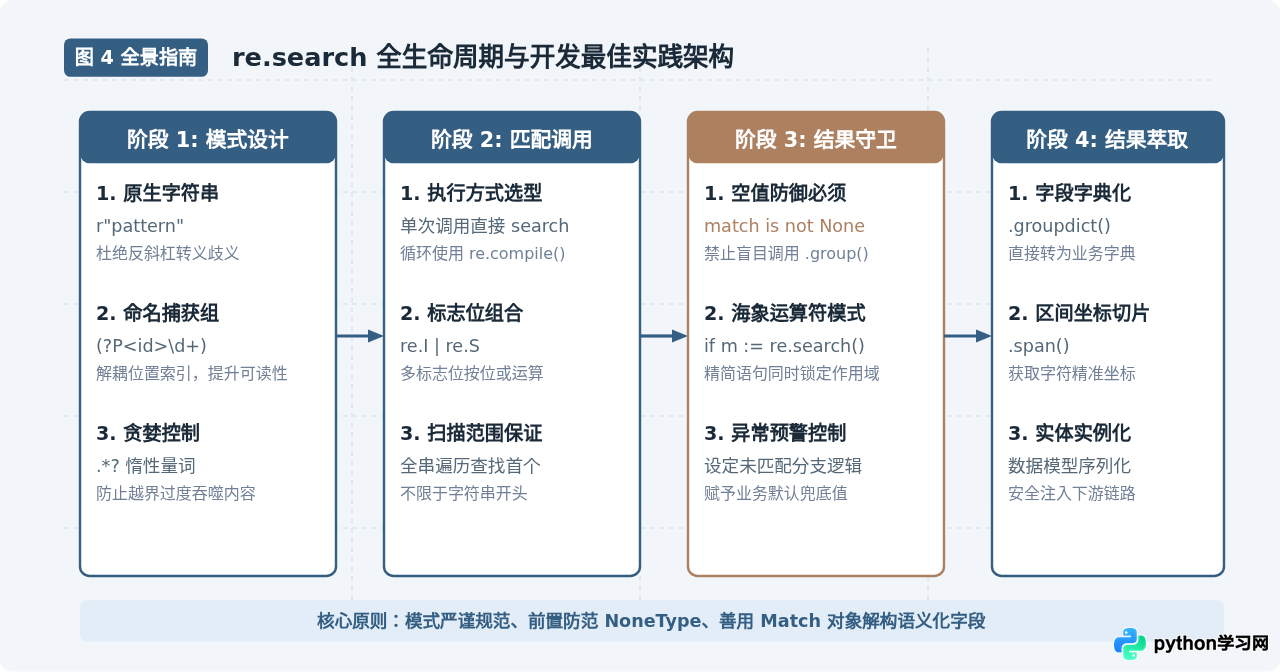
图 4:re.search 函数从模式定义到数据消费的全生命周期工程实践体系
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















