


Python threading模块基础:创建与启动线程的代码示例
深入浅出讲解Python标准库threading模块的基础用法,包括通过target函数与继承Thread类创建并启动线程的完整代码示例、参数传递、生命周期控制及核心注意事项。
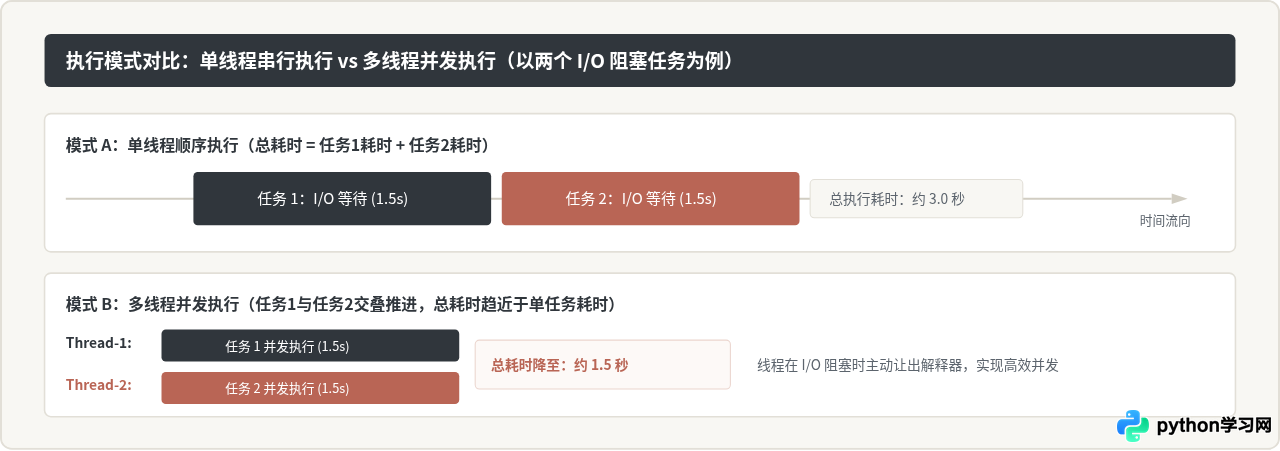
在 Python 应用程序中,当程序需要并发处理多个 I/O 密集型任务(如并发下载网络接口数据、读写多个外部文件或监听网络端口)时,标准库中的 threading 模块是最直接、最轻量的并发工具。本文将围绕该模块的创建与启动机制展开,直接提供两种标准的创建方式、完整的传参示范、线程生命周期同步方法以及常见避坑要点。
一、核心机制:创建与启动线程的标准步骤
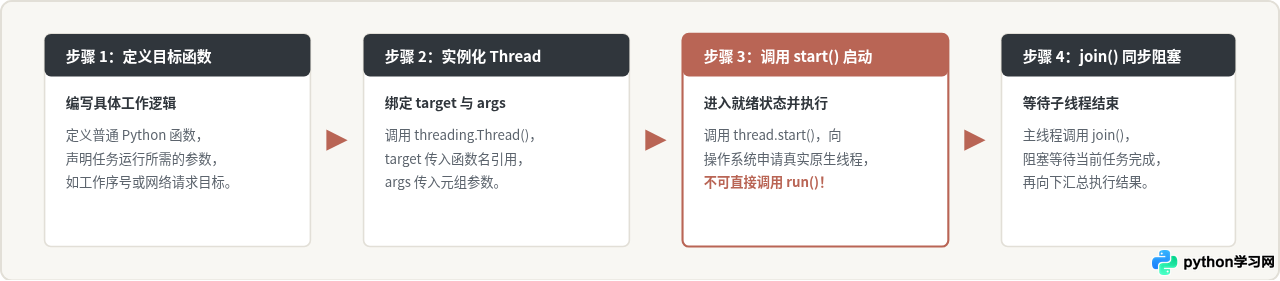
在 Python 中,通过 threading 模块创建和启动新线程主要有四步标准操作:编写任务函数、组装 Thread 对象、调用 start() 方法移交系统调度、视需要调用 join() 等待同步结果。
二、方式一:通过 target 参数传递目标函数(推荐做法)
这是最常见、最简洁的创建方式。使用 threading.Thread 构造器,并将需要异步执行的函数名赋给 target 参数。如果函数需要接收参数,分别使用 args(位置参数元组)和 kwargs(关键字参数字典)传入。
1. 完整代码示例
import threading
import time

def worker(task_name, duration, repeat=1):
    """
    工作任务函数
    :param task_name: 任务名称(通过 args 传递)
    :param duration: 模拟执行耗时(通过 args 传递)
    :param repeat: 重复打印次数(通过 kwargs 传递)
    """
    print(f"[{threading.current_thread().name}] 开始执行: {task_name}")
    for i in range(repeat):
        time.sleep(duration)
        print(f"[{threading.current_thread().name}] {task_name} 运行中 (轮次 {i + 1}/{repeat})")
    print(f"[{threading.current_thread().name}] 完成: {task_name}")

if __name__ == "__main__":
    print(f"[{threading.current_thread().name}] 主线程开始创建子线程")

    # 创建线程 1:仅使用 args 传递位置参数(注意单个元素元组必须带逗号)
    t1 = threading.Thread(
        target=worker,
        name="WorkerThread-A",
        args=("下载图片任务", 1.0)
    )

    # 创建线程 2:同时使用 args 和 kwargs 传参
    t2 = threading.Thread(
        target=worker,
        name="WorkerThread-B",
        args=("请求API数据", 0.6),
        kwargs={"repeat": 2}
    )

    # 启动线程:将线程置入就绪队列,由操作系统调度运行
    t1.start()
    t2.start()

    # join() 会让主线程停在原地,直到对应子线程执行完毕
    t1.join()
    t2.join()

print(f"[{threading.current_thread().name}] 所有子线程执行完毕,主线程安全退出")[WorkerThread-A] 开始执行: 下载图片任务
[WorkerThread-B] 开始执行: 请求API数据
[WorkerThread-B] 请求API数据 运行中 (轮次 1/2)
[WorkerThread-A] 下载图片任务 运行中 (轮次 1/1)
[WorkerThread-A] 完成: 下载图片任务
[WorkerThread-B] 请求API数据 运行中 (轮次 2/2)
[WorkerThread-B] 完成: 请求API数据
[MainThread] 所有子线程执行完毕,主线程安全退出
参数传递常见陷阱: 当 args 仅包含一个参数时,必须写成元组形式 args=("任务名称",)(包含末尾逗号)。若误写为 args=("任务名称"),Python 会将字符串解包为单个字符分别传给函数的各个形参,从而导致 TypeError。
三、方式二:继承 threading.Thread 类并重写 run() 方法
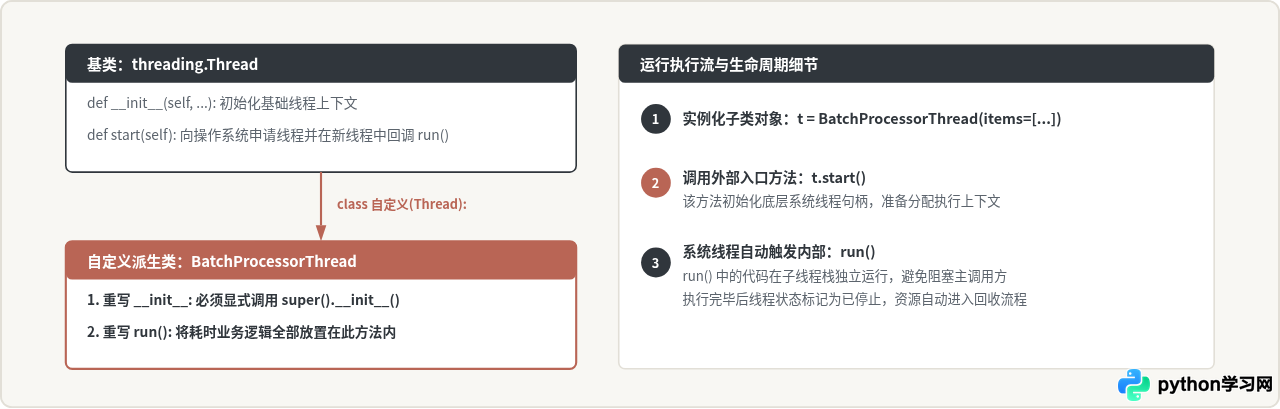
当工作任务需要维护复杂的内部状态、持有独立的数据库连接句柄或网络会话,或者需要面向对象组织代码时,继承 threading.Thread 是一种更清晰的结构化方式。
1. 完整代码示例
import threading
import time

class FileDownloadThread(threading.Thread):
    def __init__(self, filename, filesize_mb):
        # 必须显式初始化父类构造器,确保内部线程控制标识正确建立
        super().__init__()
        self.filename = filename
        self.filesize_mb = filesize_mb
        self.downloaded = 0

    def run(self):
        """线程启动后在独立执行流中执行的具体逻辑"""
        print(f"[{self.name}] 开始下载文件: {self.filename} ({self.filesize_mb}MB)")
        while self.downloaded < self.filesize_mb:
            time.sleep(0.3)
            self.downloaded += 20
            progress = min(100, int((self.downloaded / self.filesize_mb) * 100))
            print(f"[{self.name}] {self.filename} 进度: {progress}%")
        print(f"[{self.name}] 文件 {self.filename} 下载完毕!")

if __name__ == "__main__":
    t_file1 = FileDownloadThread("dataset_part1.zip", 40)
    t_file2 = FileDownloadThread("dataset_part2.zip", 60)

    # 启动两个自定义线程实例
    t_file1.start()
    t_file2.start()

    # 等待执行完成
    t_file1.join()
    t_file2.join()

print("两个文件均已下载完成。")[Thread-2] 开始下载文件: dataset_part2.zip (60MB)
[Thread-1] dataset_part1.zip 进度: 50%
[Thread-2] dataset_part2.zip 进度: 33%
[Thread-1] dataset_part1.zip 进度: 100%
[Thread-1] 文件 dataset_part1.zip 下载完毕!
[Thread-2] dataset_part2.zip 进度: 66%
[Thread-2] dataset_part2.zip 进度: 100%
[Thread-2] 文件 dataset_part2.zip 下载完毕!
两个文件均已下载完成。
四、核心注意事项:start() 与 run() 的关键区别
初学者极易犯的一个错误是直接调用 thread.run() 而非 thread.start()。这两个调用的行为截然不同:
- 调用 start(): 会向操作系统注册并分配独立的系统原生线程,分配独立的调用栈,并在新线程中异步回调
run()方法。主线程不会发生阻塞,继续向下执行。 - 直接调用 run(): 仅仅是在当前调用者所在线程(通常是主线程)中以同步方式执行了一次普通的类方法或函数调用。不会创建任何新线程,整个程序依然是单线程串行执行,完全丧失并发效果。
五、线程生命周期控制:join() 与 daemon
在创建线程后,还需要根据业务场景决定主线程如何与子线程协作:
- join([timeout]): 阻塞当前执行流,等待目标线程终止。如果在主线程中不调用
join(),主线程会直接向下执行后续逻辑。对于需要汇总各个子线程执行结果的场景,join()是必不可少的同步手段。 - daemon(守护线程): 通过在调用
start()之前设置thread.daemon = True(或在构造器中传入daemon=True),将该线程标记为守护线程。守护线程的特点是:当所有非守护线程(如主线程)结束时,无论守护线程是否还在执行,程序都会强行退出并将守护线程就地终止。这适用于周期性健康心跳、后台缓存清理等随主进程结束而废弃的任务。
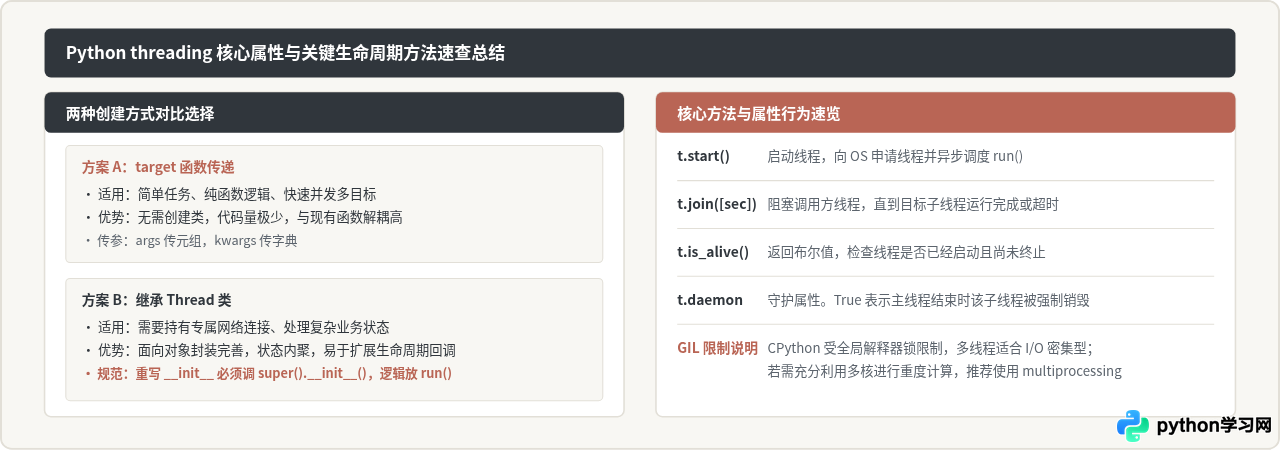
六、总结与选型建议
掌握 Python threading 模块的基础是编写高响应度 Python 程序的重要技能:
- 对于绝大多数日常场景,优先采用
threading.Thread(target=func, args=(...))方式,代码直观且侵入性最小。 - 当需要维护复杂的工作上下文、重载行为状态时,采用面向对象的子类继承方式,并在
__init__中规范执行super().__init__()。 - 牢记始终调用
start()启动多线程,避免调用run()导致假并发;通过合理搭配join()与daemon确保进程退出时的资源安全。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















