


Python修饰器有什么用:日志记录与性能计时示例
深入解析Python修饰器的作用与运行机制,通过日志记录与性能计时两大经典示例,展示如何在不修改业务代码的前提下优雅扩展函数功能。
在日常 Python 开发中,修饰器(Decorator)的核心作用是在不修改原有函数源代码且不改变函数调用方式的前提下,为目标函数动态注入额外功能。它主要用于解耦那些横跨多个模块的辅助需求(即横切关注点),例如系统调用日志、执行耗时监控、鉴权校验以及结果缓存等。
一、为什么要用修饰器:侵入式代码与解耦设计
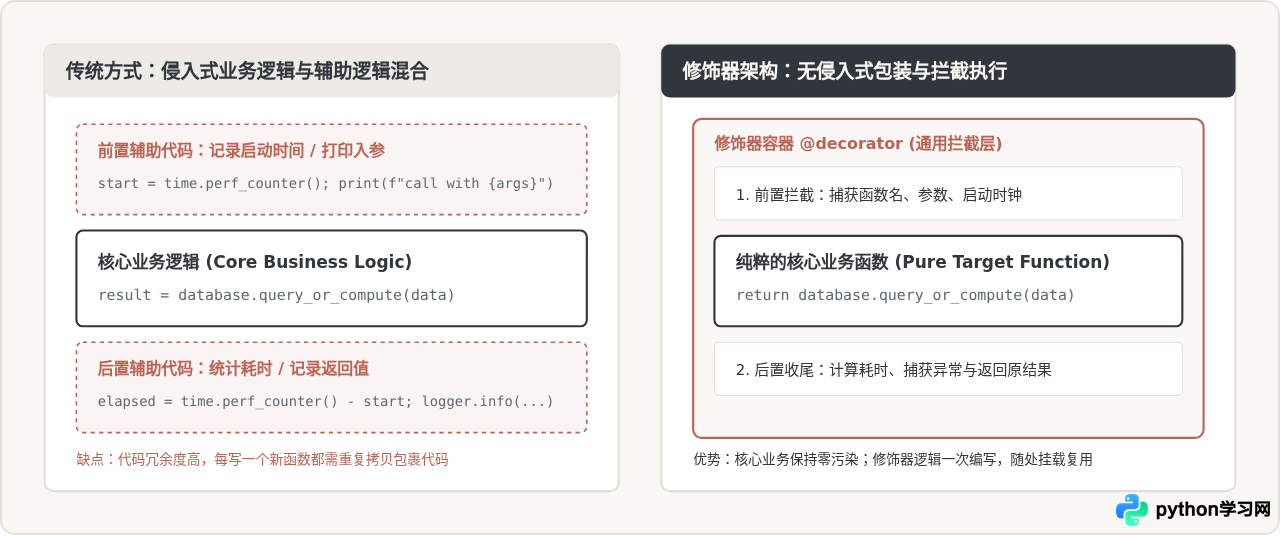
若没有修饰器,当我们需要统计某个核心接口的执行时间或打印调用入参时,最直接的做法是在函数内部首尾两端手动插入时间戳和打印语句。然而,当工程中有数十甚至上百个业务函数都需要这类辅助功能时,手动添加会带来严重的维护问题:
- 业务逻辑污染:核心代码夹杂大量与业务无关的监控打点,降低了可读性与可维护性。
- 重复代码蔓延:相同的计时与日志模板在每个函数中机械复制,一旦格式需要调整,必须逐一修改所有函数。
- 修改成本高昂:针对第三方库提供的函数或不可直接编辑的代码段,无法直接在源码内增加逻辑。
修饰器通过 Python 的“函数即一等公民”和闭包特性,以非侵入式的包装机制完美化解了这一矛盾。下图清晰展示了传统侵入式方案与修饰器架构的差异:
二、修饰器的运行原理:从闭包到语法糖
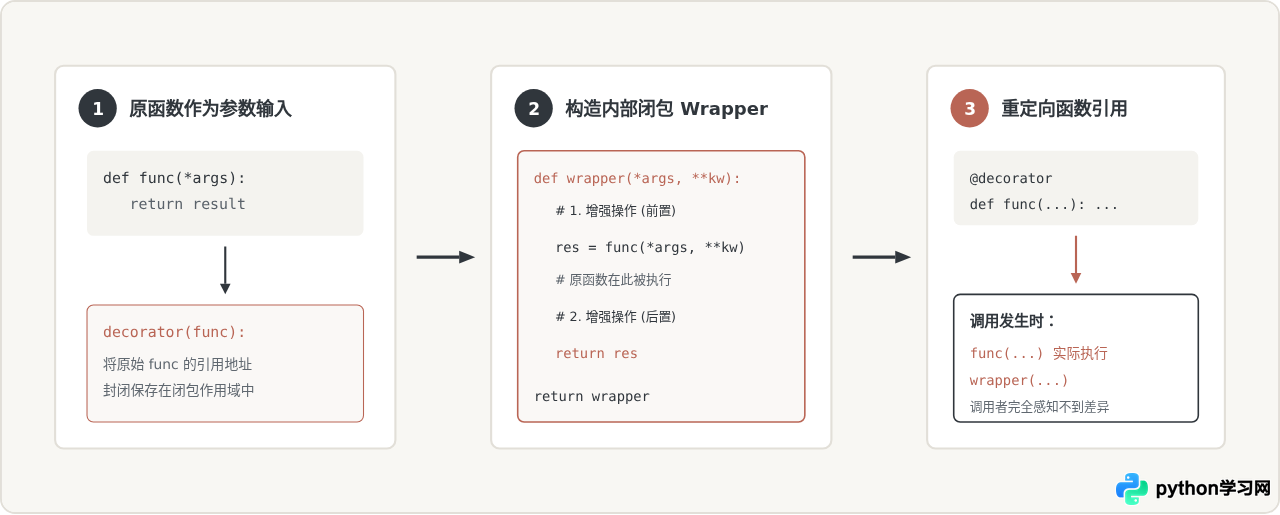
修饰器在本质上是一个接收函数作为输入、并返回一个增强后新函数的高阶函数。为了让理解更扎实,我们需要明确 Python 语法糖 @ 的本质推导过程。
假设我们编写了一个名为 my_decorator 的修饰器和一个名为 calculate_sum 的目标函数:
@my_decorator
def calculate_sum(a, b):
    return a + b
这段代码在 Python 解释器载入模块时,等价于执行了以下变量重新绑定操作:
def calculate_sum(a, b):
    return a + b

# 语法糖 @my_decorator 的实际等价展开:
calculate_sum = my_decorator(calculate_sum)
此时,原有的符号 calculate_sum 不再指向原始函数对象,而是指向了 my_decorator 内部构建并返回的闭包函数(通常命名为 wrapper)。当后续代码调用 calculate_sum(10, 20) 时,实际上执行的是 wrapper(10, 20),而 wrapper 内部再负责调用最初的原始函数。
三、示例一:实现自动化日志记录修饰器
在后端服务或数据处理管道中,记录关键函数的执行痕迹是排查线上问题的基础。我们通过修饰器实现一个通用的 @log_execution,自动捕获函数名称、传入的位置参数与关键字参数,并在函数正常结束时输出返回值,若发生异常则打印异常细节。
1. 完整代码实现
import functools
import logging

# 配置标准日志输出格式
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S"
)
logger = logging.getLogger("AppAudit")

def log_execution(func):
    """
    通用函数日志记录修饰器
    自动打印函数调用参数、返回值及运行中捕获的异常
    """
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        # 格式化入参信息
        args_repr = [repr(a) for a in args]
        kwargs_repr = [f"{k}={v!r}" for k, v in kwargs.items()]
        signature = ", ".join(args_repr + kwargs_repr)

        logger.info(f">>> 开始执行函数: {func.__name__}({signature})")
        try:
            result = func(*args, **kwargs)
            logger.info(f"<<< 函数 {func.__name__} 执行成功,返回结果: {result!r}")
            return result
        except Exception as err:
            logger.error(f"!!! 函数 {func.__name__} 执行抛出异常: {err}", exc_info=False)
            raise  # 重新抛出异常,保持原业务调用方对错误的感知
    return wrapper
2. 测试应用与结果验证
将该修饰器挂载到两个具体的业务计算函数上进行测试:
@log_execution
def create_user_profile(user_id, username, is_admin=False):
    return {"id": user_id, "name": username, "role": "admin" if is_admin else "user"}

@log_execution
def divide_operation(dividend, divisor):
    return dividend / divisor

if __name__ == "__main__":
    # 正常调用测试
    profile = create_user_profile(1001, "Alice", is_admin=True)

    # 异常捕获测试
    try:
        divide_operation(10, 0)
    except ZeroDivisionError:
        pass
执行上述测试代码后,控制台输出示例为:
2026-10-19 18:50:12 [INFO] >>> 开始执行函数: create_user_profile(1001, 'Alice', is_admin=True)
2026-10-19 18:50:12 [INFO] <<< 函数 create_user_profile 执行成功,返回结果: {'id': 1001, 'name': 'Alice', 'role': 'admin'}
2026-10-19 18:50:12 [INFO] >>> 开始执行函数: divide_operation(10, 0)
2026-10-19 18:50:12 [ERROR] !!! 函数 divide_operation 执行抛出异常: division by zero
通过这个示例可以看到,业务函数内部只专注于具体计算或数据组装,完全无需编写任何一行 logger.info。日志的采集与异常标记全部由外层修饰器统一代理。
四、示例二:实现高精度性能计时修饰器
在算法优化、数据库查询或批量接口调用场景下,评估函数的实际耗时是性能优化的第一步。利用修饰器,我们可以实现一个毫秒级精度的性能耗时分析器 @time_tracker。
注意:在 Python 中测量耗时应优先选择 time.perf_counter() 而非 time.time()。perf_counter 是具有最高可用分辨率的单调递增时钟,不受系统时钟回拨或手动调整影响,专门用于测量程序执行间隔。
1. 完整代码实现
import time
import functools

def time_tracker(threshold_ms=None):
    """
    可配置超时预警的性能计时修饰器
    :param threshold_ms: 可选耗时阈值(毫秒),超过该值输出醒目告警
    """
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            start_time = time.perf_counter()
            try:
                return func(*args, **kwargs)
            finally:
                # 无论函数是否正常返回还是抛出异常,finally 确保耗时统计必被执行
                elapsed_seconds = time.perf_counter() - start_time
                elapsed_ms = elapsed_seconds * 1000.0

                log_msg = f"[性能监控] 函数 {func.__name__} 耗时: {elapsed_ms:.2f} ms"
                if threshold_ms and elapsed_ms > threshold_ms:
                    print(f"\033[91m{log_msg} (超过告警阈值 {threshold_ms} ms!)\033[0m")
                else:
                    print(log_msg)
        return wrapper
    return decorator
2. 性能计时测试示例
# 示例 1: 使用默认统计
@time_tracker()
def heavy_matrix_calculation(n):
    total = 0
    for i in range(n):
        total += i * i
    return total

# 示例 2: 设定 50ms 告警阈值
@time_tracker(threshold_ms=50.0)
def simulated_slow_io():
    time.sleep(0.08)  # 模拟耗时 80ms 的外部 I/O
    return "OK"

if __name__ == "__main__":
    heavy_matrix_calculation(1_000_000)
    simulated_slow_io()
输出示例:
[性能监控] 函数 heavy_matrix_calculation 耗时: 38.45 ms
[性能监控] 函数 simulated_slow_io 耗时: 80.82 ms (超过告警阈值 50.0 ms!)
五、组合修饰器:多层拦截与执行时序
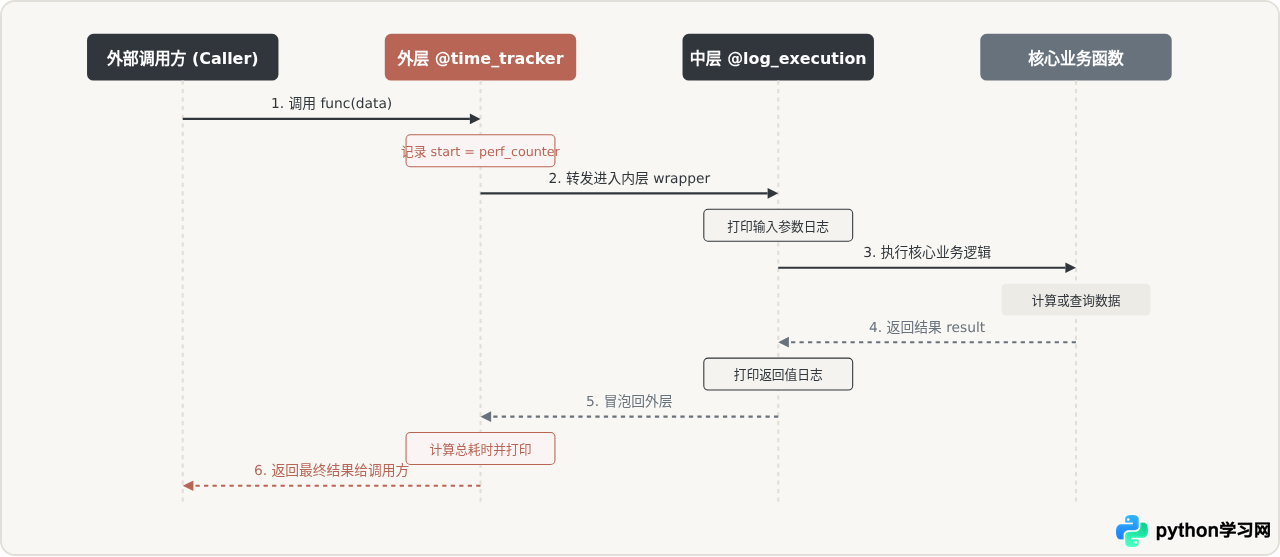
在实际生产环境中,同一个业务函数往往需要同时附加多个修饰器。例如,我们既希望统计函数的耗时,又希望打印详细的日志。
@time_tracker()
@log_execution
def process_data_pipeline(data_batch):
    # 模拟数据处理逻辑
return [item.upper() for item in data_batch]理解多修饰器堆叠的关键在于区分装配顺序与实际执行顺序:
- 装配顺序(从下至上):先将
process_data_pipeline传入@log_execution包装为日志包装器;再将日志包装器传入@time_tracker()包装为计时包装器。即等价于process_data_pipeline = time_tracker()(log_execution(process_data_pipeline))。 - 执行顺序(由外向内,再由内向外):当外部发起调用时,首先进入最外层的
time_tracker(记录开始时刻);紧接着进入中间层的log_execution(输出启动日志);然后调用真正的业务函数;业务函数返回后,log_execution捕获返回值并打印结束日志;最后time_tracker计算总耗时并打印。
六、关键注意事项与避坑指南
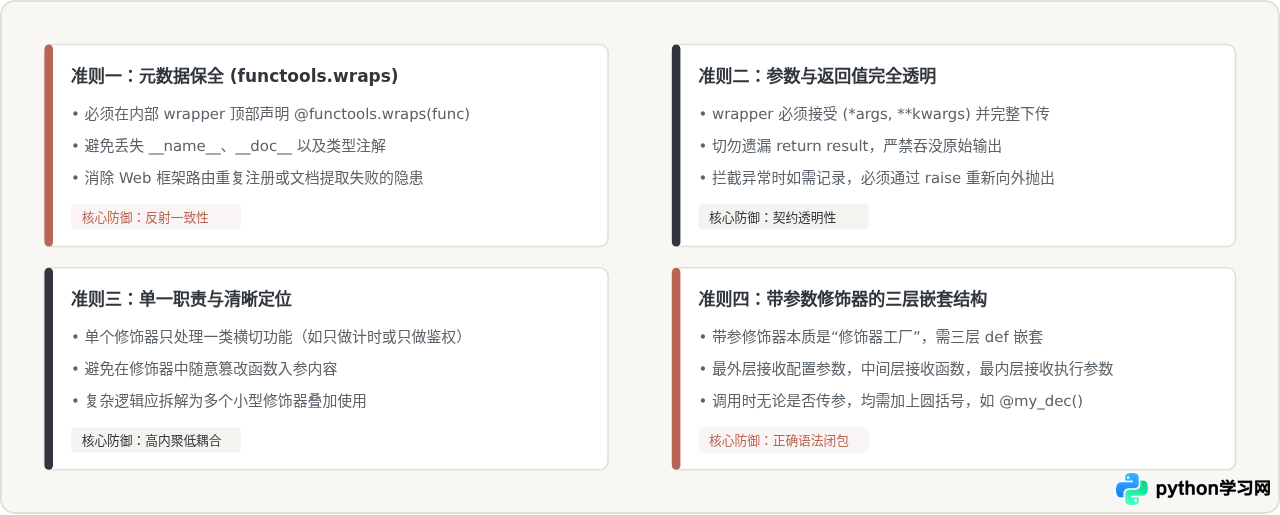
编写与使用修饰器时,若忽略底层机制,容易引发难以察觉的隐蔽 Bug。以下是必须遵循的开发准则:
1. 强制使用 @functools.wraps 保留元数据
当一个函数被 wrapper 替换后,其内部属性(如 __name__、__doc__、类型注解 __annotations__)也会默认被 wrapper 覆盖。这会导致依赖反射机制的框架(如 Flask 路由注册、FastAPI 依赖注入或自动化文档生成器 Sphinx)失效或报错。
# 错误写法:未保护元信息
def bad_decorator(func):
    def wrapper(*args, **kwargs):
        return func(*args, **kwargs)
    return wrapper

@bad_decorator
def calculate():
    """这是核心计算函数"""
    pass

print(calculate.__name__)  # 输出: "wrapper" (原始名字丢失!)
print(calculate.__doc__)   # 输出: None (文档丢失!)
通过在 wrapper 上声明 @functools.wraps(func),标准库会自动将原始函数的名称、文档以及签名全部复制给 wrapper,确保外部反射工具识别无误。
2. 务必完整透传参数与返回值
- 入参通用性:内部包装函数必须声明为
def wrapper(*args, **kwargs),并在调用原始函数时完整传递func(*args, **kwargs),确保适应不同参数签名的所有函数。 - 严禁遗漏
return:很多初学者在包装函数最后一行忘记写return result,导致调用方始终拿到None。
七、总结
Python 修饰器通过高阶函数与闭包机制,提供了一种优雅的结构扩展能力。在日志记录与性能计时的场景中:
- 日志修饰器(
@log_execution):实现了输入参数、执行状态与返回结果的自动化审计,将诊断逻辑从具体业务中彻底剥离; - 性能修饰器(
@time_tracker):利用time.perf_counter()提供了高精度单调时钟度量,为瓶颈定位与超时告警建立了标准化模板; - 工程落地保障:始终配合
@functools.wraps维护反射信息,以*args, **kwargs保持调用契约透明,并按需通过多层修饰器完成功能堆叠。
掌握修饰器的这套解耦范式,不仅能写出干净、整洁的业务代码,也是深入理解 Python 框架核心底层机制的关键基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















