


Python多个装饰器叠加时的执行顺序是怎么的
深入解析Python多个装饰器叠加时的执行顺序。全面阐明定义期装配自下而上、运行期调用由外向内像洋葱剥离的运作机制,结合带参数工厂求值对比及工程实战避坑指南,彻底讲透执行时序。
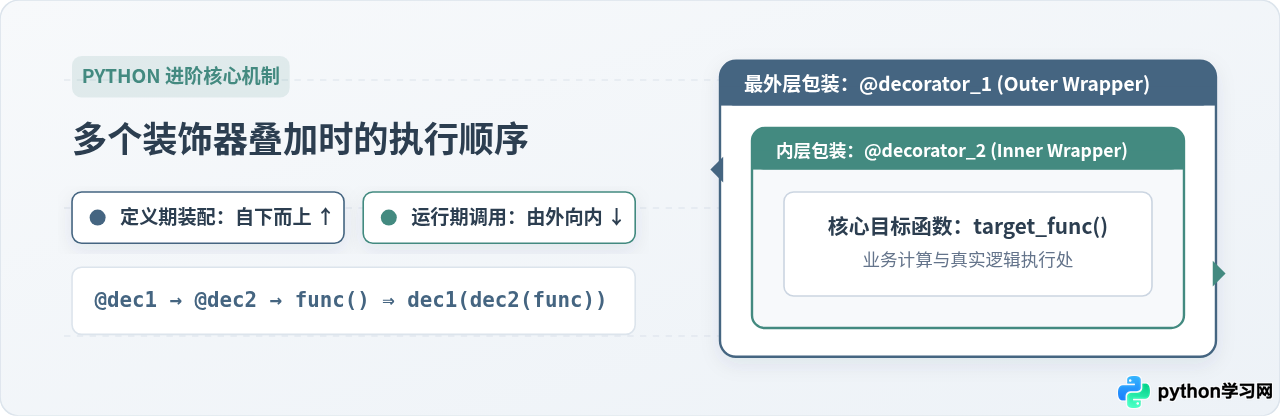
在 Python 开发中,当一个函数上方同时堆叠了两个或更多装饰器时,其执行顺序常常引起困惑。核心结论非常明确:装饰器的执行顺序必须严格区分“定义阶段(函数装配时)”和“运行阶段(函数被调用时)”。在模块被解释执行、函数刚完成定义的时刻,装饰器是自下而上(由近及远、由内向外)依次装配包装的;而当程序在运行时实际调用该函数时,装饰器内部的逻辑则呈现经典的洋葱圈模型:外部装饰器的前置代码先执行,层层向内穿透到核心函数,核心函数执行返回后,再由最内层向最外层依次执行后置逻辑。如果装饰器本身带有参数(即装饰器工厂),求值过程还会有一层额外的自上而下的表达式计算。
一、语法糖展开:为什么定义期是“自下而上”?
要彻底理解执行顺序,首先必须看清 Python 的 @ 语法糖在解释器内部是如何展开的。装饰器的本质是一个接收函数作为输入、并返回一个新可调用对象的普通函数。
假设我们编写了如下代码,在目标函数 calculate 上依次放置 @decorator_a 和 @decorator_b:
@decorator_a
@decorator_b
def calculate(x):
    return x * 2
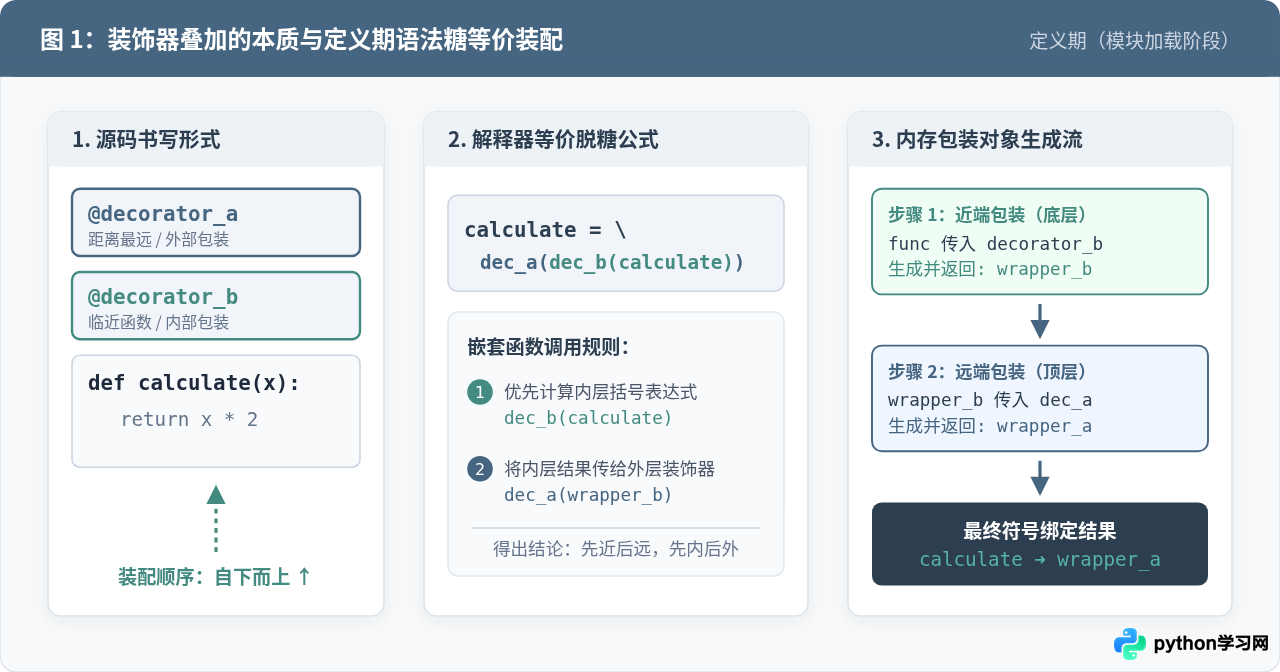
在 Python 编译与解释该模块时,上述代码会被严格转换为等价的嵌套赋值语句:
# 解释器在函数定义时的真实脱糖过程
def calculate(x):
    return x * 2

calculate = decorator_a(decorator_b(calculate))
请观察 decorator_a(decorator_b(calculate)) 这个嵌套函数调用表达式。根据数学函数嵌套与绝大多数编程语言的求值规则,解释器必须先计算最内层括号中的参数,才能把计算结果作为输入传递给外层函数:
- 内层调用(优先执行):解释器先执行
decorator_b(calculate)。此时decorator_b接收原始的calculate函数作为入参,完成第一层封装,返回包装函数wrapper_b。 - 外层调用(后续执行):解释器接着执行
decorator_a(wrapper_b)。此时decorator_a接收的不再是原生函数,而是刚才由decorator_b包装生成的wrapper_b。decorator_a完成第二层封装,返回wrapper_a。 - 符号最终重绑定:最终,全局变量名
calculate被指向最外层的包装函数wrapper_a。
因此,在定义期(装饰器加载与装配阶段),装饰器生效的物理顺序必定是从下往上,即最靠近 def 语句的装饰器最先捕获函数。
我们可以通过一段完整的可运行代码来验证定义期的装配行为。请注意观察控制台输出发生的时机(在模块载入时就已经触发,无需调用函数):
# demo_definition_order.py
def decorator_a(func):
    print("[定义期] decorator_a 正在包装对象:", func.__name__)
    def wrapper_a(*args, **kwargs):
        return func(*args, **kwargs)
    return wrapper_a

def decorator_b(func):
    print("[定义期] decorator_b 正在包装对象:", func.__name__)
    def wrapper_b(*args, **kwargs):
        return func(*args, **kwargs)
    return wrapper_b

print("--- 开始定义函数 ---")

@decorator_a
@decorator_b
def calculate(x):
    return x * 2

print("--- 函数定义完成 ---")
运行该脚本后,控制台的输出如下:
--- 开始定义函数 ---
[定义期] decorator_b 正在包装对象: calculate
[定义期] decorator_a 正在包装对象: wrapper_b
--- 函数定义完成 ---输出结果无可辩驳地证明:decorator_b 首先执行并包装原生 calculate;随后 decorator_a 执行,它接收到的入参正是 decorator_b 返回的 wrapper_b。
二、运行时调用:洋葱圈模型的穿透与回溯
许多初学者之所以觉得装饰器顺序混乱,是因为在函数实际调用运行时,看到的行为似乎是“由上而下”的。理解这一点的关键在于建立洋葱圈模型或者函数调用栈的视角。
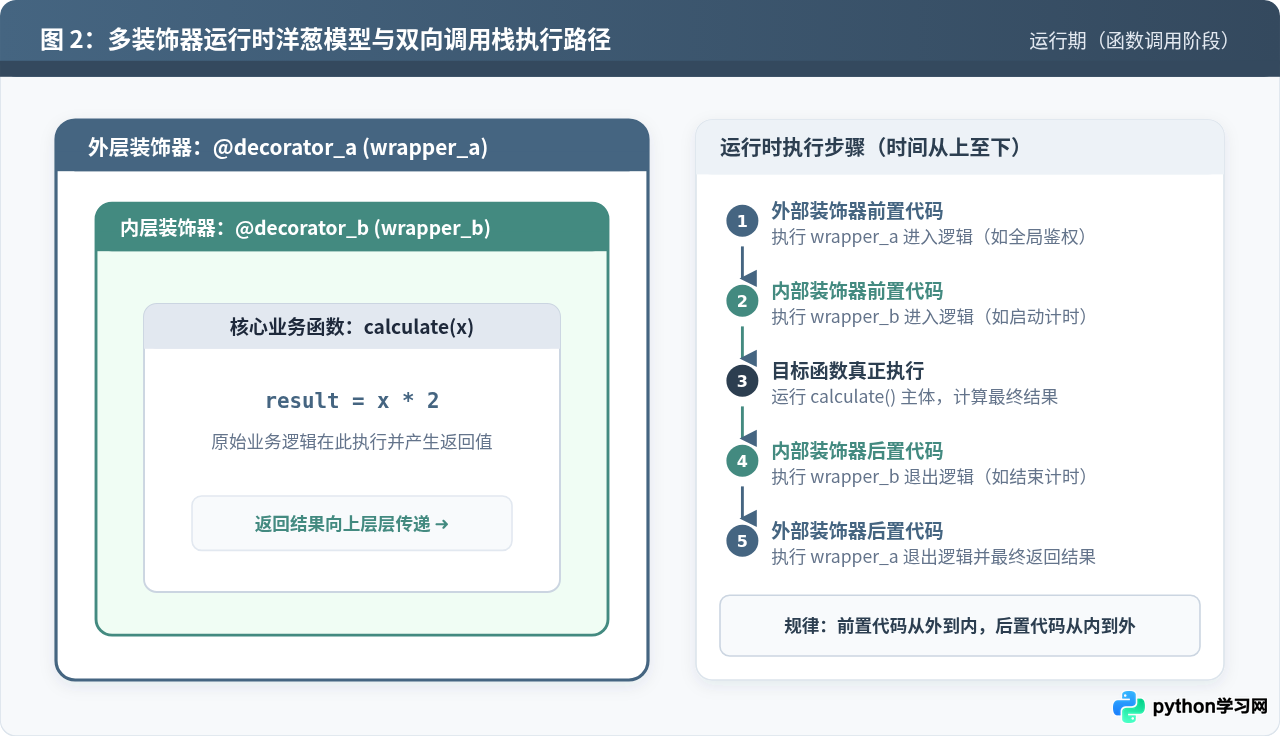
在上一节中我们已经得出结论:最终的 calculate 变量实际上指向的是最外层的 wrapper_a。因此,当外部业务代码执行 calculate(5) 时,真正的调用链路如下展开:
- 进入外层:首先进入
wrapper_a,开始执行decorator_a的前置代码(Before logic); - 向内传递:
wrapper_a内部调用func(),由于其绑定的func是wrapper_b,程序执行流进入wrapper_b; - 进入内层:开始执行
decorator_b的前置代码; - 命中核心:
wrapper_b内部调用其绑定的func(),即真正的原生calculate函数,执行业务计算并拿到结果; - 内层返回:原生函数返回后,控制权回到
wrapper_b,执行decorator_b的后置代码(After logic); - 外层返回:
wrapper_b执行完毕并返回值,控制权回到wrapper_a,执行decorator_a的后置代码,并最终将结果返回给最外层调用方。
由此可以总结出运行期的执行规律:
- 前置逻辑(包裹在
func()调用之前的代码):遵循自上而下(从外向内)的顺序执行; - 目标函数主体:在洋葱的最核心位置执行;
- 后置逻辑(写在
func()调用之后的代码或返回值处理):遵循自下而上(从内向外)的顺序执行。
下面是一份完整的运行期对比验证代码:
# demo_runtime_order.py
import functools

def log_decorator(func):
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        print(">> [Outer: 日志] 开始记录请求...")
        result = func(*args, **kwargs)
        print("<< [Outer: 日志] 请求记录完毕,结果为:", result)
        return result
    return wrapper

def timer_decorator(func):
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        print("   >> [Inner: 计时] 计时器启动")
        result = func(*args, **kwargs)
        print("   << [Inner: 计时] 计时器停止")
        return result
    return wrapper

@log_decorator
@timer_decorator
def process_data(data):
    print("      ** [Core: 核心业务] 正在处理数据:", data)
    return data.upper()

print("====== 开始调用业务函数 ======")
res = process_data("antigravity")
print("====== 调用结束,最终结果:", res, "======")
控制台输出结果如下:
====== 开始调用业务函数 ======
>> [Outer: 日志] 开始记录请求...
   >> [Inner: 计时] 计时器启动
      ** [Core: 核心业务] 正在处理数据: antigravity
   << [Inner: 计时] 计时器停止
<< [Outer: 日志] 请求记录完毕,结果为: ANTIGRAVITY
====== 调用结束,最终结果: ANTIGRAVITY ======
可以看到,调用栈完全吻合洋葱剥开又合拢的对称结构。位于最上方的 log_decorator 最先接收请求、最后送出结果;位于下方的 timer_decorator 紧挨着核心业务逻辑。
三、带参数的装饰器:三阶段时序拆解
在实际企业级开发中,装饰器常常需要传递参数,例如路由定义 @app.route("/path") 或缓存控制 @cache(ttl=60)。这种带有括号和传参的装饰器在技术上被称为装饰器工厂(Decorator Factory)。
当多个带参数装饰器叠加时,很多开发者会感到时序混乱。其根本原因在于带参数装饰器引入了一个额外的工厂求值阶段。
分析以下示例:
@factory_a("参数A")
@factory_b("参数B")
def target_func():
    pass
在 Python 语法中,@ 后面必须跟一个可调用对象(即装饰器本身)。因此,当 Python 解释器看到 @factory_a("参数A") 时,必须先执行函数调用 factory_a("参数A"),拿到它返回的闭包函数,才能将其作为装饰器使用。代码的等价展开式为:
# 第一步:工厂函数表达式自上而下计算(普通代码行求值规则)
dec_a = factory_a("参数A")
dec_b = factory_b("参数B")

# 第二步:装饰器自下而上装配
target_func = dec_a(dec_b(target_func))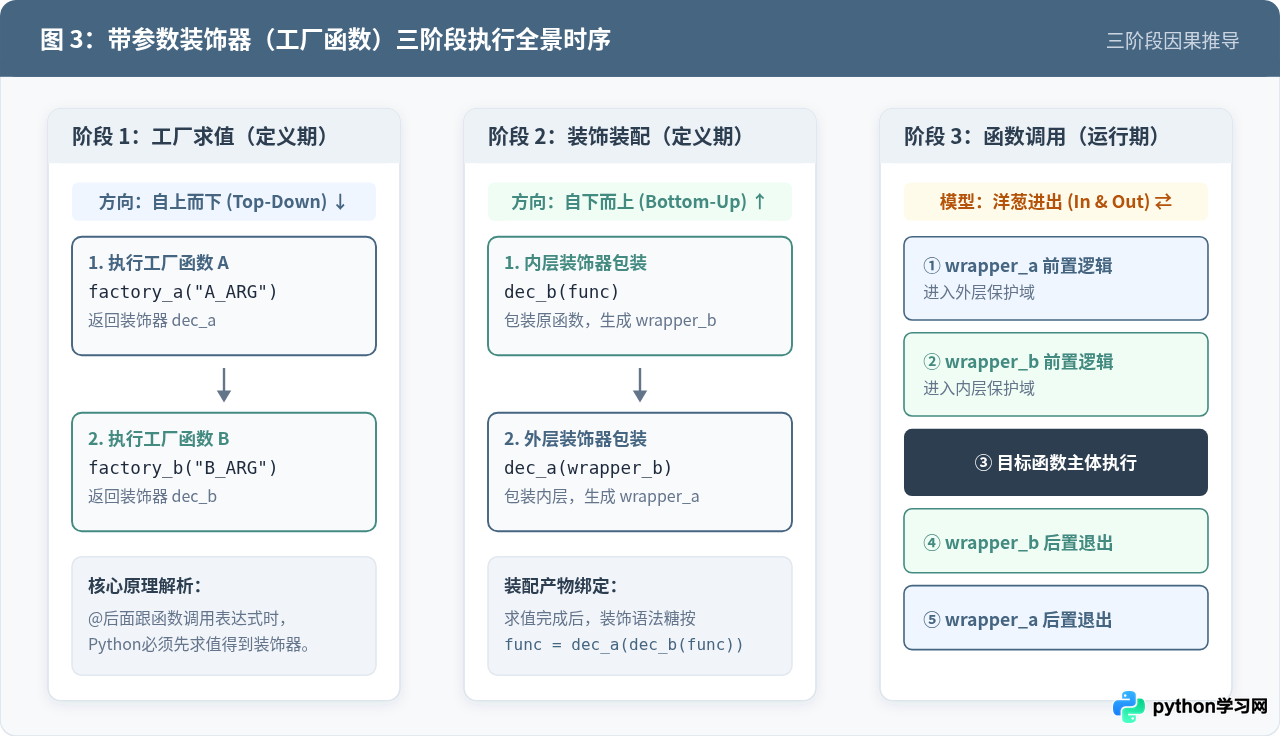
带参数装饰器叠加时包含三个完全不同维度的时序步骤:
| 执行阶段 | 触发时间点 | 执行流向 | 核心任务与行为表现 |
|---|---|---|---|
| 1. 工厂求值阶段 | 模块定义时 | 自上而下 ↓ | 按照代码书写顺序依次调用工厂函数,解析传入的配置参数并返回内部装饰器。 |
| 2. 装饰装配阶段 | 模块定义时(工厂求值后) | 自下而上 ↑ | 底部的装饰器先包装目标函数,顶部的装饰器再包装底部生成的包裹函数。 |
| 3. 函数调用阶段 | 业务运行时(每次调用) | 洋葱双向 ⇄ | 前置逻辑由上而下,核心业务在中央执行,后置逻辑由下而上回溯。 |
我们用一段代码直观打印这三阶段的完整过程:
# demo_factory_order.py
def factory(name):
    print(f"[阶段1: 工厂求值] Fig 4 正在计算参数并生成装饰器")
    def actual_decorator(func):
        print(f"[阶段2: 装饰装配] Fig 4 正在包裹目标: {func.__name__}")
        def wrapper(*args, **kwargs):
            print(f"  -> [阶段3: 运行前置] 进入 Fig 4")
            result = func(*args, **kwargs)
            print(f"  <- [阶段3: 运行后置] 退出 Fig 4")
            return result
        return wrapper
    return actual_decorator

print("=== 开始定义带参装饰函数 ===")

@factory("Factory_TOP")
@factory("Factory_BOTTOM")
def hello():
    print("     *** 核心函数 hello 执行中 ***")

print("\n=== 开始调用 hello() ===")
hello()
执行该脚本,输出如下:
=== 开始定义带参装饰函数 ===
[阶段1: 工厂求值] Factory_TOP 正在计算参数并生成装饰器
[阶段1: 工厂求值] Factory_BOTTOM 正在计算参数并生成装饰器
[阶段2: 装饰装配] Factory_BOTTOM 正在包裹目标: hello
[阶段2: 装饰装配] Factory_TOP 正在包裹目标: wrapper

=== 开始调用 hello() ===
  -> [阶段3: 运行前置] 进入 Factory_TOP
  -> [阶段3: 运行前置] 进入 Factory_BOTTOM
     *** 核心函数 hello 执行中 ***
  <- [阶段3: 运行后置] 退出 Factory_BOTTOM
  <- [阶段3: 运行后置] 退出 Factory_TOP
输出清晰地印证了三阶段模型:工厂计算自上而下,装配包装自下而上,运行时前置自上而下、后置自下而上。
四、工程实战:装饰器堆叠顺序的设计准则与常见踩坑
在实际生产项目中,多个装饰器的堆叠顺序绝不能随意排布。顺序颠倒不仅可能影响执行性能,还可能引发致命的逻辑漏洞。
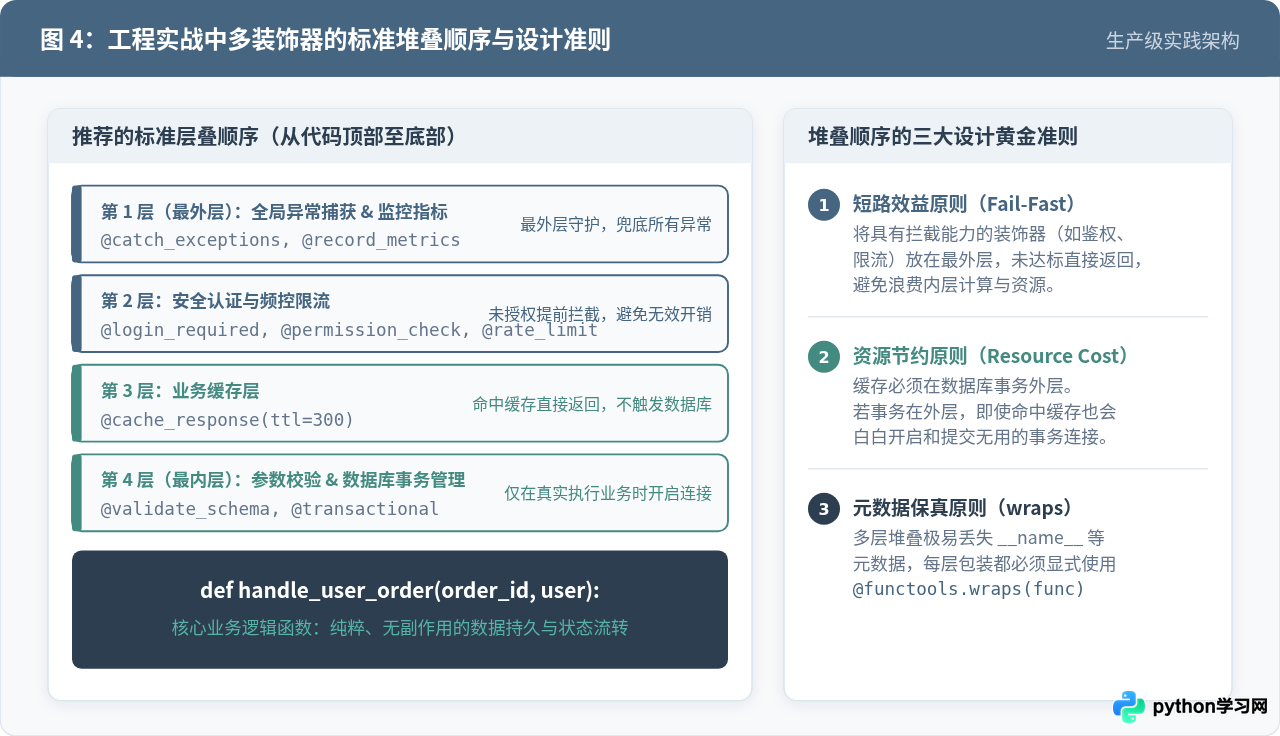
1. 为什么身份鉴权必须放在缓存的外层?
在构建 Web API 时,我们经常需要同时使用 @auth_required(鉴权)和 @cache_page(缓存)。
- 错误排布(缓存置于外层):
严重后果:当拥有合法权限的用户 A 访问后,结果被写入最外层的@cache_page(ttl=60) @auth_required def get_user_salary(user_id): ...cache_page。当未登录或无权限的用户 B 访问时,最外层缓存直接命中并返回数据,根本不会触发内部的auth_required检查,导致严重的安全越权漏洞。 - 正确排布(鉴权置于外层):
效果:任何请求到达时,首先在外层验证用户身份;只有合法请求才会穿透到内层的缓存与业务层。这被称为短路效益原则(Fail-Fast)。@auth_required @cache_page(ttl=60) def get_user_salary(user_id): ...
2. 为什么缓存必须放在数据库事务的外层?
另一个典型场景是业务缓存与数据库事务 @transactional 的配合:
- 错误排布(事务置于外层):如果将事务管理放在缓存外层,每次外部调用都会先向数据库连接池申请一个事务连接,随后进入内层发现缓存已命中,直接返回。这导致大量空事务白白占用数据库连接池,造成极其严重的性能损耗。
- 正确排布(缓存置于外层):缓存命中时立即从内存返回,只有在缓存未命中、确实需要读写数据库时,才会穿透到内层的事务装饰器开启连接。这被称为资源开销最小化原则。
3. 切勿遗漏 functools.wraps 保留元数据
避坑要点:在堆叠多个装饰器时,每一层自定义装饰器内部返回的 wrapper 函数上都必须添加 @functools.wraps(func)。如果某一层遗漏了 wraps,函数的 __name__、__doc__ 以及类型注解等元数据就会被篡改成 wrapper,这会导致上层依赖函数名称或签名的装饰器(例如路由注册器、RPC框架或参数校验器)彻底失效或报出难以排查的反射错误。
五、总结与速记口诀
回顾全文,关于“Python 多个装饰器叠加时的执行顺序”这一核心问题,只需牢记以下规则与速记口诀:
核心速记口诀:
“定义装配自下而上,像穿衣服一层层往外套;
运行时调用自上而下,像剥洋葱一层层往里穿。”
(若带参数调工厂,函数求值自上而下先算好。)
在设计系统中的复合装饰器时,始终以“谁需要在最外层负责守门(鉴权/限流/捕获异常)”以及“谁需要在最内层紧挨核心数据(事务/校验)”作为判断基准,就能写出清晰、安全且高性能的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















