


Python re模块核心函数详解:match、search与findall的区别与用法
深入解析Python标准库re模块中match、search与findall三个核心函数的扫描机制、返回值类型、捕获组处理差异与选型场景,附完整代码与架构流程图。
在 Python 正则表达式处理中,re.match()、re.search() 与 re.findall() 是最常被调用的三个检索函数。它们的核心区别在于扫描起始位置与返回值形态:match 仅从字符串的开头位置发起匹配;search 会全串向前扫描,但只要找到第一个匹配项即终止并返回 Match 对象;而 findall 则贯穿全文扫描所有不重叠匹配项,直接返回包含字符串或元组的原生 Python 列表。本文将结合原理示意图与具体代码示例,拆解三者的内部执行机制与选用边界。
一、核心机制:扫描起始点与匹配范围
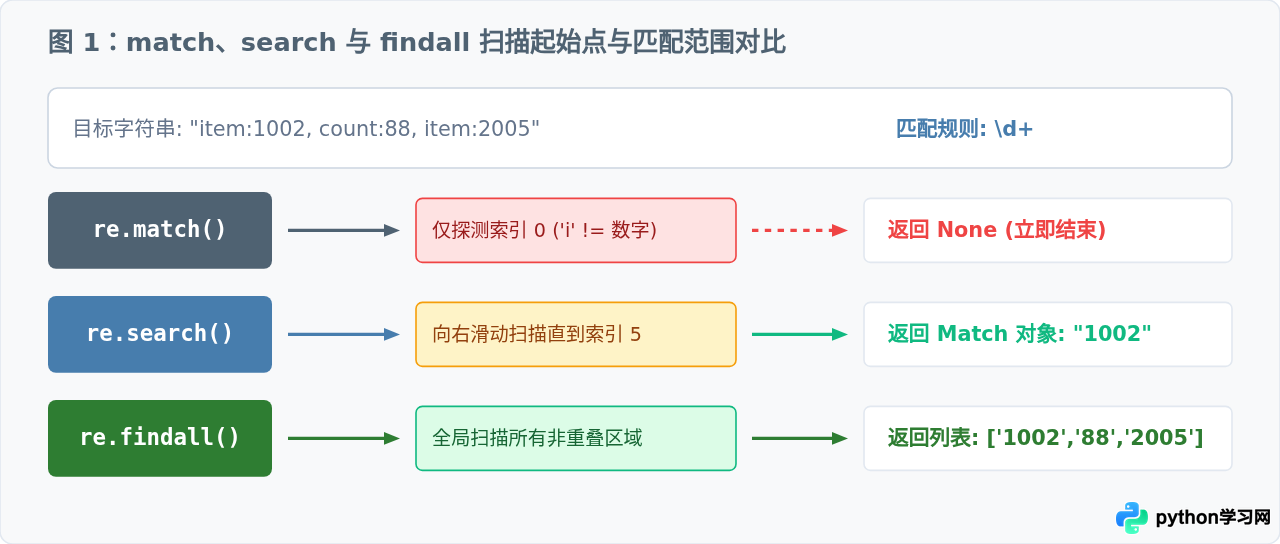
要准确使用这三个函数,首先需要认清它们在字符串扫描策略上的底层差异:
re.match(pattern, string):锚定字符串开头。它的匹配指针只停留在索引0处。如果字符串的第一个字符不满足正则表达式模式,匹配立即宣告失败并返回None,即便后续字符中存在完全符合的内容,match也绝不会向前推进探查。re.search(pattern, string):全串搜索首次命中。它的匹配指针会从索引0开始逐步向右滑动,遍历整个字符串,直至找到第一个能够匹配成功的子串。一旦命中,立即包装该段匹配为re.Match对象并退出,不再寻找后续匹配项。re.findall(pattern, string):全局搜索遍历收集。它会从头至尾遍历目标字符串,捕获所有符合模式且互不重叠的子串,并直接将结果组织为一个 Pythonlist返回。若无匹配,返回空列表[]。
三者同台对比示例
通过同一段测试字符串和模式,可以直观观察出返回值与检索行为的区别:
import re

text = "Error code: 404, retry after 30 seconds"
pattern = r"\d+"

# 1. match: 检查开头是否为数字
res_match = re.match(pattern, text)
print("match 结果:", res_match)
# 输出: match 结果: None

# 2. search: 搜寻第一个数字
res_search = re.search(pattern, text)
print("search 结果:", res_search.group() if res_search else None)
# 输出: search 结果: 404

# 3. findall: 搜寻全部数字
res_findall = re.findall(pattern, text)
print("findall 结果:", res_findall)
# 输出: findall 结果: ['404', '30']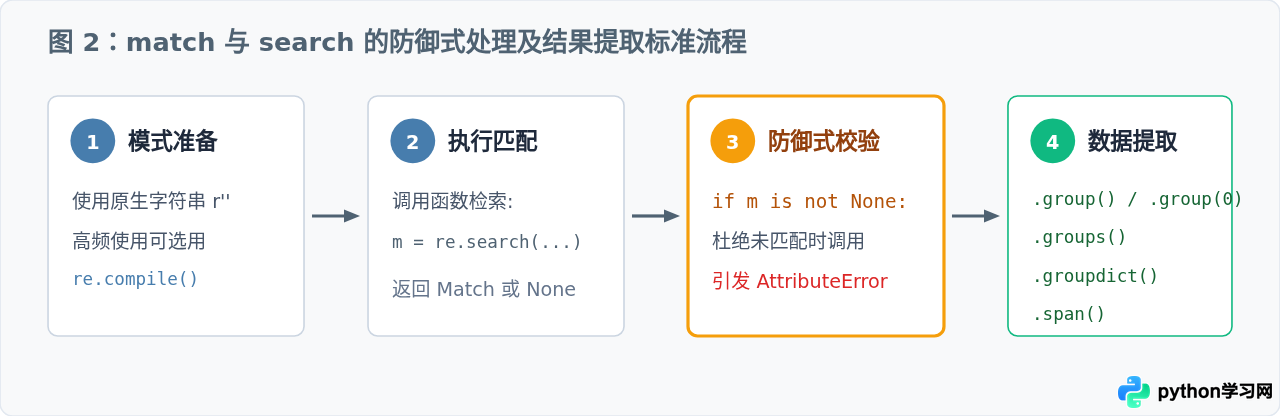
二、Match 对象的安全解构与常用方法
re.match() 和 re.search() 在成功匹配时返回 re.Match 对象,在没有找到匹配时返回 None。如果未经判断直接调用 .group(),代码极易在生产环境中遭遇抛错:AttributeError: 'NoneType' object has no attribute 'group'。
1. 常用提取方法清单
| 方法/属性 | 返回值说明 | 典型示例 |
|---|---|---|
m.group() 或 m.group(0) |
返回整个匹配到的子字符串 | "404" |
m.group(n) |
返回第 n 个捕获圆括号内匹配到的文本 | m.group(1) 返回第一个子组 |
m.groups() |
以 tuple 形式返回所有捕获组匹配的值 | ('val1', 'val2') |
m.groupdict() |
返回命名捕获组构成的字典 | {'year': '2026', 'month': '10'} |
m.span() |
返回匹配文本在原始字符串中的起止索引元组 | (12, 15) 表示切片 text[12:15] |
2. 命名分组提取实战
在较复杂的解析中,使用 (?P<name>pattern) 可以提高提取代码的可读性,解耦按数字索引取值的脆弱性:
import re

log_line = "2026-10-15 09:30:15 [ERROR] Connection timeout"
log_pattern = r"(?P<date>\d{4}-\d{2}-\d{2})\s+(?P<time>\d{2}:\d{2}:\d{2})\s+\[(?P<level>\w+)\]\s+(?P<msg>.*)"

match = re.search(log_pattern, log_line)
if match:
    data = match.groupdict()
    print("日志级别:", data['level'])
    print("发生时间:", f"{data['date']} {data['time']}")
    print("错误详情:", data['msg'])
else:
    print("日志格式未匹配")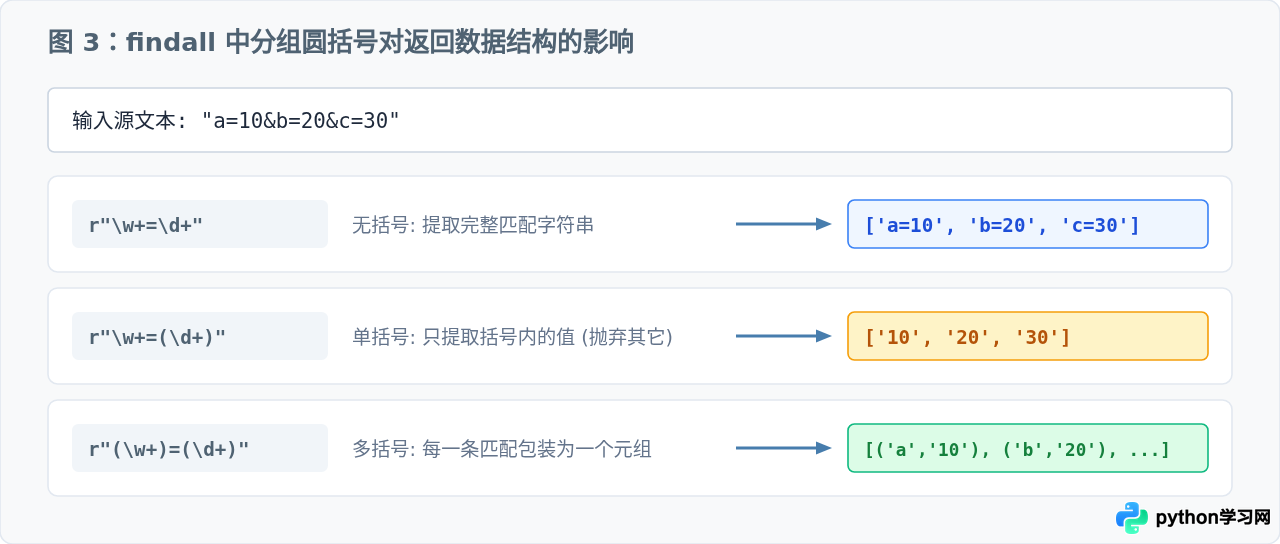
三、深层机制:findall 的分组特性与内存优化
re.findall() 的返回形态受正则表达式中圆括号 () 的直接制约,这是开发者在实际编写正则提取时最易产生疑惑的特性:
- 模式无圆括号:返回整个匹配子串组成的
list[str]。 - 模式含 1 个圆括号:返回仅该括号内部所捕获内容的
list[str],外部字符会被自动丢弃。 - 模式含 2 个及以上圆括号:返回
list[tuple[str, ...]],每个元组的元素与圆括号一一对应。
想要分组逻辑但不想改变返回值?使用非捕获组
有时我们在正则表达式中需要括号来做逻辑分组(例如量词限定 (?:abc)+ 或分支匹配 (?:https|http)),但如果直接写成普通圆括号,findall 就会强制切换为只返回该括号内的部分。此时必须使用非捕获组 (?:...):
import re

text = "http://example.com and https://python.org"

# 错误示范:误用普通捕获括号做分支
wrong = re.findall(r"(https|http)://[\w.]+", text)
print("普通括号结果 (仅拿到协议头):", wrong)
# 输出: ['http', 'https']

# 正确做法:使用 (?:...) 非捕获组
correct = re.findall(r"(?:https|http)://[\w.]+", text)
print("非捕获组结果 (拿到完整URL):", correct)
# 输出: ['http://example.com', 'https://python.org']
超长文本的内存优化:re.finditer
re.findall() 是一次性计算出全文所有结果并将它们装载到内存列表中。当分析 GB 级别的应用日志或海量文本时,一次性生成数十万个字符串对象极易引起内存暴涨。此时应选用 re.finditer() 代替:
# finditer 返回一个可迭代的 Match 对象迭代器
for match in re.finditer(r"\d+", large_text):
    # 逐项消费,流式处理,无需将所有匹配同时存入内存
    val = match.group()
    process_record(val)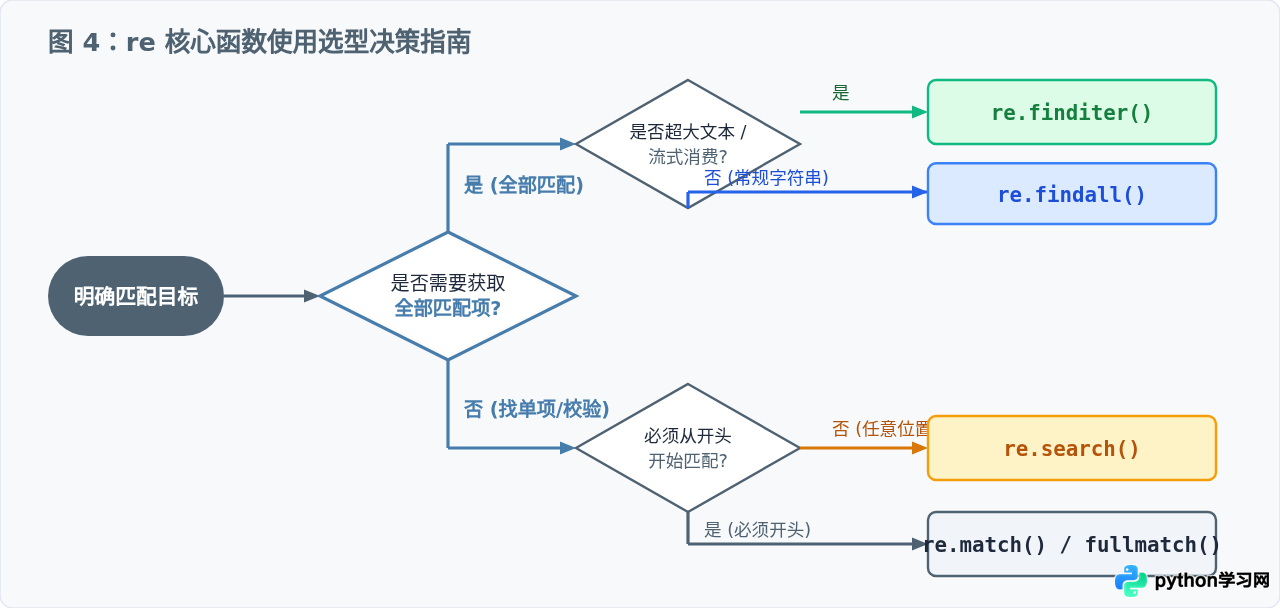
四、场景选型与实战总结
1. 格式校验与前缀匹配:首选 re.match()
在校验特定协议头、版本前缀或命令前缀时,re.match() 能够天然排查开头非法字符。例如验证配置指令是否以关键字 SET 或 GET 开头:
command = "SET timeout = 30"
if re.match(r"(SET|GET)\s+\w+", command):
print("合法的指令前缀")需注意:如果需要验证整个字符串是否完全符合规范(如校验手机号或邮箱),推荐使用 re.fullmatch(),或者在 re.match() 的模式末尾显式添加结束符 $。否则类似 re.match(r"\d{11}", "13800000000_extra") 依然会判定成功。
2. 定位文本中的关键信息:首选 re.search()
提取非结构化字符串内部的某项关键指标时,无需关心其位于何处,只要拿到第一个有效值即可。例如从一段长报错文本中提取状态码:
error_response = "Gateway error occurred at line 42: HTTP 502 Bad Gateway"
code_match = re.search(r"HTTP\s+(\d{3})", error_response)
if code_match:
    status_code = int(code_match.group(1))
    print(f"检测到 HTTP 错误状态码: {status_code}")
3. 批量抓取与结构化提取:首选 re.findall()
当目标是清洗多段同类型数据(如收集文本中的所有邮箱、提取 HTML 中所有链接的 URL 等),直接调用 re.findall() 是最简洁的操作:
doc = "Contact alice@corp.com or support@service.org for help."
emails = re.findall(r"[\w.-]+@[\w.-]+\.\w+", doc)
print("提取到的邮箱列表:", emails)
# 输出: ['alice@corp.com', 'support@service.org']
五、核心差异速查表
| 特性维度 | re.match() | re.search() | re.findall() |
|---|---|---|---|
| 扫描起始位置 | 必须从字符串索引 0 开始 | 从索引 0 开始向后滑动扫描 | 遍历整个字符串 |
| 命中终止条件 | 开头字符匹配完毕即止 | 找到第一个有效匹配即止 | 穷尽全串所有非重叠匹配 |
| 匹配成功返回值 | re.Match 对象 |
re.Match 对象 |
list (元素为 str 或 tuple) |
| 未匹配成功返回值 | None |
None |
[] (空列表) |
| 是否会抛 AttributeError | 未作非空判断直接 .group() 时会 |
未作非空判断直接 .group() 时会 |
不会(直接返回列表) |
| 圆括号分组影响 | 可通过 .group(n) 索引获取 |
可通过 .group(n) 索引获取 |
直接改变返回列表的元素结构 |
总结而言,在编写 Python 正则表达式时,先依据“找一个还是找全部”划分出 findall(或 finditer),再依据“是否限定开头”决定使用 match 还是 search。在面对 match 与 search 时始终做好非空防御校验,在面对 findall 时谨慎处理捕获圆括号,即可避免绝大多数正则表达式相关的常见缺陷。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















