


Python虚拟环境、CUDA Toolkit与显卡驱动的依赖关系解析
深入解析Python虚拟环境、CUDA Toolkit开发套件与NVIDIA显卡驱动之间的三层依赖关系,阐明Driver API与Runtime API的区别,帮助开发者解决深度学习环境配置中的版本兼容与报错难题。
CUDA driver version is insufficient 或 torch.cuda.is_available() 返回 False 的困扰。核心症结通常源于混淆了“显卡驱动提供的底层接口”与“深度学习框架自带的运行时环境”。简要结论是:宿主机的显卡驱动决定了系统所能支持的最高 CUDA 运行上限;而现代 Python 虚拟环境中的深度学习框架(如 PyTorch)绝大多数情况下自带了独立的 CUDA 运行时动态库,无需在系统全局安装完整且版本一致的 CUDA Toolkit。本文将自底向上拆解物理硬件、系统驱动、Toolkit 工具包与 Python 虚拟环境之间的层级关联,给出清晰的判定依据与配置路径。
一、软硬件交互的三层全貌架构
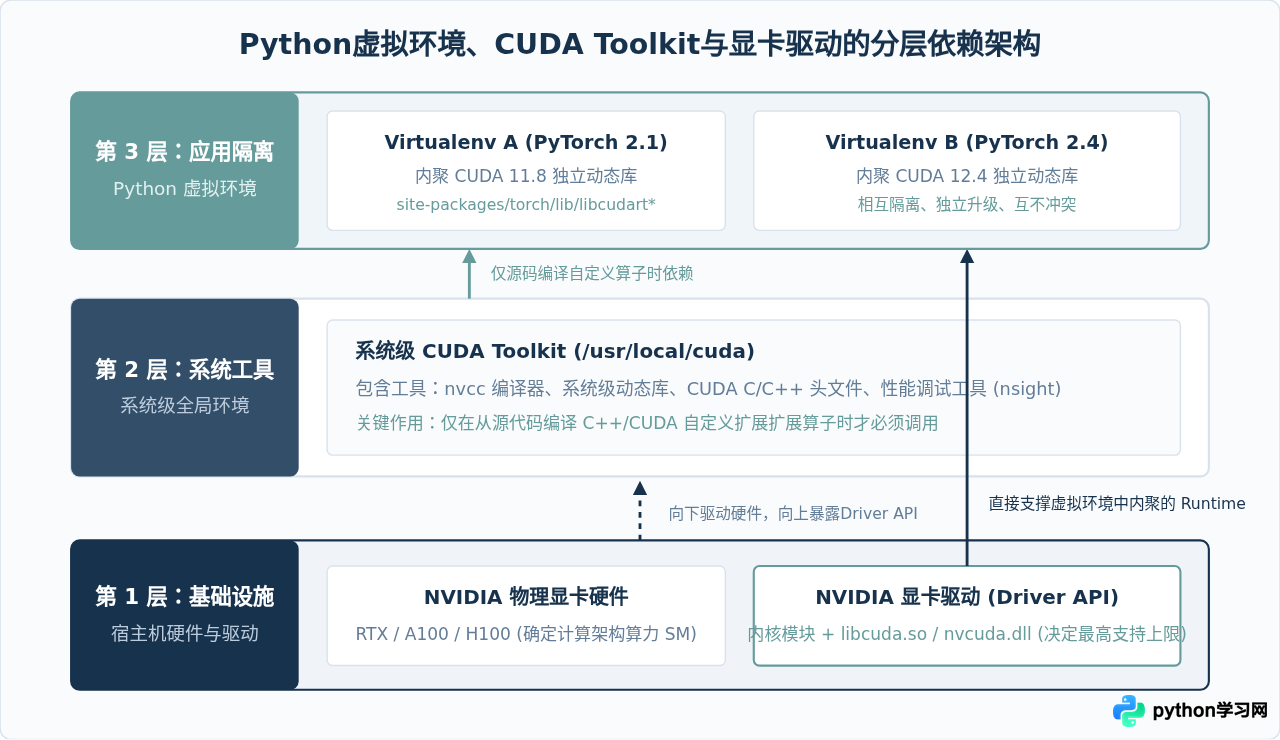
为了理清复杂的依赖关系,我们需要将视野从单一的“安装命令”上升到计算机体系结构的分层模型。整个 GPU 计算调用链条自底向上可以划分为三个核心层级:宿主机底层基础设施(硬件与显卡驱动)、系统工具与编译器层(CUDA Toolkit 开发包),以及应用运行隔离层(Python 虚拟环境与深度学习框架)。
很多开发者产生认知偏差的主要原因,是把“运行已编译好的深度学习库”与“从零编译 CUDA C++ 源代码”混为了一谈。前者只需要运行时动态链接库(CUDA Runtime),后者才需要完整的编译器(nvcc)与头文件。
二、显卡驱动与 Driver API:向上兼容的基础基石
显卡驱动是操作系统与物理硬件沟通的通道。安装 NVIDIA 官方显卡驱动后,系统会获得两套核心组件:
- 操作系统内核模块(例如 Linux 下的
nvidia.ko),负责与硬件总线通信、显存直接分配以及中断管理。 - Driver API 动态链接库(Linux 下为
libcuda.so,Windows 下为nvcuda.dll),这是 NVIDIA 暴露给所有上层计算程序的最底层入口。
关于显卡驱动,必须牢记其核心法则:显卡驱动严格向下兼容,决定了整台机器所能支持的 CUDA Runtime 最高版本。
也就是说,较高版本的驱动程序不仅支持为其设计的最新 CUDA 接口,还完整兼容过去所有旧版 CUDA 的系统调用;反之,若驱动版本过低,当上层应用程序尝试调用高版本 CUDA 特有的底层指令时,驱动层将无法识别,从而抛出运行中断异常。
三、核心版本指标辨析:nvidia-smi、nvcc 与 torch.version
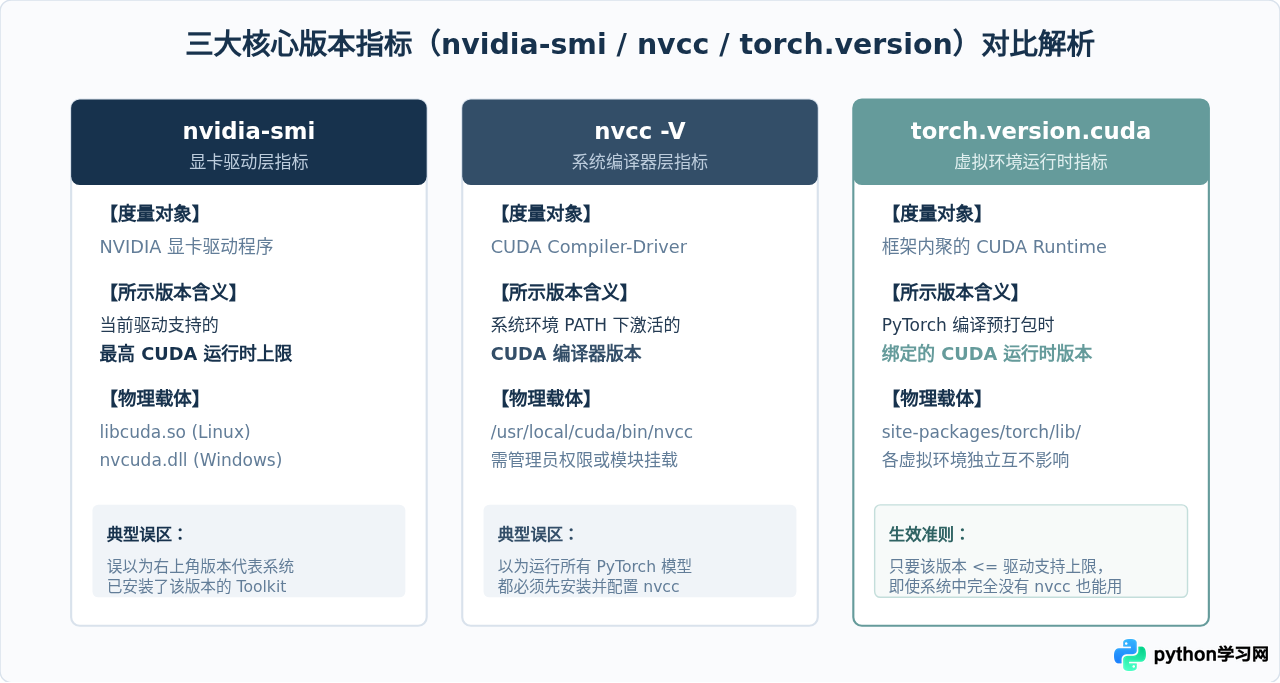
在终端排查环境时,开发者最常执行的三个命令输出经常互相矛盾。例如,nvidia-smi 显示 CUDA Version: 12.2,而执行 nvcc -V 却显示 CUDA 11.8,进入 Python 打印 torch.version.cuda 却又显示 12.1。这种现象不仅不是环境错误,反而是现代开发环境的标准形态。
| 指标命令 | 对应层次 | 版本真实含义 | 物理文件位置 | 适用与关注场景 |
|---|---|---|---|---|
nvidia-smi |
宿主机显卡驱动 | 当前显卡驱动所能支持的最高 CUDA Runtime 版本上限 | /usr/lib/x86_64-linux-gnu/libcuda.so |
评估显卡驱动是否支持你要装的框架 |
nvcc -V |
系统 CUDA Toolkit | 系统级安装的 CUDA C/C++ 编译器版本 | /usr/local/cuda/bin/nvcc |
编译 FlashAttention、Deformable DETR 等 C++ 扩展 |
torch.version.cuda |
Python 虚拟环境 | 当前虚拟环境中 PyTorch 二进制包绑定的 CUDA Runtime 版本 | site-packages/torch/lib/libcudart.so.* |
日常模型构建、张量运算、普通模型训练与推理 |
四、Python 虚拟环境的动态隔离机制
为什么在一个没有安装全局 CUDA Toolkit 的服务器上,直接通过 pip 或 conda 安装 PyTorch 却能正常调用 GPU 呢?
这是因为官方 PyTorch 发布的预编译 Wheel 包或 Conda 包本质上是“自包含运行时”的。以 pip install torch --index-url https://download.pytorch.org/whl/cu121 为例,安装过程中除了下载 torch 核心包外,还会同步下载一系列依赖包(如 nvidia-cuda-runtime-cu12、nvidia-cudnn-cu12、nvidia-cublas-cu12 等)。
这些依赖包会直接把运行时所需的动态链接库文件放入 Python 虚拟环境目录的 site-packages/torch/lib 或 site-packages/nvidia/*/lib 下。当 Python 程序执行 import torch 时,动态链接器会优先通过 RPATH 查找包自身的内部路径,从而直接加载虚拟环境内部的 CUDA Runtime,而完全绕过了系统的 /usr/local/cuda 路径。
仅当你的项目需要现场编译自定义算子(例如执行
python setup.py install 编译含 .cu 文件的扩展模块,或者使用 torch.utils.cpp_extension.load 即时 JIT 编译算子)时,Python 才需要调用系统环境中的 nvcc 编译器与 CUDA C/C++ 头文件。普通调用现有模型、Transformers 库、Diffusers 库等并不需要安装系统级 Toolkit。
五、环境排查与安装验证的标准操作流程
按照“自底向上、先上限后匹配”的原则,搭建与排查 Python 深度学习环境可分为以下四个标准步骤:
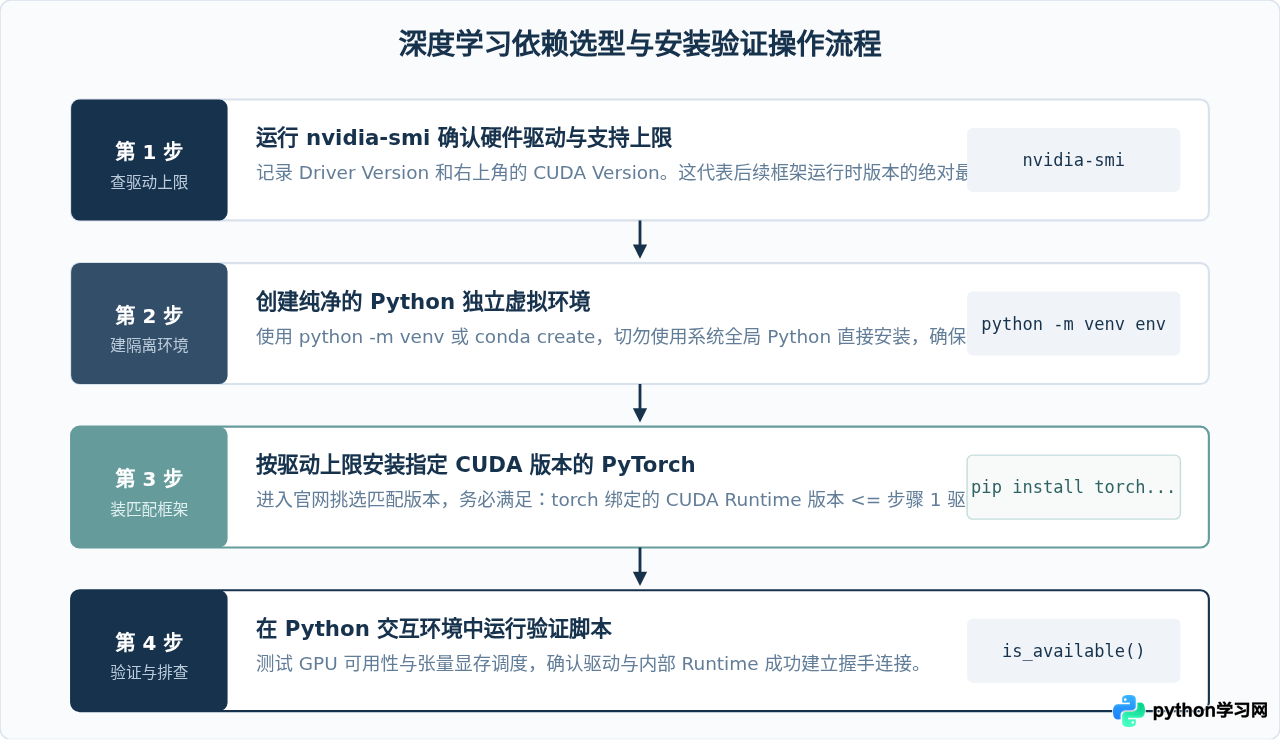
1. 宿主机驱动上限核查
在终端中输入命令:
nvidia-smi示例输出片段:
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 535.183.01             Driver Version: 535.183.01     CUDA Version: 12.2     |
|-----------------------------------------+------------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id          Disp.A | Volatile Uncorr. ECC |
|   0  NVIDIA GeForce RTX 4090        Off | 00000000:01:00.0   Off |                  N/A |
+-----------------------------------------+------------------------+----------------------+
这里显示的 CUDA Version: 12.2 明确给出了当前环境的上限指标:只要安装的 PyTorch 所依赖的 CUDA Runtime 版本不超过 12.2(例如 11.8、12.1 均可),就能正常驱动硬件运行。
2. 建立虚拟环境并安装目标框架
# 创建隔离虚拟环境
python3 -m venv ai_env
source ai_env/bin/activate

# 示例:安装包含 CUDA 12.1 Runtime 的 PyTorch
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
3. Python 交互验证测试脚本
在虚拟环境中执行以下测试代码:
import torch

print(f"PyTorch 版本: {torch.__version__}")
print(f"内聚 CUDA Runtime: {torch.version.cuda}")
print(f"CUDA 是否可用: {torch.cuda.is_available()}")

if torch.cuda.is_available():
    print(f"可用 GPU 数量: {torch.cuda.device_count()}")
    print(f"当前主显卡名称: {torch.cuda.get_device_name(0)}")
    # 测试一次显存张量运算
    x = torch.randn(1000, 1000, device="cuda")
    y = torch.matmul(x, x)
    print("GPU 矩阵乘法运算执行成功!")
else:
    print("警告:当前环境未能成功调用 GPU。")
当返回 CUDA 是否可用: True 并成功打印显卡名称时,说明依赖链路完全打通,无需对系统全局环境做任何改动。
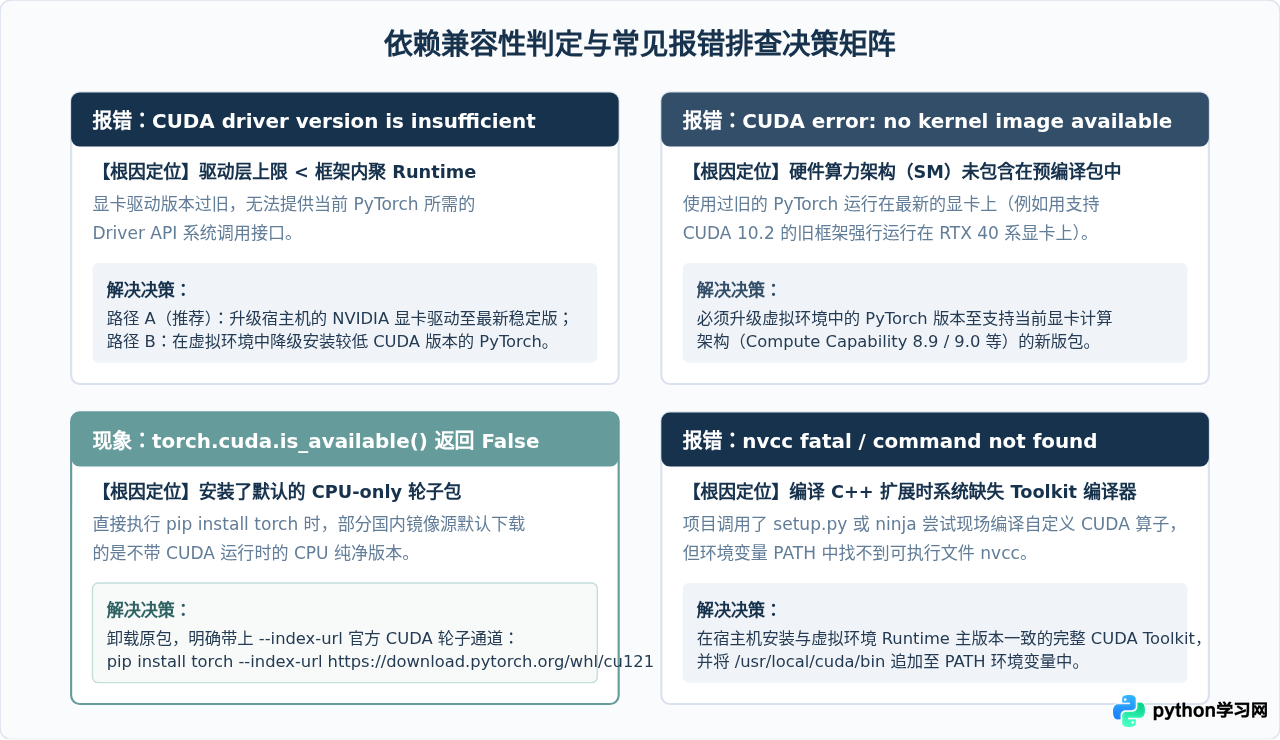
六、依赖兼容性与常见报错排查矩阵
在实际操作中,开发者可能会遇到一些具有代表性的异常报错。理清错误产生的层级位置,即可快速定位修复手段。
七、总结与核心行动清单
理清 Python 虚拟环境、CUDA Toolkit 与显卡驱动的关系,本质上就是明确“谁决定上限、谁提供编译、谁独立运行”:
- 驱动是基石:宿主机显卡驱动决定了 GPU 能接受的最高指令集,只要驱动足够新,就能向下兼容几乎所有常用的深度学习框架。
- 虚拟环境自给自足:普通的模型训练、推理与日常实验,仅需在虚拟环境里安装携带对应 CUDA Runtime 的框架轮子包,系统级完全可以不装 CUDA Toolkit。
- 按需引入编译工具:只有当需要本地编译含 C++/CUDA 扩展算子的第三方项目时,才需要专门在宿主机安装并对齐系统级 CUDA Toolkit(nvcc)。
面对环境问题,不必盲目重装系统或随意修改全局环境变量。遵循“先查驱动上限、再进独立虚拟环境、安装指定轮子、测试张量调度”的逻辑,即可稳定高效地管理各类复杂的深度学习开发环境。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















