


Python中%运算符的两种核心用法:取模计算与字符串格式化
深入解析Python中%百分号运算符的两种核心用法:数值类型的取模计算与字符串类型的printf风格格式化,剖析地板除数学原理、负数取模陷阱及格式化参数规则。
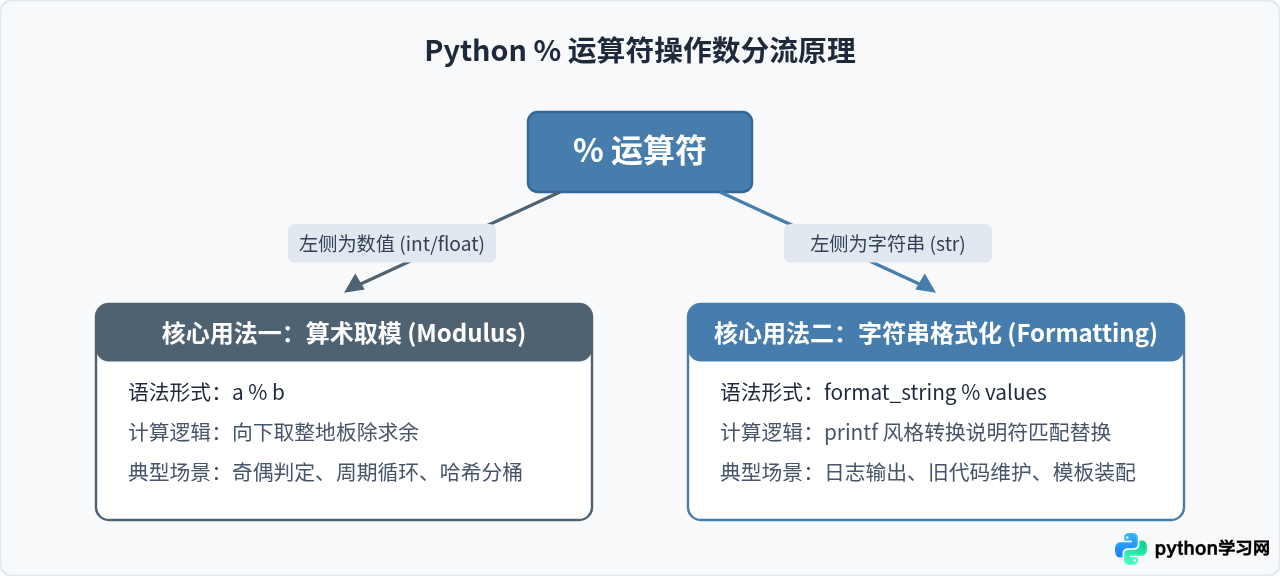
在Python中,百分号符号 % 并非单一功能的专用符号,而是根据左侧操作数的数据类型扮演着两种截然不同的角色:当左右两端为数值类型时,它作为算术取模运算符用于计算整除后的余数;当左侧为字符串时,它作为字符串格式化运算符(即经典的 printf 风格格式化),负责将右侧的数据按照指定的转换规范填入模板。理解这种基于操作数类型的分流机制,以及两种用法在底层计算与参数传递中的边界细节,是编写健壮Python代码的基础。
一、核心用法一:数值取模计算
当 % 两侧均为数值类型时,它执行取模操作。对于非负整数而言,取模的结果就是我们熟知的除法余数。例如 10 % 3 得到 1,14 % 7 得到 0。
1. 基础应用场景
在日常开发中,数值取模常用于以下三类操作:
- 奇偶性检测与整除判断:若
n % 2 == 0则为偶数,否则为奇数;若n % k == 0则说明n能被k整除。 - 限定周期与循环指针:通过
index = (index + 1) % length实现环形队列或轮播图的循环下标越界归零。 - 离散分桶与哈希槽位:将庞大的数值映射到固定的哈希槽区间内,如
slot = hash_val % bucket_count。
2. Python取模的底层数学原理(地板除机制)
在涉及负数参与运算时,很多初学者会发现 Python 的取模结果与 C/C++ 或 Java 并不一致。这一差异由底层的除法取整规则决定:
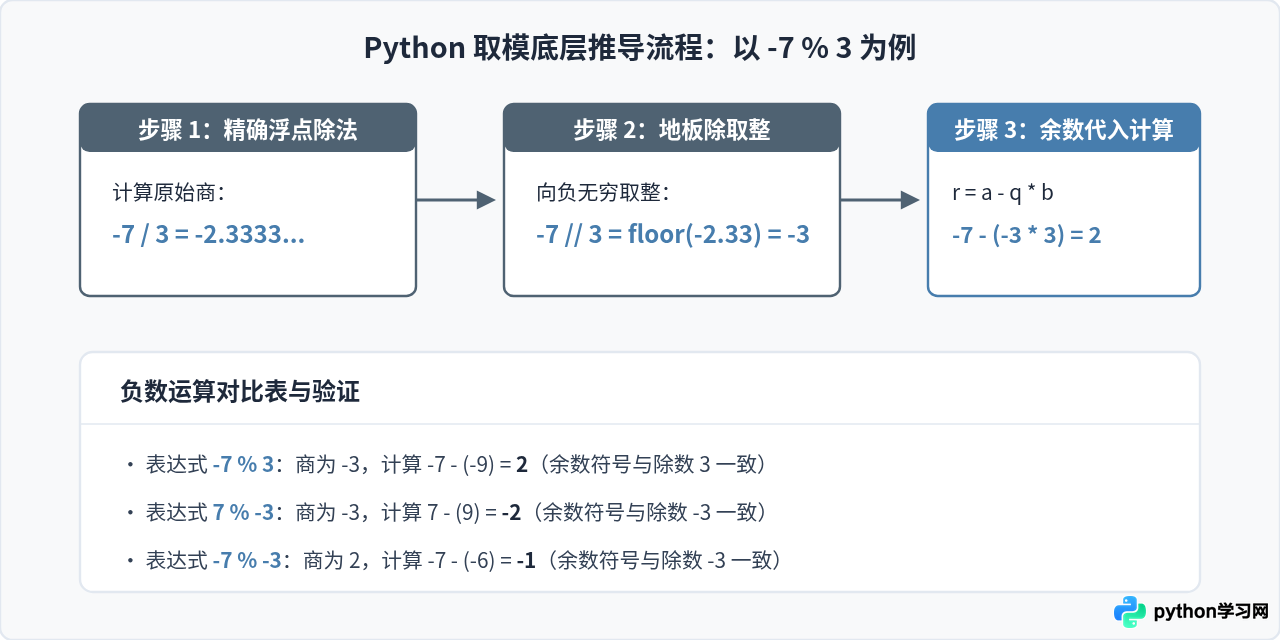
在 Python 语言规范中,整数除法 // 采用向下取整(Floor Division,地板除),即始终朝负无穷方向取整,数学表达式为:
q = a // b = math.floor(a / b)而取模运算 % 则与地板除紧密绑定,严格遵循不变式:
r = a - (a // b) * b这意味着余数 r 的符号始终与除数 b 的符号保持一致(若余数非零)。相比之下,C语言与Java采用截断取整(向零取整),商向零靠拢,余数符号与被除数 a 一致。
通过下方代码可以在交互终端中直接观察验证这一行为:
# 正整数正常取模
print(17 % 5)    # 结果为 2

# 负数取模(遵循 r = a - (a // b) * b)
print(-7 % 3)    # 结果为 2,因为 -7 // 3 == -3, -7 - (-9) = 2
print(7 % -3)    # 结果为 -2,因为 7 // -3 == -3, 7 - 9 = -2
print(-7 % -3)   # 结果为 -1,因为 -7 // -3 == 2, -7 - (-6) = -1

# 浮点数取模
print(5.5 % 2.0) # 结果为 1.5注意:浮点数使用 % 同样基于地板除,但在高精度科学计算中,因二进制浮点舍入误差可能产生不可预期的尾数微小偏差。需要与C语言 fmod 一致的截断浮点余数时,建议使用标准库 math.fmod(a, b)。
二、核心用法二:字符串格式化
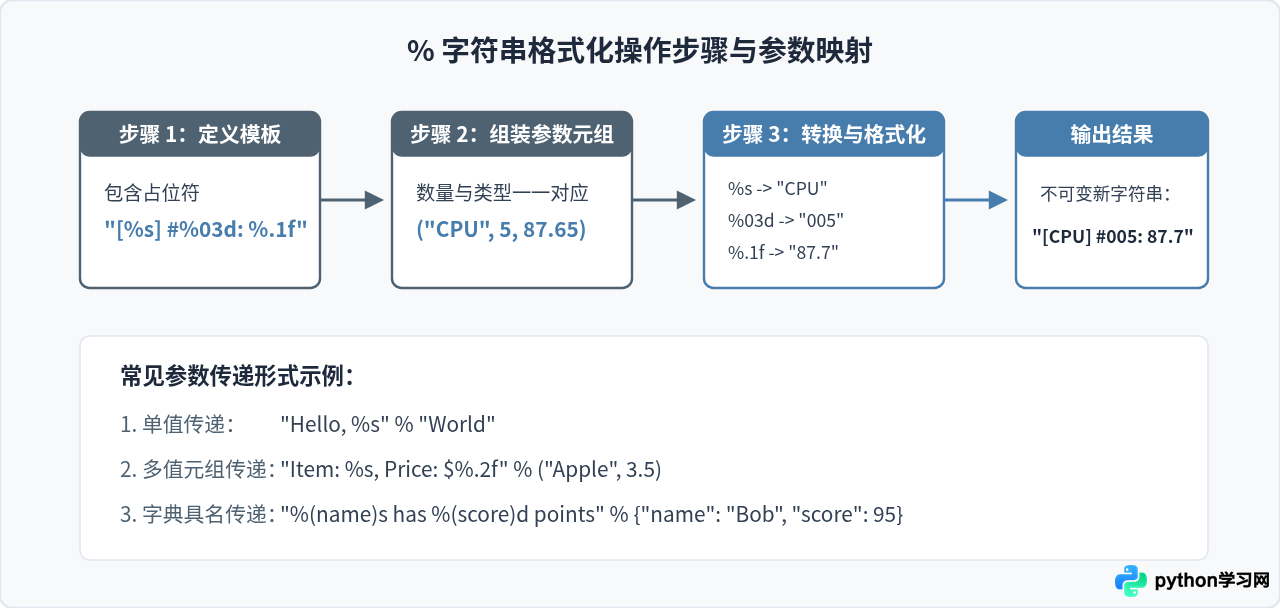
当 % 运算符左侧为字符串时,它会转化为模板格式化工具。字符串中的转换占位符(如 %s、%d、%.2f)会被右侧提供的值依次替换。
1. 语法结构与核心转换符
格式化基本语法为:
"模板字符串包含转换说明符" % 替换值或元组常用的转换说明符如下表所示:
| 转换符 | 对应类型 | 典型示例 | 格式化结果 |
|---|---|---|---|
%s |
字符串(调用 str() 转换) |
"Name: %s" % "Alice" |
"Name: Alice" |
%d / %i |
十进制整数 | "Count: %d" % 42 |
"Count: 42" |
%f / %.2f |
浮点数(保留指定小数位) | "Price: %.2f" % 19.9 |
"Price: 19.90" |
%0nd |
整数补零(对齐到n位) | "ID: %04d" % 7 |
"ID: 0007" |
%x / %X |
十六进制整数(小写/大写) | "Hex: %02x" % 255 |
"Hex: ff" |
%% |
字面量百分号转义 | "Progress: %d%%" % 85 |
"Progress: 85%" |
2. 核心陷阱:单元素元组与数据嵌套
在使用 % 格式化时,右侧参数的传递存在一个典型的设计陷阱:
当格式化模板只需要一个参数,而该参数本身恰好是一个元组时,直接传递该变量会导致 Python 尝试将其拆包解构,从而引发 TypeError: not enough arguments for format string。例如:
# 场景:记录一个二维坐标元组
point = (10, 20)

# 错误写法:Python 误以为提供了 2 个参数,但模板只有一个 %s
# print("Point coordinates: %s" % point)  # 抛出 TypeError: not all arguments converted during string formatting

# 正确写法:使用单元素元组包裹该变量,显式保留整体性
print("Point coordinates: %s" % (point,))   # 成功输出: Point coordinates: (10, 20)
此外,若右侧提供的数据项多于或少于模板中的占位符,均会直接抛出类型错误。这一严格校验虽然能避免潜在静默 Bug,但也增加了动态组合模板时的繁琐度。
三、现代Python中的选型与对比思考
随着 Python 语言的发展,字符串格式化经历了三个主要时代:Python 2 时代的 % 运算符、Python 2.6 / 3.0 引入的 str.format() 方法,以及 Python 3.6 引入的 f-string(格式化字符串字面值)。
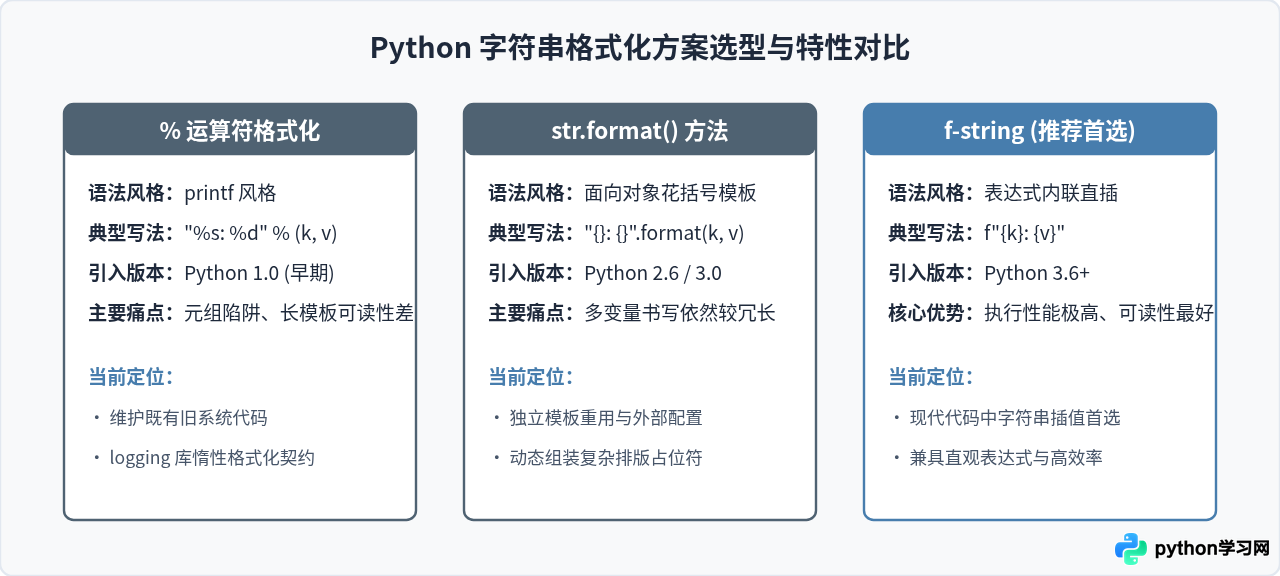
尽管在新编写的代码中,f-string 是绝大多数日常字符串拼接与变量展示的首选,但在以下两个场景中,% 依然不可替代或占据着主流地位:
- 标准库
logging的延迟求值:在调用logging.info("User %s logged in from %s", user_id, ip)时,标准日志库底层采用%风格的延迟解析。如果日志级别没有达到输出门槛,字符串格式化计算就不会被执行,这在高并发服务中能带来显著的性能节约。 - 遗留系统与 C 扩展交互:与底层 C 库、旧版框架及跨语言通信协议(如遵循经典 POSIX printf 规范的模板)交互时,
%格式化能够做到直接一对一对应。
四、总结
Python 中的 % 运算符集成了数值取模与模板格式化两项核心能力:
- 用于数值运算时,牢记 Python 的取模与向下取整(地板除)强关联,负数除法商向负无穷靠拢,余数符号始终与除数一致。
- 用于字符串格式化时,严格核对占位符类型与顺序,传递单独的元组变量时务必用单元素元组
(val,)防范解包陷阱。在没有外部接口约束的现代代码中,可结合实际场景选择效率更高、表达更直观的f-string。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















