


怎么解决Python在线编译器运行超时或内存不足
系统剖析Python在线编译器中运行超时(TLE)与内存不足(MLE)的触发原因与沙箱运行机制,提供从时间复杂度优化、生成器流式处理、快速IO到本地环境迁移的完整解决步骤与实用代码示例。
一、在线编译器的沙箱机制与资源阈值剖析
很多开发者在本地计算机运行顺畅的Python代码,一旦粘贴至网页端在线编译器(例如算法练习平台、交互式教学沙箱或轻量REPL),就会频繁收到报错或被系统直接强行终止。要彻底解决这个问题,首先需要理解在线编译器的运行环境。
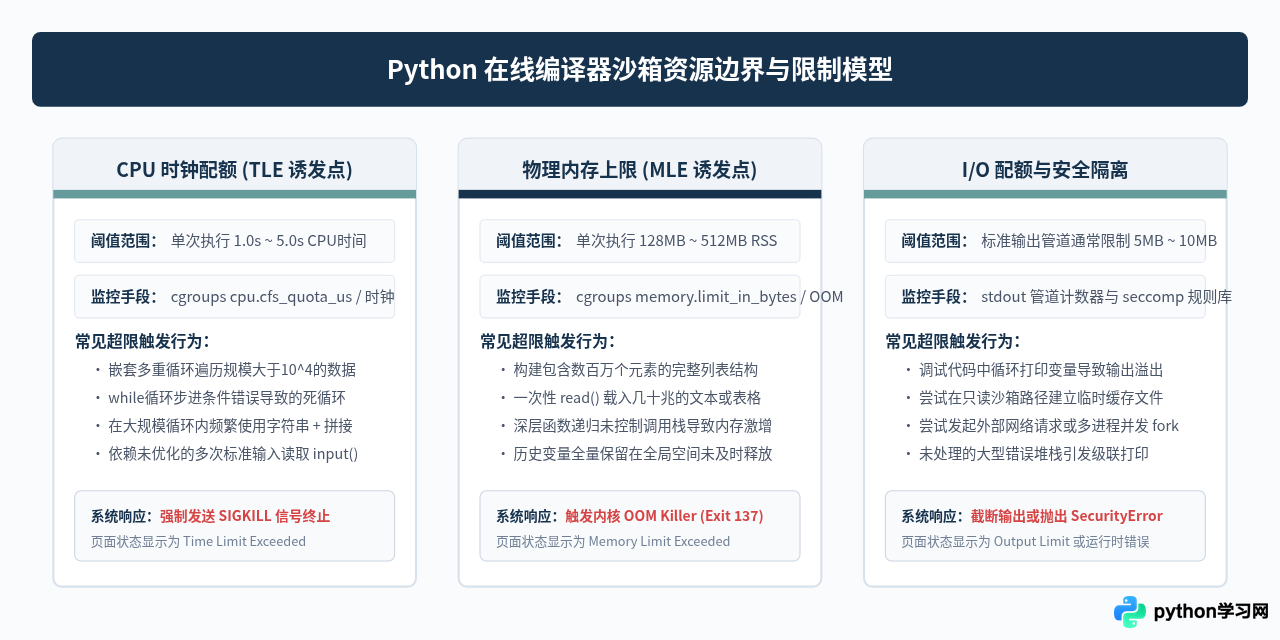
在线编译器为了保障多租户服务的高可用性、计算公平性与服务器安全,普遍采用轻量级Linux容器(如Docker、LXC或自定义沙箱)结合控制组(cgroups)以及系统调用过滤(seccomp)。平台会在内核层面施加严密监控,一旦程序触及资源红线,容器监控守护进程就会发出底层信号:
- CPU执行时钟限制(Time Limit):绝大多数平台分配给单个执行任务的CPU纯计算时间通常仅有1秒至5秒。当循环耗时或递归层级超标时,系统将发出SIGKILL或SIGALRM,直接返回“Time Limit Exceeded”或“Execution Timed Out”。
- 驻留物理内存限制(Memory Limit):轻量沙箱通常将进程最大驻留集(RSS)限定在128MB至512MB之间。一旦列表扩容、递归爆栈或大文件载入触发内存边界,Linux内核的OOM Killer(Out of Memory Killer)会瞬间终止Python进程,返回Exit Code 137或显示“Memory Limit Exceeded”。
- 标准I/O与系统调用拦截:高频调用print会导致标准输出缓冲区塞满,触发Output Limit Exceeded;而试图向临时磁盘写入大量缓存文件则可能直接遭遇权限拒绝或磁盘配额超标。
二、解决运行超时(Time Limit Exceeded):排查与代码优化
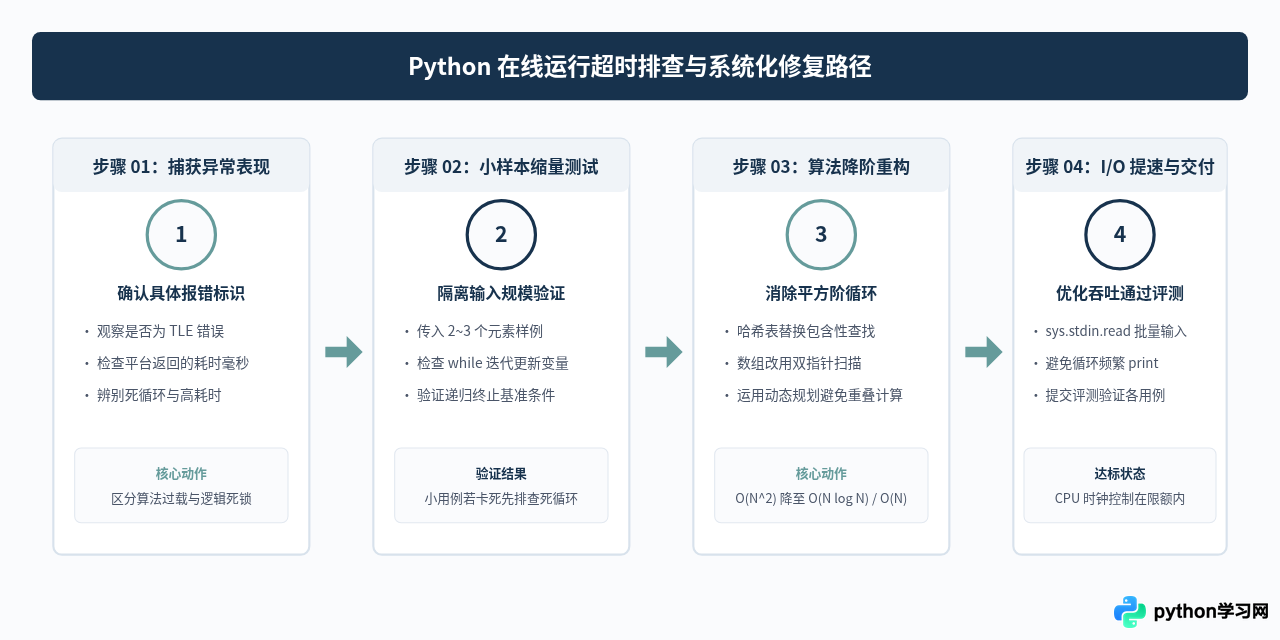
当平台提示运行超时时,首要任务是判断问题属于“逻辑死循环”还是“时间复杂度过高”。按照以下步骤进行排查与修复:
1. 第一步:小规模测试数据快速定位
如果代码包含 while 循环,先检查是否存在无法满足的退出条件。可以手工构造一个只有 2~3 个元素的小数据集运行:
- 如果小规模数据依然直接超时,说明存在无限死循环,或者递归缺乏基准退出条件(Base Case)。
- 如果小规模数据瞬间得出正确答案,但提交完全用例时超时,则 100% 属于时间复杂度超标。
2. 第二步:算法时间复杂度降维(核心措施)
在算法在线判题中,通常以 1 秒内执行约 10^7 ~ 10^8 次基本 Python 运算为基准。如果测试数据量为 N = 10^5:
- O(N^2) 的算法需要进行 10^10 次操作,在在线编译器中必定超时。
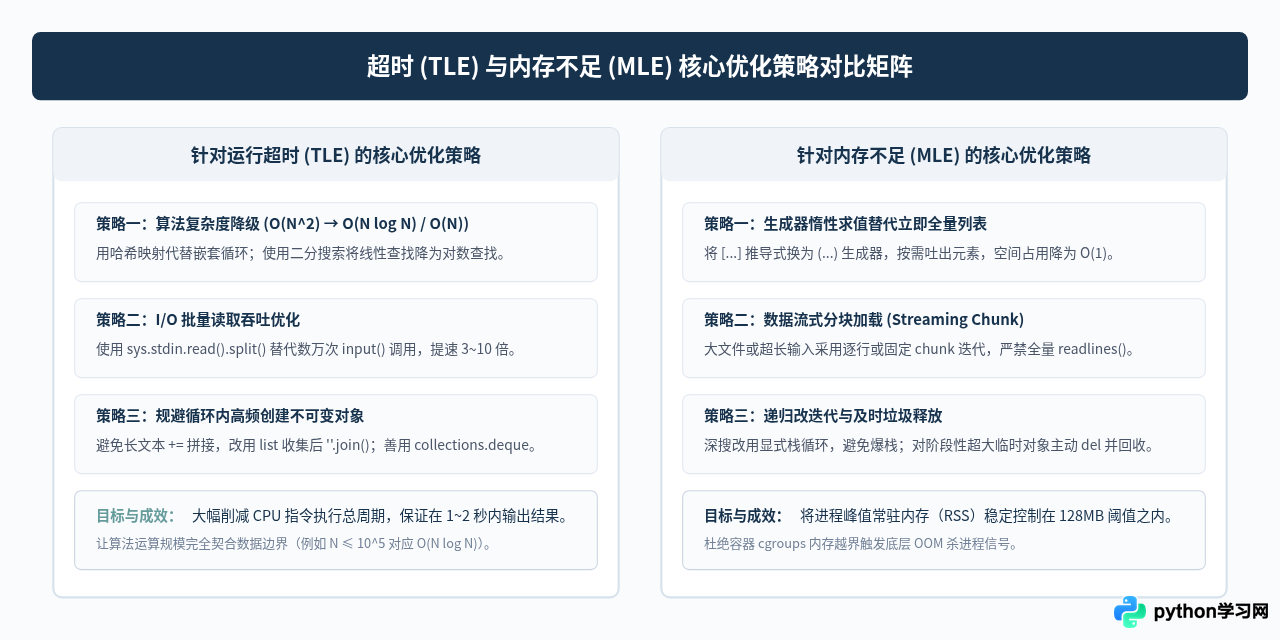
- 必须将算法优化为 O(N log N)(如排序后双指针)或 O(N)(如哈希映射)。
以经典的“两数之和(判断列表中是否存在两数相加等于目标值)”为例,对比优化前后的代码:
# ❌ 低效写法:双重循环嵌套,时间复杂度 O(N^2),数据量达 50000 时必然超时
def two_sum_slow(nums, target):
    n = len(nums)
    for i in range(n):
        for j in range(i + 1, n):
            if nums[i] + nums[j] == target:
                return [i, j]
    return []

# ✅ 高效写法:单次哈希表查找,时间复杂度降至 O(N),秒级通过判题
def two_sum_fast(nums, target):
    lookup = {}
    for i, num in enumerate(nums):
        complement = target - num
        if complement in lookup:
            return [lookup[complement], i]
        lookup[num] = i
    return []
3. 第三步:优化高频操作与标准输入输出(I/O)
在处理数万行输入的判题场景下,Python 默认的 input() 函数由于包装了提示符处理及换行符清理,性能明显滞后。改用 sys.stdin.read 一次性读取并分割数据,可以带来 3~10 倍的输入提速:
import sys

# ❌ 耗时写法:循环调用 input() 处理多行输入
# lines = [input() for _ in range(n)]

# ✅ 提速写法:通过 sys.stdin 快速提取输入流
def fast_io_solution():
    input_data = sys.stdin.read().split()
    if not input_data:
        return
    # 后续直接通过迭代器按需取值
    iterator = iter(input_data)
    n = int(next(iterator))
    values = [int(next(iterator)) for _ in range(n)]
    # 处理业务逻辑...
str_data += char 拼接。由于 Python 字符串是不可变对象,频繁拼接会触发连续内存重新分配与拷贝。应当使用列表收集子串,最后统一调用 "".join(str_list)。
三、解决内存不足(Memory Limit Exceeded):空间压缩与流式处理
“Memory Limit Exceeded”(内存溢出)通常源自将海量数据一次性实例化进内存、过度保存中间状态,或者递归调用层数过多导致栈帧累积。解决内存不足的核心思想是“惰性求值(Lazy Evaluation)”与“流式迭代(Streaming)”。
1. 用生成器表达式替代列表推导式
当需要生成或过滤一系列数据并求和时,如果直接使用方括号 [...],Python 会在内存中立即开辟连续空间存放全部元素;而改用圆括号 (...) 的生成器表达式,内存占用将从原本的几十上百兆降为常数级别(仅几十字节):
# ❌ 内存超限写法:一次性分配包含 1000 万个整数的列表,占用数百兆内存导致崩溃
# total = sum([x * 2 for x in range(10000000)])

# ✅ 内存安全写法:使用生成器表达式惰性求值,即算即抛,内存常数级 O(1)
total = sum(x * 2 for x in range(10000000))
2. 文件与大数据集的分块流式读取
在处理包含文本或表格数据的任务时,切勿使用 f.read() 或 f.readlines()。它们会将整个文件一口气装入 RAM。应当直接利用 Python 文件的迭代器特性逐行处理,或者使用自定义分块生成器:
# ❌ 危险写法:将大文本全量载入内存
# content = f.readlines()

# ✅ 安全写法:逐行流式读取,每次只在内存中保留当前行的内容
def process_large_file(file_obj):
    for line in file_obj:
        stripped_line = line.strip()
        if stripped_line:
            # 单行即时处理,处理完成后该行对象即可被垃圾回收
            yield process_line(stripped_line)

# ✅ 二进制数据分块流式加载
def read_in_chunks(file_obj, chunk_size=4096):
    while True:
        data = file_obj.read(chunk_size)
        if not data:
            break
        yield data
3. 递归转迭代,消除调用栈爆满
Python 默认递归深度上限通常为 1000,而在部分在线沙箱中,即使调整了 sys.setrecursionlimit(),过深的递归也会因创建大量函数栈帧而耗尽内存。对于深度优先搜索(DFS)或树遍历算法,应显式采用循环配合栈(list)实现迭代版本,既规避栈溢出,又大幅节省内存开销。
四、在在线沙箱内进行轻量级耗时与内存自测
在线编译器一般不开放外部性能调优工具(如 cProfile 或 memory_profiler 的命令行交互)。但我们可以在代码头部直接引入 Python 标准库,内联打印出当前函数的实际执行耗时与内存峰值,从而在正式提交或上线前心中有数。
import time
import tracemalloc

def profile_runner():
    # 开启内存追踪
    tracemalloc.start()
    start_time = time.perf_counter()

    # --- 待测目标逻辑开始 ---
    # 示例:构建一个轻量生成器求和
    result = sum(i for i in range(1000000))
    # --- 待测目标逻辑结束 ---

    end_time = time.perf_counter()
    current, peak = tracemalloc.get_traced_memory()
    tracemalloc.stop()

    print(f"执行耗时: {(end_time - start_time):.4f} 秒")
    print(f"内存当前占用: {current / (1024 * 1024):.2f} MB")
    print(f"内存峰值占用: {peak / (1024 * 1024):.2f} MB")
    return result

profile_runner()
tracemalloc 本身也会带来额外的内存跟踪开销与微小耗时,可能会挤占本来就紧张的沙箱裕量。
五、何时应当脱离在线编译器:本地与云端迁移决策
我们需要客观认识在线编译器的边界。在线编译器是极佳的“算法逻辑验证工具”、“语法学习沙盒”与“面试代码协同平台”,但它绝不是设计用来运行复杂生产级数据工程、深度学习模型或巨型文件的平台。
下表给出了判断是否需要切换开发环境的具体技术标准:
| 任务特征维度 | 适合在在线编译器中解决 | 应当果断迁移至本地或云端环境 |
|---|---|---|
| 数据量规模 | 输入规模在 10^5 以内,单文件体积 < 5MB | 真实业务数据集、超过 50MB 的 CSV/日志或数据库导出文件 |
| 库依赖要求 | 仅依赖 Python 标准库(math, collections, sys 等) | 重度依赖 PyTorch, TensorFlow, OpenCV 等重型外部原生编译库 |
| 计算耗时特征 | 要求在 1~5 秒内返回确定性输出结果 | 需要多线程并发爬虫、长时间训练或数十分钟的批处理 |
| 磁盘与网络访问 | 纯内存纯 I/O 数据流运算,无外部交互 | 需要频繁写入本地多级目录文件或建立 Socket 网络连接 |
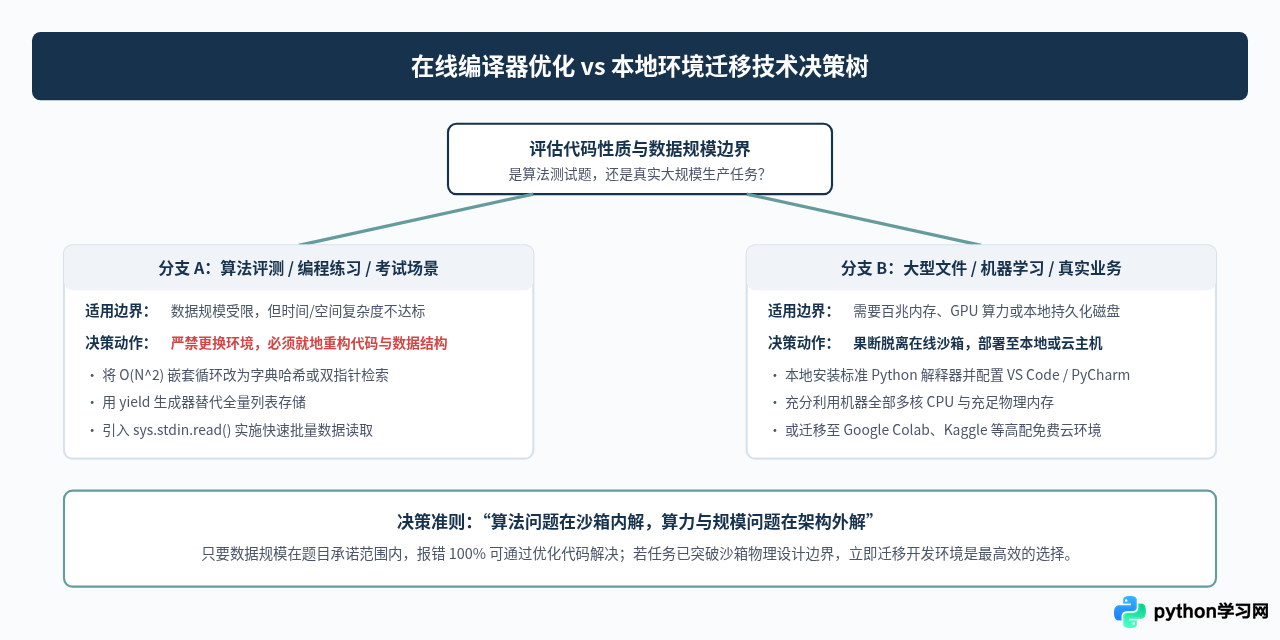
六、全文核心解决要点总结
当遇到 Python 在线编译器运行超时或内存不足时,遵循以下速查表进行应对:
- 看清报错信号:明确是 TLE(CPU 耗时超标)还是 MLE(内存溢出中断),避免无方向地胡乱修改。
- 优先排查死循环与递归基准:传入 2~3 个极简数据验证,如果小规模数据耗时依然不归零,重点检查
while条件变量更新或递归终止语句。 - 降维核心算法:用哈希表将循环中的
in list操作从 O(N) 降低至 O(1);对查找与匹配逻辑改用双指针或二分法。 - 全面推行惰性求值:严禁一次性开辟数百万长数组,将列表推导式
[...]换为生成器(...);利用文件流式迭代替代readlines()。 - 优化输入输出吞吐:在大量输入场景下使用
sys.stdin.read().split()代替input(),避免在超大循环中高频触发print()。 - 合理评估环境上限:如果涉及数十兆的文件读写、第三方大型复杂科学计算库或图形界面渲染,果断在本地电脑搭建 Python 开发环境或使用配置更充足的云端 Jupyter 实例。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















